

Framtiden är här, teknologier inom artificiell intelligens och maskininlärning används redan framgångsrikt av dina favoritbutiker, transportföretag och till och med gårdar som odlar kalkoner.
Och om något existerar, finns det redan information om det på internet... ett öppet projekt! Se hur Open Data Hub hjälper till att skala nya teknologier och undvika svårigheter vid deras implementering.
Trots alla fördelar med artificiell intelligens (AI) och maskininlärning (ML) har organisationer ofta svårt att skala dessa teknologier. De största problemen är vanligtvis följande:
- Informationsutbyte och samarbete – att utbyta information utan onödiga ansträngningar och samarbeta i snabba iterationer är praktiskt taget omöjligt.
- Tillgång till data – för varje uppgift måste den byggas om och göras manuellt, vilket tar mycket tid.
- Tillgång på begäran – det finns ingen möjlighet att få tillgång till verktyg och plattformar för maskininlärning samt till den beräkningsinfrastruktur som krävs.
- Produktion – modellerna förblir på prototypstadiet och når inte produktionsanvändning.
- Spårning och förklaring av AI-resultat – reproducerbarhet, spårning och förklaring av AI/ML-resultat är besvärligt.
Om dessa problem lämnas olösta påverkar de negativt hastigheten, effektiviteten och produktiviteten hos värdefulla databehandlare och analytiker. Detta leder till frustration, arbetsmissnöje och i slutändan krossas affärens förväntningar på AI/ML.
Ansvar för att lösa dessa problem vilar på IT-specialister, som måste förse dataanalytiker med – korrekt, en molnlösning. Mer specifikt behövs en plattform som ger valfrihet och har enkel och bekväm tillgång. Den bör vara snabb, lätt att omkonfigurera, skalbar på begäran och motståndskraftig mot fel. Att bygga en sådan plattform på öppna källkodsteknologier hjälper till att undvika leverantörsberoende och behålla en långsiktig strategisk fördel när det gäller kostnadskontroll.
För flera år sedan skedde något liknande inom applikationsutveckling, vilket ledde till framväxten av mikrotjänster, hybrida molnmiljöer, IT-automatisering och agila processer. För att hantera allt detta började IT-specialister använda containrar, Kubernetes och öppna hybrida moln.
Nu tillämpas denna erfarenhet för att möta utmaningarna inom AI. Därför skapar IT-specialister plattformar som bygger på containrar, möjliggör skapandet av AI/ML-tjänster inom ramen för agila processer, accelererar innovation och byggs med sikte på hybrida moln.
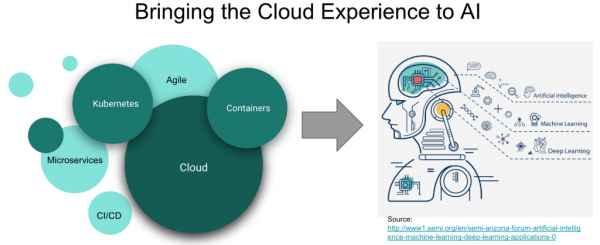
Vi kommer att starta byggandet av en sådan plattform med Red Hat OpenShift, vår Kubernetes-plattform för hybrida moln, som har ett snabbt växande ekosystem av mjukvaru- och hårdvarulösningar för ML (NVIDIA, H2O.ai, Starburst, PerceptiLabs m.fl.). Några av Red Hats kunder, såsom BMW Group, ExxonMobil och andra, har redan implementerat containrariserade kedjor av ML-verktyg och DevOps-processer baserade på denna plattform och dess ekosystem för att driva sina ML-arkitekturer mot industriell produktion och påskynda arbetet för dataanalytiker.
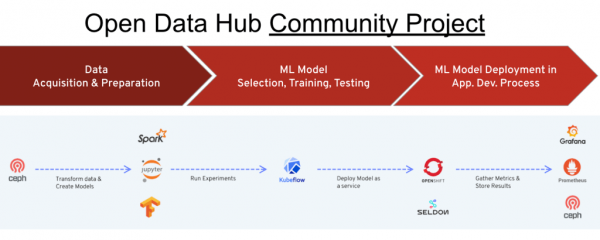
En annan anledning till att vi startade projektet Open Data Hub är att demonstrera ett exempel på en arkitektur baserad på flera öppna programvaruprojekt och visa hur hela livscykeln av en ML-lösning kan implementeras baserat på OpenShift-plattformen.
Projektet Open Data Hub
Det här är ett projekt med öppen källkod som utvecklas inom den relevanta utvecklingsgemenskapen och implementerar hela cykeln av operationer – från laddning och konvertering av ursprungliga data till skapande, träning och underhåll av modeller – när man löser AI/ML-uppgifter med hjälp av containrar och Kubernetes på OpenShift-plattformen. Detta projekt kan ses som en referensimplementation, ett exempel på hur man bygger en öppen lösning av typen "AI/ML som tjänst" baserat på OpenShift och relevanta verktyg med öppen källkod, såsom Tensorflow, JupyterHub, Spark och andra. Det är viktigt att notera att Red Hat själv använder detta projekt för att erbjuda sina AI/ML-tjänster. Dessutom integreras OpenShift med nyckelprogramvaror och hårdvarulösningar för ML från NVIDIA, Seldon, Starburst och andra leverantörer, vilket underlättar byggandet och lanseringen av egna maskininlärningssystem.
Projektet Open Data Hub riktar sig till följande användarkategorier och användningsscenarier:
- En dataanalytiker som behöver en lösning för att genomföra ML-projekt, organiserad som en molnbaserad tjänst med självbetjäningsegenskaper.
- En dataanalytiker som behöver det största utbudet av alla de senaste AI/ML-verktygen och plattformarna med öppen källkod.
- En dataanalytiker som behöver tillgång till datakällor när han tränar modeller.
- En dataanalytiker som behöver tillgång till datorkällor (CPU, GPU, minne).
- En dataanalytiker som behöver möjlighet att samarbeta och dela sina resultat med kollegor, få feedback och göra förbättringar genom snabba iterationer.
- En dataanalytiker som vill interagera med utvecklare (och devops-team) för att se till att hans ML-modeller och resultat går i produktion.
- En dataingenjör som behöver ge dataanalytikern tillgång till en mängd olika datakällor med efterlevnad av normer och säkerhetskrav.
- En IT-systemadministratör/operator som behöver möjlighet att enkelt övervaka livscykeln (installation, konfiguration, uppdatering) av komponenter och teknologier med öppen källkod. Dessutom behövs lämpliga hanterings- och kvoteringsverktyg.
Projektet Open Data Hub samlar en rad verktyg med öppen källkod för att genomföra hela cykeln av AI/ML-operationer. Den primära arbetsverktyget för dataanalytikern är här Jupyter Notebook. Detta verktyg är idag mycket populärt bland specialister inom datahantering och analys, och Open Data Hub gör det enkelt för dem att skapa och hantera Jupyter Notebook-arbetsytor med inbyggd JupyterHub. Förutom att skapa och importera Jupyter-notebookar innehåller projektet Open Data Hub också en rad färdiga notebookar i form av AI Library.
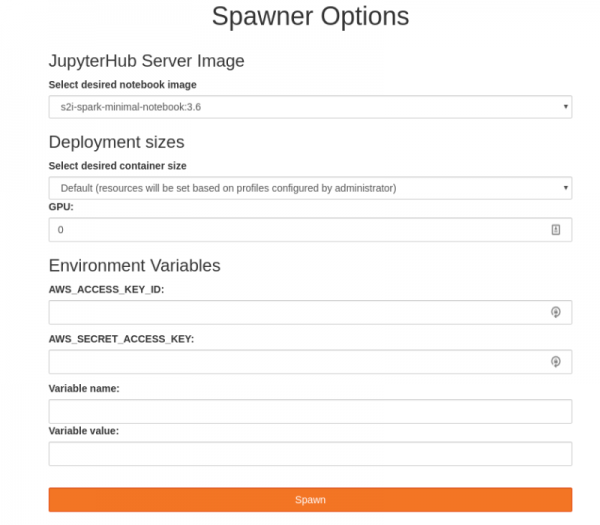
Det här biblioteket är en samling av open-source komponenter för maskininlärning och lösningar för typiska scenarier som förenklar snabb prototypering. JupyterHub är integrerat med RBAC-åtkomstmodellen av OpenShift, vilket gör det möjligt att använda befintliga OpenShift-konton och implementera single sign-on. Dessutom erbjuder JupyterHub ett användarvänligt gränssnitt som kallas spawner, där användaren enkelt kan ställa in mängden beräkningsresurser (CPU-kärnor, minne, GPU) för den valda Jupyter Notebooken.
När datanalytikern har skapat och konfigurerat notebooken tar Kubernetes-schedulern, som är en del av OpenShift, hand om alla andra bekymmer. Användarna kan fokusera på att utföra sina experiment, spara och dela resultaten av sitt arbete. Dessutom kan avancerade användare direkt få tillgång till OpenShift CLI från Jupyter notebooks för att använda Kubernetes-primitiv såsom Job, eller funktioner i OpenShift, som Tekton eller Knative. Alternativt kan man använda det bekväma OpenShift-gränssnittet som kallas "OpenShift webbkonsol".
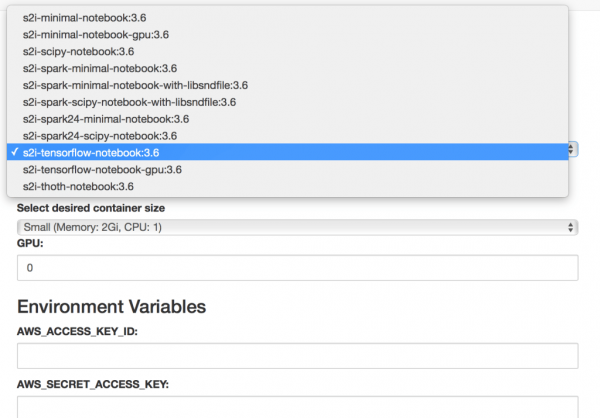
Vid övergången till nästa steg möjliggör Open Data Hub hantering av data pipelines. Detta görs med hjälp av en Ceph-objekt som tillhandahålls som en S3-kompatibel objektlagring. Apache Spark säkerställer datastreaming från externa källor eller det inbyggda Ceph S3-lagringsutrymmet och möjliggör även förbehandling av data. Apache Kafka tillhandahåller avancerad hantering av data pipelines (där man kan utföra multipla uppladdningar samt transformationer, analyser och lagring av data).
Så, datanalytikern har fått tillgång till data och byggt en modell. Nu vill han dela de uppnådda resultaten med kollegor eller applikationsutvecklare, och ge dem sin modell som en tjänst. För detta krävs en output-server, och Open Data Hub har en sådan server, den kallas Seldon och möjliggör publicering av modellen som en RESTful-tjänst.
Vid någon tidpunkt finns det flera sådana modeller på Seldon-servern, och behovet av att övervaka hur de används uppstår. För detta erbjuder Open Data Hub en samling relevanta metrics och en rapportmotor baserad på de populära övervakningsverktygen med öppen källkod Prometheus och Grafana. Som ett resultat får vi återkoppling för övervakning av användningen av AI-modeller, särskilt i produktionsmiljöer.
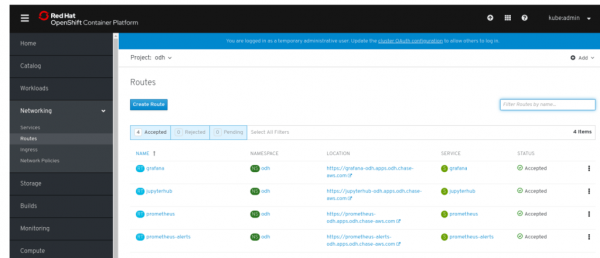
Således ger Open Data Hub en molnbaserad strategi genom hela cykeln för AI/ML-operationer, från åtkomst och databereddning till träning och industriell drift av modellen.
Sammanfattar allt
Nu uppstår frågan om hur allt detta ska organiseras av OpenShift-administratören. Här kommer en speciell Kubernetes-operator för Open Data Hub-projekt in i bilden.
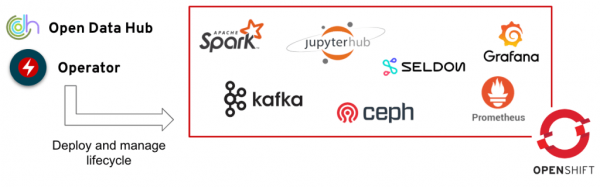
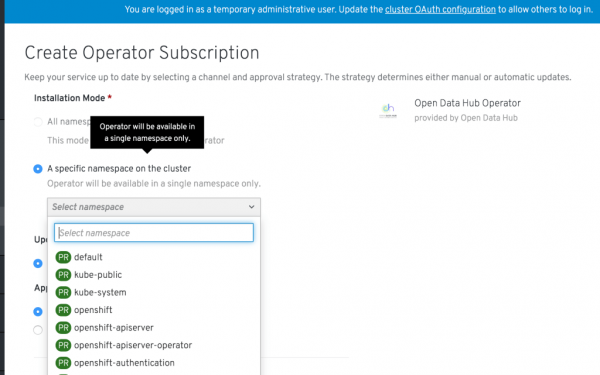
Denna operator hanterar installation, konfiguration och livscykel för Open Data Hub-projektet, inklusive distribution av ovan nämnda verktyg som JupyterHub, Ceph, Spark, Kafka, Seldon, Prometheus och Grafana. Open Data Hub-projektet kan hittas i OpenShift-webbkonsolen under community-operators. På så sätt kan OpenShift-administratören ange att de relevanta OpenShift-projekten tillhör kategorin "Open Data Hub-projekt". Detta görs en gång. Efter det går dataanalytikern in i sitt projektutrymme via OpenShift-webbkonsolen och ser att den relevanta Kubernetes-operatören är installerad och tillgänglig för sina projekt. Sedan skapar han ett exemplar av Open Data Hub-projektet med ett musklick och får omedelbar tillgång till de ovan beskrivna verktygen. Och allt detta kan konfigureras för hög tillgänglighet och redundans.
Om du vill prova Open Data Hub-projektet själv, börja med . Tekniska detaljer om Open Data Hubs arkitektur finns att hitta , projektets utvecklingsplaner – . I framtiden planeras ytterligare integration med Kubeflow, lösning på en rad frågor kring reglering av data och säkerhet, samt organisering av integrering med regeldrivna system som Drools och Optaplanner. Du kan dela din åsikt och delta i projektet på sidan .
Sammanfattningsvis hindrar allvarliga skalningsproblem organisationer från att fullt ut förverkliga potentialen hos artificiell intelligens och maskininlärning. Red Hat OpenShift har länge och framgångsrikt använts för att lösa liknande problem inom mjukvaruindustrin. Projektet Open Data Hub, som genomförts inom ramen för ett öppen källkod-gemenskap, erbjuder en referensarkitektur för att organisera hela cykeln av AI/ML-operationer baserat på hybridmolnet OpenShift. Vi har en tydlig och genomtänkt utvecklingsplan för detta projekt och vi är fast beslutna att skapa en aktiv och fruktbar gemenskap för utveckling av öppna AI-lösningar på plattformen OpenShift.
Källa: habr.com
