

Detta är en översättningsartikel . Men först en liten inledning. Hur blir man zombies? Vi har alla varit där när man vill dra upp en vän eller kollega till sin nivå, men det funkar inte. Och det handlar inte så mycket om dig som om dem: på ena sidan väger en normal lön, uppgifter och så vidare, på den andra sidan väger behovet av att tänka. Att tänka är obehagligt och smärtsamt. De ger snabbt upp och fortsätter skriva kod utan att riktigt använda sin hjärna. Du förstår hur mycket energi det krävs för att övervinna barriären av inlärd hjälplöshet, och så gör man helt enkelt inte det. Så blir de zombies som verkar kunna botas, men som ingen verkar vilja hjälpa.
När jag såg att (ja, just den personen från läroböckerna) och håller en frågestund istället för en föreläsning, blev jag lite skeptisk. Som en bakgrund är Leslie en världsberömd forskare, författare till grundläggande arbeten inom distribuerad databehandling, och kanske känner ni honom via bokstäverna La i ordet LaTeX — "Lamport TeX". Den andra oroande faktorn är hans krav: alla som kommer måste (helt gratis) lyssna på ett par av hans föreläsningar i förväg, tänka ut minst en fråga och bara då komma. Jag bestämde mig för att se vad Lamport pratar om — och det är fantastiskt! Det är precis den sak, den magiska länken-tablett för att bota zombitillståndet. Jag varnar: texten kan förarga dem som älskar överflexibla metoder och ogillar att testa det skrivna.
Efter introduktionen börjar själva översättningen av seminariet. Trevlig läsning!
Oavsett vilken uppgift du tar dig an, måste du alltid gå igenom tre steg:
- klargöra vilket mål du vill uppnå;
- bestämma hur du ska nå ditt mål;
- komma till ditt mål.
Detta gäller även programmering. När vi skriver kod behöver vi:
- klargöra vad programmet ska göra;
- bestämma hur det ska utföra sin uppgift;
- skriva motsvarande kod.
Det sista steget är självklart mycket viktigt, men jag kommer inte att prata om det idag. Istället kommer vi att diskutera de första två. Dessa är något som varje programmerare genomför innan de börjar arbeta. Man sätter sig inte ner för att skriva om man inte har bestämt vad man faktiskt skriver: en webbläsare eller en databas. En tydlig bild av målet måste alltid finnas. Och man tänker igenom vad programmet ska göra, istället för att skriva huller om buller i hopp om att koden på något sätt ska förvandlas till en webbläsare.
Hur exakt sker denna förberedande planering av koden? Hur mycket tid bör vi lägga på detta? Allt beror på hur komplex problemet vi löser är. Låt oss anta att vi vill skriva ett felfritt distribuerat system. I det fallet bör vi tänka igenom allt noggrant innan vi sätter oss för att koda. Men om vi bara behöver öka en heltalsvariabel med 1? Vid första anblicken verkar detta trivialt, och inga överväganden behövs, men sedan kommer vi ihåg att överflöd kan inträffa. Därför, för att förstå om det är ett enkelt eller komplext problem — måste man tänka efter först.
Om man i förväg tänker igenom potentiella lösningar på problemet kan man undvika misstag. Men för detta krävs det att ditt tänkande är klart. För att uppnå detta behöver man skriva ner sina tankar. Jag gillar verkligen citatet av Dick Gindin: 'När du skriver, visar naturen dig hur slarvigt ditt tänkande är'. Om du inte skriver, verkar det bara som om du tänker. Och man bör skriva ner sina tankar i form av specifikationer.
Specifikationer uppfyller många funktioner, särskilt i stora projekt. Men jag kommer att prata om bara en av dem: de hjälper oss att tänka klart. Att tänka klart är mycket viktigt och ganska svårt, så vi behöver all hjälp vi kan få här. På vilket språk ska vi skriva specifikationerna? Det är alltid den första frågan för programmerare: vilket språk ska vi använda? Det finns inget rätt svar på detta: problemen vi löser är för många och olika. För vissa är TLA+ användbart — ett specifikationsspråk som jag har utvecklat. För andra är det lättare att använda kinesiska. Det beror helt på situationen.
En annan viktig fråga är: hur ska vi uppnå klarare tänkande? Svaret: vi måste tänka som forskare. Det är ett sätt att tänka som har visat sig vara mycket effektivt under de senaste 500 åren. Inom vetenskapen bygger vi matematiska modeller av verkligheten. Astronomi var kanske den första riktiga vetenskapen. I den matematiska modellen som används inom astronomi framställs himlakroppar som punkter med massa, position och rörelse, även om de i verkligheten är extremt komplexa objekt med berg och hav, tidvatten och ebb. Denna modell, precis som alla andra, är skapad för att lösa specifika problem. Den är utmärkt för att avgöra vart teleskopet ska riktas om vi behöver hitta en planet. Men om du vill förutsäga vädret på denna planet, är denna modell inte tillräcklig.
Matematiken låter oss bestämma egenskaperna hos modellen. Och vetenskapen visar hur dessa egenskaper relaterar till verkligheten. Låt oss prata om vår vetenskap, datavetenskap. Verkligheten vi arbetar med är beräkningssystem av olika slag: processorer, spelkonsoler, datorer som kör program och så vidare. Jag kommer att prata om att köra ett program på en dator, men i stort sett gäller alla dessa slutsatser för alla beräkningssystem. Inom vår vetenskap använder vi många olika modeller: Turingmaskinen, delvis ordnade mängder av händelser och många andra.
Vad är ett program? Det är vilken kod som helst som kan ses som självständig. Anta att vi behöver skriva en webbläsare. Vi utför tre uppgifter: vi designar programmets presentation för användaren, skriver sedan en hög-nivå schema för programmet, och slutligen skriver vi koden. Under skrivningen av koden inser vi att vi behöver skriva ett verktyg för textformatering. Här igen måste vi lösa tre uppgifter: fastställa vilken text detta verktyg ska returnera; välja en algoritm för formatering; skriva koden. Denna uppgift har sin egen deluppgift: att korrekt infoga bindestreck i orden. Denna deluppgift löser vi också i tre steg — som vi ser upprepas på många nivåer.
Låt oss titta närmare på det första steget: vilken uppgift programmet löser. Här modellerar vi oftast programmet som en funktion som tar vissa indata och ger vissa utdata. Inom matematiken beskrivs en funktion vanligtvis som en ordnad mängd par. Till exempel beskrivs funktionen att ta kvadraten av naturliga tal som mängden {, , , , …}. Funktionsområdet för en sådan funktion är mängden av de första elementen i varje par, det vill säga naturliga tal. För att definiera en funktion behöver vi ange dess funktionsområde och formel.
Men funktioner inom matematik är inte detsamma som funktioner i programmeringsspråk. Matematiken är betydligt enklare. Eftersom jag inte har tid för komplexa exempel, låt oss titta på ett enkelt: en funktion i C-språket eller en statisk metod i Java som returnerar den största gemensamma delaren av två heltal. I specifikationen av denna metod skriver vi: beräknar GCD(M,N) för argumenten M och N, där GCD(M,N) — en funktion vars funktionsområde är mängden av par av heltal, och returvärdet är det största heltalet som är delbart med M och N. Hur relaterar denna modell till verkligheten? Modellen arbetar med heltal, medan vi i C eller Java har 32-bitars. intDenna modell gör att vi kan avgöra om algoritmen är korrekt GCD, men den förhindrar inte överflödesfel. För detta skulle en mer komplex modell krävas, vilket det inte finns tid för.
Låt oss tala om begränsningarna hos funktionen som en modell. Vissa program (till exempel operativsystem) syftar inte bara till att returnera ett visst värde för vissa argument, de kan köras kontinuerligt. Dessutom lämpar sig funktionen som modell dåligt för det andra steget: planering av hur uppgiften ska lösas. Snabbsortering och bubbel-sortering beräknar samma funktion, men det är helt olika algoritmer. Därför använder jag en annan modell för att beskriva sättet att nå programmets mål, låt oss kalla den den standardiserade beteendemodellen. Programmet representeras här som en mängd av alla tillåtna beteenden, var och en av dem är en sekvens av tillstånd, och ett tillstånd är en tilldelning av värden till variabler.
Låt oss se hur det andra steget i Euklides algoritm kommer att se ut. Vi behöver beräkna GCD(M, N). Vi initierar M som x, och N som y, och drar sedan bort den mindre av dessa variabler från den större tills de är lika. Till exempel, om M = 12, och N = 18, kan vi beskriva följande beteende:
[x = 12, y = 18] → [x = 12, y = 6] → [x = 6, y = 6]
Och om M = 0 och N = 0? Ноль делится на все числа, поэтому наибольшего делителя в этом случае нет. В этой ситуации нам нужно вернуться к первому шагу и спросить: действительно ли нам нужно вычислять НОД для неположительных чисел? Если в этом нет необходимости, то нужно просто изменить спецификацию.
Här är det värt att göra en liten avstickare om produktivitet. Den mäts ofta i antalet kodrader som skrivs per dag. Men ditt arbete är betydligt mer värdefullt om du har blivit av med ett visst antal rader, eftersom du får mindre plats för buggar. Och att bli av med kod är lättast just i det första steget. Det är fullt möjligt att du helt enkelt inte behöver alla de funktioner som du försöker implementera. Det snabbaste sättet att förenkla programmet och spara tid är att inte göra saker som inte bör göras. Det andra steget har den näst största potentialen för tidsbesparing. Om du mäter produktivitet i antal skrivna rader, så kommer planeringen av hur uppgiften ska utföras att göra dig mindre produktiv, eftersom du kan lösa samma uppgift med mindre kod. Jag kan inte ge exakt statistik här, eftersom jag inte har något sätt att räkna det antal rader som jag inte skrev tack vare att jag lade tid på specifikationen, det vill säga på det första och andra steget. Och det går inte att experimentera med detta, eftersom vi inte har rätt att utföra det första steget i experimentet, uppgiften är definierad i förväg.
I informella specifikationer är det lätt att förbise många svårigheter. Det är inget svårt med att skriva strikta specifikationer för funktioner, det kommer jag inte att diskutera. Istället kommer vi att prata om att skriva strikta specifikationer för standardbeteendemodeller. Det finns en sats som säger att vilket beteende som helst kan beskrivas med hjälp av säkerhetsegenskaper (safety) och livaktighetsegenskaper (liveness). Säkerhet betyder att inget dåligt kommer att hända, programmet kommer inte att ge felaktiga svar. Robusthet innebär att något bra kommer att hända förr eller senare, det vill säga programmet kommer förr eller senare att ge rätt svar. I allmänhet är säkerhet en viktigare indikator, eftersom fel oftast uppstår här. Därför kommer jag att spara tid genom att inte prata om robusthet, även om det självklart också är viktigt.
Vi uppnår säkerhet genom att först skriva ner många möjliga initiala tillstånd. Och för det andra relationerna med alla möjliga efterföljande tillstånd för varje tillstånd. Vi ska bete oss som forskare och definiera tillstånden matematiskt. Setet av initiala tillstånd beskrivs med en formel, till exempel i fallet med Euklides algoritm: (x = M) ∧ (y = N). För vissa värden M och N finns det bara ett initialt tillstånd. Relationerna med nästa tillstånd beskrivs med en formel där variablerna för nästa tillstånd skrivs med ett streck, och det aktuella tillståndet utan streck. I fallet med Euklides algoritm kommer vi att hantera en disjunktion av två formler, där den ena x är det största värdet, och den andra y:
I det första fallet är det nya värdet y lika med det gamla värdet på y, och det nya värdet på x får vi genom att subtrahera den mindre variabeln från den större. I det andra fallet gör vi tvärtom.
Låt oss återgå till Euklides algoritm. Anta återigen att M = 12, N = 18. Detta definierar det unika initiala tillståndet, (x = 12) ∧ (y = 18). Sedan sätter vi in dessa värden i formeln ovan och får:
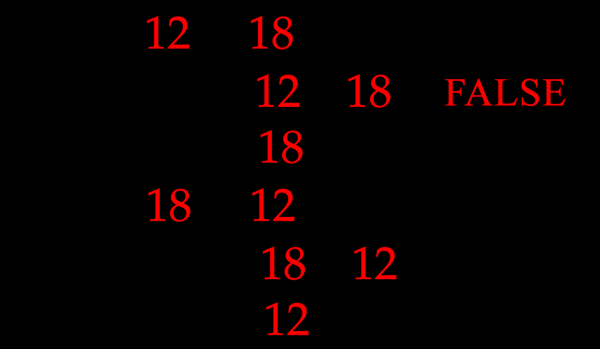
Här är den enda möjliga lösningen: x' = 18 - 12 ∧ y' = 12, och vi får beteendet: [x = 12, y = 18]. På samma sätt kan vi beskriva alla tillstånd i vårt beteende: [x = 12, y = 18] → [x = 12, y = 6] → [x = 6, y = 6].
I det sista tillståndet [x = 6, y = 6] kommer båda delarna av uttrycket att vara falska, därför finns det inget nästa tillstånd. Så vi har en fullständig specifikation av det andra steget – som vi ser är det helt vanlig matematik, som hos ingenjörer och forskare, och inte konstig som inom datavetenskap.
Dessa två formler kan kombineras till en enda formel för tidslogik. Den är elegant och lätt att förklara, men det finns ingen tid för det just nu. Tidslogik kan behövas för egenskapen livlighet, men den är inte nödvändig för säkerhet. Tidslogik som sådan tilltalar inte, det är inte helt vanlig matematik, men i fallet med livlighet utgör den ett nödvändigt ont.
I Euklides algoritm för varje värde x och y finns unika värden x' och y', som gör att förhållandet med nästa tillstånd är sant. Med andra ord är Euklides algoritm deterministisk. För att modellera en icke-deterministisk algoritm måste det nuvarande tillståndet ha flera möjliga framtida tillstånd, och varje värde av variabeln utan streck måste ha flera värden av variabeln med streck, vid vilka förhållandet med nästa tillstånd är sant. Detta är inte svårt att göra, men jag kommer inte att ge exempel just nu.
För att skapa ett fungerande verktyg behövs formell matematik. Hur gör man en specifikation formell? För detta behöver vi ett formellt språk, till exempel, . Specifikationen av Euklides algoritm skulle se ut så här på detta språk:
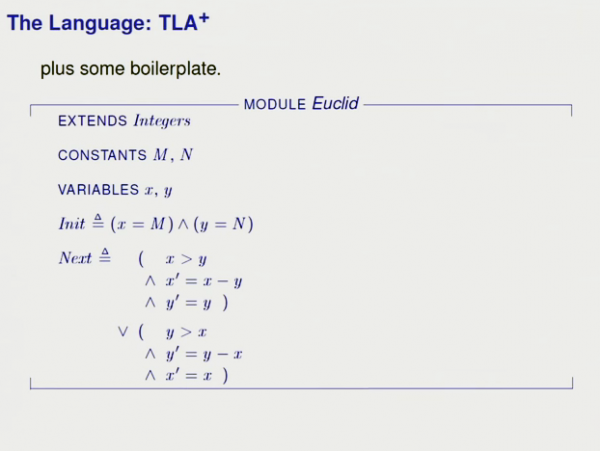
Symbolen för likhet med en triangel betyder att värdet till vänster om tecknet definieras som lika med värdet till höger om tecknet. I huvudsak är en specifikation en definition, i vårt fall två definitioner. Till specifikationen i TLA+ måste man lägga till deklarationer och viss syntax, som på bilden ovan. I ASCII skulle det se ut så här:
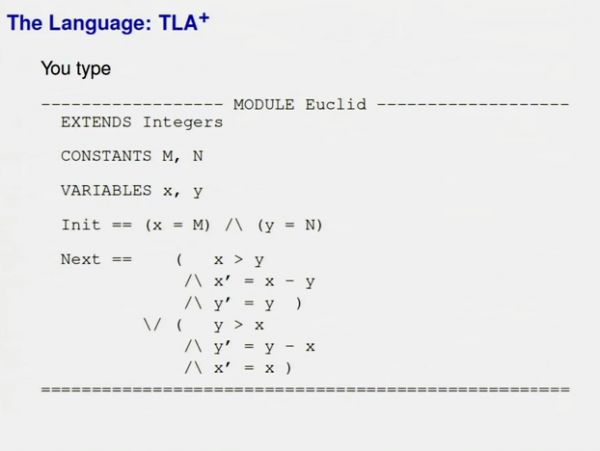
Som vi ser är ingenting komplicerat. Specifikationen i TLA+ kan verifieras, det vill säga alla möjliga beteenden kan granskas i en liten modell. I vårt fall kommer denna modell att vara specifika värden M och N. Detta är ett mycket effektivt och enkelt sätt att verifiera på, som helt och hållet utförs automatiskt. Dessutom kan man skriva formella bevis för sanningen och verifiera dem mekaniskt, men det kräver mycket tid, därför görs det sällan.
Den största nackdelen med TLA+ är att det är matematik, och programmerare och datavetare är rädda för matematik. Vid första anblick låter detta som ett skämt, men tyvärr säger jag detta helt seriöst. Min kollega berättade just för mig hur han försökte förklara TLA+ för flera utvecklare. Så fort formlerna dök upp på skärmen fick de genast glasartade ögon. Så om TLA+ skrämmer, kan man använda , som är en slags lekspråk för programmering. Uttrycken i PlusCal kan vara vad som helst som TLA+ uttrycker, det vill säga, i stort sett vilket matematiskt uttryck som helst. Dessutom har PlusCal syntax för icke-deterministiska algoritmer. Tack vare att man kan uttrycka vilket TLA+-uttryck som helst i PlusCal, är den betydligt mer uttrycksfull än något verkligt programmeringsspråk. Vidare kompileras PlusCal till en lättläst specifikation av TLA+. Detta innebär givetvis inte att en komplex PlusCal-specifikation blir enkel i TLA+ — det finns bara en uppenbar överensstämmelse mellan dem, ingen extra komplexitet framträder. Slutligen kan den specifikationen kontrolleras med TLA+ verktyg. Sammanfattningsvis kan PlusCal hjälpa till att övervinna rädslan för matematik, det är lätt att förstå även för programmerare och datavetare. Tidigare publicerade jag under en tid (ungefär 10 år) algoritmer på det.
Möjligen kan någon invända att TLA+ och PlusCal är matematik, och matematik fungerar bara på påhittade exempel. I praktiken behövs ett verkligt språk med typer, procedurer, objekt och så vidare. Så är det inte. Här är vad Chris Newcomb, som arbetat på Amazon, skriver: „Vi använde TLA+ i tio stora projekt, och i varje fall bidrog dess användning betydligt till utvecklingen, eftersom vi kunde fånga farliga buggar innan de kom till produktion, och för att det gav oss förståelsen och tryggheten som behövdes för aggressiva optimeringar av prestanda utan att påverka programmets sanningsenlighet“. Man hör ofta att användning av formella metoder ger ineffektiv kod — i praktiken är det dock precis tvärtom. Dessutom finns det en uppfattning om att det är omöjligt att övertyga chefer om behovet av formella metoder, även när programmerare är övertygade om deras nyttighet. Och Newcomb skriver: Managerna uppmuntrar nu på alla sätt att skriva specifikationer på TLA+, och avsätter särskild tid för detta.. Så när managerna ser att TLA+ fungerar, tar de gladeligen till sig det. Chris Newcomb skrev detta för ungefär sex månader sedan (i oktober 2014), och såvitt jag vet används TLA+ nu i 14 projekt, inte 10. Ett annat exempel rör designen av XBox 360. En praktikant kom till Charles Ticker och skrev en specifikation för minnessystemet. Tack vare denna specifikation upptäcktes en bugg som annars inte skulle ha märkts, och som skulle ha fått varje XBox 360 att krascha efter fyra timmars användning. Ingenjörer från IBM bekräftade att deras tester inte skulle ha upptäckt denna bugg.
Du kan läsa mer om TLA+ på internet, men nu låt oss prata om informella specifikationer. Vi skriver sällan program som beräknar det minsta gemensamma multipel och liknande. Mycket oftare skriver vi program som ett verktyg för strukturell utskrift (pretty-printer), som jag skrev för TLA+. Efter den enklaste bearbetningen skulle koden på TLA+ se ut så här:
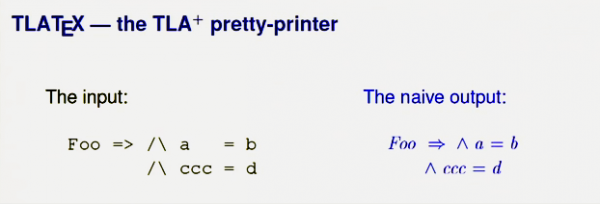
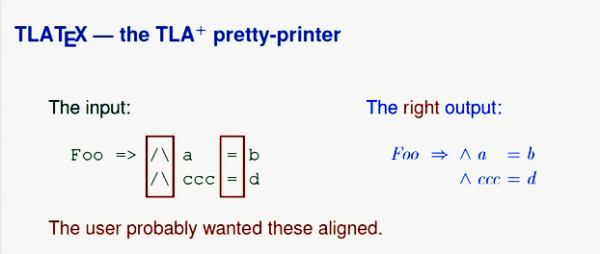
Men i det givna exemplet ville användaren förmodligen att konjunktions- och likhetstecknen skulle vara justerade. Så det korrekta formatet skulle se ut så här:
Låt oss titta på ett annat exempel:
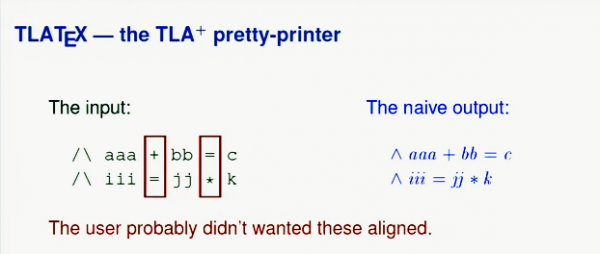
Här var däremot justeringen av likhetstecken, additions- och multiplikationstecken i källan slumpmässig, så den enklaste bearbetningen räcker gott. Generellt finns det ingen exakt matematisk definition av korrekt formatering, eftersom "korrekt" i detta fall betyder "såsom användaren önskar", och det är matematiskt omöjligt att definiera.
Det verkar som att om vi inte har en definition av sanningsenlighet, är specifikationen värdelös. Men så är det inte. Om vi inte vet exakt vad programmet ska göra, betyder det inte att vi inte behöver tänka på dess funktion — tvärtom, vi bör lägga ännu mer tid på detta. Specifikationen är särskilt viktig här. Det är omöjligt att definiera det optimala programmet för strukturell utskrift, men det betyder inte att vi inte ska arbeta med det överhuvudtaget; att skriva kod som en ström av medvetande är inte rätt metod. Slutligen skrev jag en specifikation med sex regler med definitioner i form av kommentarer i Java-filen. Här är ett exempel på en av reglerna: en left-comment-token är LeftComment som är anpassat till sin överordnande token. Denna regel är skriven på, låt oss säga, matematisk engelska: LeftComment anpassat, left-comment och överordnad token — termer med definitioner. Så här beskriver matematiker matematik: de skriver definitioner av termer och baserat på dem — regler. Fördelen med en sådan specifikation är att det är betydligt enklare att förstå och felsöka sex regler än 850 rader kod. Jag måste säga att det var inte lätt att skriva dessa regler, det tog ganska mycket tid att felsöka dem. Speciellt för detta syfte skrev jag en kod som meddelade vilken regel som användes. Tack vare att jag testade dessa sex regler med flera exempel behövde jag inte felsöka 850 rader kod, och buggarna visade sig vara ganska lätta att hitta. I Java finns det utmärkta verktyg för detta. Om jag bara hade skrivit koden skulle det ha tagit betydligt mer tid, och formatet skulle ha blivit av sämre kvalitet.
Varför kunde man inte använda en formell specifikation? Å ena sidan är korrektheten i detta fall inte så viktig. Strukturell utskrift kommer definitivt att ogillas av någon, så jag behövde inte sträva efter att få det att fungera korrekt i alla ovanliga situationer. Ännu viktigare är att jag inte hade adekvata verktyg. Ett verktyg för att kontrollera TLA+-modeller är här värdelöst, så jag skulle behöva skriva exempel manuellt.
Den angivna specifikationen har drag som är gemensamma för alla specifikationer. Den är på en högre nivå än kod. Den kan implementeras på vilket språk som helst. För att skriva den är verktyg eller metoder onödiga. Ingen programmeringskurs kommer att hjälpa dig skriva denna specifikation. Och det finns inga verktyg som skulle kunna göra denna specifikation onödig, såvida du inte skriver ett språk speciellt för att skriva program för strukturell utskrift på TLA+. Slutligen säger denna specifikation ingenting om hur vi faktiskt kommer att skriva kod, den anger bara vad denna kod gör. Vi skriver specifikationen för att hjälpa oss tänka igenom problemet innan vi börjar tänka på koden.
Men denna specifikation har också egenskaper som skiljer den från andra specifikationer. 95 % av andra specifikationer är betydligt kortare och enklare:
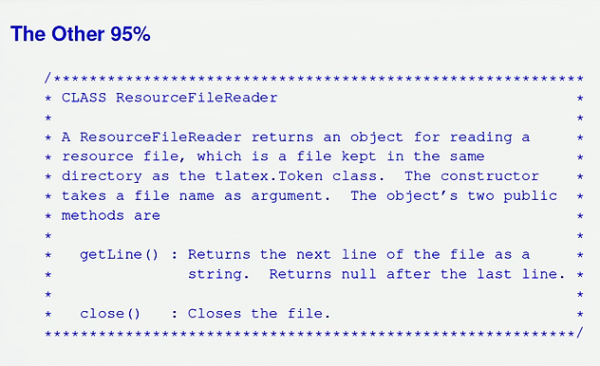
Vidare är denna specifikation en uppsättning regler. I allmänhet är detta ett tecken på en dålig specifikation. Att förstå konsekvenserna av en uppsättning regler är ganska svårt, och det är därför jag har fått spendera mycket tid på att debugga dem. Ändå så fann jag inget bättre sätt i det här fallet.
Det är värt att säga några ord om program som körs kontinuerligt. Som regel arbetar de parallellt, till exempel operativsystem eller distribuerade system. Att förstå dem i huvudet eller på papper kan mycket få, och jag räknar inte mig själv bland dem, även om det en gång var möjligt för mig. Därför behövs verktyg som kan kontrollera vårt arbete — till exempel TLA+ eller PlusCal.
Varför behövde jag skriva en specifikation, om jag redan visste vad koden skulle göra? Egentligen trodde jag bara att jag visste det. Dessutom, med en specifikation behöver en utomstående person inte längre gå in i koden för att förstå vad den gör. Jag har en regel: det ska inte finnas några allmänna regler. Denna regel har dock ett undantag, den är den enda allmänna regeln som jag följer: specifikationen för vad koden gör ska informera människor om allt de behöver veta när de använder denna kod.
Så vad behöver programmerare veta om tänkande? Först och främst, samma som alla andra: om du inte skriver, så verkar det bara som om du tänker. Dessutom måste man tänka innan man kodar, vilket betyder att man måste skriva innan man kodar. Specifikationen är det vi skriver innan vi börjar koda. Specifikationen behövs för all kod som kan användas eller ändras av någon annan. Och denna "någon annan" kan mycket väl vara kodens skapare en månad efter att den skrivits. Specifikationer behövs för stora program och system, för klasser, för metoder och ibland även för komplexa delar av enskilda metoder. Vad behöver man skriva om koden? Man bör beskriva vad den gör, det vill säga det som kan vara användbart för alla som använder denna kod. Ibland kan det också vara nödvändigt att ange hur precis koden når sitt mål. Om vi har gått igenom den metoden under algoritmkurser kallar vi det för en algoritm. Om det är något mer speciellt och nytt kallar vi det för högnivådesign. Det finns ingen formell skillnad här: båda är abstrakta modeller av programmet.
Hur ska man skriva en kodspecifikation? Det viktigaste: den bör vara ett steg högre än själva koden. Den bör beskriva tillstånd och beteenden. Den måste vara så strikt som uppgiften kräver. Om du skriver en specifikation för hur en uppgift ska implementeras kan den skrivas i pseudokod eller med PlusCal. Att lära sig skriva specifikationer bör göras på formella specifikationer. Det kommer att ge dig de nödvändiga färdigheterna som också hjälper med informella specifikationer. Men hur lär man sig skriva formella specifikationer? När vi lärde oss programmering skrev vi program och felsökte dem. Detsamma gäller här: du måste skriva en specifikation, testa den med ett modellkontrollverktyg och rätta till eventuella fel. TLA+ kanske inte är det bästa språket för formella specifikationer, och för dina specifika behov är det troligt att ett annat språk passar bättre. Fördelen med TLA+ är att det lär ut matematiskt tänkande på ett utmärkt sätt.
Hur kopplar man samman specifikationen och koden? Genom kommentarer som kopplar matematiska koncept till deras implementation. Om du arbetar med grafer kommer du på programnivå att ha arrayer av noder och arrayer av kopplingar. Därför måste du skriva ner hur grafen konkret implementeras med dessa programmeringsstrukturer.
Det är viktigt att notera att inget av det som sagts ovan rör själva kodskrivningsprocessen. När du skriver kod, det vill säga utför det tredje steget, behöver du också tänka och planera programmet. Om en deluppgift visar sig vara komplex eller otydlig, är det nödvändigt att skriva en specifikation för den. Men jag pratar inte om själva koden här. Du kan använda vilket programmeringsspråk eller metodologi som helst, det handlar inte om dem. Dessutom befriar inget av det som sagts ovan från behovet av att testa och debugga koden. Även om den abstrakta modellen är korrekt skriven kan det finnas buggar i dess implementation.
Skrivande av specifikationer är ett extra steg i kodningsprocessen. Tack vare det kan många fel upptäckas med mindre ansträngning — vi vet detta från erfarenheten av programmerare hos Amazon. Med specifikationer blir programkvaliteten högre. Så varför klarar vi oss så ofta utan dem? För att det är svårt att skriva. Och det är svårt att skriva eftersom det kräver eftertanke, och att tänka är också svårt. Det är alltid enklare att låtsas tänka. Här kan man dra en parallell med löpning — ju mindre du springer, desto långsammare springer du. Du behöver träna dina muskler och öva på skrivandet. Praktik är nödvändig.
Specifikationen kan vara felaktig. Du kan ha gjort ett misstag någonstans, eller kraven kan ha förändrats, eller det kan ha blivit nödvändigt att göra förbättringar. All kod som någon använder måste ändras, så förr eller senare kommer specifikationen att sluta överensstämma med programmet. I idealfallet bör man i så fall skriva en ny specifikation och helt skriva om koden. Vi vet mycket väl att ingen gör så. I praktiken patchar vi koden och kanske uppdaterar specifikationen. Men om detta oundvikligen händer förr eller senare, varför ska vi då skriva specifikationer överhuvudtaget? För det första, för den person som kommer att redigera din kod är varje överflödigt ord i specifikationen guld värd, och den personen kan mycket väl vara du själv. Jag klandrar mig ofta för bristande specifikationer när jag redigerar min kod. Och jag skriver fler specifikationer än kod. Därför bör du alltid uppdatera specifikationen när du redigerar koden. För det andra, med varje redigering blir koden sämre, den blir allt svårare att läsa och underhålla. Detta är en ökning av entropin. Men om du inte börjar med en specifikation, så kommer varje rad som skrivs att vara en redigering, och koden kommer från början att bli otymplig och svårläst.
Som Eisenhower sa , ingen strid har vunnits enligt planen, och ingen strid har vunnits utan plan. Och han visste en del om strider. Det finns en åsikt att skriva specifikationer är en slöseri med tid. Ibland är det verkligen så, och uppgiften är så enkel att den inte kräver någon djupare eftertanke. Men man måste alltid komma ihåg att när någon rekommenderar att du inte ska skriva specifikationer, så rekommenderar de att du inte ska tänka. Och detta bör man tänka på varje gång. Att tänka igenom en uppgift garanterar inte att du inte gör misstag. Som vi vet har ingen uppfunnit ett magiskt spö, och programmering är en komplex uppgift. Men om du inte tänker igenom uppgiften, kommer du garanterat att göra misstag.
Du kan läsa mer om TLA+ och PlusCal på en särskild webbplats, som du kan nå från min hemsida . Det var allt för mig, tack för uppmärksamheten.
Jag påminner om att detta är en översättning. När du skriver kommentarer, kom ihåg att författaren inte kommer att läsa dem. Om du verkligen vill kommunicera med författaren så kommer han att vara på konferensen Hydra 2019, som äger rum den 11-12 juli 2019 i Sankt Petersburg. Biljetter kan köpas .
Källa: habr.com
