

Webbapplikationer används nu överallt, och bland alla transportprotokoll står HTTP för en stor del. När man studerar detaljerna i webbapplikationsutveckling ägnar de flesta mycket lite uppmärksamhet åt operativsystemet där dessa applikationer faktiskt körs. Separationen av utveckling (Dev) och drift (Ops) har bara förvärrat situationen. Men med spridningen av DevOps-kulturen börjar utvecklare ta ansvar för att köra sina applikationer i molnet, så det är mycket användbart för dem att förstå operativsystemets backend i detalj. Detta är särskilt värdefullt om du försöker implementera ett system för tusentals eller tiotusentals samtidiga anslutningar.
Begränsningar i webbservrar liknar mycket begränsningar i andra applikationer. Oavsett om det handlar om lastbalanserare eller databasservrar, har alla dessa applikationer liknande problem i högpresterande miljöer. Att förstå dessa grundläggande begränsningar och sätt att övervinna dem kommer generellt att möjliggöra en uppskattning av prestandan och skalbarheten hos dina webbapplikationer.
Jag skriver denna serie artiklar som svar på frågor från unga utvecklare som vill bli väl informerade systemarkitekter. Det är omöjligt att tydligt förstå metoder för optimering av Linux-applikationer utan att dyka ner i grunderna för hur de fungerar på operativsystemsnivå. Även om det finns många typer av applikationer, vill jag i denna cykel utforska nätverksapplikationer snarare än stationära, som webbläsare eller textredigerare. Detta material riktar sig till utvecklare och arkitekter som vill förstå hur Linux- eller Unix-program fungerar och hur de struktureras för hög prestanda.
Linux är en serverbaserad operativsystem, och oftast körs dina applikationer just på detta OS. Även om jag säger "Linux", kan du nästan alltid med säkerhet anta att det syftar på alla Unix-liknande operativsystem i allmänhet. Jag har dock inte testat den medföljande koden på andra system. Så om du är intresserad av FreeBSD eller OpenBSD kan resultaten variera. När jag testar något som är specifikt för Linux, markerar jag det.
Även om du kan använda den kunskap du får för att skapa en applikation från grunden och att den kan bli väloptimerad, är det bäst att undvika det. Om du skriver en ny webbserver i C eller C++ för ditt företags affärsapplikation, kan det bli din sista dag på jobbet. Men att ha kunskap om strukturen hos dessa applikationer kommer att hjälpa vid valet av redan existerande program. Du kommer att kunna jämföra system baserat på processer med system baserade på trådar, liksom händelsebaserade system. Du kommer att förstå och uppskatta varför Nginx fungerar bättre än Apache httpd, och varför en Python-applikation baserad på Tornado kan hantera fler användare jämfört med en Python-applikation baserad på Django.
ZeroHTTPd: utbildningsverktyg
— en webbserver som jag har skrivit från grunden i C som ett utbildningsverktyg. Den har inga externa beroenden, inklusive tillgång till Redis. Vi kör våra egna Redis-rutiner. Läs mer nedan.
Även om vi skulle kunna diskutera teorin länge, finns det inget bättre än att skriva kod, köra den och jämföra alla serverarkitekturer. Det är den mest visuella metoden. Därför kommer vi att skriva en enkel webbserver, ZeroHTTPd, med varje modell: baserat på processer, trådar och händelser. Vi kommer att testa var och en av dessa servrar och se hur de fungerar jämfört med varandra. ZeroHTTPd är implementerad i en enda C-fil. Servern för händelsehantering inkluderar , en utmärkt implementation av en hash-tabell som levereras i en enda header-fil. I övrigt finns inga beroenden för att inte komplicera projektet.
Koden innehåller många kommentarer för att hjälpa till att förstå. Som en enkel webbserver i några få rader kod är ZeroHTTPd också en minimal ram för webbutveckling. Den har begränsad funktionalitet, men den kan leverera statiska filer och mycket enkla "dynamiska" sidor. Jag måste säga att ZeroHTTPd är väl lämpad för att lära sig hur man skapar högpresterande Linux-applikationer. I huvudsak väntar de flesta webbservrar på förfrågningar, verifierar dem och bearbetar dem. Det är precis vad ZeroHTTPd kommer att göra. Det är ett verktyg för utbildning, inte för produktion. Det är inte bra på felhantering och kommer troligen inte att skryta med bästa säkerhetspraxis (åh ja, jag använde strcpy) eller krångliga tricks med C-språket. Men jag hoppas att det kommer att klara uppgiften bra.
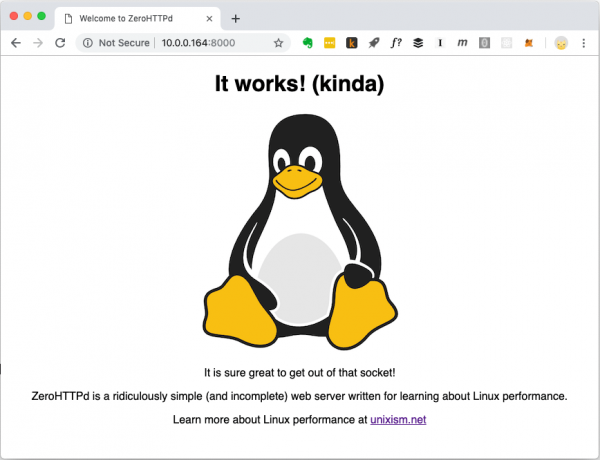
Startsidan för ZeroHTTPd. Den kan leverera olika typer av filer, inklusive bilder
Gästboksapplikation
Moderna webbapplikationer är vanligtvis inte begränsade till statiska filer. De har komplexa interaktioner med olika databaser, cachear, osv. Därför kommer vi att skapa en enkel webbapplikation som heter "Gästbok", där besökare lämnar meddelanden under sina namn. Gästboken sparar tidigare lämnade meddelanden. Det finns också en besöksräknare längst ner på sidan.
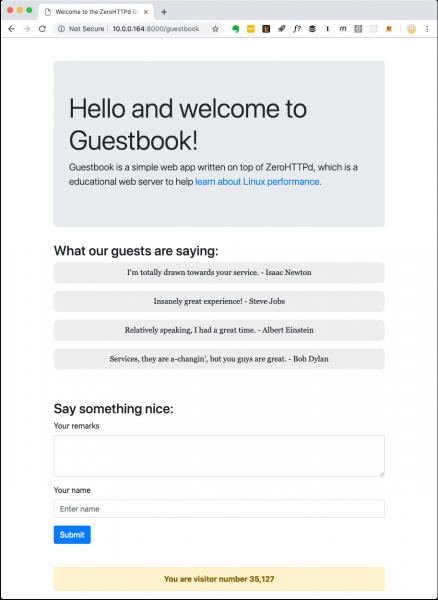
Webbapplikationen "Gästbok" för ZeroHTTPd
Besöksräknaren och meddelandena i gästboken lagras i Redis. För kommunikation med Redis har vi implementerat egna procedurer som inte är beroende av externa bibliotek. Jag är ingen stort fan av att lansera hemgjord kod när det finns offentliga och väl testade lösningar. Men målet med ZeroHTTPd är att studera prestanda i Linux och tillgång till externa tjänster, medan hanteringen av HTTP-förfrågningar allvarligt påverkar prestandan. Vi måste ha full kontroll över kommunikationen med Redis i varje vår serverarkitektur. I en arkitektur använder vi blockerande anrop, i andra händelsebaserade procedurer. Användning av ett externt Redis-klientbibliotek kommer inte att ge den kontroll vi behöver. Dessutom utför vår lilla Redis-klient bara några få funktioner (hämta, ställa in och öka nyckeln; hämta och lägga till i en array). Dessutom är Redis-protokollet oerhört elegant och enkelt. Man behöver faktiskt inte lära sig det specifikt. Faktumet att hela arbetet protokollet utförs i ungefär hundra rader kod talar för hur väl genomtänkt det är.
Följande bild visar applikationens aktiviteter när klienten (webbläsaren) gör en begäran /guestbookURL.

Hur gästboksapplikationen fungerar
När en gästboksida ska returneras görs ett anrop till filsystemet för att läsa in mallen i minnet och tre nätverksanrop till Redis. Mallfilen innehåller största delen av HTML-innehållet för sidan i skärmdumpen längst upp. Det finns också speciella platshållare för den dynamiska delen av innehållet: poster och besöksräknare. Vi hämtar dem från Redis, infogar dem på sidan och levererar helt färdigt innehåll till klienten. Det tredje Redis-anropet kan undvikas, eftersom Redis returnerar det nya värdet för nyckeln vid varje ökning. Men för vår server med en asynkron händelsebaserad arkitektur är många nätverksanrop en bra utmaning för utbildningssyften. Därför släpper vi det returnerade värdet från Redis om antalet besökare och begär det med ett separat anrop.
ZeroHTTPd-serverarkitekturer
Vi bygger sju versioner av ZeroHTTPd med samma funktionalitet men olika arkitekturer:
- Iterativ
- Fork-server (en underprocess per anrop)
- Pre-fork-server (förhandsforkning av processer)
- Server med trådar (en tråd per anrop)
- Server med förskapat trådar
- Arkitektur baserad på
poll() - Arkitektur baserad på
epoll
Vi mäter prestandan för varje arkitektur genom att belasta servern med HTTP-anrop. Men vid jämförelse av arkitekturer med hög parallellism ökar antalet anrop. Vi testar tre gånger och räknar medelvärdet.
Testmetodik
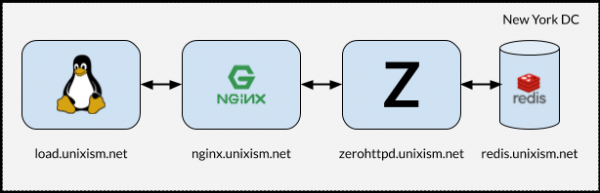
Inställning för belastningstest av ZeroHTTPd
Det är viktigt att vid genomförandet av testerna inte alla komponenter körs på samma maskin. I så fall bär operativsystemet på extra overhead för schemaläggning, eftersom komponenterna tävlar om CPU-resurser. Att mäta operativsystemets overhead med varje av de valda serverarkitekturerna är ett av de mest avgörande målen med denna övning. Att lägga till fler variabler kan vara skadligt för processen. Därför fungerar inställningen i bilden ovan bäst.
Vad gör var och en av dessa servrar
- load.unixism.net: här kör vi
ab, verktyget Apache Benchmark. Det genererar den belastning som behövs för att testa våra serverarkitekturer. - nginx.unixism.net: ibland vill vi köra mer än ett instans av serverprogrammet. För detta fungerar Nginx-servern med rätt inställningar som en belastningsbalanserare för inkommande trafik från ab våra serverprocesser.
- zerohttpd.unixism.net: här kör vi våra serverprogram på sju olika arkitekturer, en i taget.
- redis.unixism.net: på denna server körs Redis-demonen, där uppgifter för gästboken och besökarräknaren lagras.
Alla servrar arbetar på en enda CPU-kärna. Idén är att bedöma den maximala prestandan hos varje arkitektur. Eftersom alla serverprogram testas på samma hårdvara, är detta grundnivån för jämförelse. Min testuppsättning består av virtuella servrar hyrda från Digital Ocean.
Vad mäter vi?
Olika mått kan mätas. Vi bedömer prestandan hos varje arkitektur i denna konfiguration genom att belasta servrarna med förfrågningar på olika nivåer av parallellism: belastningen ökar från 20 till 15 000 samtidiga användare.
Testresultat
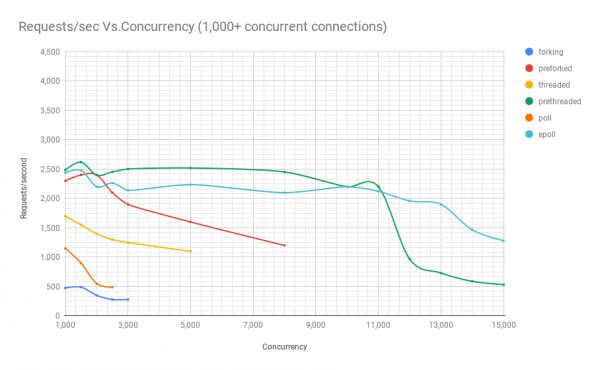
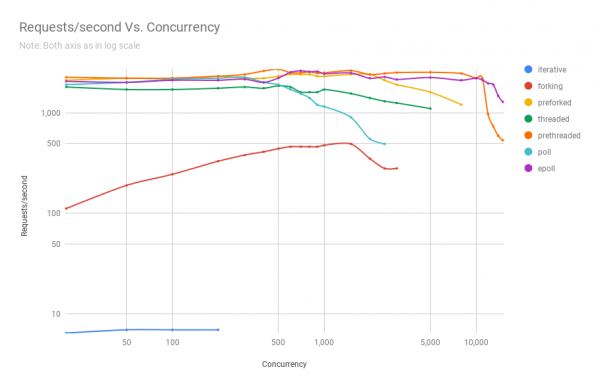
I det följande diagrammet visas servernas prestanda på olika arkitekturer vid olika nivåer av parallellism. På y-axeln — antalet förfrågningar per sekund, på x-axeln — parallella anslutningar.
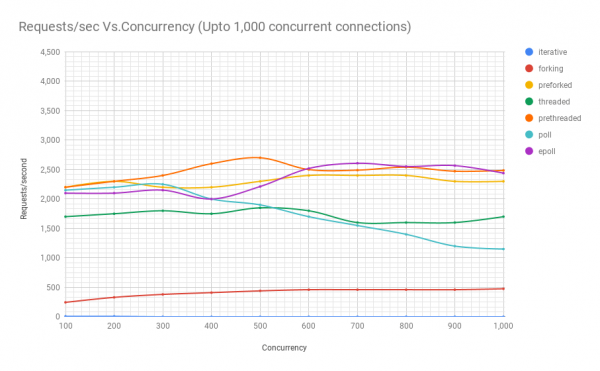
Nedan är tabellen med resultaten.
förfrågningar per sekund
parallellism
process.
fork
pre-fork
trådad
pre-trådad
poll
epoll
20
7
112
2100
1800
2250
1900
2050
50
7
190
2200
1700
2200
2000
2000
100
7
245
2200
1700
2200
2150
2100
200
7
330
2300
1750
2300
2200
2100
300
–
380
2200
1800
2400
2250
2150
400
–
410
2200
1750
2600
2000
2000
500
–
440
2300
1850
2700
1900
2212
600
–
460
2400
1800
2500
1700
2519
700
–
460
2400
1600
2490
1550
2607
800
–
460
2400
1600
2540
1400
2553
900
–
460
2300
1600
2472
1200
2567
1000
–
475
2300
1700
2485
1150
2439
1500
–
490
2400
1550
2620
900
2479
2000
–
350
2400
1400
2396
550
2200
2500
–
280
2100
1300
2453
490
2262
3000
–
280
1900
1250
2502
stor spridning
2138
5000
–
stor spridning
1600
1100
2519
–
2235
8000
–
–
1200
stor spridning
2451
–
2100
10 000
–
–
stor spridning
–
2200
–
2200
11 000
–
–
–
–
2200
–
2122
12 000
–
–
–
–
970
–
1958
13 000
–
–
–
–
730
–
1897
14 000
–
–
–
–
590
–
1466
15 000
–
–
–
–
532
–
1281
Från diagrammet och tabellen kan vi se att vid över 8000 samtidiga förfrågningar kvarstår bara två aktörer: pre-fork och epoll. Med ökande belastning presterar poll-baserade servrar sämre än trådarna. Arkitekturen med förhandskapade trådar är en värdig konkurrent till epoll: detta visar hur väl Linux-kärnan planerar ett stort antal trådar.
Källkoden för ZeroHTTPd
Källkoden för ZeroHTTPd . För varje arkitektur finns en separat katalog.
ZeroHTTPd
│
├── 01_iterative
│   ├── main.c
├── 02_forking
│   ├── main.c
├── 03_preforking
│   ├── main.c
├── 04_threading
│   ├── main.c
├── 05_prethreading
│   ├── main.c
├── 06_poll
│   ├── main.c
├── 07_epoll
│    └── main.c
├── Makefile
├── public
│   ├── index.html
│   └── tux.png
└── templates
    └── guestbook
        └── index.html
Förutom de sju katalogerna för alla arkitekturer finns det två ytterligare i rotkatalogen: public och templates. I den första finns filen index.html och en bild från den första skärmdumpen. Dit kan man lägga andra filer och mappar, och ZeroHTTPd bör utan problem kunna leverera dessa statiska filer. Om sökvägen i webbläsaren motsvarar sökvägen i mappen public, letar ZeroHTTPd efter filen index.html i denna katalog. Innehållet för gästboken genereras dynamiskt. Den har bara en huvudpage, och dess innehåll baseras på filen ‘templates/guestbook/index.html’. Det är enkelt att lägga till dynamiska sidor i ZeroHTTPd för utvidgning. Idén är att användare kan lägga till mallar i denna katalog och utvidga ZeroHTTPd efter behov.
För att bygga alla sju servrar, kör make all från rotkatalogen – och alla byggnationer kommer att dyka upp i denna katalog. Exekverbara filer söker i katalogerna public och templates i den katalog från vilken de körs.
Linux API
För att förstå informationen i denna artikelserie behöver man inte vara särskilt insatt i Linux API. Jag rekommenderar dock att läsa mer om detta ämne, det finns många referensresurser på nätet. Även om vi kommer att beröra flera kategorier av Linux API, kommer vårt fokus huvudsakligen att ligga på processer, trådar, händelser och nätverksstacken. Utöver böcker och artiklar om Linux API, rekommenderar jag även att läsa man-sidorna för systemanrop och de använda biblioteksfunktionerna.
Prestanda och skalbarhet
En observation angående prestanda och skalbarhet. Teoretiskt sett finns det ingen koppling mellan dem. Du kan ha en webbservice som fungerar mycket bra, med svarstid på några millisekunder, men den är överhuvudtaget inte skalbar. På samma sätt kan det finnas en webbapplikation som fungerar dåligt och kräver flera sekunder för att svara, men den kan skalas till tiotals för att hantera tiotusentals samtidiga användare. Trots detta är en kombination av hög prestanda och skalbarhet en mycket kraftfull kombination. Högpresterande applikationer använder generellt sett resurser sparsamt och kan därmed effektivt betjäna fler samtidiga användare på servern, vilket sänker kostnaderna.
CPU- och I/O-uppgifter
I beräkningar finns det alltid två möjliga typer av uppgifter: för I/O och CPU. Att hämta förfrågningar via internet (nätverksin- och utmatning), hantera filer (nätverks- och disk I/O), kommunicera med databasen (nätverks- och disk I/O) - allt detta är I/O-åtgärder. Vissa databasförfrågningar kan något belasta CPU:n (sortering, beräkning av genomsnittet av en miljon resultat osv.). De flesta webbapplikationer är begränsade av maximalt möjliga I/O, medan processorn sällan används på full kapacitet. När du ser att en viss I/O-uppgift använder mycket CPU, är det troligtvis ett tecken på dålig applikationsarkitektur. Det kan innebära att CPU-resurser spenderas på processhantering och kontextväxling - vilket inte är särskilt användbart. Om du gör något som bildbehandling, konvertering av ljudfiler eller maskininlärning, kräver applikationen då kraftfulla CPU-resurser. Men för de flesta applikationer är det inte fallet.
Mer om serverarkitekturer
Källa: habr.com
