

I dag ska vi diskutera hur man bäst lagrar data i en värld där femte generationens nätverk, genomgångsscannrar och självkörande bilar producerar mer data på en dag än vad mänskligheten har genererat fram till den industriella revolutionen.
Vår värld genererar allt mer information. En del av denna är tillfällig och går förlorad lika snabbt som den samlas in. Annan information måste lagras under en längre tid, och en del är avsedd "för evigt" - åtminstone är det så vi uppfattar det nu. Informativa flöden lagras i datacenter med sådan hastighet att varje ny metod, varje teknologi avsedd att tillfredsställa denna oändliga "efterfrågan", snabbt blir föråldrad.
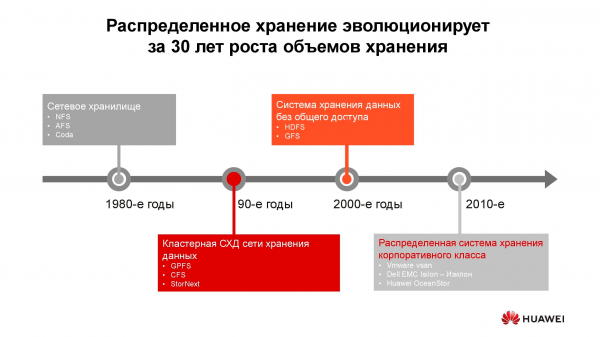
40 års utveckling av distribuerad lagring
De första nätverkslagringarna i den form vi känner dem kom på 1980-talet. Många av er har stött på NFS (Network File System), AFS (Andrew File System) eller Coda. Efter ett årtionde hade modet och teknologin förändrats, och de distribuerade filsystemen fick ge vika för klusterlagringssystem baserade på GPFS (General Parallel File System), CFS (Clustered File Systems) och StorNext. Som bas användes blocklagringssystem av klassisk arkitektur, ovanpå vilka en enhetlig filsystem skapades med hjälp av mjukvarulager. Dessa och liknande lösningar används fortfarande, har sin nisch och är ganska efterfrågade.
Vid millennieskiftet ändrades paradigmet för distribuerad lagring något, och system med arkitektur SN (Shared-Nothing) kom i främsta rummet. Övergången skedde från klusterlagring till lagring på separata noder, där klassiska servrar som tillhandahöll pålitlig lagringsprogramvara vanligtvis fungerade som nod. På dessa principer är HDFS (Hadoop Distributed File System) och GFS (Global File System) baserade.
Närmare 2010 började koncepten som låg till grund för distribuerade lagringssystem allt oftare speglas i fullfjädrade kommersiella produkter, såsom VMware vSAN, Dell EMC Isilon och vår . Bakom dessa plattformar står inte längre en gemenskap av entusiaster, utan specifika leverantörer som ansvarar för funktionaliteten, supporten, tjänstedesign och garanterar dess fortsatta utveckling. Sådana lösningar är mest efterfrågade inom flera områden.
Telekommunikationsoperatörer
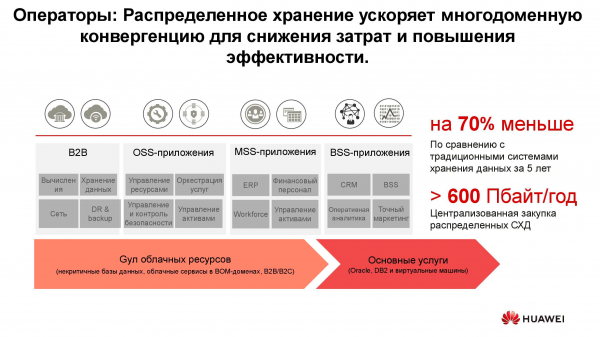
Kanske är en av de äldsta användarna av distribuerade lagringssystem teleoperatörer. Schemat visar vilka grupper av applikationer som producerar den största datamängden. OSS (Operations Support Systems), MSS (Management Support Services) och BSS (Business Support Systems) utgör tre kompletterande programskikt som krävs för att tillhandahålla tjänster till abonnenter, finansrapportering till leverantören och driftstöd till operatörens ingenjörer.
Ofta är data i dessa skikt starkt sammanblandade, och för att undvika uppbyggnad av onödiga kopior används just distribuerade lagringssystem som samlar all information som kommer från det aktiva nätet. Lagringarna sammanfogas i en gemensam pool som alla tjänster får åtkomst till.
Våra beräkningar visar att övergången från klassiska lagringssystem till blocklagring kan spara upp till 70% av budgeten bara genom att avstå från dedikerade lagringssystem av hi-end klass och använda vanliga servrar av klassisk arkitektur (vanligtvis x86), som arbetar i samverkan med specialiserad programvara. Mobiloperatörer har redan länge börjat köpa sådana lösningar i betydande volymer. Särskilt har ryska operatörer använt sådana produkter från Huawei i mer än sex år.
Ja, vissa uppgifter går inte att genomföra med hjälp av distribuerade system. Till exempel, vid högre krav på prestanda eller kompatibilitet med gamla protokoll. Men minst 70% av den data som operatören bearbetar kan utan problem placeras i en distribuerad pool.
Banksektorn
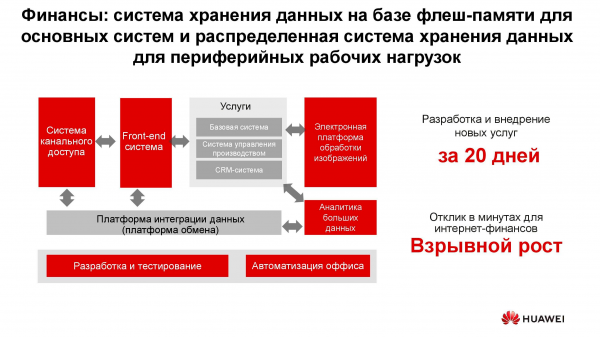
I varje bank finns det en mängd olika IT-system, från processering till automatiserade banksystem. Denna infrastruktur arbetar också med stora volymer information, där en stor del av uppgifterna inte kräver hög prestanda och tillförlitlighet från lagringssystemet, till exempel utveckling, testning, automatisering av kontorsprocesser, etc. Här är användningen av klassiska lagringssystem möjlig, men blir med varje år allt mindre lönsam. Dessutom saknas i det här fallet flexibilitet i resursanvändningen av lagringssystemet, vars prestanda beräknas utifrån den maximala belastningen.
När man använder distribuerade lagringssystem kan deras noder, som i själva verket är vanliga servrar, när som helst konverteras till exempelvis en serverfarm och användas som en databehandlingsplattform.
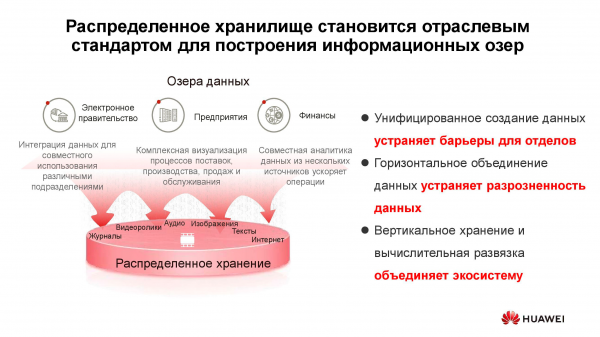
Datadammar
I schemat ovan presenteras en lista över typiska användare av tjänster . Det kan vara myndighetstjänster (som "Mina meddelanden"), som har genomgått digitalisering, finansiella institutioner med mera. Alla behöver arbeta med stora mängder heterogen information.
Att använda klassiska lagringssystem för att lösa sådana uppgifter är ineffektivt, eftersom det krävs både högpresterande åtkomst till blockdatabaser och vanlig åtkomst till bibliotek med skannade dokument som lagras som objekt. Hit kan även ett beställningssystem via webportalen kopplas. För att allt detta ska kunna genomföras på en klassisk lagringsplattforms krävs en stor uppsättning utrustning för olika uppgifter. Ett horisontellt och universellt lagringssystem kan mycket väl omfatta alla tidigare nämnda uppgifter: det krävs bara att skapa flera pooler med olika lagringskarakteristika.
Nya informationsgeneratorer
Mängden information som lagras i världen ökar med cirka 30% varje år. Det är goda nyheter för leverantörer av lagringssystem, men vad är och kommer att vara den huvudsakliga källan till dessa data?
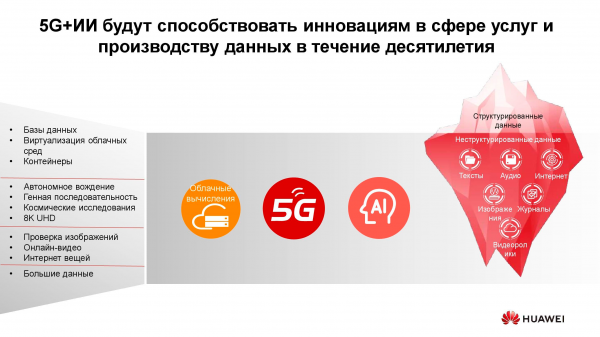
För tio år sedan blev sociala nätverk sådana generatorer, vilket krävde skapandet av ett stort antal nya algoritmer, hårdvarulösningar med mera. Just nu framhävs tre huvudsakliga tillväxtdrivare för lagringsvolymer. Den första är molntjänster. I nuläget använder cirka 70% av företagen på något sätt molntjänster. Det kan vara e-postsystem, säkerhetskopior och andra virtualiserade enheter.
Den andra drivkraften blir 5G-nätverk. Det handlar om nya hastigheter och nya datavolymer. Enligt våra prognoser kommer den breda spridningen av 5G att leda till minskad efterfrågan på flashminneskort. Oavsett hur mycket minne en telefon har, tar det slut, och med en 100-megabit kanal i en enhet finns det ingen anledning att lagra bilder lokalt.
Den tredje gruppen av orsaker till den ökade efterfrågan på lagringssystem omfattar den snabba utvecklingen av artificiell intelligens, övergången till big data-analys och trenden mot allmän automatisering av allt möjligt.
Ett kännetecken för "ny trafik" är dess Vi måste lagra dessa data utan att definiera deras format. Det krävs endast vid senare läsning. Till exempel kommer ett banksystem för kreditbedömning att titta på bilder som du har lagt upp på sociala medier för att avgöra hur ofta du besöker havet och restauranger, samtidigt som det granskar de uttag från dina medicinska dokument som det har tillgång till. Dessa data är å ena sidan omfattande, men å andra sidan saknar de enhetlighet.
Havet av ostrukturerade data
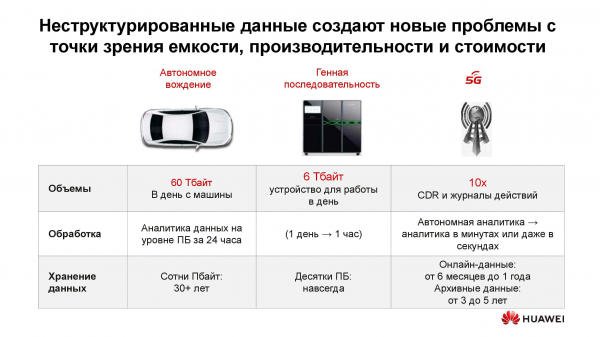
Vilka problem medför egentligen framväxten av "nya data"? Den allra största är förstås själva mängden information och beräknade lagringstider. Bara en modern autonom bil utan förare genererar varje dag upp till 60 TB data från alla sina sensorer och mekanismer. För att utveckla nya köralgoritmer måste denna information bearbetas samma dag, annars kommer den att börja samlas. Samtidigt måste den lagras under mycket lång tid – i årtionden. Endast då kan vi i framtiden dra slutsatser baserade på stora analytiska urval.
En enhet för avkodning av genetiska sekvenser producerar cirka 6 TB per dag. Och de data som samlas in med hjälp av den förutsätter överhuvudtaget ingen radering, vilket betyder att de hypotetiskt sett bör lagras för evigt.
Till sist, allt detta gäller 5G-nätverk. Förutom den information som överförs är ett sådant nätverk dessutom en enorm datagenerator: loggar över aktiviteter, samtalsinspelningar, intermediala resultat av maskininteraktioner med mera.
Allt detta kräver utveckling av nya metoder och algoritmer för lagring och bearbetning av information. Och sådana metoder börjar dyka upp.
Ny era-teknologier
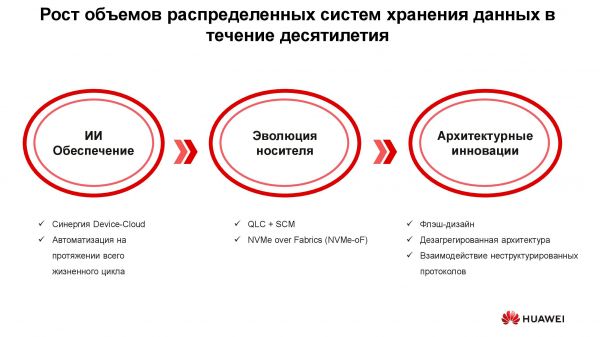
Tre grupper av lösningar kan särskiljas som syftar till att hantera de nya kraven på informationslagringssystem: implementering av artificiell intelligens, teknisk utveckling av lagringsmedia och innovationer inom systemarkitektur. Låt oss börja med AI.
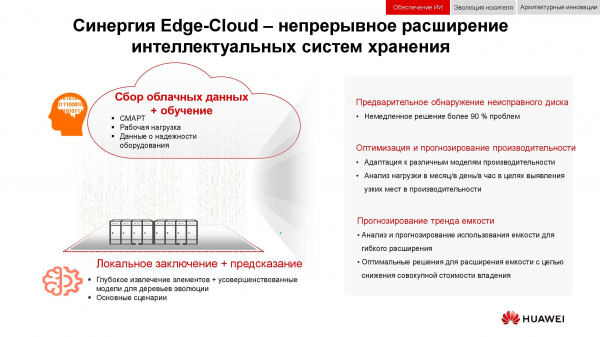
I de nya lösningarna från Huawei används artificiell intelligens redan på nivån av själva lagringssystemet, som är utrustat med en AI-processor som tillåter systemet att självständigt analysera sitt tillstånd och förutsäga fel. Om lagringssystemet kopplas till en tjänst i molnet med betydande beräkningskapacitet kan den artificiella intelligensen bearbeta mer information och öka noggrannheten i sina hypoteser.
Förutom fel kan denna AI förutsäga framtida toppbelastningar och tid kvar till kapacitetsutarmning. Detta möjliggör optimering av prestanda och skalning av systemet innan några oönskade händelser inträffar.
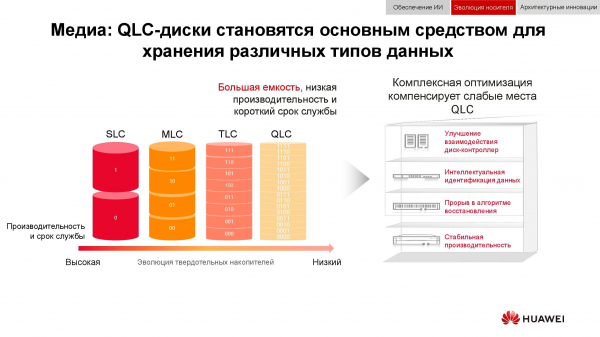
Låt oss nu prata om utvecklingen av lagringsenheter. De första flash-enheterna tillverkades med SLC-teknik (Single-Level Cell). Produkter baserade på denna teknik var snabba, pålitliga och stabila, men hade liten kapacitet och var mycket dyra. En ökning av kapaciteten och en sänkning av priserna har uppnåtts genom vissa tekniska kompromisser, vilket har lett till minskad hastighet, pålitlighet och livslängd för lagringsenheterna. Trots detta har trenden inte påverkat lagringssystemen själva, som genom olika arkitektoniska knep har blivit både mer prestandastarka och mer pålitliga.
Men varför behövdes lagringssystem av typen All-Flash? Var det inte tillräckligt att bara byta ut de gamla HDD:erna i det befintliga systemet mot nya SSD:er av samma formfaktor? Detta var nödvändigt för att på ett effektivt sätt utnyttja alla resurser hos de nya solid-state-enheterna, vilket helt enkelt var omöjligt i de gamla systemen.
Företaget Huawei har till exempel utvecklat en rad teknologier för att lösa detta problem, en av dem är , vilket möjliggjorde максимalt optimerade interaktioner mellan "disk - kontroller".
Intelligent identifiering gjorde det möjligt att dela upp data i flera flöden och hantera en rad oönskade fenomen som (write amplification). Samtidigt har nya återställningsalgoritmer, särskilt , ökat hastigheten på rebuilten och minskat tiden till helt oansenliga mängder.
Fel, överbelastning, "skräpprogrammering" — dessa faktorer påverkar inte längre lagringssystemets prestanda tack vare speciella förbättringar av kontrollerna.
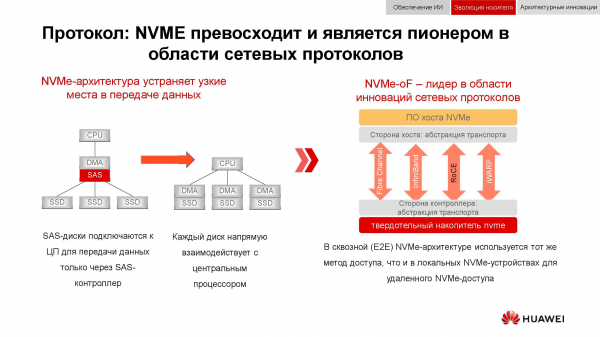
Och blockbaserade datalagringar förbereder sig för att möta . Vi påminner om att den klassiska schemat för dataåtkomst fungerade så här: processorn anslöt till RAID-kontrollern via PCI Express-bussen. Den interagerade i sin tur med mekaniska diskar via SCSI eller SAS. Användningen av NVMe i backend har avsevärt snabbar upp hela processen, men det medföljer en nackdel: lagringsenheterna måste ha en direkt anslutning till processorn för att ge den direkt tillgång till minnet.
Den nästa utvecklingsfasen för teknologin, som vi ser nu, är tillämpningen av NVMe-oF (NVMe over Fabrics). När det gäller Huaweis blockteknologier, så stöder de redan nu FC-NVMe (NVMe över Fibre Channel), och NVMe over RoCE (RDMA over Converged Ethernet) är på ingång. Testmodellerna är fullt funktionella, med bara några månader kvar till deras officiella presentation. Observera att allt detta också kommer att dyka upp i distribuerade system där "Ethernet utan förluster" kommer att vara mycket efterfrågat.
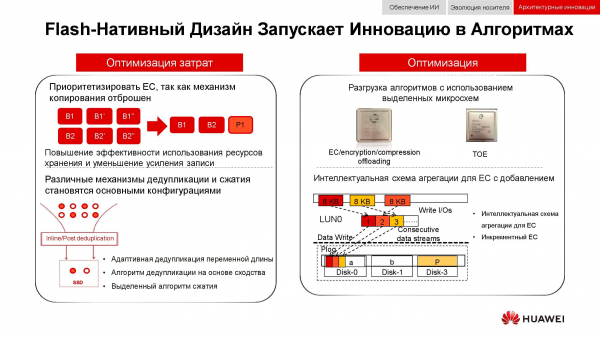
Ett ytterligare sätt att optimera arbetet speciellt med distribuerade lagringssystem har varit att helt avstå från datakopiering. Huaweis lösningar använder inte längre n kopior, som i den bekanta RAID 1, och övergår helt till mekanismen (Erasure coding). Ett särskilt matematiskt paket beräknar med viss periodicitet kontrollblock som möjliggör återställning av mellanliggande data i händelse av förlust.
Mekanismer för deduplicering och komprimering blir obligatoriska. Om vi i klassiska lagringssystem är begränsade av antalet processorer installerade i kontrollenheter, så innehåller varje nod i distribuerade horisontellt skalbara lagringssystem allt som behövs: diskar, minne, processorer och interconnect. Dessa resurser är tillräckliga för att deduplicering och komprimering ska ha minimal påverkan på prestandan.
Och även om hårdvarumetoder för optimering. Här har man lyckats minska belastningen på centrala processorer med hjälp av särskilda dedikerade kretsar (eller dedikerade block i själva processorn) som spelar rollen som (TCP/IP Offload Engine) eller tar på sig de matematiska uppgifterna för EC, deduplicering och komprimering.
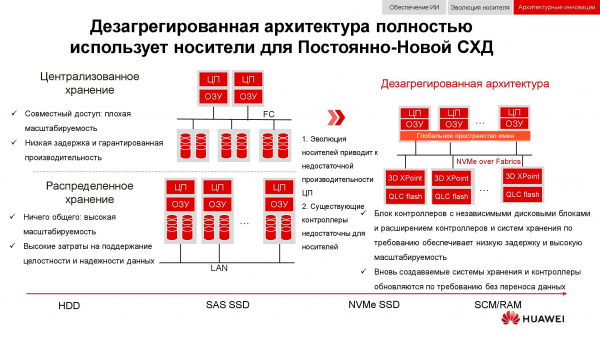
Nya metoder för datalagring har förverkligats i en desaggregerad (distribuerad) arkitektur. I system för centraliserad lagring finns en serverfabrik, som är ansluten via Fibre Channel till ett stort antal matriser. Nackdelarna med denna metod är svårigheter med skalning och att säkerställa en garanterad servicenivå (när det gäller prestanda eller latens). Hyperkonvergerande system använder samma värdar — både för lagring och för att bearbeta information. Detta ger praktiskt taget oändliga skalningsmöjligheter, men medför höga kostnader för att upprätthålla dataintegritet.
Till skillnad från de båda tidigare nämnda, innebär den desaggregerade arkitekturen en uppdelning av systemet i en beräkningsfabrik och ett horisontellt lagringssystem. Detta erbjuder fördelar från båda arkitekturerna och gör det möjligt att praktiskt taget oändligt skala endast den komponent vars prestanda är bristfällig.
Från integration till konvergens
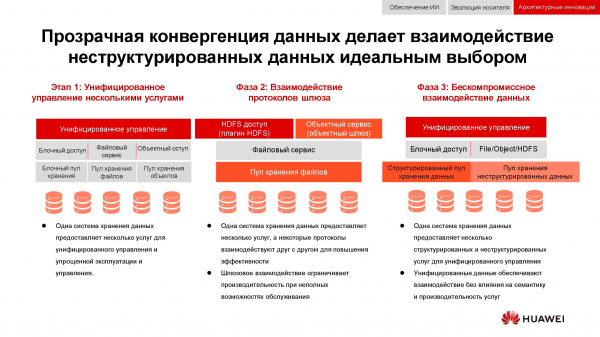
Ett klassiskt problem, vars aktualitet har ökat de senaste 15 åren, är behovet av att samtidigt säkerställa blocklagring, filåtkomst, objektåtkomst, arbete med big data-farmar, och så vidare. En grädden på moset kan vara till exempel ett backup-system för magnetband.
I det första steget kunde endast hanteringen av dessa tjänster enas. Heterogena datalagringssystem knöts till specialiserad programvara, via vilken administratören fördelade resurser från tillgängliga pooler. Men eftersom hårdvarumässigt dessa pooler var olika, var en migrering av belastningen mellan dem omöjlig. På en högre nivå av integration skedde sammanslagningen på gatewaysnivå. Med gemensam filåtkomst kunde den ges via olika protokoll.
Den mest avancerade metoden för konvergens som vi har tillgång till just nu innebär skapandet av ett universellt hybrid-system. Sådant som vårt . Universell åtkomst använder samma hårdvaruresurser, logiskt uppdelade i olika pooler, men tillåter migrering av belastning. Allt detta kan göras genom en единая kontrollkonsol. På så sätt har vi lyckats förverkliga konceptet "ett datacenter — en lagringslösning".
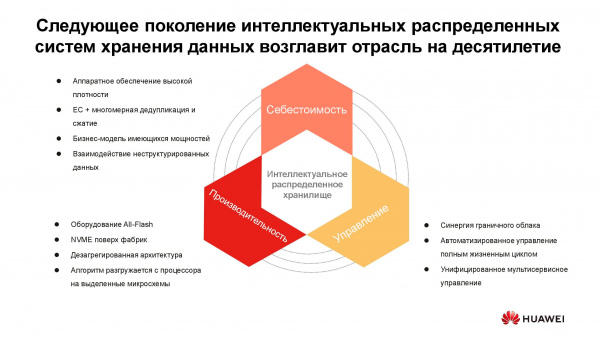
Kostnaden för informationslagring definierar nu många arkitektoniska beslut. Även om detta kan sättas i centrum för diskussionen, pratar vi idag om "levande" lagring med aktiv åtkomst, så prestanda måste också beaktas. En annan viktig egenskap hos nästa generations distribuerade system är enhetlighet. Ingen vill ha flera fristående system som hanteras från olika konsoler. Alla dessa egenskaper har blivit verklighet i den nya produktserien från Huawei. .
Massiv lagringslösning av nästa generation
OceanStor Pacific uppfyller kraven på pålitlighet på nivån "sex nior" (99,9999%) och kan användas för att skapa datacenter av HyperMetro-klass. Vid ett avstånd mellan två datacenter på upp till 100 km uppvisar systemen en extra fördröjning på 2 ms, vilket gör det möjligt att bygga katastrofsäkra lösningar, inklusive med kvorumservrar.
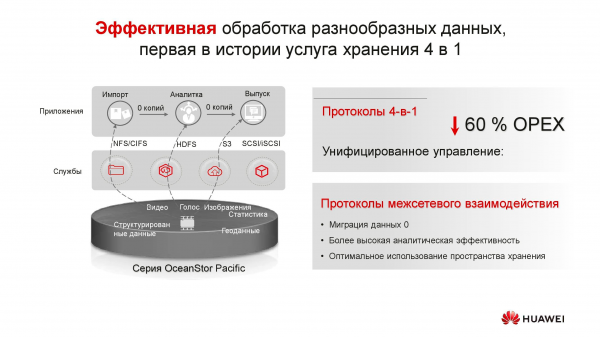
Produkter i den nya serien visar mångsidighet när det gäller protokoll. Redan nu stöder OceanStor 100D blockåtkomst, objektåtkomst och Hadoop-åtkomst. Snart kommer även filåtkomst att implementeras. Det finns ingen anledning att lagra flera kopior av data om de kan levereras via olika protokoll.
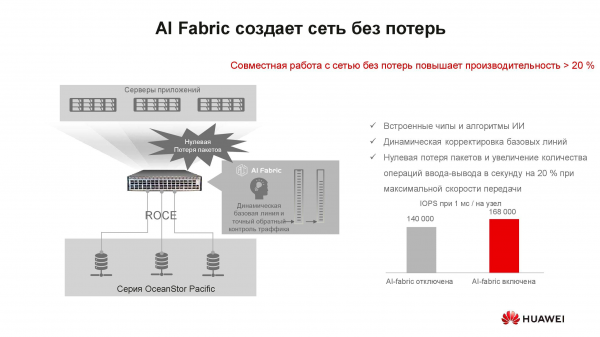
Det kan verka som att konceptet "förlustfritt nätverk" har något att göra med lagringslösningar? Faktum är att distribuerade datalagringssystem byggs på en snabb nätverksinfrastruktur som stöder relevanta algoritmer och RoCE-mekanismen. Den AI-system som stöds av våra switchar hjälper dessutom till att öka nätverkets hastighet och minska fördröjningar. . Prestandavinsten från lagringslösningen vid aktivering av AI Fabric kan nå upp till 20%.
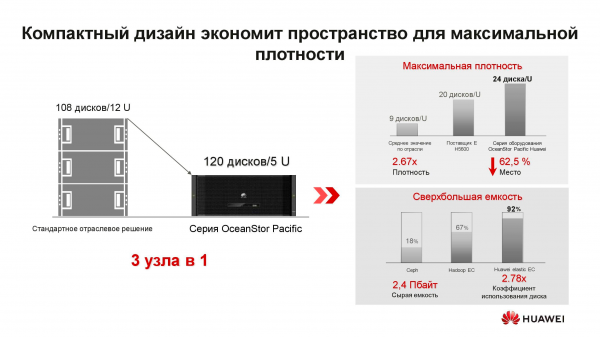
Vad är då den nya noden i den distribuerade lagringslösningen OceanStor Pacific? Lösningen med 5U formfaktor inkluderar 120 enheter och kan ersätta tre klassiska noder, vilket ger mer än dubbel platsbesparing i en rack. Genom att avstå från att lagra kopior ökar effektiviteten hos enheterna avsevärt (upp till +92%).
Vi är vana vid att programvarudefinierad lagring är en speciell programvara som installeras på en klassisk server. Men nu, för att uppnå optimala parametrar, kräver denna arkitektoniska lösning också speciella noder. Den består av två servrar baserade på ARM-processorer som styr en mängd hårddiskar på tre tum.
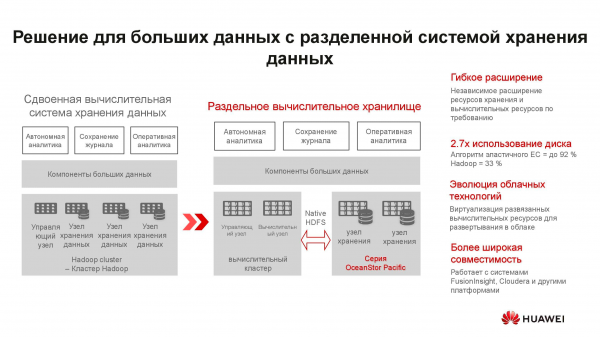
Dessa servrar är knappt lämpliga för hyperkonvergerande lösningar. För det första finns det väldigt få applikationer för ARM, och för det andra är det svårt att upprätthålla lastbalansering. Vi föreslår att man går över till separat lagring: en beräkningskluster, representerad av klassiska eller rack-servrar, fungerar separat men kopplas till OceanStor Pacific-lagringsnoder som också utför sina direkta uppgifter. Detta visar sig vara fördelaktigt.
Som exempel tar vi en klassisk lösning för lagring av stordata med ett hyperkonvergerande system som upptar 15 serverställ. Om man distribuerar lasten mellan separata beräkningsservrar och OceanStor Pacific-lagringsnoder, separerat från varandra, minskar antalet nödvändiga ställ med hälften! Detta sänker driftkostnaderna för datacentret och minskar den totala ägandekostnaden. I en värld där mängden lagrad information växer med 30 % per år, är sådana fördelar ovärderliga.
***
Mer information om Huaweis lösningar och deras tillämpningsområden kan du få på vår eller genom att kontakta representanter från företaget direkt.
Källa: habr.com
