

Jag har lagt upp på Github .
Detta är en enkel hash-tabell för GPU som kan hantera hundratals miljoner insättningar per sekund. På min laptop med NVIDIA GTX 1060 infogar koden 64 miljoner slumpmässigt genererade nyckel-värde-par på cirka 210 ms och tar bort 32 miljoner par på cirka 64 ms.
Det vill säga, hastigheten på laptopen är cirka 300 miljoner insättningar/s och 500 miljoner borttagningar/s.
Tabellen är skriven i CUDA, men samma metod kan användas för HLSL eller GLSL. Implementeringen har några begränsningar som säkerställer hög prestanda på grafikkortet:
- Endast 32-bitars nycklar och likadana värden bearbetas.
- Hash-tabellen har en fast storlek.
- Och denna storlek måste vara en kraft av två.
För nycklar och värden behöver man reservera en enkel avgränsande markör (i den angivna koden är detta 0xffffffff).
Hash-tabell utan lås
I hash-tabellen används öppen adressering med , vilket innebär att det helt enkelt är en array av nyckel-värde-par som lagras i minnet och har utmärkt cache-prestanda. Detta kan inte sägas om kedjebinding (chaining), vilket innebär att man letar efter en pekare i en länkad lista. Hash-tabellen är en enkel array som lagrar element KeyValue:
struct KeyValue
{
    uint32_t key;
    uint32_t value;
};
Tabellens storlek är en kraft av två, inte ett primtal, eftersom det räcker med en snabb instruktion för att använda pow2/AND-mask, medan modulus-operatören fungerar mycket långsammare. Detta är viktigt i fallet med linjär sonding, eftersom indexet för slotten måste omslutas i varje slot. Och som ett resultat läggs kostnaden för modulus-operationen till i varje slot.
Tabellen lagrar endast nyckel och värde för varje element, inte hash av nyckeln. Eftersom tabellen bara lagrar 32-bitars nycklar beräknas hash mycket snabbt. Den angivna koden använder hash Murmur3, som utför bara några skiftningar, XOR och multiplikation.
I hash-tabellen används en metod för att skydda sig mot låsningar, som inte beror på ordningen för placering i minnet. Även om vissa skrivoperationer bryter mot ordningen för andra sådana operationer, kommer hash-tabellen ändå att behålla ett korrekt tillstånd. Detta kommer vi att diskutera nedan. Metoden fungerar utmärkt med grafikprocessorer där tusentals trådar körs samtidigt.
Nycklar och värden i hash-tabellen initieras som tomma.
Koden kan modifieras så att den kan hantera både 64-bitars nycklar och värden. För nycklarna krävs atomära operationer för läsning, skrivning och jämförelse med byte (compare-and-swap). För värdena behövs atomära läs- och skrivoperationer. Lyckligtvis är läs- och skrivoperationerna för 32- och 64-bitars värden atomära så länge de är korrekt justerade (se. ), och moderna grafikprocessorer stöder 64-bitars atomära jämförelse med byteoperationer. Självklart kan prestandan minska något när man går över till 64 bitar.
Tillståndet för hash-tabellen
Varje nyckel-värde-par i hash-tabellen kan ha ett av fyra tillstånd:
- Nyckeln och värdet är tomma. I detta tillstånd initieras hash-tabellen.
- Nyckeln har skrivits, men värdet har ännu inte det. Om en annan exekveringstråd läser data vid den tidpunkten returnerar den ett tomt värde. Detta är normalt, samma skulle hända om en annan exekveringstråd hade kört lite tidigare, och vi talar om en konkurrensutsatt datakonstruktion.
- Både nyckeln och värdet har skrivits.
- Värdet är tillgängligt för andra exekveringstrådar, medan nyckeln inte är det ännu. Detta kan inträffa eftersom programmeringsmodellen i CUDA förutsätter en svagt ordnad minnesmodell. Detta är normalt; i vilket fall som helst är nyckeln fortfarande tom, även om värdet inte längre är det.
En viktig aspekt är att så snart nyckeln har skrivits in i ett fack, flyttas den inte längre — även om nyckeln tas bort, vilket vi kommer att diskutera nedan.
Koden för hash-tabellen fungerar även med svagt ordnade minnesmodeller, där ordningen för läsningar och skrivningar i minnet inte är känd. När vi behandlar insättning, sökning och borttagning i hash-tabellen, kom ihåg att varje nyckel-värde-par finns i ett av de fyra ovanstående tillstånden.
Insättning i hash-tabellen
CUDA-funktionen som sätter in nyckel-värde-par i hash-tabellen ser ut så här:
void gpu_hashtable_insert(KeyValue* hashtable, uint32_t key, uint32_t value)
{
    uint32_t slot = hash(key);

    while (true)
    {
        uint32_t prev = atomicCAS(&hashtable[slot].key, kEmpty, key);
        if (prev == kEmpty || prev == key)
        {
            hashtable[slot].value = value;
            break;
        }
        slot = (slot + 1) & (kHashTableCapacity-1);
    }
}
För att sätta in nyckeln itererar koden genom hash-tabellens array, började från hashen för den inlagda nyckeln. I varje fack av arrayen utförs en atomär jämför-och-byt-operation där nyckeln i detta fack jämförs med det tomma värdet. Om en skillnad upptäckts uppdateras nyckeln i facket med den inlagda nyckeln och den ursprungliga nyckeln i facket återförs. Om denna ursprungliga nyckel var tom eller matchade den inlagda nyckeln innebär det att koden har hittat en lämplig plats för inmatning och lägger in värdet i facket.
Om i ett anrop av kärnan gpu_hashtable_insert() finns flera element med samma nyckel, då kan vilket som helst av deras värden skrivas in i nyckelfacket. Detta anses vara normalt: en av skrivoperationerna för nyckel-värde-paret under anropet kommer att vara framgångsrik, men eftersom allt detta sker parallellt inom flera exekveringstrådar, kan vi inte förutspå vilken skrivoperation till minnet som kommer att vara den sista.
Sökning i hash-tabellen
Koden för att söka efter nycklar:
uint32_t gpu_hashtable_lookup(KeyValue* hashtable, uint32_t key)
{
        uint32_t slot = hash(key);

        while (true)
        {
            if (hashtable[slot].key == key)
            {
                return hashtable[slot].value;
            }
            if (hashtable[slot].key == kEmpty)
            {
                return kEmpty;
            }
            slot = (slot + 1) & (kHashTableCapacity - 1);
        }
}
För att hitta värdet av en nyckel som lagras i tabellen itererar vi genom arrayen, började från hashen för den nyckel vi letar efter. I varje fack kontrollerar vi om nyckeln är den vi söker, och om så är fallet returnerar vi dess värde. Vi kontrollerar också om nyckeln är tom, och om så är fallet avbryter vi sökningen.
Om vi inte lyckas hitta nyckeln returnerar koden ett tomt värde.
Alla dessa sökningsoperationer kan utföras samtidigt under insättningar och borttagningar. Varje par i tabellen kommer att ha ett av de fyra ovanstående tillstånden för tråden.
Borttagning i hash-tabellen
Koden för att ta bort nycklar:
void gpu_hashtable_delete(KeyValue* hashtable, uint32_t key, uint32_t value)
{
    uint32_t slot = hash(key);

    while (true)
    {
        if (hashtable[slot].key == key)
        {
            hashtable[slot].value = kEmpty;
            return;
        }
        if (hashtable[slot].key == kEmpty)
        {
            return;
        }
        slot = (slot + 1) & (kHashTableCapacity - 1);
    }
}
Att ta bort en nyckel utförs på ett ovanligt sätt: vi lämnar nyckeln i tabellen och markerar dess värde (inte själva nyckeln) som tomt. Denna kod är mycket lik lookup(), förutom att den vid upptäckten av en matchning med nyckeln gör dess värde tomt.
Som nämnts ovan, så fort nyckeln har skrivits till en slot flyttas den inte längre. Även vid borttagning av ett element från tabellen förblir nyckeln på plats; dess värde blir bara tomt. Detta innebär att vi inte behöver använda en atomär skrivoperation för slotens värde, eftersom det inte spelar någon roll om det aktuella värdet är tomt eller inte — det kommer ändå att bli tomt.
Ändra storleken på hash-tabellen
Storleken på hash-tabellen kan ändras genom att skapa en större tabell och sätta in icke-tomma element från den gamla tabellen i den. Jag har inte implementerat denna funktionalitet eftersom jag ville hålla exempel-koden enkel. Dessutom utförs minnesallokering ofta i värdkoden, snarare än i CUDA-kärnan.
I artikeln beskriver hur man ändrar en sådan dat struktur skyddad mot lås.
Konkurens
I de ovanstående fragmenten av koden hanterar funktionerna gpu_hashtable_insert(), _lookup() och _delete() en nyckel-värde-par i taget. Men nedan gpu_hashtable_insert(), _lookup() och _delete() hanterar en array av par parallellt, varje par i en separat GPU-tråd:
// CPU code to invoke the CUDA kernel on the GPU
uint32_t threadblocksize = 1024;
uint32_t gridsize = (numkvs + threadblocksize - 1) / threadblocksize;
gpu_hashtable_insert_kernel<<<gridsize, threadblocksize>>>(hashtable, kvs, numkvs);

// GPU code to process numkvs key/values in parallel
void gpu_hashtable_insert_kernel(KeyValue* hashtable, const KeyValue* kvs, unsigned int numkvs)
{
    unsigned int threadid = blockIdx.x*blockDim.x + threadIdx.x;
    if (threadid < numkvs)
    {
        gpu_hashtable_insert(hashtable, kvs[threadid].key, kvs[threadid].value);
    }
}
En hash-tabell med lås skyddar stödjer samtidiga insättningar, sökningar och borttagningar. Eftersom nyckel-värde par alltid är i ett av fyra tillstånd, och nycklarna inte flyttas, garanterar tabellen korrekthet även vid samtidig utförande av operationer av olika slag.
Men om vi parallellt behandlar ett paket av insättningar och borttagningar, och om inmatningsarrayen av par innehåller duplicerade nycklar, kan vi inte förutsäga vilka par som "vinner" — som kommer att skrivas till hash-tabellen sist. Anta att vi kallade insättningskoden med inmatningsarrayen av par A/0 B/1 A/2 C/3 A/4. När koden är klar kommer paren B/1 och C/3 garanterat att finnas i tabellen, men samtidigt kommer något av paren A/0, A/2 eller A/4Det här kan vara ett problem, eller inte — det beror på användningen. Du kan veta i förväg att det inte finns några duplicerade nycklar i den inkommande arrayen, eller så kanske det inte spelar någon roll vilket värde som sist skrevs.
Om detta är ett problem för dig måste du dela upp duplicerade par mellan olika systemanrop i CUDA. I CUDA avslutas alltid varje operation med en kärnåtgärd innan nästa kärnåtgärd anropas (åtminstone inom en tråd. I olika trådar körs kärnorna parallellt). Om vi i det ovanstående exemplet anropar en kärna med A/0 B/1 A/2 C/3, och en annan med A/4, då kommer nyckeln A att få värdet 4.
Nu får vi diskutera huruvida funktionerna lookup() och delete() ska använda en enkel (plain) eller variabel (volatile) pekare på array av par i hash-tabellen. hävdar att:
Compilern kan efter eget gottfinnande optimera läs- och skrivoperationer till global eller shared minne... Dessa optimeringar kan inaktiveras med hjälp av nyckelordet
volatile: ... varje referens till denna variabel kompileras till en faktisk läs- eller skrivinstruktion till minnet.
Korrekthetshänsyn kräver inte tillämpning volatile. Om exekveringsströmmen använder ett cachat värde från en tidigare läsoperation, innebär det att den kommer att använda något föråldrad information. Men detta är ändå information från ett korrekt tillstånd i hash-tabellen vid ett visst ögonblick av kärnan. Om du behöver använda den senaste informationen kan du använda en pekare volatile, men då minskar prestandan något: enligt mina tester minskade hastigheten vid borttagning av 32 miljoner element från 500 miljoner borttagningar/sek till 450 miljoner borttagningar/sek.
Performance
I testet för att införa 64 miljoner element och ta bort 32 miljoner av dem var konkurrensen mellan std::unordered_map och hash-tabellen för GPU praktiskt taget obefintlig:
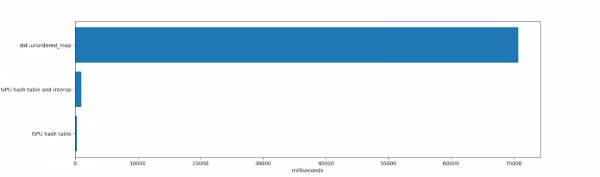
std::unordered_map det tog 70 691 ms att införa och ta bort element med efterföljande frigöring av unordered_map (frigöring av miljoner element tar en hel del tid eftersom många minnesallokeringar görs inuti unordered_map ). Ärligt talat hade std::unordered_map helt andra begränsningar. Det är en enhetlig CPU-tråd för exekvering, den stöder nyckel-värden av vilken storlek som helst, fungerar bra vid höga belastningar och visar stabil prestanda efter upprepade borttagningar.
Körningstiden för hash-tabellen för GPU och mellanprogram interaktion var 984 ms. Detta inkluderar tiden som spenderades på att placera tabellen i minnet och dess borttagning (ett engångsanrop för att allokera 1 GB minne, vilket tar en viss tid i CUDA), insättning och borttagning av element, samt iteration genom dem. Även alla kopieringar in i och ur GPU-minnet beaktas.
Hash-tabellens egna arbete tog 271 ms. Detta inkluderar tiden som spenderades av GPU:n för insättning och borttagning av element, och inkluderar inte tiden för minneskopiering och iteration genom den resulterande tabellen. Om GPU-tabellen lever länge, eller om hash-tabellen helt hålls i GPU-minnet (till exempel för att skapa en hash-tabell som kommer att användas av annan GPU-kod, och inte av CPU:n), är testresultatet relevant.
Hash-tabellen för GPU:n visar hög prestanda tack vare stor bandbredd och aktiv parallellisering.
Nackdelar
Det finns flera problem med arkitekturen för hash-tabellen som bör beaktas:
- Klustering hindrar linjär sondning, vilket gör att nycklarna i tabellen inte placeras optimalt.
- Nycklar tas inte bort med funktionen
ta bortoch över tid blockerar de tabellen.
Som ett resultat kan prestandan för hash-tabellen gradvis minska, särskilt om den existerar länge och många insättningar och borttagningar görs. Ett av sätten att mildra dessa nackdelar är att rehashera till en ny tabell med en tillräckligt låg utnyttjandegrad och filtrera bort borttagna nycklar vid rehashing.
För att illustrera de beskrivna problemen använder jag koden ovan för att skapa en tabell med 128 miljoner element, och cykliskt kommer jag att sätta in 4 miljoner element tills jag fyller 124 miljoner platser (uthyrningsgrad på cirka 0,96). Här är resultattabellen, varje rad är ett anrop av CUDA-kärnan med insättning av 4 miljoner nya element i en hash-tabell:
Utnyttjandegrad
Varaktighet för isättning av 4 194 304 element
0,00
11,608448 ms (361,314798 miljoner nycklar/sek.)
0,03
11,751424 ms (356,918799 miljoner nycklar/sek.)
0,06
11,942592 ms (351,205515 miljoner nycklar/sek.)
0,09
12,081120 ms (347,178429 miljoner nycklar/sek.)
0,12
12,242560 ms (342,600233 miljoner nycklar/sek.)
0,16
12,396448 ms (338,347235 miljoner nycklar/sek.)
0,19
12,533024 ms (334,660176 miljoner nycklar/sek.)
0,22
12,703328 ms (330,173626 miljoner nycklar/sek.)
0,25
12,884512 ms (325,530693 miljoner nycklar/sek.)
0,28
13,033472 ms (321,810182 miljoner nycklar/sek.)
0,31
13,239296 ms (316,807174 miljoner nycklar/sek.)
0,34
13,392448 ms (313,184256 miljoner nycklar/sek.)
0,37
13,624000 ms (307,861434 miljoner nycklar/sek.)
0,41
13,875520 ms (302,280855 miljoner nycklar/sek.)
0,44
14,126528 ms (296,909756 miljoner nycklar/sek.)
0,47
14,399328 ms (291,284699 miljoner nycklar/sek.)
0,50
14,690304 ms (285,515123 miljoner nycklar/sek.)
0,53
15,039136 ms (278,892623 miljoner nycklar/sek.)
0,56
15,478656 ms (270,973402 miljoner nycklar/sek.)
0,59
15,985664 ms (262,379092 miljoner nycklar/sek.)
0,62
16,668673 ms (251,627968 miljoner nycklar/sek.)
0,66
17,587200 ms (238,486174 miljoner nycklar/sek.)
0,69
18,690048 ms (224,413765 miljoner nycklar/sek.)
0,72
20,278816 ms (206,831789 miljoner nycklar/sek.)
0,75
22,545408 ms (186,038058 miljoner nycklar/sek.)
0,78
26,053312 ms (160,989275 miljoner nycklar/sek.)
0,81
31,895008 ms (131,503463 miljoner nycklar/sek.)
0,84
42,103294 ms (99,619378 miljoner nycklar/sek.)
0,87
61,849056 ms (67,815164 miljoner nycklar/sek.)
0,90
105,695999 ms (39,682713 miljoner nycklar/sek.)
0,94
240,204636 ms (17,461378 miljoner nycklar/sek.)
När användningsgraden ökar minskar prestandan. Detta är oönskat i de flesta fall. Om applikationen sätter in element i tabellen och sedan kastar bort dem (t.ex. vid ordantal i en bok) är det inget problem. Men om applikationen använder en långlivad hash-tabell (t.ex. i en grafisk redigerare för att lagra icke-tomma delar av bilder när användaren ofta klipper och klistrar) kan detta beteende orsaka problem.
Och jag mätte djupet på sondningen av hash-tabellen efter 64 miljoner insättningar (användningsgrad 0,5). Det genomsnittliga djupet var 0,4774, så de flesta nycklar låg antingen i den bästa möjliga slotten eller en slot från den bästa positionen. Det maximala djupet på sondningen var 60.
Sedan mätte jag djupet på sondningen i tabellen med 124 miljoner insättningar (användningsgrad 0,97). Det genomsnittliga djupet var nu 10,1757, och det maximala var 6474 (!!). Prestandan för linjär sondning faller kraftigt vid höga användningsgrader.
Det är bäst att hålla denna hash-tabell med en låg användningsgrad. Men då ökar vi prestandan på bekostnad av minnesanvändning. Lyckligtvis kan detta vara berättigat för nycklar och värden av 32 bitar. Om vi i exemplet ovan har en tabell med 128 miljoner element och behåller en användningsgrad på 0,25 kan vi bara placera 32 miljoner element i den, medan de återstående 96 miljoner platserna går förlorade — 8 byte för varje par, 768 MB förlorat minne.
Observera att detta handlar om förlust av grafikkortsminne, vilket är en mer värdefull resurs än systemminnet. Även om de flesta moderna skrivbords-GPU:er som stöder CUDA har minst 4 GB minne (vid tidpunkten för denna artikel har NVIDIA 2080 Ti 11 GB), är det fortfarande inte särskilt klokt att förlora sådana mängder.
Jag kommer senare att skriva mer om att skapa hash-tabeller för grafikkort som inte har problem med probingdjup samt om metoder för att återanvända borttagna platser.
Probingdjupsmätning
För att bestämma probingdjupet för en nyckel kan vi extrahera hashningen av nyckeln (dess ideala index i tabellen) från dess faktiska tabellindex:
// get_key_index() -> index of key in hash table
uint32_t probelength = (get_key_index(key) - hash(key)) & (hashtablecapacity-1);
På grund av magin med två binära tal i komplement och det faktum att kapaciteten i en hash-tabell är en tvåa upphöjt till, kommer denna metod att fungera även när nyckelns index flyttas till början av tabellen. Låt oss ta en nyckel som hashats till 1 men som satts in i plats 3. Då får vi för en tabell med kapacitet 4 (3 — 1) & 3, vilket är ekvivalent med 2.
Slutsats
Om du har frågor eller kommentarer kan du skriva till mig på eller öppna ett nytt ämne i.
Den här koden är inspirerad av fantastiska artiklar:
I framtiden kommer jag att fortsätta skriva om implementationer av hash-tabeller för grafikkort och analysera deras prestanda. Planerna inkluderar kedjebindning, Robin Hood-hashing och cuckoo-hashing med atomära operationer i datastrukturer som är bekväma för grafikkort.
Källa: habr.com
