

Många tror att det bara är att flytta applikationen till Kubernetes (antingen med hjälp av Helm eller manuellt) – så blir allt bra. Men det är inte så enkelt.
Team översatte artikel av DevOps-ingenjören Julian Gindi. Han beskriver vilka fallgropar hans företag stötte på under migreringen, så att ni inte gör samma misstag.
Steg ett: konfigurera pod-förfrågningar och begränsningar
Vi börjar med att konfigurera en ren miljö där våra pods ska fungera. Kubernetes hanterar planering av pods och felhantering utmärkt. Men det visade sig att schemaläggaren ibland inte kan placera en pod om den har svårt att bedöma vilka resurser som krävs för att den ska fungera framgångsrikt. Här kommer förfrågningar om resurser och begränsningar in. Det förekommer många diskussioner om den bästa metoden för att konfigurera dessa. Ibland känns det som att det verkligen är mer en konst än en vetenskap. Här är vår metod.
Pod-förfrågningar (pod requests) är den grundläggande mängd som används av schemaläggaren för optimal placering av en pod.
Av : vid filtreringssteget bestäms en uppsättning noder där en pod kan schemaläggas. Till exempel kontrollerar filtret PodFitsResources om det finns tillräckligt med resurser på noden för att uppfylla podens specifika resursförfrågningar.
Vi använder applikationsförfrågningar så att vi kan bedöma hur mycket resurser som faktiskt behövs för applikationen för att fungera normalt. Då kan schemaläggaren realistiskt placera noder. Från början ville vi ställa in förfrågningar med marginal, för att säkerställa att det fanns tillräckligt med resurser för varje pod, men vi märkte att schemaläggningstiden ökade avsevärt, och vissa pods blev aldrig helt schemalagda, som om inga resursförfrågningar hade kommit in för dem.
I det här fallet "pressade" schemaläggaren ofta ut pods och kunde inte schemalägga dem igen eftersom kontrollplanet inte visste hur mycket resurser applikationen skulle behöva, vilket är en nyckelkomponent i schemaläggningsalgoritmen.
Pod-begränsningar (pod limits) är ett mer tydligt tak för en pod. Det representerar den maximala mängd resurser som klustret kommer att avsätta för containern.
Återigen, från : om minnesgränsen för containern är satt till 4 GiB, kommer kubelet (och container-runtime) att tvinga den. Runtime tillåter inte containern att använda mer än den angivna resursgränsen. Till exempel, när en process i containern försöker använda mer än den tillåtna mängden minne, avslutar systemets kärna denna process med ett felmeddelande «out of memory» (OOM).
Containern kan alltid använda mer resurser än vad som anges i resursförfrågan, men får aldrig använda mer än vad som anges i gränsen. Det är en svår avvägning att ställa in rätt värde, men det är mycket viktigt.
Idealiskt sett vill vi att resursbehovet för podden ska förändras under livscykeln för processen, utan att påverka andra processer i systemet — det är målet med att sätta gränser.
Tyvärr kan jag inte ge specifika riktlinjer för vilka värden som ska ställas in, men vi följer själva dessa regler:
- Med ett belastningstestverktyg modellerar vi en grundläggande trafiknivå och observerar resursanvändningen för podden (minne och CPU).
- Vi sätter poddens förfrågningar på ett godtyckligt lågt värde (med resursgränsen ungefär 5 gånger högre än förfrågningsvärdet) och observerar. När förfrågningarna är för låga kan processen inte starta, vilket ofta orsakar mystiska körningsfel i Go.
Jag vill notera att högre resursgränser komplicerar planeringen, eftersom podden behöver en målnod med tillräckligt med tillgängliga resurser.
Föreställ dig en situation där du har en lättvikts webbserver med en mycket hög resursgräns, till exempel 4 GB minne. Troligtvis kommer denna process att behöva skalas horisontellt, och varje ny modul måste planeras på en nod med minst 4 GB tillgängligt minne. Om en sådan nod inte finns, måste klustret introducera en ny nod för att hantera denna pod, vilket kan ta en stund. Det är viktigt att uppnå en minimal skillnad mellan resursförfrågningar och gränser för att säkerställa snabb och smidig skalning.
Steg två: konfigurera Liveness och Readiness tester
Det här är ett annat subtilt ämne som ofta diskuteras inom Kubernetes-gemenskapen. Det är viktigt att ha en god förståelse för livstest (Liveness) och beredskapstest (Readiness), eftersom de erbjuder en mekanism för stabil drift av programvaran och minimerar stilleståndstiden. Men de kan allvarligt påverka prestandan för din applikation om de inte är korrekt konfigurerade. Nedan följer en sammanfattning av vad båda testerna innebär.
Liveness visar om containern fungerar. Om det misslyckas dödar kubelet containern och en återstartspolicy aktiveras. Om containern inte har en Liveness-check, anses det vara framgång som standard—så står det i .
Liveness-tester bör vara billiga, det vill säga de ska inte konsumera mycket resurser, eftersom de körs ofta och ska informera Kubernetes om att applikationen är igång.
Om du ställer in parametern att köra varje sekund, kommer det att lägga till 1 begäran per sekund, så tänk på att ytterligare resurser behövs för att hantera denna trafik.
På vårt företag testar Liveness-tester kärnkomponenterna i applikationen, även om data (som från en fjärrdatabas eller cache) inte är helt tillgängliga.
Vi har konfigurerat en "livskraft"-endpoint i applikationerna som helt enkelt returnerar statuskod 200. Detta är en indikation på att processen är igång och kan hantera begärningar (men inte ännu trafik).
Test Readiness indikerar om containern är redo att hantera begärningar. Om beredskapstesten misslyckas, tar kontrolleraren bort poddens IP-adress från alla tjänsters endpoints som motsvarar podden. Detta står också i Kubernetes-dokumentationen.
Readiness-tester konsumerar mer resurser, eftersom de måste nå backend på ett sätt som visar att applikationen är redo att ta emot begärningar.
Det pågår många diskussioner i samhället om huruvida man ska direkt kontakta databasen. Med hänsyn till overheadkostnader (kontroller görs ofta, men de kan regleras), har vi bestämt att för vissa applikationer räknas beredskapsresponsen endast efter att det har verifierats att databasen returnerar poster. Väl genomtänkta beredskapskontroller har säkerställt en högre tillgänglighet och eliminerat driftstopp under distributionen.
Om du beslutar dig för att göra en databasfråga för att kontrollera applikationens beredskap, se till att den är så kostnadseffektiv som möjligt. Låt oss ta följande fråga:
SELECT small_item FROM table LIMIT 1Här är ett exempel på hur vi konfigurerar dessa två värden i Kubernetes:
livenessProbe:
 httpGet:
   path: /api/liveness
   port: http
readinessProbe:
 httpGet:
   path: /api/readiness
   port: http  periodSeconds: 2
Du kan lägga till vissa ytterligare konfigurationsparametrar:
initialDelaySeconds— hur många sekunder som går från att containern startar tills beredskapskontroller börjar.periodSeconds— väntetiden mellan körningar av kontroller.timeoutSeconds— antalet sekunder efter vilket en pod anses vara i ett felaktigt tillstånd. Vanlig tidsgräns.failureThreshold— antal felade kontroller innan en signal om omstart skickas till podden.successThreshold— antal lyckade kontroller innan podden övergår till beredskapsläge (efter ett fel, när podden startas eller återställs).
Steg tre: konfigurera standard nätverkspolicys för podden
I Kubernetes är nätverkstopologin "platt", vilket innebär att alla poddar per standard interagerar direkt med varandra. I vissa fall är detta oönskat.
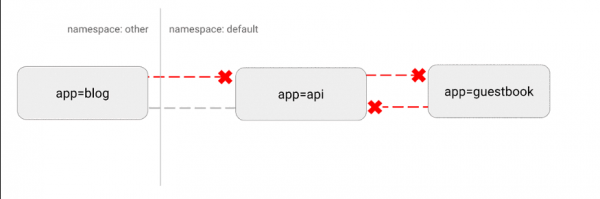
Ett potentiellt säkerhetsproblem är att en angripare kan använda en enda sårbar applikation för att skicka trafik till alla poddar i nätverket. Som i många säkerhetsfrågor gäller här principen om minimiåtkomst. Idealiskt sett bör nätverkspolicys tydligt ange vilka anslutningar mellan poddar som är tillåtna och vilka som inte är det.
Till exempel nedan är en enkel policy som förbjuder all inkommande trafik för ett specifikt namnrum:
---
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
 name: default-deny-ingress
spec:
 podSelector: {}
 policyTypes:
   - Ingress
Visualisering av denna konfiguration:
(https://miro.medium.com/max/875/1*-eiVw43azgzYzyN1th7cZg.gif)
Mer i detalj .
Steg fyra: Anpassat beteende med hjälp av hooks och init-containrar
En av våra huvuduppgifter var att säkerställa utplaceringar i Kubernetes utan driftstopp för utvecklarna. Detta är svårt på grund av att det finns många sätt för applikationer att avsluta och frigöra sina resurser.
Speciella svårigheter uppstod med . Vi märkte att aktiva kopplingar bröts under den sekventiella utplaceringen av dessa pods innan de kunde avslutas framgångsrikt.
Efter omfattande undersökningar på internet visade det sig att Kubernetes inte väntar på att Nginx-anslutningarna ska ta slut innan den stänger av podden. Med hjälp av pre-stop hook införde vi denna funktionalitet och eliminerade helt driftstoppet:
lifecycle:
 preStop:
   exec:
     command: ["/usr/local/bin/nginx-killer.sh"]
Och här är nginx-killer.sh:
#!/bin/bash
sleep 3
PID=$(cat /run/nginx.pid)
nginx -s quit
while [ -d /proc/$PID ]; do
   echo "Waiting while shutting down nginx..."
   sleep 10
done
En annan oerhört användbar paradigm är att använda init-containrar för att hantera starten av specifika applikationer. Detta är särskilt användbart om du har en resurskrävande databas migreringsprocess som bör köras innan applikationen startar. För denna process kan du också ange en högre resursgräns utan att sätta en sådan gräns för huvudapplikationen.
Ett annat vanligt mönster är att komma åt hemligheter i init-containern, som tillhandahåller dessa autentiseringsuppgifter till huvudmodulen, vilket förhindrar obehörig åtkomst till hemligheterna från själva huvudmodulen i applikationen.
Som vanligt, ett citat från dokumentationen: Init-containrar kör säkert användarkod eller verktyg som annars skulle sänka säkerheten i applikationens containerbild. Genom att lagra onödiga verktyg separat begränsar du angreppsyta för applikationens containerbild.
Steg fem: Kärninställningar
Avslutningsvis ska vi tala om en mer avancerad teknik.
Kubernetes är en utomordentligt flexibel plattform som gör det möjligt att köra arbetsbelastningar på det sätt du anser lämpligt. Vi har en rad högpresterande applikationer som kräver extremt mycket resurser. Efter omfattande belastningstestning upptäckte vi att en av applikationerna har svårt att hantera den förväntade trafikbelastningen om standardinställningarna för Kubernetes är aktiva.
Kubernetes gör det dock möjligt att köra en privilegierad container som ändrar kärnparametrar endast för en specifik pod. Här är vad vi använde för att ändra det maximala antalet öppna anslutningar:
initContainers:
  - name: sysctl
     image: alpine:3.10
     securityContext:
         privileged: true
      command: ['sh', '-c', "sysctl -w net.core.somaxconn=32768"]
Detta är en mer avancerad teknik som ofta inte behövs. Men om din applikation knappt klarar av hög belastning kan du försöka justera några av dessa parametrar. Mer information om denna process och justering av olika värden finns alltid .
Avslutningsvis
Även om Kubernetes kan verka som en färdig lösning "ur lådan", krävs det flera viktiga steg för att säkerställa att applikationerna fungerar utan avbrott.
Under hela migrationen till Kubernetes är det viktigt att följa "cykeln för belastningstestning": du startar applikationen, testar den under belastning, observerar metrik och beteende vid skalning, justerar konfigurationen baserat på dessa data och upprepar sedan cykeln igen.
Gör en realistisk bedömning av den förväntade trafiken och försök att överskrida den för att se vilka komponenter som går sönder först. Med en sådan iterativ metod kan det räcka med några av de nämnda rekommendationerna för att uppnå framgång. Alternativt kan mer detaljerad justering krävas.
Ställ alltid dig själv sådana frågor:
- Hur mycket resurser förbrukar applikationerna och hur kommer det här beloppet att förändras?
- Vad är de verkliga kraven för skalning? Hur mycket trafik kommer applikationen att hantera i genomsnitt? Och hur är det med den maximala trafiken?
- Hur ofta behöver tjänsten horisontell skalning? Hur snabbt behöver nya pods sättas i drift för att ta emot trafik?
- Hur korrekt stängs pods av? Behövs detta överhuvudtaget? Går det att åstadkomma distribution utan nedtid?
- Hur kan man minimera säkerhetsrisker och begränsa skador från eventuellt komprometterade pods? Har några tjänster rättigheter eller åtkomst som de inte behöver?
Kubernetes erbjuder en fantastisk plattform som möjliggör de bästa metoderna för att distribuera tusentals tjänster i en kluster. Ändå är alla applikationer olika. Ibland kräver implementering en aning mer arbete.
Lyckligtvis erbjuder Kubernetes de nödvändiga inställningarna för att uppnå alla tekniska mål. Genom att använda en kombination av resursförfrågningar och begränsningar, Liveness- och Readiness-prober, init-containrar, nätverkspolicyer och skräddarsydd kärninställning kan du uppnå hög prestanda tillsammans med driftsäkerhet och snabb skalbarhet.
Vad mer att läsa:
- .
- .
- .
Källa: habr.com
