

Paket tidyr ingår i kärnan av ett av de mest populära biblioteken på språket R — tidyverse.
Huvudsyftet med paketet är att ge data ett ordnat utseende.
Det finns redan en artikel på Habré dedikerad till detta paket, men den dateras till 2015. Jag vill berätta om de mest aktuella förändringarna som dess skapare Hadley Wickham meddelade för några dagar sedan.
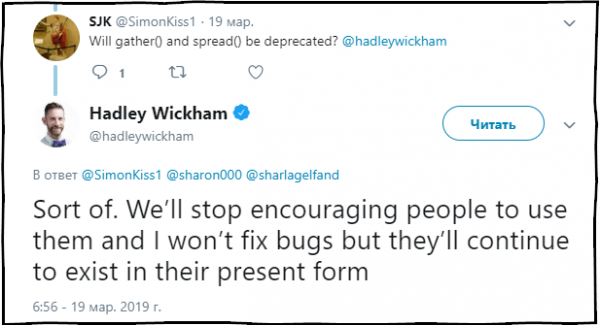
SJK: Kommer funktionerna gather() och spread() att betraktas som föråldrade?
Hadley Wickham: I viss mån. Vi kommer att sluta rekommendera användningen av dessa funktioner och rätta till fel i dem, men de kommer fortfarande att finnas kvar i paketet i nuvarande tillstånd.
Innehåll
Om du är intresserad av dataanalys kan du vara intresserad av mina och kanaler vara av intresse. Största delen av innehållet ägnas åt språket R.
Konceptet TidyData
Syftet tidyr — hjälpa dig att ge data ett så kallat ordnat utseende. Ordnade data är data där:
- Varje variabel finns i en kolumn.
- Varje observation är en rad.
- Varje värde är en cell.
Med data som har anpassats till tidy data är det mycket enklare och bekvämare att arbeta med under analys.
Huvudfunktionerna i paketet tidyr
tidyr innehåller ett set av funktioner avsedda för att transformera tabeller:
fill()— fylla i saknade värden i en kolumn med föregående värden;separate()— delar ett fält i flera med en avgränsare;unite()— gör en operation som förenar flera fält till ett, motsatsen till funktionenseparate();pivot_longer()— en funktion som omvandlar data från brett format till långt;pivot_wider()— en funktion som omvandlar data från långt format till brett. Denna operation är motsatsen till den som utförs av funktionenpivot_longer().gather()föråldrad — en funktion som omvandlar data från brett format till långt;spread()föråldrad — en funktion som omvandlar data från långt format till brett. Denna operation är motsatsen till den som utförs av funktionengather().
Ett nytt koncept för att omvandla data från brett format till långt och vice versa
Tidigare använde man funktioner för liknande transformationer gather() och spread(). Med åren har det blivit uppenbart att namnen på dessa funktioner och deras argument var otydliga för de flesta användare, inklusive paketets skapare, vilket ledde till svårigheter att hitta och förstå vilken av dessa funktioner som omvandlar en data ram från brett till långt format, och vice versa.
Därför tidyr har två nya, viktiga funktioner lagts till
De nya funktionerna pivot_longer() och pivot_wider() har skapats under intryck av vissa funktioner från paketet cdata, skapad av John Mount och Nina Zumel.
Installera den mest aktuella versionen av tidyr 0.8.3.9000
För att installera den senaste versionen av paketet tidyr 0.8.3.9000, där de nya funktionerna är tillgängliga, använd följande kod.
devtools::install_github("tidyverse/tidyr")
Vid tidpunkten för artikelskrivandet är dessa funktioner endast tillgängliga i dev-versionen av paketet på GitHub.
Övergång till nya funktioner
Att faktiskt översätta gamla skript till att använda de nya funktionerna är inte svårt; för att förstå bättre tar jag ett exempel från dokumentationen av de gamla funktionerna och visar hur dessa operationer utförs med hjälp av de nya pivot_*() funktionerna.
Omvandling från brett format till långt.
Kodexempel från dokumentationen för funktionen gather
# example
library(dplyr)
stocks <- data.frame(
  time = as.Date('2009-01-01') + 0:9,
  X = rnorm(10, 0, 1),
  Y = rnorm(10, 0, 2),
  Z = rnorm(10, 0, 4)
)

# old
stocks_gather <- stocks %>% gather(key   = stock,
                                   value = price,
                                   -time)

# new
stocks_long   <- stocks %>% pivot_longer(cols      = -time,
                                       names_to  = "stock",
                                       values_to = "price")
Omvandling från långt format till brett.
Kodexempel från dokumentationen för funktionen spread
# old
stocks_spread <- stocks_gather %>% spread(key = stock,
                                          value = price)

# new
stock_wide    <- stocks_long %>% pivot_wider(names_from  = "stock",
                                            values_from = "price")
Eftersom i de ovan nämnda exemplen med pivot_longer() och pivot_wider(), i den ursprungliga tabellen stocks finns det inga kolumner som nämns i argumenten names_to och values_to måste deras namn anges inom citationstecken.
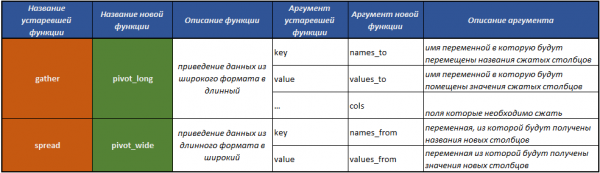
Tabellen som hjälper dig att enklast förstå hur man går över till att arbeta med det nya konceptet tidyr.
Anteckning från författaren
All vidare text är en anpassad, jag skulle till och med säga fri översättning av från den officiella webbplatsen för biblioteket tidyverse.
Ett enkelt exempel på att omvandla data från brett format till långt
pivot_longer () gör datamängder längre, minskar antalet kolumner och ökar antalet rader.
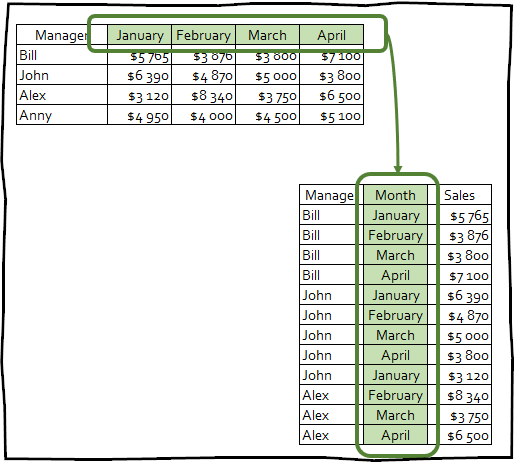
För att utföra exemplen i artikeln måste de nödvändiga paketen initially laddas:
library(tidyr)
library(dplyr)
library(readr)
Anta att vi har en tabell med resultaten från en undersökning där (bland annat) människor tillfrågades om sin religion och sin årliga inkomst:
#> # A tibble: 18 x 11
#>    religion `<$10k` `$10-20k` `$20-30k` `$30-40k` `$40-50k` `$50-75k`
#>    <chr>      <dbl>     <dbl>     <dbl>     <dbl>     <dbl>     <dbl>
#>  1 Agnostic      27        34        60        81        76       137
#>  2 Atheist       12        27        37        52        35        70
#>  3 Buddhist      27        21        30        34        33        58
#>  4 Catholic     418       617       732       670       638      1116
#>  5 Don’t k…      15        14        15        11        10        35
#>  6 Evangel…     575       869      1064       982       881      1486
#>  7 Hindu          1         9         7         9        11        34
#>  8 Histori…     228       244       236       238       197       223
#>  9 Jehovah…      20        27        24        24        21        30
#> 10 Jewish        19        19        25        25        30        95
#> # … with 8 more rows, and 4 more variables: `$75-100k` <dbl>,
#> #   `$100-150k` <dbl>, `>150k` <dbl>, `Don't know/refused` <dbl>
Den här tabellen innehåller data om respondenternas religioner i raderna, medan inkomstnivån sprids över kolumnnamnen. Antalet respondenter från varje kategori lagras i värdena i cellerna vid skärningspunkten mellan religion och inkomstnivå. För att få tabellen i ett snyggt, korrekt format räcker det att använda pivot_longer():
pew %>%
  pivot_longer(cols = -religion, names_to = "income", values_to = "count")
pew %>%
pivot_longer(cols = -religion, names_to = "income", values_to = "count")
#> # En tibble: 180 x 3
#> religion income count
#>
#> 1 Agnostiker 2 Agnostiker $10-20k 34
#> 3 Agnostiker $20-30k 60
#> 4 Agnostiker $30-40k 81
#> 5 Agnostiker $40-50k 76
#> 6 Agnostiker $50-75k 137
#> 7 Agnostiker $75-100k 122
#> 8 Agnostiker $100-150k 109
#> 9 Agnostiker >150k 84
#> 10 Agnostiker Vet inte/avstått 96
#> # … med 170 fler raderArgumenten för funktionen pivot_longer()
- Det första argumentet cols, beskriver vilka kolumner som ska slås samman. I detta fall alla kolumner förutom time.
- Argumentet names_to namnger variabeln som kommer att skapas från kolumnnamnen vi har slagit samman.
- values_to namnger variabeln som kommer att skapas från de värden som finns i cellerna i de sammanfogade kolumnerna.
Specifikationer
Detta är en ny funktionalitet i paketet tidyr, som tidigare var otillgänglig när man använde de föråldrade funktionerna.
Specifikation är ett dataram, där varje rad motsvarar en kolumn i den nya utdata-dataramen och två specialkolumner som börjar med:
- .*.namn innehåller det ursprungliga kolumnnamnet.
- .value innehåller namnet på kolumnen som värdena i cellerna kommer att gå in i.
De övriga kolumnerna i specifikationen återspeglar hur titeln på de komprimerade kolumnerna kommer att presenteras i den nya kolumnen. .*.namn.
Specifikationen beskriver metadata lagrad i kolumnnamnet, med en rad för varje kolumn och en kolumn för varje variabel som har sammanfogats med kolumnnamnet. Just nu kanske den definitionen verkar förvirrande, men efter att ha granskat ett par exempel kommer det bli mycket tydligare.
Syftet med specifikationen är att du kan extrahera, ändra och sätta nya metadata till den transformerade dataram.
För att arbeta med specifikationerna vid omvandlingen av en tabell från brett format till långt format används funktionen pivot_longer_spec().
Hur denna funktion fungerar är att den tar vilken dataram som helst och formar dess metadata på det sätt som beskrivits ovan.
För att ge ett exempel kan vi ta datasetet who, som tillhandahålls med paketet tidyr. Denna dataset innehåller information från Världshälsoorganisationen om tuberkulosfall.
who
#># A tibble: 7,240 x 60
#>#    country iso2  iso3   year new_sp_m014 new_sp_m1524 new_sp_m2534
#>#        &
#>#  1 Afghan… AF    AFG    1980          NA           NA           NA
#>#  2 Afghan… AF    AFG    1981          NA           NA           NA
#>#  3 Afghan… AF    AFG    1982          NA           NA           NA
#>#  4 Afghan… AF    AFG    1983          NA           NA           NA
#>#  5 Afghan… AF    AFG    1984          NA           NA           NA
#>#  6 Afghan… AF    AFG    1985          NA           NA           NA
#>#  7 Afghan… AF    AFG    1986          NA           NA           NA
#>#  8 Afghan… AF    AFG    1987          NA           NA           NA
#>#  9 Afghan… AF    AFG    1988          NA           NA           NA
#># 10 Afghan… AF    AFG    1989          NA           NA           NA
#># # … med 7,230 fler rader och 53 fler variabler
Vi bygger dess specifikation.
spec %
  pivot_longer_spec(new_sp_m014:newrel_f65, values_to = "count")
#> # A tibble: 56 x 3
#> .name .value name
#> <chr> <chr> <chr>
#> 1 new_sp_m014 count new_sp_m014
#> 2 new_sp_m1524 count new_sp_m1524
#> 3 new_sp_m2534 count new_sp_m2534
#> 4 new_sp_m3544 count new_sp_m3544
#> 5 new_sp_m4554 count new_sp_m4554
#> 6 new_sp_m5564 count new_sp_m5564
#> 7 new_sp_m65 count new_sp_m65
#> 8 new_sp_f014 count new_sp_f014
#> 9 new_sp_f1524 count new_sp_f1524
#> 10 new_sp_f2534 count new_sp_f2534
#> # … with 46 more rowsFält land, iso2, iso3 är redan variabler. Vår uppgift är att vända kolumnerna med new_sp_m014 per newrel_f65.
I namnen på dessa kolumner lagras följande information:
- Prefix
new_indikerar att kolumnen innehåller data om nya tuberkulosfall; den aktuella dataframen innehåller information endast om nya fall, så detta prefix har ingen meningsfull betydelse i nuvarande sammanhang. sp/rel/sp/epbeskriver diagnosmetoden.m/fpatientens kön.014/1524/2535/3544/4554/65patientens åldersintervall.
Vi kan dela dessa kolumner med funktionen extract(), med hjälp av reguljära uttryck.
spec %
        extract(name, c("diagnosis", "gender", "age"), "new_?(.*)_(.)(.*)")
#> # A tibble: 56 x 5
#> .name .value diagnosis gender age
#> <chr> <chr> <chr> <chr> <chr>
#> 1 new_sp_m014 count sp m 014
#> 2 new_sp_m1524 count sp m 1524
#> 3 new_sp_m2534 count sp m 2534
#> 4 new_sp_m3544 count sp m 3544
#> 5 new_sp_m4554 count sp m 4554
#> 6 new_sp_m5564 count sp m 5564
#> 7 new_sp_m65 count sp m 65
#> 8 new_sp_f014 count sp f 014
#> 9 new_sp_f1524 count sp f 1524
#> 10 new_sp_f2534 count sp f 2534
#> # … with 46 more rowsObservera att kolumnen .*.namn ska förbli oförändrad, eftersom det är vår index i kolumnnamnen i den ursprungliga datasetet.
Kön och ålder (kolumnerna gender och age) har fasta och kända värden, så det rekommenderas att omvandla dessa kolumner till faktorer:
spec %
            mutate(
              gender = factor(gender, levels = c("f", "m")),
              age = factor(age, levels = unique(age), ordered = TRUE)
            )
Slutligen, för att tillämpa den specifikation vi har skapat på den ursprungliga dataframen who måste vi använda argumentet spec i funktionen pivot_longer().
who %>% pivot_longer(spec = spec)
#> # A tibble: 405,440 x 8
#>    country     iso2  iso3   year diagnosis gender age   count
#>    <chr>       <chr> <chr> <int> <chr>     <fct>  <ord> <int>
#>  1 Afghanistan AF    AFG    1980 sp        m      014      NA
#>  2 Afghanistan AF    AFG    1980 sp        m      1524     NA
#>  3 Afghanistan AF    AFG    1980 sp        m      2534     NA
#>  4 Afghanistan AF    AFG    1980 sp        m      3544     NA
#>  5 Afghanistan AF    AFG    1980 sp        m      4554     NA
#>  6 Afghanistan AF    AFG    1980 sp        m      5564     NA
#>  7 Afghanistan AF    AFG    1980 sp        m      65       NA
#>  8 Afghanistan AF    AFG    1980 sp        f      014      NA
#>  9 Afghanistan AF    AFG    1980 sp        f      1524     NA
#> 10 Afghanistan AF    AFG    1980 sp        f      2534     NA
#> # … with 405,430 more rows
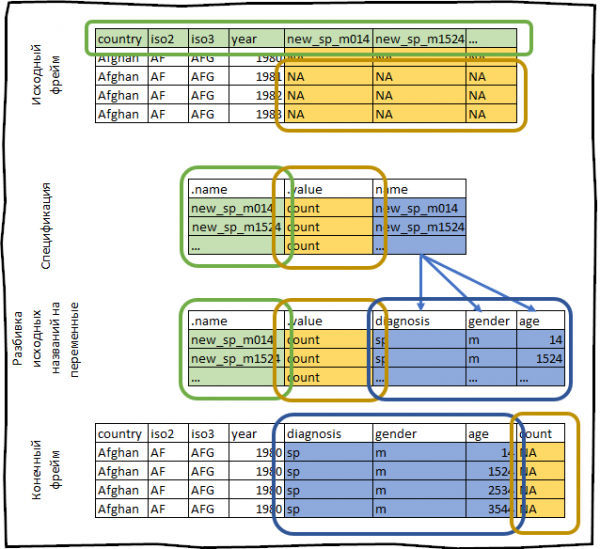
Allt vi just gjort kan schematiskt representeras så här:
Specifikation med flera värden (.value)
I det ovanstående exemplet representeras specifikationskolumnen .value innehöll bara ett värde, vilket oftast är fallet.
Men ibland kan det uppstå en situation där du behöver samla in data från kolumner med olika datatyper. Med hjälp av den föråldrade funktionen spread() skulle det vara ganska svårt att göra.
Exemplet nedan är hämtat från paketet data.table.
Låt oss skapa en träningsdataframe.
family <- tibble::tribble(
  ~family,  ~dob_child1,  ~dob_child2, ~gender_child1, ~gender_child2,
       1L, "1998-11-26", "2000-01-29",             1L,             2L,
       2L, "1996-06-22",           NA,             2L,             NA,
       3L, "2002-07-11", "2004-04-05",             2L,             2L,
       4L, "2004-10-10", "2009-08-27",             1L,             1L,
       5L, "2000-12-05", "2005-02-28",             2L,             1L,
)
family % mutate_at(vars(starts_with("dob")), parse_date)
#> # A tibble: 5 x 5
#> family dob_child1 dob_child2 gender_child1 gender_child2
#> <int> <date> <date> <int> <int>
#> 1 1 1998-11-26 2000-01-29 1 2
#> 2 2 1996-06-22 NA 2 NA
#> 3 3 2002-07-11 2004-04-05 2 2
#> 4 4 2004-10-10 2009-08-27 1 1
#> 5 5 2000-12-05 2005-02-28 2 1Den skapade dataframet innehåller på varje rad uppgifter om barnen i en familj. Familjer kan ha ett eller två barn. För varje barn tillhandahålls data om födelsedatum och kön, där uppgifterna för varje barn kommer i separata kolumner. Vår uppgift är att få dessa data i rätt format för analys.
Observera att vi har två variabler med information om varje barn: deras kön och födelsedatum (kolumner med prefixet dob innehåller födelsedatum, kolumner med prefixet gender innehåller barnets kön). I det förväntade resultatet ska de komma i separata kolumner. Vi kan göra detta genom att generera en specifikation där kolumnen .value kommer att ha två olika värden.
spec %
  pivot_longer_spec(-family) %>%
  separate(col = name, into = c(".value", "child"))%>%
  mutate(child = parse_number(child))
#> # A tibble: 4 x 3
#>   .name         .value child
#>   <chr>         <chr>  <dbl>
#> 1 dob_child1    dob        1
#> 2 dob_child2    dob        2
#> 3 gender_child1 gender     1
#> 4 gender_child2 gender     2
Så låt oss gå igenom stegen som utförs av ovanstående kod.
pivot_longer_spec(-family)— vi skapar en specifikation som komprimerar alla existerande kolumner förutom kolumnen family.separate(col = name, into = c(".value", "child"))— vi separerar kolumnen .*.namn, som innehåller namnen på de ursprungliga fälten, baserat på understreck och placerar de erhållna värdena i kolumnerna .value och child.mutate(child = parse_number(child))— vi omvandlar värdena i fältet child från textuell till numerisk datatyp.
Nu kan vi applicera den erhållna specifikationen på den ursprungliga dataframen för att få tabellen i önskat format.
family %>%
    pivot_longer(spec = spec, na.rm = T)
#> # A tibble: 9 x 4
#> family child dob gender
#> <int> <dbl> <date> <int>
#> 1 1 1 1998-11-26 1
#> 2 1 2 2000-01-29 2
#> 3 2 1 1996-06-22 2
#> 4 3 1 2002-07-11 2
#> 5 3 2 2004-04-05 2
#> 6 4 1 2004-10-10 1
#> 7 4 2 2009-08-27 1
#> 8 5 1 2000-12-05 2
#> 9 5 2 2005-02-28 1Vi använder argumentet na.rm = TRUE, eftersom den nuvarande datan tvingar oss att skapa överflödiga rader för saknade observationer. Eftersom familj 2 har endast ett barn, na.rm = TRUE garanterar att familj 2 kommer att ha en rad i utdata.
Omvandla dataframes från långt format till brett
pivot_wider() – är en omvänd transformation och ökar antalet kolumner i dataframen genom att minska antalet rader.
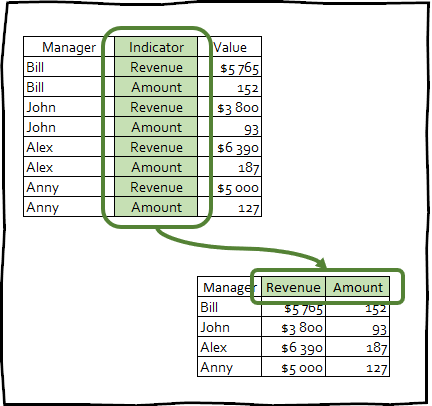
Denna typ av transformation används sällan för att strukturera data, men detta tillvägagångssätt kan vara användbart för att skapa sammanfattningstabeller som används i presentationer, eller för integration med andra verktyg.
I själva verket är funktionerna pivot_longer() och pivot_wider() symmetriska och utför motsatta åtgärder, dvs: df %>% pivot_longer(spec = spec) %>% pivot_wider(spec = spec) och df %>% pivot_wider(spec = spec) %>% pivot_longer(spec = spec) återställer den ursprungliga df.
Det enklaste exemplet på att omvandla en tabell till brett format
För att demonstrera funktionen pivot_wider() kommer vi att använda datasetet fish_encounters, som innehåller information om hur olika stationer registrerar fiskars rörelser i floden.
#> # A tibble: 114 x 3
#>    fish  station  seen
#>    <fct> <fct>   <int>
#>  1 4842  Release     1
#>  2 4842  I80_1       1
#>  3 4842  Lisbon      1
#>  4 4842  Rstr        1
#>  5 4842  Base_TD     1
#>  6 4842  BCE         1
#>  7 4842  BCW         1
#>  8 4842  BCE2        1
#>  9 4842  BCW2        1
#> 10 4842  MAE         1
#> # … with 104 more rows
I de flesta fall kommer denna tabell att vara mer informativ och användbar om informationen presenteras per station i separata kolumner.
fish_encounters %>% pivot_wider(names_from = station, values_from = seen)
fish_encounters %>% pivot_wider(names_from = station, values_from = seen)
#> # En tibble: 19 x 12
#>    fisk  Frigivning I80_1 Lissabon  Rstr Bas_TD   BCE   BCW  BCE2  BCW2   MAE
#>        &;
#>  1 4842        1     1      1     1       1     1     1     1     1     1
#>  2 4843        1     1      1     1       1     1     1     1     1     1
#>  3 4844        1     1      1     1       1     1     1     1     1     1
#>  4 4845        1     1      1     1       1    NA    NA    NA    NA    NA
#>  5 4847        1     1      1    NA      NA    NA    NA    NA    NA    NA
#>  6 4848        1     1      1     1      NA    NA    NA    NA    NA    NA
#>  7 4849        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#>  8 4850        1     1     NA     1       1     1     1    NA    NA    NA
#>  9 4851        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#> 10 4854        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#> # … med 9 fler rader och 1 fler variabel: MAW
Detta dataset registrerar information endast i de fall där fisken har upptäckts av stationen, dvs. om någon fisk inte har registrerats av någon station, så kommer denna data inte att finnas i tabellen. Detta innebär att utdata kommer att fyllas med NA.
Men i detta fall vet vi att frånvaron av en post betyder att fisken inte har setts, så vi kan använda argumentet values_fill i funktionen pivot_wider() och fylla dessa saknade värden med nollor:
fish_encounters %>% pivot_wider(
  names_from = station,
  values_from = seen,
  values_fill = list(seen = 0)
)
#> # A tibble: 19 x 12
#> fish Release I80_1 Lisbon Rstr Base_TD BCE BCW BCE2 BCW2 MAE
#> <fct> <int> <int> <int> <int> <int> <int> <int> <int> <int> <int>
#> 1 4842 1 1 1 1 1 1 1 1 1 1
#> 2 4843 1 1 1 1 1 1 1 1 1 1
#> 3 4844 1 1 1 1 1 1 1 1 1 1
#> 4 4845 1 1 1 1 1 0 0 0 0 0
#> 5 4847 1 1 1 0 0 0 0 0 0 0
#> 6 4848 1 1 1 1 0 0 0 0 0 0
#> 7 4849 1 1 0 0 0 0 0 0 0 0
#> 8 4850 1 1 0 1 1 1 1 0 0 0
#> 9 4851 1 1 0 0 0 0 0 0 0 0
#> 10 4854 1 1 0 0 0 0 0 0 0 0
#> # … with 9 more rows, and 1 more variable: MAW <int>Generering av kolumnnamn från flera ursprungliga variabler
Tänk dig att vi har en tabell som innehåller en kombination av produkter, länder och år. För att generera ett testdataframe kan vi köra följande kod:
df %
  filter((product == "A" & country == "AI") | product == "B") %>%
  mutate(value = rnorm(nrow(.)))
#> # A tibble: 45 x 4
#> product country year value
#> <chr> <chr> <int> <dbl>
#> 1 A AI 2000 -2.05
#> 2 A AI 2001 -0.676
#> 3 A AI 2002 1.60
#> 4 A AI 2003 -0.353
#> 5 A AI 2004 -0.00530
#> 6 A AI 2005 0.442
#> 7 A AI 2006 -0.610
#> 8 A AI 2007 -2.77
#> 9 A AI 2008 0.899
#> 10 A AI 2009 -0.106
#> # … with 35 more rowsVår uppgift är att utvidga dataframe så att en kolumn innehåller data för varje kombination av produkt och land. För detta räcker det med att ange i argumentet names_from en vektor som innehåller namnen på de sammanfogade fälten.
df %>% pivot_wider(names_from = c(product, country),
                 values_from = "value")
#> # A tibble: 15 x 4
#> year A_AI B_AI B_EI
#> <int> <dbl> <dbl> <dbl>
#> 1 2000 -2.05 0.607 1.20
#> 2 2001 -0.676 1.65 -0.114
#> 3 2002 1.60 -0.0245 0.501
#> 4 2003 -0.353 1.30 -0.459
#> 5 2004 -0.00530 0.921 -0.0589
#> 6 2005 0.442 -1.55 0.594
#> 7 2006 -0.610 0.380 -1.28
#> 8 2007 -2.77 0.830 0.637
#> 9 2008 0.899 0.0175 -1.30
#> 10 2009 -0.106 -0.195 1.03
#> # … with 5 more rowsDu kan också tillämpa specifikationer på funktionen pivot_wider(). Men när den skickas till pivot_wider() specifikationen utför en omvandling som är motsatt pivot_longer(): kolumner skapas enligt dem som anges i .*.namn, med värden från .value och andra kolumner.
För denna datamängd kan du generera en anpassad specifikation om du vill att varje möjlig kombination av land och produkt ska ha sin egen kolumn, inte bara de som finns i data:
spec %
  expand(product, country, .value = "value") %>%
  unite(".name", product, country, remove = FALSE)
#> # A tibble: 4 x 4
#> .name product country .value
#> <chr> <chr> <chr> <chr>
#> 1 A_AI A AI value
#> 2 A_EI A EI value
#> 3 B_AI B AI value
#> 4 B_EI B EI valuedf %>% pivot_wider(spec = spec) %>% head()#> # A tibble: 6 x 5
#> year A_AI A_EI B_AI B_EI
#> <int> <dbl> <dbl> <dbl> <dbl>
#> 1 2000 -2.05 NA 0.607 1.20
#> 2 2001 -0.676 NA 1.65 -0.114
#> 3 2002 1.60 NA -0.0245 0.501
#> 4 2003 -0.353 NA 1.30 -0.459
#> 5 2004 -0.00530 NA 0.921 -0.0589
#> 6 2005 0.442 NA -1.55 0.594Flera avancerade exempel på att arbeta med det nya konceptet tidyr
Att ge data ett ordnat utseende, med hjälp av ett dataset om inkomst och hyra i USA
Datamängden us_rent_income innehåller information om genomsnittsinkomst och hyra för varje delstat i USA för 2017 (datamängden finns tillgänglig i paketet tidycensus).
us_rent_income
#> # A tibble: 104 x 5
#>    GEOID NAME       variable estimate   moe
#>
#>  1 01    Alabama    income      24476   136
#>  2 01    Alabama    rent          747     3
#>  3 02    Alaska     income      32940   508
#>  4 02    Alaska     rent         1200    13
#>  5 04    Arizona    income      27517   148
#>  6 04    Arizona    rent          972     4
#>  7 05    Arkansas   income      23789   165
#>  8 05    Arkansas   rent          709     5
#>  9 06    California income      29454   109
#> 10 06    California rent         1358     3
#> # … med 94 fler rader
I den form som data lagras i datasetet us_rent_income är det mycket opraktiskt att arbeta med dem, så vi skulle vilja skapa en datamängd med kolumner: rent, rent_moe, come, income_moe. Det finns många sätt att skapa denna specifikation, men det viktiga är att vi behöver generera varje kombination av värden för variabeln och estimate/moe, och därefter generera namnet på kolumnen.
  spec %
    expand(variable, .value = c("estimate", "moe")) %>%
    mutate(
      .name = paste0(variable, ifelse(.value == "moe", "_moe", ""))
    )
#> # A tibble: 4 x 3
#> variable .value .name
#> <chr> <chr> <chr>
#> 1 income estimate income
#> 2 income moe income_moe
#> 3 rent estimate rent
#> 4 rent moe rent_moeAtt tillhandahålla denna specifikation pivot_wider() ger oss det resultat vi söker:
us_rent_income %>% pivot_wider(spec = spec)
#> # A tibble: 52 x 6
#>    GEOID NAME                 income income_moe  rent rent_moe
#>    <chr> <chr>                 <dbl>      <dbl> <dbl>    <dbl>
#>  1 01    Alabama               24476        136   747        3
#>  2 02    Alaska                32940        508  1200       13
#>  3 04    Arizona               27517        148   972        4
#>  4 05    Arkansas              23789        165   709        5
#>  5 06    California            29454        109  1358        3
#>  6 08    Colorado              32401        109  1125        5
#>  7 09    Connecticut           35326        195  1123        5
#>  8 10    Delaware              31560        247  1076       10
#>  9 11    District of Columbia  43198        681  1424       17
#> 10 12    Florida               25952         70  1077        3
#> # … with 42 more rows
Världsbanken
Ibland kräver det flera steg att få en datamängd i rätt form.
Datamängd world_bank_pop innehåller data från världsbanksbefolkningen för varje land under perioden 2000 till 2018.
#> # A tibble: 1,056 x 20
#>    country indicator `2000` `2001` `2002` `2003`  `2004`  `2005`   `2006`
#>    <chr>   <chr>      <dbl>  <dbl>  <dbl>  <dbl>   <dbl>   <dbl>    <dbl>
#>  1 ABW     SP.URB.T… 4.24e4 4.30e4 4.37e4 4.42e4 4.47e+4 4.49e+4  4.49e+4
#>  2 ABW     SP.URB.G… 1.18e0 1.41e0 1.43e0 1.31e0 9.51e-1 4.91e-1 -1.78e-2
#>  3 ABW     SP.POP.T… 9.09e4 9.29e4 9.50e4 9.70e4 9.87e+4 1.00e+5  1.01e+5
#>  4 ABW     SP.POP.G… 2.06e0 2.23e0 2.23e0 2.11e0 1.76e+0 1.30e+0  7.98e-1
#>  5 AFG     SP.URB.T… 4.44e6 4.65e6 4.89e6 5.16e6 5.43e+6 5.69e+6  5.93e+6
#>  6 AFG     SP.URB.G… 3.91e0 4.66e0 5.13e0 5.23e0 5.12e+0 4.77e+0  4.12e+0
#>  7 AFG     SP.POP.T… 2.01e7 2.10e7 2.20e7 2.31e7 2.41e+7 2.51e+7  2.59e+7
#>  8 AFG     SP.POP.G… 3.49e0 4.25e0 4.72e0 4.82e0 4.47e+0 3.87e+0  3.23e+0
#>  9 AGO     SP.URB.T… 8.23e6 8.71e6 9.22e6 9.77e6 1.03e+7 1.09e+7  1.15e+7
#> 10 AGO     SP.URB.G… 5.44e0 5.59e0 5.70e0 5.76e0 5.75e+0 5.69e+0  4.92e+0
#> # … with 1,046 more rows, and 11 more variables: `2007` <dbl>,
#> #   `2008` <dbl>, `2009` <dbl>, `2010` <dbl>, `2011` <dbl>, `2012` <dbl>,
#> #   `2013` <dbl>, `2014` <dbl>, `2015` <dbl>, `2016` <dbl>, `2017` <dbl>
Vårt mål är att skapa en ren datamängd där varje variabel finns i en separat kolumn. Det är fortfarande oklart vilka steg som behövs, men vi börjar med det mest uppenbara problemet: året är uppdelat i flera kolumner.
För att åtgärda detta behöver vi använda funktionen pivot_longer().
pop2 %
  pivot_longer(`2000`:`2017`, names_to = "year")
#> # A tibble: 19,008 x 4
#> country indicator year value
#> <chr> <chr> <chr> <dbl>
#> 1 ABW SP.URB.TOTL 2000 42444
#> 2 ABW SP.URB.TOTL 2001 43048
#> 3 ABW SP.URB.TOTL 2002 43670
#> 4 ABW SP.URB.TOTL 2003 44246
#> 5 ABW SP.URB.TOTL 2004 44669
#> 6 ABW SP.URB.TOTL 2005 44889
#> 7 ABW SP.URB.TOTL 2006 44881
#> 8 ABW SP.URB.TOTL 2007 44686
#> 9 ABW SP.URB.TOTL 2008 44375
#> 10 ABW SP.URB.TOTL 2009 44052
#> # … with 18,998 more rowsNästa steg är att överväga variabeln indicator.
pop2 %>% count(indicator)
#> # A tibble: 4 x 2
#>   indicator       n
#>   <chr>       <int>
#> 1 SP.POP.GROW  4752
#> 2 SP.POP.TOTL  4752
#> 3 SP.URB.GROW  4752
#> 4 SP.URB.TOTL  4752
Där SP.POP.GROW är befolkningstillväxt, SP.POP.TOTL är den totala befolkningen, och SP.URB. * är detsamma men enbart för stadsområden. Låt oss dela upp dessa värden i två variabler: area — område (total eller urban) och en variabel som innehåller faktiska data (population eller growth):
pop3 %
  separate(indicator, c(NA, "area", "variable"))
#> # A tibble: 19,008 x 5
#> country area variable year value
#> <chr> <chr> <chr> <chr> <dbl>
#> 1 ABW URB TOTL 2000 42444
#> 2 ABW URB TOTL 2001 43048
#> 3 ABW URB TOTL 2002 43670
#> 4 ABW URB TOTL 2003 44246
#> 5 ABW URB TOTL 2004 44669
#> 6 ABW URB TOTL 2005 44889
#> 7 ABW URB TOTL 2006 44881
#> 8 ABW URB TOTL 2007 44686
#> 9 ABW URB TOTL 2008 44375
#> 10 ABW URB TOTL 2009 44052
#> # … with 18,998 more rowsNu återstår det bara att dela variabeln variable i två kolumner:
pop3 %>%
  pivot_wider(names_from = variable, values_from = value)
#> # A tibble: 9,504 x 5
#> country area year TOTL GROW
#> <chr> <chr> <chr> <dbl> <dbl>
#> 1 ABW URB 2000 42444 1.18
#> 2 ABW URB 2001 43048 1.41
#> 3 ABW URB 2002 43670 1.43
#> 4 ABW URB 2003 44246 1.31
#> 5 ABW URB 2004 44669 0.951
#> 6 ABW URB 2005 44889 0.491
#> 7 ABW URB 2006 44881 -0.0178
#> 8 ABW URB 2007 44686 -0.435
#> 9 ABW URB 2008 44375 -0.698
#> 10 ABW URB 2009 44052 -0.731
#> # … with 9,494 more rowsKontaklista
Det sista exemplet, föreställ dig att du har en kontaktlista som du har kopierat och klistrat in från en webbplats:
contacts <- tribble(
  ~field, ~value,
  "name", "Jiena McLellan",
  "company", "Toyota",
  "name", "John Smith",
  "company", "google",
  "email", "john@google.com",
  "name", "Huxley Ratcliffe"
)
Att få denna lista till tabellformat är ganska svårt, eftersom det inte finns någon variabel som identifierar vilka data som tillhör vilken kontakt. Vi kan åtgärda detta genom att notera att data för varje ny kontakt börjar med namnet ("name"), så vi kan skapa en unik identifierare och öka den med ett för varje gång värdet “name” förekommer i kolumnen field:
contacts %
  mutate(
    person_id = cumsum(field == "name")
  )
contacts
#> # A tibble: 6 x 3
#> field value person_id
#> <chr> <chr> <int>
#> 1 name Jiena McLellan 1
#> 2 company Toyota 1
#> 3 name John Smith 2
#> 4 company google 2
#> 5 email john@google.com 2
#> 6 name Huxley Ratcliffe 3Nu när vi har en unik identifierare för varje kontakt kan vi vända fält och värde till kolumner:
contacts %>%
  pivot_wider(names_from = field, values_from = value)
#> # A tibble: 3 x 4
#> person_id name company email
#> <int> <chr> <chr> <chr>
#> 1 1 Jiena McLellan Toyota <NA>
#> 2 2 John Smith google john@google.com
#> 3 3 Huxley Ratcliffe <NA> <NA>Slutsats
Enligt min åsikt är den nya konceptet tidyr verkligen mer intuitivt och betydligt överlägset de föråldrade funktionerna. spread() och gather()Hoppas att den här artikeln har hjälpt dig att förstå. pivot_longer() och pivot_wider().
Källa: habr.com
