

Översättningen av artikeln är framtagen inför kursstarten
Distribuerad träning på flera högpresterande beräkningsinstanser kan minska träningstiden för moderna djupa neurala nätverk på stora datamängder från flera veckor till timmar eller till och med minuter, vilket gör denna inlärningsteknik dominerande inom tillämpningen av djupinlärning. Användare måste förstå hur man delar och synkroniserar data över flera instanser, vilket i sin tur har stor inverkan på skalningseffektiviteten. Dessutom måste användare veta hur man deployar ett träningsskript på flera instanser som fungerar på en enda instans.
I denna artikel kommer vi att diskutera ett snabbt och enkelt sätt för distribuerad träning med hjälp av det öppna djupinlärningsbiblioteket Apache MXNet och ramverket för distribuerad träning Horovod. Vi kommer tydligt att visa fördelarna med Horovod-ramverket när det gäller prestanda och demonstrera hur man skriver ett MXNet-träningsskript så att det fungerar distribuerat med Horovod.
Vad är Apache MXNet
– ett öppet ramverk för djupinlärning, som används för att skapa, träna och deploya djupa neurala nätverk. MXNet abstraherar bort komplexiteten som är kopplad till implementeringen av neurala nätverk, har hög prestanda och skalbarhet, och erbjuder API:er för populära programmeringsspråk som , , , , , , och andra.
Distribuerad träning i MXNet med parameter server
använder en parameterserveransats. Den använder en uppsättning parameterservrar för att samla in gradienter från varje arbetare, utföra aggregering och skicka tillbaka de uppdaterade gradienterna till arbetarna för nästa iterationsoptimering. Att definiera rätt förhållande mellan servrar och arbetare är nyckeln till effektiv skalning. Om det bara finns en parameterserver kan den bli en flaskhals i beräkningarna. Å andra sidan, om för många servrar används, kan "många-till-många"-anslutningarna blockera alla nätverksanslutningar.
Vad är Horovod
– en öppen ramverk för distribuerad djupinlärning, utvecklad av Uber. Den använder effektiva teknologier för samverkan mellan flera GPU:er och noder, såsom NVIDIA Collective Communications Library (NCCL) och Message Passing Interface (MPI) för att fördela och aggreggera modellens parametrar mellan arbetarna. Den optimerar användningen av nätverksbandbredd och skalar väl när den arbetar med modeller för djupa neurala nätverk. För närvarande stöder den flera populära maskininlärningsramverk, nämligen , Tensorflow, Keras och PyTorch.
Integrering av MXNet och Horovod
MXNet integreras med Horovod via API:er för distribuerad inlärning, definierade i Horovod. I Horovod kommunikations-API:er horovod.broadcast(), horovod.allgather() och horovod.allreduce() realiseras med hjälp av asynkrona callbacks från MXNet-motorn, som en del av dess uppgiftsschema. På så sätt hanteras data beroenden mellan kommunikation och beräkningar lätt av MXNet-motorn, för att undvika prestandaförluster på grund av synkronisering. Objektet distributed optimizer, definierat i Horovod horovod.DistributedOptimizer utvidgar Optimizer i MXNet på ett sätt så att det anropar motsvarande API:er från Horovod för distribuerad uppdatering av parametrar. Alla dessa implementationsdetaljer är transparenta för slutanvändarna.
Snabbstart
Du kan snabbt börja träna ett litet konvolutionellt neuralt nätverk på MNIST-datasetet med MXNet och Horovod på din MacBook.
För att börja, installera mxnet och horovod från PyPI:
pip install mxnet
pip install horovod
Obs: Om du får ett fel under pip install horovod, kan det hända att du behöver lägga till variabeln MACOSX_DEPLOYMENT_TARGET=10.vv, där vv – är detta versionen av din MacOS-version, till exempel för MacOSX Sierra behöver du skriva MACOSX_DEPLOYMENT_TARGET=10.12 pip install horovod
Installera sedan OpenMPI .
Till slut, ladda ner testscriptet mxnet_mnist.py och kör följande kommandon i terminalen på din MacBook i arbetskatalogen:
mpirun -np 2 -H localhost:2 -bind-to none -map-by slot python mxnet_mnist.pySå här kör du träningen på två kärnor av din processor. Utdata kommer att se ut ungefär så här:
INFO:root:Epoch[0] Batch [0-50] Speed: 2248.71 samples/sec      accuracy=0.583640
INFO:root:Epoch[0] Batch [50-100] Speed: 2273.89 samples/sec      accuracy=0.882812
INFO:root:Epoch[0] Batch [50-100] Speed: 2273.39 samples/sec      accuracy=0.870000
Prestandademonstration
Vid träning av ResNet50-v1 modellen på ImageNet-datasetet på 64 GPU:er med åtta instanser p3.16xlarge EC2, där var och en innehåller 8 GPU NVIDIA Tesla V100 på AWS-molnet, nådde vi en träningsbandbredd på 45000 bilder/sek (d.v.s. antalet tränade exempel per sekund). Träningen avslutades efter 44 minuter efter 90 epoker med bästa noggrannhet på 75,7%.
Vi jämförde detta med distribuerad träning av MXNet med en metod som använder parameterservrar på 8, 16, 32 och 64 GPU med en server med en parameter och förhållandet mellan servrar och arbetare 1 till 1 respektive 2 till 1. Resultatet kan ni se i Figur 1 nedan. På y-axeln till vänster speglar staplarna antalet bilder för träning per sekund, linjerna visar skalningsprestanda (d.v.s. förhållandet mellan faktisk bandbredd och idealisk) på y-axeln till höger. Som ni ser påverkar valet av antal servrar skalningsprestanda. Om parameterservern är en, faller skalningsprestandan till 38% vid 64 GPU. För att uppnå samma skalningsprestanda som med Horovod måste antalet servrar ökas dubbelt i förhållande till antalet arbetare.
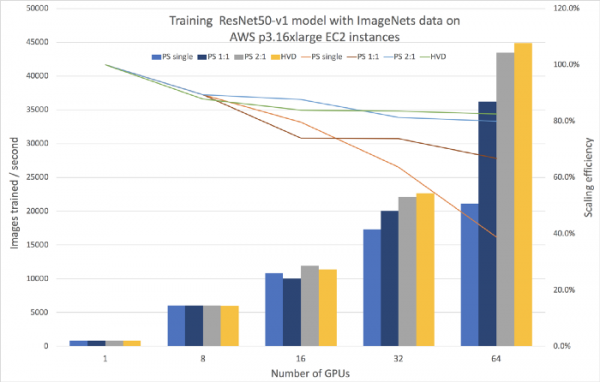
Figur 1. Jämförelse av distribuerad träning med användning av MXNet med Horovod och med parameterserver.
I Tabell 1 nedan jämförde vi den slutliga kostnaden för instansen vid utförande av experiment på 64 GPU. Användning av MXNet tillsammans med Horovod ger bästa bandbredd med lägsta kostnader.
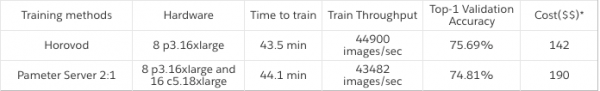
Tabell 1. Jämförelse av kostnader mellan Horovod och parameterserver med förhållandet servrar till arbetare 2 till 1.
Steg för att återskapa
I följande steg kommer vi att förklara hur man återskapar resultatet av distribuerad träning med hjälp av MXNet och Horovod. För att lära dig mer om distribuerad träning med MXNet, läs .
Steg 1
Skapa en kluster av homogena instanser med MXNet version 1.4.0 eller högre och Horovod version 0.16.0 eller högre för att använda distribuerad träning. Du måste också installera bibliotek för träning på GPU. För våra instanser valde vi Ubuntu 16.04 Linux, med GPU-driver 396.44, CUDA 9.2, cuDNN-bibliotek 7.2.1, NCCL-kommunikator 2.2.13 och OpenMPI 3.1.1. Du kan också använda , där dessa bibliotek redan är förinstallerade.
Steg 2
Lägg till möjlighet att arbeta med Horovod API i ditt träningsskript för MXNet. Nedanstående skript baserat på MXNet Gluon API kan användas som en enkel mall. Raderna som är markerade med fet stil behövs om du redan har ett relevant träningsskript. Här är några kritiska ändringar som måste göras för träning med Horovod:
- Ställ in kontexten enligt Horovods lokala rang (rad 8) för att säkerställa att träningen utförs på rätt grafikkärna.
- Överför initiala parametrar från en arbetare till alla (rad 18) för att se till att alla arbetare börjar med samma initiala parametrar.
- Skapa Horovod DistributedOptimizer (rad 25) för att uppdatera parametrar distribuerat.
För att få det fullständiga skriptet, hänvisa till exempel på Horovod-MXNet och .
1  import mxnet as mx
2  import horovod.mxnet as hvd
3
4  # Horovod: initiera Horovod
5  hvd.init()
6
7  # Horovod: låsa en GPU för att användas av lokal rang
8  context = mx.gpu(hvd.local_rank())
9
10 # Bygg model
11 model = ...
12
13 # Initiera parametrar
14 model.initialize(initializer, ctx=context)
15 params = model.collect_params()
16
17 # Horovod: sänd ut parametrar
18 hvd.broadcast_parameters(params, root_rank=0)
19
20 # Skapa optimizer
21 optimizer_params = ...
22 opt = mx.optimizer.create('sgd', **optimizer_params)
23
24 # Horovod: omslut optimizer med DistributedOptimizer
25 opt = hvd.DistributedOptimizer(opt)
26
27 # Skapa tränare och förlustfunktion
28 trainer = mx.gluon.Trainer(params, opt, kvstore=None)
29 loss_fn = ...
30
31 # Träna modellen
32 for epoch in range(num_epoch):
33    ...
Steg 3
Logga in på en av arbetarna för att starta distribuerad träning med hjälp av MPI-direktiv. I detta exempel startas distribuerad träning på fyra instanser med 4 GPU:er vardera, vilket totalt blir 16 GPU:er i klustret. En stochastic gradient descent (SGD) optimizer kommer att användas med följande hyperparametrar:
- mini-batch size: 256
- learning rate: 0.1
- momentum: 0.9
- weight decay: 0.0001
När vi skalade från en GPU till 64 GPU:er skalade vi linjärt inlärningshastigheten i förhållande till antalet GPU:er (från 0,1 för 1 GPU till 6,4 för 64 GPU), medan vi behöll antalet bilder per GPU på 256 (från ett paket om 256 bilder för 1 GPU till 16 384 för 64 GPU). Parametrarna weight decay och momentum justerades efter antalet GPU:er. Vi använde blandad precisionsträning med datatypen float16 för framåtpassagen och float32 för gradienter, för att påskynda float16-beräkningar som stöds av NVIDIA Tesla GPU:er.
$ mpirun -np 16
    -H server1:4,server2:4,server3:4,server4:4
    -bind-to none -map-by slot
    -mca pml ob1 -mca btl ^openib
    python mxnet_imagenet_resnet50.py
Slutsats
I den här artikeln har vi granskat en skalbar metod för distribuerad modellutbildning med hjälp av Apache MXNet och Horovod. Vi visade effektiviteten av skalning och kostnadseffektivitet i jämförelse med metoden med en parameter-server på datasetet ImageNet, där modellen ResNet50-v1 utbildades. Vi beskrev också de steg genom vilka du kan ändra ett befintligt skript för att starta träningen på flera instanser med hjälp av Horovod.
Om du precis har börjat arbeta med MXNet och djupinlärning, gå till installationssidan , för att först bygga MXNet. Vi rekommenderar också starkt att läsa artikeln , för att komma igång.
Om du redan har arbetat med MXNet och vill prova distribuerad utbildning med Horovod, kika på , bygg det med MXNet och följ exemplet eller .
*kostnaden beräknas baserat på AWS för EC2-instanser
Läs mer om kursen
Källa: habr.com
