

Obs. övers.: Författaren till detta material är Cindy Sridharan, ingenjör på imgix, som arbetar med API-utveckling och särskilt med testning av mikrotjänster. I detta material delar hon med sig av sin djupgående syn på aktuella problem inom distribuerad spårning, där hon anser att det råder en brist på verkligt effektiva verktyg för att lösa aktuella utmaningar.
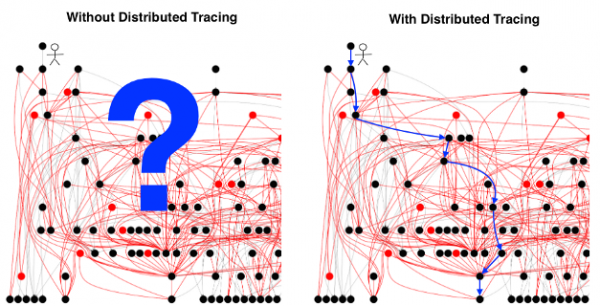
[Illustrationen är lånad från om distribuerad spårning.]
Det anses att är svår att implementera, och avkastningen på den . "Problematiseringen" av spårning förklaras med många skäl, och det hänvisas ofta till den arbetsintensiva konfigurationen av varje systemkomponent för att överföra motsvarande rubriker med varje begäran. Även om detta problem faktiskt existerar, kan det inte alls kallas oövervinneligt. Det förklarar å andra sidan inte varför utvecklare inte är så förtjusta i spårning (även om den redan är i drift).
Den huvudsakliga svårigheten med distribuerad spårning handlar inte om insamling av data, standardisering av distributionsformat och presentation av resultat, eller att bestämma när, var och hur man ska samplea. Jag försöker absolut inte föreställa mig triviala dessa "användbarhetsproblem" — det finns faktiskt ganska betydande tekniska och (om vi betraktar verkligt open source ) politiska utmaningar som måste övervinnas för att dessa problem ska kunna anses vara lösta.
Men om vi föreställer oss att alla dessa problem är lösta, är det stor sannolikhet att ingenting väsentligt förändras ur slutanvändarens perspektiv. Spårning kan fortfarande vara utan praktiskt värde i de vanligaste felsökningsscenarierna — även efter att den har implementerats.
Sådan olik spårning
Distribuerad spårning består av flera åtskilda komponenter:
- utrustning av applikationer och middleware med kontrollverktyg;
- överföring av distribuerad kontext;
- insamling av spårningar;
- lagring av spårningar;
- deras extrahering och visualisering.
Många diskussioner om distribuerad spårning handlar om att betrakta den som en viss unär operation vars enda syfte är att hjälpa till med en fullständig diagnostik av systemet. Mycket av detta hänger samman med hur våra uppfattningar om distribuerad spårning historiskt har formats. I , som gjordes när källkoden till Zipkin öppnades, nämndes att den [Zipkin] gör Twitter snabbare. De första kommersiella erbjudandena för spårning marknadsfördes också som .
Obs. övers.: För att den fortsatta texten ska uppfattas bättre, låt oss definiera två grundläggande termer enligt :
- Span är det grundläggande elementet i distribuerad spårning. Det representerar en beskrivning av en viss arbetsprocess (t.ex. en databasfråga) med ett namn, start- och sluttid, taggar, loggar och kontext.
- Spanar innehåller vanligtvis länkar till andra spanar, vilket möjliggör att koppla samman många spanar i Trace en visualisering av livscykeln för en begäran när den rör sig genom ett distribuerat system.
Traces innehåller otroligt värdefulla data som kan hjälpa med uppgifter som: tester i produktion, genomförande av katastrofåterställningstester, testning med felintroduktion osv. Faktum är att vissa företag redan använder spårning för sådana syften. Låt oss börja med att har även andra tillämpningar bortom enkel överföring av spanar till lagringssystem:
- Till exempel, Uber använder spårningsresultat för att särskilja testtrafik och produktionstrafik.
- Facebook data från traces för att analysera den kritiska vägen och för att växla trafik under regelbundna katastrofåterställningstester.
- Den sociala nätverksplattformen Jupyter-notebookar som gör det möjligt för utvecklare att göra godtyckliga begärningar på spårningsresultaten.
- Förespråkare för (Lineage Driven Failure Injection) distribuerade traces för felförstärkningsprovning.
Ingen av de ovanstående alternativen handlar helt och hållet om scenariot felsökning, där ingenjörerna försöker lösa problem genom att se på traces.
När det kommer faktiskt till scenariot för felsökning, förblir diagrammet traceview även om några också kallar det för "Gantt-diagrammet" eller "kaskaddiagrammet"). Under traceview jag alla span och relaterad metadata som tillsammans bildar trace. Varje spårningssystem med öppen källkod samt varje kommersiell spårningslösning erbjuder baserat på traceview ett användargränssnitt för visualisering, detaljering och filtrering av traces.
Problemet med alla spårningssystem som jag har stött på hittills är att den slutliga visualiseringen (traceview) nästan helt återspeglar funktionerna i processen för att generera trace. Även när alternativa visualiseringar erbjuds: intensitetskarta (heatmap), tjänsttopologier, latenstidsdiagram (latency), så reduceras de i slutändan till traceview.
Tidigare har jag över att de flesta "innovationer" inom spårning när det gäller UI/UX verkar begränsas av ytterligare metadata i trace, inklusive information med hög kardinalitet (high-cardinality) eller att erbjuda möjligheter att detaljera specifika spans eller utföra förfrågningar mellan och inom trace. Samtidigt traceview förblir det det primära visualiseringsverktyget. Så länge denna situation kvarstår kommer distribuerad spårning (i bästa fall) att ta fjärde plats som felsökningsverktyg, efter metrik, loggar och stack traces, och i sämsta fall bli en ren förlust av pengar och tid.
Problemet med traceview
Syftet traceview är att ge en fullständig bild av hur enskilda förfrågningar rör sig genom alla komponenter i det distribuerade systemet som de berör. Vissa mer avancerade spårningssystem tillåter detaljerad insyn i specifika spans och visar tidsuppdelningar inuti en och samma process (när spans har funktionella gränser).
Den grundläggande premissen för mikrotjänstarkitektur är idén att organisationsstrukturen växer i takt med företagets behov. Förespråkare för mikrotjänster hävdar att fördelningen av olika affärsuppgifter över separata tjänster gör det möjligt för små, självständiga utvecklingsteam att kontrollera hela livscykeln för dessa tjänster, vilket ger dem möjlighet att oberoende skapa, testa och distribuera dessa tjänster. Men en nackdel med denna fördelning är förlusten av information om hur varje tjänst interagerar med andra. I sådana situationer anses distribuerad spårning vara ett oumbärligt verktyg för felsökning komplexa interaktioner mellan tjänster.
Om du verkligen , är ingen människa kapabel att hålla i huvudet på dess fullständiga bild. Faktum är att utvecklingen av ett verktyg baserat på antagandet att detta överhuvudtaget är möjligt, är något av ett antipattern (en ineffektiv och oproduktiv metod). I idealfallet behövs ett verktyg för att snäva in sökområdet, så att ingenjörer kan fokusera på en delmängd av mått (tjänster/användare/värdar osv.) som är relevanta för det aktuella problemscenariot. När man utreder orsaken till ett fel behöver ingenjörer inte förstå vad som hände i alla tjänster samtidigt, eftersom detta krav skulle vara i strid med själva idén av mikrotjänstarkitektur.
Men traceview representerar just det. Ja, vissa spårningssystem erbjuder komprimerad traceview när antalet spans i trace är så stort att det inte går att återge inom en enda visualisering. Men på grund av den stora mängd information som finns även i en sådan nedbantad visualisering, tvingas ingenjörerna fortfarande att "sila" den, manuellt snäva in urvalet till en uppsättning tjänster som är källor till problem. Tyvärr är maskiner på detta område betydligt snabbare än människor, mindre benägna att göra misstag, och deras resultat är mer repetitiva. En annan anledning till att jag anser att metoden traceview är felaktig är att den inte passar bra för hypotesbaserad felsökning. I sin grund är felsökning en
iterativ process. en process som börjar med en hypotes, följt av att olika observationer och fakta från systemet samlas in längs olika vinklar, slutsatser/sammanfattningar och en vidare bedömning av hypotesens sanningshalt.
Möjlighet snabbt och billigt att testa hypoteser och förbättra den mentala modellen i enlighet med detta är en hörnsten i felsökning. Vilket felsökningsverktyg som helst bör vara interaktivt och avgränsa sökområdet eller, vid en falsk ledtråd, låta användaren gå tillbaka och fokusera på ett annat område av systemet. Det perfekta verktyget skulle göra detta i förväg, omedelbart rikta användarens uppmärksamhet mot potentiellt problematiska områden.
Tyvärr traceview kan man inte kalla det interaktiva verktyget ett verktyg. Det bästa man kan hoppas på vid dess användning är att upptäcka en viss källa till ökad latens och gå igenom alla möjliga taggar och loggar kopplade till den. Det hjälper inte ingenjören att identifiera mönster i trafiken, såsom specifikationen av latensdistribution eller att upptäcka korrelationer mellan olika mätningar. kan hjälpa till att kringgå vissa av dessa problem. Faktiskt på framgångsrik analys som använder maskininlärning för att identifiera anomala spans och att identifiera en delmängd av taggar som kan relateras till anomalt beteende. Ändå har jag hittills inte stött på övertygande visualiseringar av fynd gjorda med hjälp av maskininlärning eller dataanalys tillämpade på spans, som skulle skilja sig avsevärt från traceview eller DAG (direkt acyklisk graf).
Spans är för låg nivå
Ett grundläggande problem med traceview är att spans är för låg nivå primitiva för både latensanalys och orsak-och-verkan-analyser. Det är som att analysera enskilda processorinstruktioner i ett försök att åtgärda ett undantag, med vetskap om att det finns mycket mer hög-nivå verktyg som backtrace, som är mycket enklare att arbeta med.
Dessutom vågar jag påstå följande: i idealfallet behöver vi inte ens en fullständig bild den som inträffade under livscykeln av en begäran, som moderna verktyg för spårning representerar. Istället krävs en form av högre abstraktion som innehåller information om vad gick fel (i likhet med backtrace), tillsammans med viss kontext. Istället för att se hela spåret föredrar jag att se dess del, där något intressant eller ovanligt händer. För närvarande utförs sökningen manuellt: ingenjören får spåret och analyserar spanarna själv i jakt på något intressant. Ett tillvägagångssätt där människor stirrar på spanarna i olika spår i hopp om att upptäcka misstänkt aktivitet är absolut ohållbart (särskilt när de måste bearbeta all metadata som är kodad i olika spanare, såsom span-ID, RPC-metodnamn, spanens varaktighet, loggar, taggar, etc.).
Alternativ till traceview
Resultaten från spårning är mest användbara när de kan visualiseras på ett sätt så att de ger en icke-trivial uppfattning om vad som händer i de sammanlänkade delarna av systemet. Tills dess förblir debuggningsprocessen i stor utsträckning trögrörlig och beror på användarens förmåga att notera korrekta korrelationer, kontrollera rätt delar av systemet eller sätta ihop bitarna i mosaiken – till skillnad från verktyget, som hjälper användaren att formulera dessa hypoteser.
Jag är inte en visuell designer och inte expert inom UX, men i nästa sektion vill jag dela med mig av några idéer om hur sådana visualiseringar kan se ut.
Fokus på specifika tjänster
I en situation där branschen konsolideras runt begreppen , verkar det rimligt att separata team först och främst bör övervaka sina tjänsters överensstämmelse med dessa mål. Detta innebär att tjänstefokuserad visualisering passar bäst för sådana team.
Spår, särskilt utan sampling, är en guldgruva av information om varje komponent i ett distribuerat system. Denna information kan matas till en smart behandlare som kommer att leverera till användarna tjänstefokuserade insikter. De kan identifieras i förväg – innan användaren ser spåren:
- Fördelningsdiagram över fördröjningar endast för utstickande förfrågningar (utstickande förfrågningar);
- Fördelningsdiagram över fördröjningar för fall när tjänstens SLO-mål inte uppfylls;
- De mest "vanliga", "intressanta" och "konstiga" etiketterna i förfrågningar som oftast återkommer;
- Fördröjningsuppdelning för fall när beroenden tjänsten inte uppfyller uppsatta SLO-mål;
- Fördröjningsuppdelning efter olika downstream-tjänster.
På vissa av dessa frågor kan inbyggda mätningar helt enkelt inte svara, vilket får användarna att noggrant granska spannen. Resultatet är en extremt användarovänlig mekanism.
Detta leder till frågan: hur är det med komplexa interaktioner mellan olika tjänster som styrs av olika team? Är det inte traceview det mest lämpliga verktyget för att belysa en sådan situation?
Mobilutvecklare, ägare av stateless-tjänster, ägare av hanterade stateful-tjänster (som databaser) och plattformsägare kan vara intresserade av en annan framställning av det distribuerade systemet; traceview – detta är en alltför generell lösning för dessa i grunden olika behov. Även i en mycket komplex mikrotjänstarkitektur behöver tjänsteägarna inte ha djupgående kunskaper om mer än två eller tre upstream- och downstream-tjänster. I själva verket räcker det för användarna i de flesta scenarier att svara på frågor som rör ett begränsat antal tjänster..
Det liknar att studera en liten delmängd av tjänster genom ett förstoringsglas för noggrant granskande. Detta gör det möjligt för användaren att ställa mer angelägna frågor om den komplexa interaktionen mellan dessa tjänster och deras omedelbara beroenden. Det är analogt med backtrace i tjänsternas värld, där ingenjören vet, vad som inte står rätt till, och har också en viss uppfattning om vad som händer i de omgivande tjänsterna för att förstå, varför.
Den metod jag förespråkar är helt motsatt den "top-down"-metod som bygger på traceview, där analysen börjar med hela trace:en och gradvis går ner till enskilda span:ar. Istället börjar den "bottom-up"-metoden med att analysera en liten del närmare den potentiella orsaken till incidenten, och sedan utvidgas sökområdet vid behov (eventuellt med hjälp av andra team för att analysera ett bredare spektrum av tjänster). Den andra metoden är bättre anpassad för snabb validering av initiala hypoteser. När konkreta resultat har erhållits kan man gå vidare till en mer riktad och detaljerad analys.
Byggande av topologi
Tjänstspecifika vyer kan vara otroligt användbara om användaren vet vilken tjänst eller tjänstgrupp som är ansvarig för ökningar av fördröjningar eller är källan till fel. Emellertid kan det i ett komplext system vara en utmanande uppgift att identifiera den felande tjänsten under en störning, särskilt om felmeddelanden från tjänsterna inte har inkommit.
Byggandet av tjänsttopologier kan vara till stor hjälp för att ta reda på vilken tjänst som visar en ökning av fel frekvens eller fördröjning, vilket leder till märkbar försämring av tjänstens prestanda. När jag talar om byggande av topologi menar jag inte en tjänstekarta, som visar varje befintlig tjänst i systemet och är känd för sina . En sådan framställning är inget bättre än traceview baserat på en riktad acyklisk graf. Istället skulle jag vilja se en dynamiskt genererad tjänsttopologi, baserad på specifika attribut som fel frekvens, svarstid eller vilket användardefinierat parameter som helst som hjälper till att klargöra situationen med specifika misstänkta tjänster.
Låt oss ta ett exempel. Föreställ dig en hypotetisk nyhetssajt. Tjänsten för startsidan (front page) utbyter data med Redis, rekommendationstjänsten, annonsservicen och videoservicen. Videoservicen hämtar videoklipp från S3, medan metadata kommer från DynamoDB. Rekommendationstjänsten får metadata från DynamoDB, laddar data från Redis och MySQL, och skriver meddelanden till Kafka. Annonsservicen hämtar data från MySQL och skriver meddelanden till Kafka.
Nedan visas en schematisk bild av denna topologi (topologin skapas av många kommersiella program för spårning). Den kan vara till nytta om man behöver förstå tjänsternas beroenden. Men under tiden felsökning, när en viss tjänst (låt oss säga videoservicen) visar ökad svarstid, är en sådan topologi inte särskilt användbar.
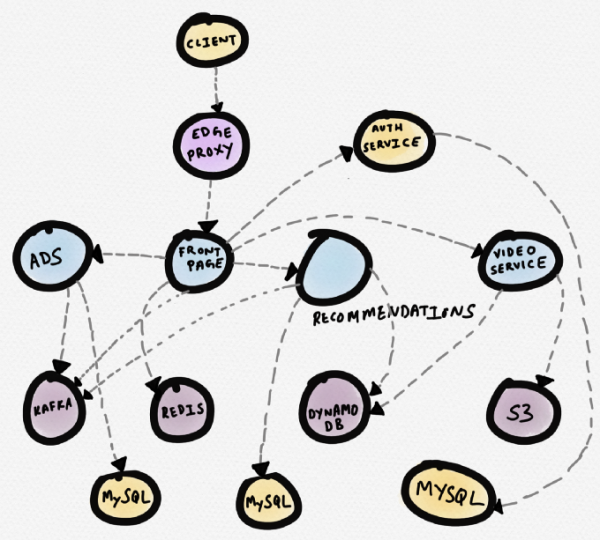
Schema för tjänster på en hypotetisk nyhetssajt
En diagram skulle passa bättre, som den nedan. Här framträder den problematiska tjänsten (video) direkt i centrum. Användaren lägger genast märke till den. Från denna visualisering blir det klart att videoservicen fungerar onormalt på grund av den ökade svarstiden från S3, vilket påverkar laddningstiden för en del av startsidan.
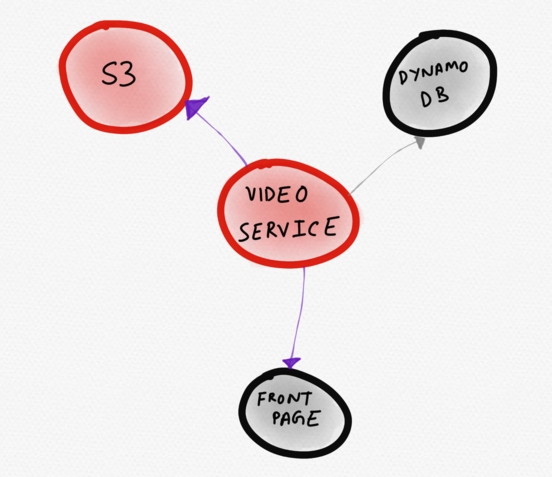
Dynamisk topologi som bara visar "intressanta" tjänster
Dynamiskt genererade topologiska scheman kan visa sig vara mer effektiva än statiska kartor över tjänster, särskilt i elastiska, autoskalande infrastrukturer. Möjligheten att jämföra och relatera tjänsttopologier gör att användaren kan ställa mer aktuella frågor. Mer precisa frågor om systemet leder mer sannolikt till en bättre förståelse av hur systemet fungerar.
Jämförande visualisering
En annan användbar visualisering skulle vara en jämförande visualisering. För närvarande är trace:ar inte särskilt bra för att jämföra sida vid sida, så de jämförs vanligtvis spans. Den grundläggande idén med denna artikel är just att span:ar är för låg nivå för att extrahera den mest värdefulla informationen från spårningsresultaten.
Att jämföra två trace:ar kräver inga principiellt nya visualiseringar. Egentligen räcker det med något som ett histogram, som representerar samma information som traceview. Det är förvånande, men även denna enkla metod kan ge mycket mer än att bara studera två trace:ar separat. En ännu mer kraftfull funktion skulle vara möjligheten visualisera jämförelse av spår totalt. Det skulle vara oerhört användbart att se hur en nyligen implementerad databas konfiguration med aktiverad GC (garbage collection) påverkar svaretider för downstream-tjänsten över flera timmar. Om det jag beskriver här liknar A/B-testning av påverkan av infrastruktur förändringar i många tjänster med hjälp av spårnings resultat, så är du inte så långt ifrån sanningen.
Slutsats
Jag ifrågasätter inte värdet av själva spårningen. Jag är uppriktigt övertygad om att det inte finns något annat sätt att samla in lika rika, casual och kontextuella data som de i ett spår. Men jag anser också att alla spårningslösningar använder dessa data oerhört ineffektivt. Så länge spårningsverktyg är fokuserade på spårvisningen kommer de att vara begränsade i sin förmåga att maximera värdefull information som kan utvinnas från data i spåren. Dessutom finns det en risk för att utvecklingen av en helt oöverskådlig och ointuitiv visuell användargränssnitt, som kraftigt begränsar användarens förmåga att felsöka applikationen.
Felsökning av komplexa system, även med moderna verktyg, är otroligt svårt. Verktyg måste hjälpa utvecklaren att formulera och verifiera hypoteser, aktivt tillhandahålla relevant information, identifiera avvikelser och notera mönster i fördröjningsfördelningen. För att spårning ska bli det föredragna verktyget för utvecklare vid felsökning i produktion eller vid problem som berör flera tjänster, behövs originella användargränssnitt och visualiseringar som i högre grad samsvarar med utvecklarnas mentala modell som skapar och driftar dessa tjänster.
Det krävs seriösa mentala ansträngningar för att designa ett system som kan representera olika signaler som finns i spårningsresultaten på ett sätt som är optimerat för att underlätta analys och slutsatser. Det är nödvändigt att tänka igenom hur man abstraherar systemtopologin under felsökning på ett sätt som hjälper användaren att övervinna blinda fläckar utan att behöva dyka ner i enskilda spår eller span.
Vi behöver bra möjligheter till abstraktion och nivåindelning (speciellt i UI). Sådana som passar bra in i en hypotesbaserad felsökningsprocess där man iterativt kan ställa frågor och testa hypoteser. De kommer inte automatiskt att lösa alla problem med observerbarhet, men de kommer att hjälpa användarna att finslipa sin intuition och formulera mer välavvägda frågor. Jag uppmanar till en mer eftertänksam och innovativt angreppssätt inom visualisering. Här finns en verklig möjlighet att vidga vyerna.
P.S. från översättaren
Läs även i vår blogg:
- «»;
- «»;
- «».
Källa: habr.com
