

CAP-teoremet är hörnstenen i teorin om distribuerade system. Självklart tystnar debatten kring den aldrig: varken definitionerna är kanoniska, och det finns inget strikt bevis... Ändå, fast förankrade i sunt förnuft™, förstår vi intuitivt att teoremet är korrekt.
Det enda som inte är uppenbart är innebörden av bokstaven "P". När en kluster splittras, beslutar den – antingen att inte svara förrän ett kvorum har nåtts, eller att ge de data som finns. Beroende på resultatet av detta val klassificeras systemet som antingen CP eller AP. Cassandra, till exempel, kan bete sig både så och så, beroende inte ens av klusterinställningarna, utan av parametrarna för varje specifik förfrågan. Men om systemet inte är "P", och det har splittrats, vad händer då?
Svaret på denna fråga är något oväntat: CA-klustret kan inte splittras.
Vad är det för kluster som inte kan splittras?
En nödvändig egenskap hos ett sådant kluster är ett gemensamt datalagringssystem. I de flesta fall innebär detta en anslutning via SAN, vilket begränsar användningen av CA-lösningar till stora företag som kan upprätthålla SAN-infrastruktur. För att flera servrar kan arbeta med samma data, krävs ett kluster-filsystem. Sådana filsysten finns i portföljerna hos HPE (CFS), Veritas (VxCFS) och IBM (GPFS).
Oracle RAC
Real Application Cluster-alternativet introducerades första gången 2001 i Oracle 9i. I ett sådant kluster arbetar flera instanser servern med samma databas.
Oracle kan arbeta både med kluster-filsystem och med sin egen lösning – ASM, Automatic Storage Management.
Varje instans håller sin egen logg. En transaktion utförs och registreras av en instans. Vid en instansfel läser en av de överlevande noderna i klustret (instanserna) dennes logg och återställer de förlorade data – därigenom säkerställs tillgängligheten.
Alla instanser upprätthåller sina egna cacheminnen, och samma sidor (block) kan finnas i cacheminnena hos flera instanser samtidigt. Dessutom, om en instans behöver en viss sida, och den finns i cacheminnet hos en annan instans, kan den få den från "grannen" genom mekanismen cache fusion istället för att läsa från disken.
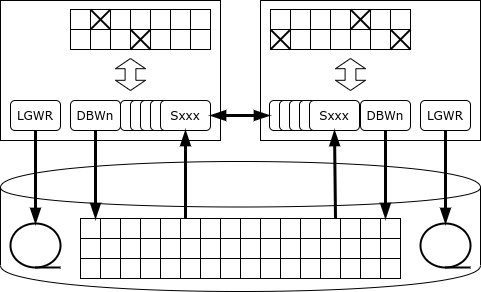
Men vad händer om en av instanserna behöver ändra data?
En egenskap hos Oracle är att den inte har någon dedikerad låsningsservice: om servern vill låsa en rad, sätts uppgiften om låsningen direkt på den minnessida där den låsta raden finns. Tack vare denna metod är Oracle en mästare på prestanda bland monolitiska databaser: låsningsservicen blir aldrig en flaskhals. Men i en klusterkonfiguration kan sådan arkitektur leda till intensiv nätverkstrafik och ömsesidiga låsningar.
Så snart en post låses, meddelar instansen alla andra instanser om att sidan där denna post finns har tagits i monopolläge. Om en annan instans behöver ändra posten på samma sida måste den vänta tills ändringarna på sidan har bekräftats, dvs. informationen om ändringen har skrivits till loggen på disken (under tiden kan transaktionen fortsätta). Det kan också hända att sidan ändras sekventiellt av flera instanser, och då måste det vid skrivning av sidan till disken tas reda på vilken som har den aktuella versionen av denna sida.
Oavsiktlig uppdatering av samma sidor via olika noder i RAC leder till en dramatisk sänkning av databasens prestanda - till den grad att klustrets prestanda kan vara lägre än en enda instans.
Rätt användning av Oracle RAC innebär fysisk uppdelning av data (t.ex. med hjälp av mekanismen för partitionerade tabeller) och åtkomst till varje datamängd via en dedikerad nod. Huvudsyftet med RAC blev inte horisontell skalning, utan att säkerställa redundans.
Om en nod slutar svara på heartbeat, startar den nod som först upptäckte detta proceduren för röstning på disken. Om den saknade noden inte heller registreras här, tar en av noderna på sig ansvaret för dataräddning:
- «fryser» alla sidor som fanns i cachen för den saknade noden;
- läser loggarna (redo) för den saknade noden och återanvänder ändringarna som registrerades i dessa loggar, samtidigt som det kontrollerar om andra noder har nyare versioner av de ändrade sidorna;
- återställer ofullständiga transaktioner.
För att underlätta växlingen mellan noder finns det i Oracle ett begrepp kallat service – ett virtuellt instance. En instans kan betjäna flera tjänster, och en tjänst kan flytta mellan noder. En applikationsinstans som betjänar en viss del av databasen (t.ex. en kundgrupp) arbetar med en tjänst, och tjänsten som ansvarar för den delen av databasen flyttar till en annan nod när en nod går ner.
IBM Pure Data Systems for Transactions
Klusterlösningen för databashanteringssystem etablerades i den blåkraftiga portföljen 2009. Ideologiskt är det en arvtagare till klustret Parallel Sysplex, som är byggt på "vanlig" utrustning. 2009 släpptes produkten DB2 pureScale, som är en mjukvarupaket, och 2012 erbjuder IBM en programvaru-hårdvarukomponent (appliance) kallad Pure Data Systems for Transactions. Måste inte förväxlas med Pure Data Systems for Analytics, som är inget annat än ett omdöpt Netezza.
Arkitekturen pureScale liknar vid första ögonkastet Oracle RAC: på samma sätt är flera noder anslutna till ett gemensamt datalager, och på varje nod körs en egen instans av databashanteringssystemet med sina egna minnesområden och transaktionsloggar. Men till skillnad från Oracle har DB2 en dedikerad låsservice, representerad av ett set av processer db2LLM*. I klusterkonfigurationen placeras denna service på en separat nod, som i Parallel Sysplex kallas coupling facility (CF), och i Pure Data – PowerHA.
PowerHA tillhandahåller följande tjänster:
- låsmanager;
- global buffertcache;
- område för mellanprocesskommunikation.
För dataöverföring mellan PowerHA och databaserna används fjärråtkomst till minnet, så klusterinterkonnekt måste stödja RDMA-protokollet. PureScale kan använda både Infiniband och RDMA över Ethernet.
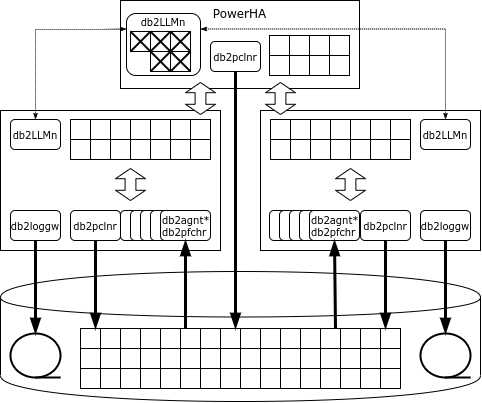
Om en nod behöver en sida, och den sidan inte finns i cachen, begär noden sidan i den globala cachen, och först om den inte finns där, läser den från disken. Till skillnad från Oracle går förfrågan endast till PowerHA och inte till angränsande noder.
Om en instans ska ändra en rad, låser den den i exklusivt läge och sidan där raden finns i delat läge. Alla lås registreras i den globala låshanteraren. När transaktionen är slutförd skickar noden ett meddelande till låshanteraren, som kopierar den ändrade sidan till den globala cachen, tar bort låsningarna och ogiltigförklarar den ändrade sidan i kassor från andra noder.
Om sidan som innehåller den ändrade raden redan är låst, kommer låshanteraren att läsa den ändrade sidan från minnet av noden som gjorde ändringarna, ta bort låsningen, ogiltigförklara den ändrade sidan i kassor från andra noder och ge låsningen av sidan till noden som begärde den.
"Smutsiga", det vill säga ändrade, sidor kan skrivas till disk både från en vanlig nod och från PowerHA (castout).
Vid fel på en av noderna i pureScale är återställningen begränsad till de transaktioner som vid tidpunkten för fel fortfarande inte hade avslutats: sidor som ändrades av denna nod i avslutade transaktioner finns i den globala cachen på PowerHA. Noden startas om i en nedskuren konfiguration på en av servrarna i klustret, rullar tillbaka de ouppklarade transaktionerna och frigör låsningar.
PowerHA fungerar på två servrar, och den primära noden replikerar sitt tillstånd synkront. Vid fel på den primära noden fortsätter PowerHA-klustret att arbeta med den backup-nod som finns.
Självklart, om man hänvisar till en datamängd via en nod, kommer den övergripande prestandan för klustret att vara högre. PureScale kan till och med märka att ett visst datakluster behandlas av en nod, och då kommer alla lås som rör detta område att hanteras av noden lokalt utan kommunikation med PowerHA. Men så snart applikationen försöker få åtkomst till dessa data via en annan nod, kommer den centraliserade låshanteringen att återupptas.
IBMs interna belastningstester, bestående av 90% läsning och 10% skrivning, vilket liknar en verklig industriell belastning, visar nästan linjär skalning upp till 128 noder. Tyvärr avslöjas inte testvillkoren.
HPE NonStop SQL
Hewlett-Packard Enterprise har också sin egen högtillgängliga plattform. Det är en NonStop-plattform som lanserades på marknaden 1976 av Tandem Computers. År 1997 förvärvades företaget av Compaq, som i sin tur gick samman med Hewlett-Packard år 2002.
NonStop används för att bygga kritiska applikationer – till exempel HLR eller hantering av bankkort. Plattformen levereras i form av en programvaru- och hårdvarukomplex (appliance), som inkluderar beräkningsnoder, lagringssystem och kommunikationsutrustning. Nätverket ServerNet (i moderna system – Infiniband) används både för kommunikation mellan noder och för åtkomst till lagringssystemet.
I de tidiga versionerna av systemet användes proprietära processorer, som var synkroniserade med varandra: alla operationer utfördes synkront av flera processorer, och så fort en av processorerna gjorde ett fel stängdes den av medan den andra fortsatte sin verksamhet. Senare gick systemet över till vanliga processorer (först MIPS, sedan Itanium och slutligen x86), och andra mekanismer började användas för synkronisering:
- meddelanden: varje systemprocess har en dubbelgångare som kallas "skugga", som den aktiva processen regelbundet skickar meddelanden om sitt tillstånd; vid fel på den primära processen börjar den skuggliknande processen arbete från den punkt som anges av det senaste meddelandet;
- omröstning: lagringssystemet har en speciell hårdvarukomponent som tar emot flera identiska förfrågningar och utför dem endast om förfrågningarna överensstämmer; istället för fysisk synkronisering arbetar processorerna asynkront, och resultaten av deras arbete jämförs endast vid in- och utmatning.
Sedan 1987 har en relationsdatabas, först SQL/MP och senare SQL/MX, fungerat på NonStop-plattformen.
Hela databasen delas upp i delar, och varje del ansvaras av sin egen Data Access Manager (DAM). Den säkerställer dataskrivning, caching och låsmekanismer. Databehandling hanteras av exeuterande processer (Executor Server Process) som arbetar på samma noder som de motsvarande datamanagerna. SQL/MX-schemaläggaren fördelar uppgifter mellan utövare och samlar resultaten. När det är nödvändigt att göra samordnade ändringar används en tvåfaskommittéprotokoll, utförd av TMF-biblioteket (Transaction Management Facility).
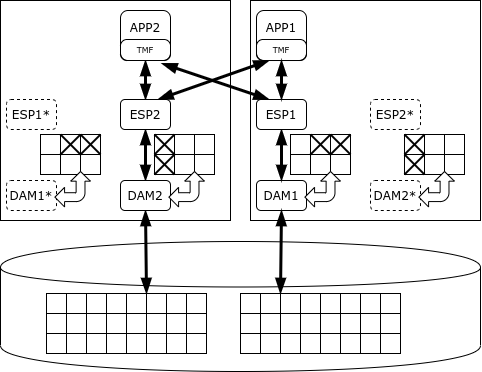
NonStop SQL kan prioritera processer så att långa analytiska frågor inte stör utförandet av transaktioner. Dess syfte är dock just att behandla korta transaktioner, inte analys. Utvecklaren garanterar tillgänglighet för NonStop-klustret på nivå fem "nior", vilket betyder att stilleståndet bara utgör 5 minuter per år.
SAP HANA
Den första stabila versionen av databashanteringssystemet HANA (1.0) släpptes i november 2010, och SAP ERP-paketet övergick till HANA i maj 2013. Plattformen baseras på förvärvade teknologier: TREX-sökmotorn (sökning i kolumnlagring), databashanteringssystemet P*TIME och MAX DB.
Själva ordet "HANA" är en akronym, High performance ANalytical Appliance. Detta databashanteringssystem levereras som kod som kan köras på alla x86-servrar, men industriinstallationer tillåts endast på certifierad hårdvara. Det finns lösningar från HP, Lenovo, Cisco, Dell, Fujitsu, Hitachi, NEC. Vissa Lenovo-konfigurationer tillåter till och med drift utan SAN - klustret GPFS på lokala diskar fungerar som en gemensam lagring.
Till skillnad från de ovan nämnda plattformarna är HANA ett minnesbaserat databashanteringssystem, vilket innebär att den primära bilden av data lagras i RAM, medan endast loggar och periodiska avbildningar skrivs till disk - för att möjliggöra återställning vid en krasch.
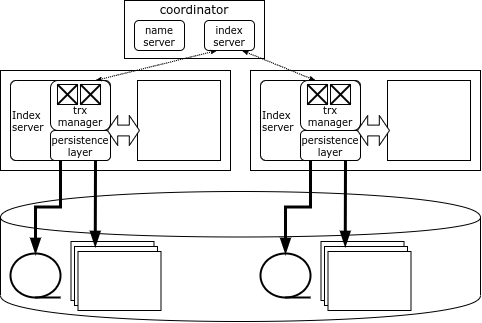
Varje nod i HANA-klustret ansvarar för sin del av data, och datakartan lagras i en speciell komponent - Name Server, som är belägen på samordningsnoden. Data dupliciteter inte mellan noder. Information om lås lagras också på varje nod, men systemet har en global detektor för dödlägen.
HANA-klienten laddar ner topologin för klustret när den ansluter och kan sedan direkt kommunicera med vilken nod som helst beroende på vilka data som krävs. Om en transaktion berör data från en enda nod kan den utföras lokalt av den noden, men om flera noders data förändras, kontaktar initiatorn noden för att samordna en distribuerad transaktion, vilket bekräftas med ett optimerat protokoll för tvåfasåterkoppling.
Koordinatornoden är duplikerad, vilket innebär att om koordinatorn går ner, träder reservnoden omedelbart i kraft. Om en nod med data går ner är det enda sättet att få åtkomst till dess data att starta om noden. Vanligtvis har HANA-kluster en reservserver för att snabbt kunna starta om en förlorad nod.
Källa: habr.com
