

Hej, Habr-besökare. Som vi redan har skrivit, lanserar OTUS två kurser i maskininlärning den här månaden, nämligen och . I samband med detta fortsätter vi att dela användbart material.
Syftet med denna artikel är att berätta om vår första erfarenhet av .
Vi kommer att börja översikten med dess tracking-server och logga alla iterationer av forskningen. Därefter delar vi vår erfarenhet av att koppla Spark med MLflow med hjälp av UDF.
Kontext
En kort historia om containrar: från chroot till Kubernetes använder maskininlärning och artificiell intelligens för att ge människor möjlighet att ta hand om sin hälsa och sitt välbefinnande. Därför ligger maskininlärningsmodellerna till grund för de databehandlingsprodukter vi utvecklar, och därför blev vi intresserade av MLflow - en plattform med öppen källkod som omfattar alla aspekter av maskininlärningens livscykel.
MLflow
Huvudsyftet med MLflow är att tillhandahålla ett extra lager ovanpå maskininlärning som skulle låta datavetare arbeta praktiskt med vilket maskininlärningsbibliotek som helst (, , , , och ), för att ta dess funktioner till en ny nivå.
MLflow erbjuder tre komponenter:
- Tracking – inspelning och förfrågningar om experiment: kod, data, konfiguration och resultat. Att följa utvecklingen av en modell är mycket viktigt.
- Projekt – Paketformat för körning på vilken plattform som helst (till exempel, )
- Models – ett gemensamt format för att skicka modeller till olika distributionsverktyg.
MLflow (vid tidpunkten för artikelns skrivande i alpha-version) är en plattform med öppen källkod som möjliggör hantering av livscykeln för maskininlärning, inklusive experiment, återanvändning och distribution.
Konfigurering av MLflow
För att använda MLflow måste hela Python-miljön först konfigureras, för detta kommer vi att använda (för att installera Python på Mac, titta gärna ). Så kan vi skapa en virtuell miljö där vi installerar alla nödvändiga bibliotek för att köra.
```
pyenv install 3.7.0
pyenv global 3.7.0 # Använd Python 3.7
mkvirtualenv mlflow # Skapa en virtuell miljö med Python 3.7
workon mlflow
```
Vi installerar de nödvändiga biblioteken.
```
pip install mlflow==0.7.0
            Cython==0.29
            numpy==1.14.5
            pandas==0.23.4
            pyarrow==0.11.0
```
Obs: vi använder PyArrow för att köra sådana modeller som UDF. Versionerna av PyArrow och Numpy behövde justeras eftersom de senaste versionerna krockade med varandra.
Kör Tracking UI
MLflow Tracking låter oss logga och göra förfrågningar på experiment med hjälp av Python och API. Utöver detta kan vi definiera var modellarterna ska lagras (localhost, , , eller ). Eftersom vi på Alpha Health använder AWS, kommer S3 att fungera som lagring för modellarterna.
# Running a Tracking Server
mlflow server
    --file-store /tmp/mlflow/fileStore
    --default-artifact-root s3://<bucket>/mlflow/artifacts/
    --host localhost
    --port 5000
MLflow rekommenderar att använda permanent fil lagring. Fil lagring är en plats där servern kommer att lagra metadata för körningar och experiment. När servern startas, se till att den pekar på permanent fil lagring. Här för experimentet kommer vi att använda /tmp.
Kom ihåg att om vi vill använda mlflow-servern för att köra gamla experiment, måste de finnas i fil lagringen. Men även utan detta skulle vi kunna använda dem i UDF, eftersom vi bara behöver sökvägen till modellen.
Obs: Tänk på att Tracking UI och modelklienten måste ha åtkomst till platsen för artefakten. Det vill säga, oavsett att Tracking UI ligger i en EC2-instans, måste maskinen ha direkt åtkomst till S3 för att skriva modellarterna lokalt när MLflow startas.
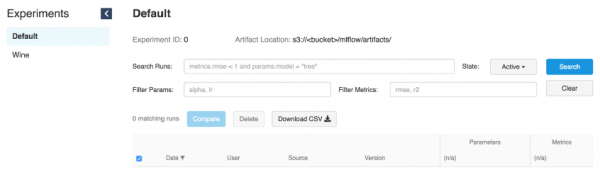
Tracking UI lagrar artefakterna i en S3-bucket
Körning av modeller
Så snart Tracking-servern är igång kan vi börja träna modeller.
Som exempel kommer vi att använda en modifiering av wine från MLflow-exemplet i .
MLFLOW_TRACKING_URI=http://localhost:5000 python wine_quality.py
  --alpha 0.9
  --l1_ration 0.5
  --wine_file ./data/winequality-red.csv
Som vi redan har nämnt, låter MLflow oss logga parametrar, metrik och artefakter av modeller så att vi kan spåra hur de utvecklas över iterationerna. Denna funktion är extremt användbar eftersom vi då kan reproducera den bästa modellen genom att gå till Tracking-servern eller förstå vilken kod som körde den nödvändiga iterationen genom att använda loggar av git hash-kommentarerna.
with mlflow.start_run():

    ... model ...

    mlflow.log_param("source", wine_path)
    mlflow.log_param("alpha", alpha)
    mlflow.log_param("l1_ratio", l1_ratio)

    mlflow.log_metric("rmse", rmse)
    mlflow.log_metric("r2", r2)
    mlflow.log_metric("mae", mae)

    mlflow.set_tag('domain', 'wine')
    mlflow.set_tag('predict', 'quality')
mlflow.sklearn.log_model(lr, "model") 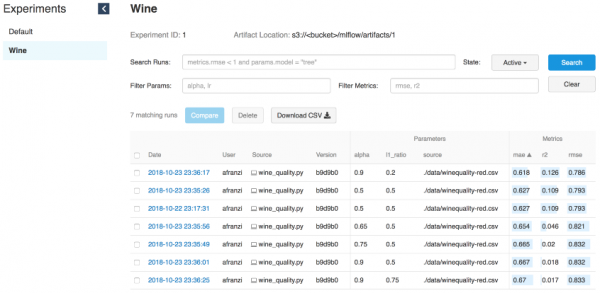
Wine-iterationer
Serverdelen för modellen
MLflow-trackingserver som körs med kommandot “mlflow server” har ett REST API för att spåra körningar och registrera data i det lokala filsystemet. Du kan ange adressen till trackingservern med miljövariabeln «MLFLOW_TRACKING_URI», och MLflows tracking API kommer automatiskt att ansluta till trackingservern på denna adress för att skapa/hämta information om körningar, loggmetrik, etc.
Källa:
För att tillhandahålla modellen med en server behöver vi en aktiv trackingserver (se startgränssnittet) och modellens Run ID.
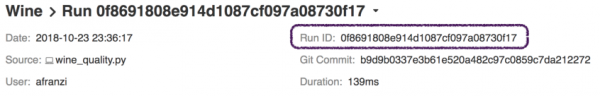
Run ID
# Serve a sklearn model through 127.0.0.0:5005
MLFLOW_TRACKING_URI=http://0.0.0.0:5000 mlflow sklearn serve
  --port 5005
  --run_id 0f8691808e914d1087cf097a08730f17
  --model-path model
För att hantera modeller med hjälp av MLflow serve-funktionalitet behöver vi tillgång till Tracking UI för att hämta information om modellen genom att helt enkelt ange --run_id.
När modellen kopplas till trackingservern kan vi få en ny modellens slutpunkt.
# Query Tracking Server Endpoint
curl -X POST
  http://127.0.0.1:5005/invocations
  -H 'Content-Type: application/json'
  -d '[
	{
		"fixed acidity": 3.42,
		"volatile acidity": 1.66,
		"citric acid": 0.48,
		"residual sugar": 4.2,
		"chloridessssss": 0.229,
		"free sulfur dsioxide": 19,
		"total sulfur dioxide": 25,
		"density": 1.98,
		"pH": 5.33,
		"sulphates": 4.39,
		"alcohol": 10.8
	}
]'

> {"predictions": [5.825055635303461]}
Kör modeller från Spark
Även om trackingservern är tillräckligt kraftfull för att betjäna modeller i realtid, deras träning och utnyttjande av serve-funktionaliteten (källa: ), är användningen av Spark (batch eller streaming) en ännu kraftfullare lösning tack vare dess distribuerade natur.
Tänk dig att du just har genomfört träning offline och sedan tillämpat den slutgiltiga modellen på alla dina data. Just här kommer Spark och MLflow att visa sina bästa sidor.
Installera PySpark + Jupyter + Spark
Källa:
För att visa hur vi tillämpar MLflow-modeller på Spark-dataramar måste vi konfigurera samarbetet mellan Jupyter-notebookar och PySpark.
Börja med att installera den senaste stabila versionen :
cd ~/Downloads/
tar -xzf spark-2.4.3-bin-hadoop2.7.tgz
mv ~/Downloads/spark-2.4.3-bin-hadoop2.7 ~/
ln -s ~/spark-2.4.3-bin-hadoop2.7 ~/spark
Installera PySpark och Jupyter i den virtuella miljön:
pip install pyspark jupyterKonfigurera miljövariabler:
export SPARK_HOME=~/spark
export PATH=$SPARK_HOME/bin:$PATH
export PYSPARK_DRIVER_PYTHON=jupyter
export PYSPARK_DRIVER_PYTHON_OPTS="notebook --notebook-dir=${HOME}/Projects/notebooks"
Genom att definiera notebook-dir, kan vi lagra våra notebooks i önskad mapp.
Kör Jupyter från PySpark
Eftersom vi har kunnat konfigurera Jupyter som PySpark-drivrutin kan vi nu köra Jupyter notebook i kontexten av PySpark.
(mlflow) afranzi:~$ pyspark
[I 19:05:01.572 NotebookApp] sparkmagic-tillägg aktiverat!
[I 19:05:01.573 NotebookApp] Serverar anteckningsblock från lokal katalog: /Users/afranzi/Projects/notebooks
[I 19:05:01.573 NotebookApp] Jupyter Notebook körs på:
[I 19:05:01.573 NotebookApp] http://localhost:8888/?token=c06252daa6a12cfdd33c1d2e96c8d3b19d90e9f6fc171745
[I 19:05:01.573 NotebookApp] Använd Control-C för att stoppa den här servern och stänga av alla kärnor (tryck två gånger för att hoppa över bekräftelsen).
[C 19:05:01.574 NotebookApp]

    Kopiera/klistra in den här URL:en i din webbläsare när du ansluter för första gången,
    för att logga in med en token:
http://localhost:8888/?token=c06252daa6a12cfdd33c1d2e96c8d3b19d90e9f6fc171745 
Som nämnts ovan tillhandahåller MLflow en funktion för att logga artefakter av modellen i S3. När vi väl har modellen i våra händer kan vi importera den som UDF med hjälp av modulen mlflow.pyfunc.
import mlflow.pyfunc

model_path = 's3:///mlflow/artifacts/1/0f8691808e914d1087cf097a08730f17/artifacts/model'
wine_path = '/Users/afranzi/Projects/data/winequality-red.csv'
wine_udf = mlflow.pyfunc.spark_udf(spark, model_path)

df = spark.read.format("csv").option("header", "true").option('delimiter', ';').load(wine_path)
columns = [ "fast syra", "flyktig syra", "citronsyra",
            "resterande socker", "klorider", "fri svavel-dioxid",
            "total svavel-dioxid", "densitet", "pH",
            "sulfater", "alkohol"
          ]

df.withColumn('prediction', wine_udf(*columns)).show(100, False) 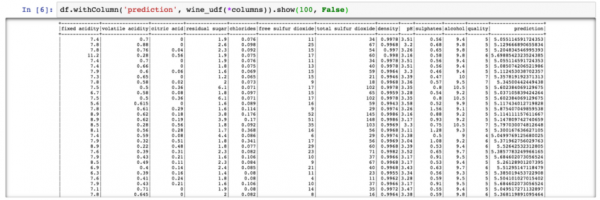
PySpark – Utskrift av vinens kvalitetsprediktion
Hitintills har vi pratat om hur man använder PySpark med MLflow genom att köra vinets kvalitetsprediktion på hela datasetet. Men vad händer om man måste använda Python-moduler från MLflow i Scala Spark?
Vi har testat det också, och delat Spark-kontot mellan Scala och Python. Det vill säga att vi registrerade MLflow UDF i Python och använde den från Scala (ja, kanske inte den bästa lösningen, men vad vi har).
Scala Spark + MLflow
För detta exempel kommer vi att lägga till till den befintliga Jupiter.
Installera Spark + Toree + Jupyter
pip install toree
jupyter toree install --spark_home=${SPARK_HOME} --sys-prefix
jupyter kernelspec list
```
```
Tillgängliga kärnor:
  apache_toree_scala    /Users/afranzi/.virtualenvs/mlflow/share/jupyter/kernels/apache_toree_scala
  python3               /Users/afranzi/.virtualenvs/mlflow/share/jupyter/kernels/python3
```
Som visas i det bifogade anteckningsblocket används UDF tillsammans med Spark och PySpark. Vi hoppas att denna del kommer att vara användbar för dem som älskar Scala och vill distribuera maskininlärningsmodeller i produktion.
import org.apache.spark.sql.functions.col
import org.apache.spark.sql.types.StructType
import org.apache.spark.sql.{Column, DataFrame}
import scala.util.matching.Regex

val FirstAtRe: Regex = "^_".r
val AliasRe: Regex = "[\s_.:@]+".r

def getFieldAlias(field_name: String): String = {
    FirstAtRe.replaceAllIn(AliasRe.replaceAllIn(field_name, "_"), "")
}

def selectFieldsNormalized(columns: List[String])(df: DataFrame): DataFrame = {
    val fieldsToSelect: List[Column] = columns.map(field =>
        col(field).as(getFieldAlias(field))
    )
    df.select(fieldsToSelect: _*)
}

def normalizeSchema(df: DataFrame): DataFrame = {
    val schema = df.columns.toList
    df.transform(selectFieldsNormalized(schema))
}

FirstAtRe = ^_
AliasRe = [s_.:@]+

getFieldAlias: (field_name: String)String
selectFieldsNormalized: (columns: List[String])(df: org.apache.spark.sql.DataFrame)org.apache.spark.sql.DataFrame
normalizeSchema: (df: org.apache.spark.sql.DataFrame)org.apache.spark.sql.DataFrame
Out[1]:
[s_.:@]+
In [2]:
val winePath = "~\/Research\/mlflow-workshop\/examples\/wine_quality\/data\/winequality-red.csv"
val modelPath = "\/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model"

winePath = ~\/Research\/mlflow-workshop\/examples\/wine_quality\/data\/winequality-red.csv
modelPath = \/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model
Out[2]:
\/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model
In [3]:
val df = spark.read
              .format("csv")
              .option("header", "true")
              .option("delimiter", ";")
              .load(winePath)
              .transform(normalizeSchema)

df = [fixed_acidity: string, volatile_acidity: string ... 10 more fields]
Out[3]:
[fixed_acidity: string, volatile_acidity: string ... 10 more fields]
In [4]:
%%PySpark
import mlflow
from mlflow import pyfunc

model_path = "\/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model"
wine_quality_udf = mlflow.pyfunc.spark_udf(spark, model_path)

spark.udf.register("wineQuality", wine_quality_udf)
Out[4]:
<function spark_udf..predict at 0x1116a98c8>
In [6]:
df.createOrReplaceTempView("wines")
In [10]:
%%SQL
SELECT
    quality,
    wineQuality(
        fixed_acidity,
        volatile_acidity,
        citric_acid,
        residual_sugar,
        chlorides,
        free_sulfur_dioxide,
        total_sulfur_dioxide,
        density,
        pH,
        sulphates,
        alcohol
    ) AS prediction
FROM wines
LIMIT 10
Out[10]:
+-------+------------------+
|quality|        prediction|
+-------+------------------+
|      5| 5.576883967129615|
|      5|  5.50664776916154|
|      5| 5.525504822954496|
|      6| 5.504311247097457|
|      5| 5.576883967129615|
|      5|5.5556903912725755|
|      5| 5.467882654744997|
|      7| 5.710602976324739|
|      7| 5.657319539336507|
|      5| 5.345098606538708|
+-------+------------------+

In [17]:
spark.catalog.listFunctions.filter('name like "%wineQuality%").show(20, false)

+-----------+--------+-----------+---------+-----------+
|name       |database|description|className|isTemporary|
+-----------+--------+-----------+---------+-----------+
|wineQuality|null    |null       |null     |true       |
+-----------+--------+-----------+---------+-----------+
Följande steg
Trots att MLflow vid tidpunkten för denna artikel är i Alpha-version, ser den lovande ut. Möjligheten att köra flera maskininlärningsramverk och använda dem från en enda slutpunkt tar rekommendationssystem på en ny nivå.
Dessutom sammanför MLflow dataingenjörer och datavetare genom att skapa ett gemensamt lager mellan dem.
Efter denna forskning om MLflow är vi övertygade om att vi kommer att gå vidare och använda det för våra Spark-flöden och i rekommendationssystem.
Det skulle vara bra att synkronisera filsystemet med databasen, istället för att använda filsystemet. Så vi borde få flera slutpunkter som kan använda samma filsystem. Till exempel, att använda flera instanser och med samma Glue metastore.
Sammanfattningsvis vill vi tacka MLFlow-gemenskapen för att ni gör vårt arbete med data mer intressant.
Om du experimenterar med MLflow, tveka inte att skriva till oss och berätta hur du använder det, särskilt om du använder det i produktion.
Läs mer om kurserna:
Läs mer:
Källa: habr.com
