

Flera månader sedan — en offentlig för PostgreSQL.
Under denna tid har du redan använt den över 6000 gånger, men en av de praktiska funktionerna kan ha förblivit oupptäckta — det är strukturella tips, som ser ut ungefär så här:
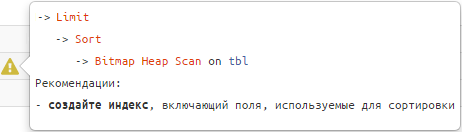
Lyssna på dem, och dina frågor kommer att bli "släta och silkeslena". 🙂
Men allvarligt talat, många situationer som gör en fråga långsam och "resurskrävande" är typiska och kan kännas igen genom strukturen och datan i planen..
I sådana fall behöver varje enskild utvecklare inte söka efter optimeringsalternativ på egen hand, baserat enbart på sin erfarenhet — vi kan ge honom en ledtråd om vad som händer, vad som kan vara orsaken och hur man kan närma sig en lösning. Det har vi gjort.
Låt oss titta lite närmare på dessa fall — hur de identifieras och vilka rekommendationer de leder till.
För en bättre förståelse av ämnet, kan man först lyssna på motsvarande del av , och först sedan gå vidare till en detaljerad analys av varje exempel:
#1: индексная «недосортировка»
När det uppstår
Visa senaste fakturan för kunden "AB Klocka".
Hur man identifierar
-> Limit
   -> Sort
      -> Index [Endast] Scan [Bakåt] | Bitmap Heap Scan
Rekommendationer
Använd index utöka med sorteringsfält.
Exempel:
SKAPA TABELL tbl SOM
SELECT
  generate_series(1, 100000) pk  -- 100K "fakta"
, (random() * 1000)::integer fk_cli; -- 1K olika externa nycklar

SKAPA INDEX PÅ tbl(fk_cli); -- index för foreign key

SELECT
  *
FROM
  tbl
WHERE
  fk_cli = 1 -- urval baserat på specifik relation
ORDER BY
  pk DESC -- vi vill bara ha en "senaste" post
LIMIT 1; 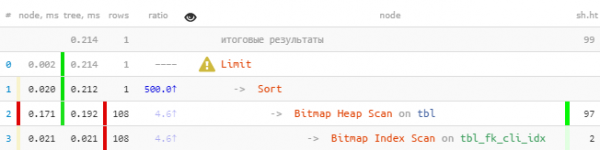
Det kan genast noteras att mer än 100 poster lästes av indexet, som sedan sorteras och en enda behålls.
Vi åtgärdar:
DROP INDEX tbl_fk_cli_idx;
SKAPA INDEX PÅ tbl(fk_cli, pk DESC); -- tillade sorteringsnyckel
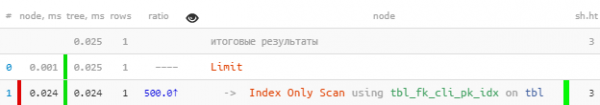
Även på en så primitiv urval — 8.5 gånger snabbare och 33 gånger färre läsningar. Effekten kommer att bli desto tydligare ju fler du har "fakta" per värde fk.
Jag påpekar att detta index kommer att fungera som "prefix" lika bra som det tidigare och för andra frågor med fk, där sorteringarna på pk inte fanns och inte finns (mer om detta kan du läsa ). Det kommer även säkerställa normal stöd för explicita foreign key för detta fält.
#2: пересечение индексов (BitmapAnd)
När det uppstår
Visa alla avtal för kunden «OOO Kolokolchik», ingångna i namn av «NAO Lyutik».
Hur man identifierar
-> BitmapAnd
   -> Bitmap Index Scan
   -> Bitmap Index Scan
Rekommendationer
Skapa kompositindex på fälten från båda källorna eller utvidga en av de befintliga med fält från den andra.
Exempel:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk      -- 100K "fakta"
, (random() *  100)::integer fk_org  -- 100 olika externa nycklar
, (random() * 1000)::integer fk_cli; -- 1K olika externa nycklar

CREATE INDEX ON tbl(fk_org); -- index för foreign key
CREATE INDEX ON tbl(fk_cli); -- index för foreign key

SELECT
  *
FROM
  tbl
WHERE
(fk_org, fk_cli) = (1, 999); -- urval efter ett specifikt par 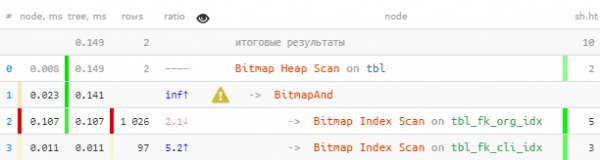
Vi åtgärdar:
DROP INDEX tbl_fk_org_idx;
CREATE INDEX ON tbl(fk_org, fk_cli);
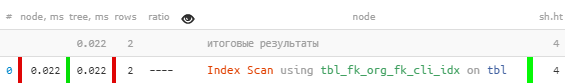
Här är vinsten mindre eftersom Bitmap Heap Scan är tillräckligt effektiv i sig. Men ändå 7 gånger snabbare och 2.5 gånger färre läsningar.
#3: объединение индексов (BitmapOr)
När det uppstår
Visa de första 20 äldsta "egna" eller icke tilldelade ärendena för behandling, där de egna har prioritet.
Hur man identifierar
-> BitmapOr
   -> Bitmap Index Scan
   -> Bitmap Index Scan
Rekommendationer
Använd UNION [ALL] för att kombinera underfrågor för varje OR-block av villkor.
Exempel:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk  -- 100K "fakta"
, CASE
    WHEN random() < 1::real/16 THEN NULL -- med sannolikhet 1:16 gör posten "oavgjort"
    ELSE (random() * 100)::integer -- 100 olika externa nycklar
  END fk_own;

CREATE INDEX ON tbl(fk_own, pk); -- index med "det verkar passa" sortering

SELECT
  *
FROM
  tbl
WHERE
  fk_own = 1 OR -- egna
  fk_own IS NULL -- ... eller "oavgjorda"
ORDER BY
  pk
, (fk_own = 1) DESC -- först "egna"
LIMIT 20;
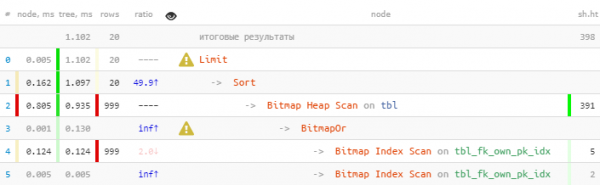
Vi åtgärdar:
(
  SELECT
    *
  FROM
    tbl
  WHERE
    fk_own = 1 -- först "egna" 20
  ORDER BY
    pk
  LIMIT 20
)
UNION ALL
(
  SELECT
    *
  FROM
    tbl
  WHERE
    fk_own IS NULL -- sedan "oavgjorda" 20
  ORDER BY
    pk
  LIMIT 20
)
LIMIT 20; -- men totalt - 20, mer behövs inte 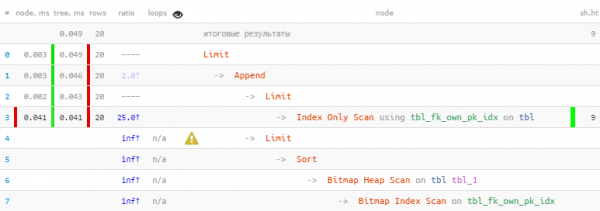
Vi utnyttjade att alla 20 nödvändiga poster redan erhölls i det första blocket, så den andra, med en "dyrare" Bitmap Heap Scan, kördes inte ens — slutligen 22 gånger snabbare, 44 gånger färre läsningar!
En mer detaljerad berättelse om denna optimeringsmetod med konkreta exempel kan läsas i artiklar och .
En generaliserad version av ordnad urval efter flera nycklar (och inte bara efter paret const/NULL) diskuteras i artikeln .
#4: читаем много лишнего
När det uppstår
Det uppstår vanligtvis när man vill "koppla till ännu ett filter" till en redan befintlig fråga.
"Och har ni inte en likadan, men med pärlemorknappar?» film "Den diamantiska handen"
Till exempel, genom att modifiera uppgiften ovan, visa de första 20 äldsta "kritiska" ansökningarna för behandling, oavsett deras tilldelning.
Hur man identifierar
-> Sekvensanalys | Bitmap Heap Scan | Index [Endast] Scan [Bakåt]
   && 5 × rader < RRbF -- filtrerat >80% av det lästa
   && loopar × RRbF > 100 -- och dessutom mer än 100 poster totalt
Rekommendationer
Skapa [mer] specialiserad index med WHERE-villkor eller inkludera ytterligare fält i indexet.
Om filtreringsvillkoret är "statiskt" för dina uppgifter - det vill säga inte förutser en utvidgning av värden i framtiden - är det bättre att använda WHERE-index. Olika boolean/enum-statusar passar bra in i denna kategori.
Om däremot filtreringsvillkoret kan ta olika värden, så är det bättre att utvidga indexet med dessa fält - som i situationen med BitmapAnd ovan.
Exempel:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk -- 100K "fakta"
, CASE
    WHEN random() < 1::real/16 THEN NULL
    ELSE (random() * 100)::integer -- 100 olika externa nycklar
  END fk_own
, (random() < 1::real/50) critical; -- 1:50, att ansökan är "kritisk"

CREATE INDEX ON tbl(pk);
CREATE INDEX ON tbl(fk_own, pk);

SELECT
  *
FROM
  tbl
WHERE
  critical
ORDER BY
  pk
LIMIT 20; 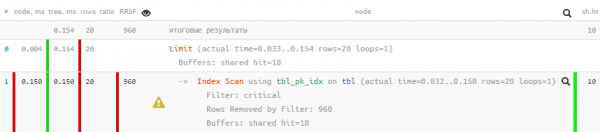
Vi åtgärdar:
CREATE INDEX ON tbl(pk)
  WHERE critical; -- lade till "statiskt" filtreringsvillkor
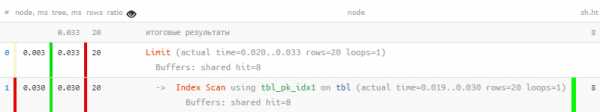
Som vi ser, försvann filtreringen från planen helt, och förfrågan blev 5 gånger snabbare.
#5: разреженная таблица
När det uppstår
Olika försök att skapa en egen kö för behandlingen av uppgifter, när ett stort antal uppdateringar/borttagningar av poster i tabellen leder till en situation med ett stort antal "döda" poster.
Hur man identifierar
-> Sekvensanalys | Bitmap Heap Scan | Index [Endast] Scan [Bakåt]
   && loopar × (rader + RRbF) < (delad träff + delad läsning) × 8
      -- läst mer än 1KB per poster
   && delad träff + delad läsning > 64
Rekommendationer
Regelbundet utföra VACUUM [FULL] eller uppnå tillräckligt frekvent bearbetning genom att justera dess parametrar, inklusive .
I de flesta fall orsakas sådana problem av dålig sammanställning av förfrågningar vid anrop från affärslogiken, som de som diskuterades i .
Men man måste förstå att även VACUUM FULL inte alltid kan hjälpa. För sådana fall är det värt att bekanta sig med algoritmen från artikeln .
#6: чтение с «середины» индекса
När det uppstår
Det verkar som vi har läst lite, och allt i index, och filtrerade inte bort någon overksamhet - men ändå har betydligt fler sidor lästs än önskat.
Hur man identifierar
-> Index [Only] Scan [Backward]
   && loops × (rows + RRbF)  64
Rekommendationer
Titta noga på strukturen av den använda index och nyckelområdena som anges i förfrågan – det är troligtvis en del av indexet är inte angivet. Antagligen behöver du skapa ett liknande index, men utan prefixfält eller .
Exempel:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk      -- 100K "fakta"
, (random() *  100)::integer fk_org  -- 100 olika externa nycklar
, (random() * 1000)::integer fk_cli; -- 1K olika externa nycklar

CREATE INDEX ON tbl(fk_org, fk_cli); -- nästan allt som i #2
-- endast att vi redan anser att en separat index på fk_cli är överflödig och har tagit bort den

SELECT
  *
FROM
  tbl
WHERE
  fk_cli = 999 -- och fk_org är inte angivet, även om det står tidigare i indexet
LIMIT 20; 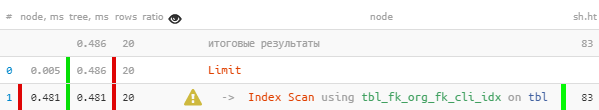
Allt verkar bra, även med indexet, men det verkar misstänkt – varje av de 20 lästa posterna krävde att vi läste fyra datalag, 32KB per post – är det inte för mycket? Även namnet på indexet tbl_fk_org_fk_cli_idx får en att fundera.
Vi åtgärdar:
CREATE INDEX ON tbl(fk_cli); 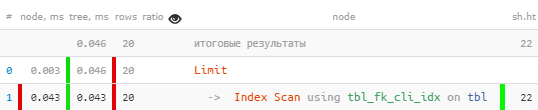
Plötsligt – 10 gånger snabbare, och 4 gånger mindre att läsa!
Andra exempel på ineffektiv användning av index kan ses i artikeln .
#7: CTE × CTE
När det uppstår
I förfrågan har vi skapat "feta" CTE från olika tabeller, och sedan bestämde vi oss för att göra en JOIN.
Fallet är aktuellt för versioner under v12 eller förfrågningar med WITH MATERIALIZED.
Hur man identifierar
-> CTE Scan
   && loops > 10
   && loops × (rows + RRbF) > 10000
      -- för stort kartesiskt produkt av CTE
Rekommendationer
Analysera noga förfrågan – är ? Если все-таки да, то tillämpa "ordlista" i hstore/json enligt modellen som beskrivs i .
#8: swap на диск (temp written)
När det uppstår
Engångshantering (sortering eller unifiering) av ett stort antal poster får inte plats i det avsatta minnet.
Hur man identifierar
-> *
   && temp written > 0
Rekommendationer
Om mängden minne som används av operationen inte överstiger det angivna värdet för parametern , bör det justeras. Kan göras direkt i konfigurationen för alla, eller via SET [LOCAL] för specifik förfrågan/transaktion.
Exempel:
SHOW work_mem;
-- "16MB"

SELECT
  random()
FROM
  generate_series(1, 1000000)
ORDER BY
1; 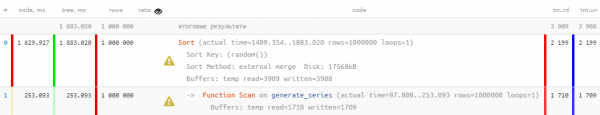
Vi åtgärdar:
SET work_mem = '128MB'; -- före utförande av förfrågan 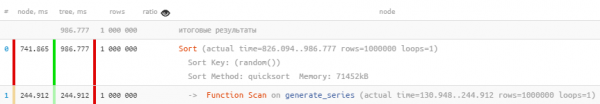
Av uppenbara skäl, om bara minne används och inte disk, så kommer också förfrågan att köras mycket snabbare. Samtidigt avlastas också en del av belastningen från HDD.
Men måste förstå att det inte alltid går att avsätta mycket minne – det kommer helt enkelt inte att räcka till alla.
#9: неактуальная статистика
När det uppstår
Det har pumpats in mycket i databasen, men vi hann inte köra igenom det. ANALYZE.
Hur man identifierar
-> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && ratio >> 10
Rekommendationer
Verkligen genomföra ANALYZE.
Mer detaljerad information om denna situation finns i .
#10: «что-то пошло не так»
När det uppstår
Det uppstod en väntan på en lås som satts av en konkurrerande förfrågan, eller så fanns det inte tillräckligt med CPU/hypervisor resurser.
Hur man identifierar
-> *
   && (shared hit / 8K) + (shared read / 1K) < time / 1000
      -- RAM hit = 64MB/s, HDD read = 8MB/s
   && time > 100ms -- vi läste lite, men det tog för lång tid
Rekommendationer
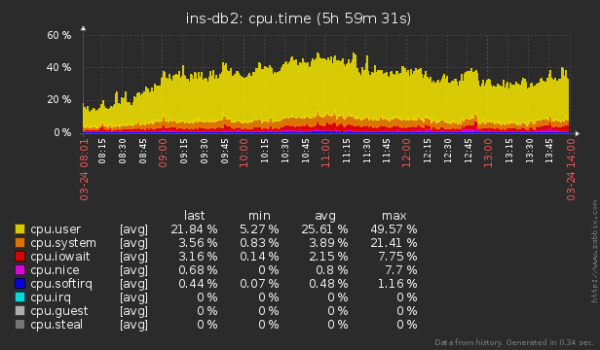
Använd ett externt övervakningssystem för servrar för att kontrollera förekomsten av låsningar eller onormal resursanvändning. Vi har redan berättat om vår metod för att organisera denna process för hundratals servrar. och .
Källa: habr.com
