

I denna artikel vill vi beskriva egenskaperna hos All Flash-arrayen AccelStor i samband med en av de mest populära virtualiseringsplattformarna – VMware vSphere. Särskilt fokus läggs på de parametrar som kan maximera effekten av att använda ett så kraftfullt verktyg som All Flash.
All Flash-arrayarna AccelStor NeoSapphire™ är eller noders enheter baserade på SSD-lagringslösningar med ett helt annat angreppssätt på datalagring och tillgång genom användning av egen teknologi istället för de mycket populära RAID-algoritmerna. Arrayen erbjuder blockåtkomst för värdar via Fibre Channel eller iSCSI-gränssnitt. För rättvisans skull bör det nämnas att modeller med iSCSI-gränssnitt också har filåtkomst som en trevlig bonus. Men i denna artikel fokuserar vi på användning av blockprotokoll som är de mest presterande för All Flash.
Hela processen för implementering och efterföljande konfiguration av samarbetet mellan AccelStor-arrayen och VMware vSphere-systemet kan delas upp i flera steg:
- Implementering av anslutningstopologi och konfiguration av SAN-nätverket;
- Konfiguration av All Flash-arrayen;
- Konfiguration av ESXi-värdar;
- Konfiguration av virtuella maskiner.
Som utrustning för exemplen användes AccelStor NeoSapphire™-array med Fibre Channel-gränssnitt och med iSCSI-gränssnitt. Som basprogramvara användes VMware vSphere 6.7U1.
Innan implementeringen av de system som beskrivs i artikeln rekommenderas starkt att bekanta sig med dokumentationen från VMware angående prestandafrågor ( ) och iSCSI-inställningar ()
Anslutningstopologi och konfiguration av SAN-nätverket
De huvudsakliga komponenterna i SAN-nätverket är HBA-adaptrar i ESXi-värdarna, SAN-switchar och noder i arrayen. En typisk topologi för ett sådant nätverk ser ut så här:
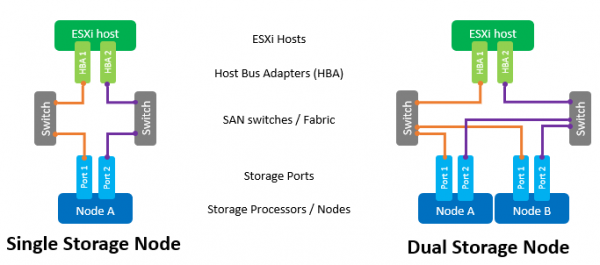
Med termen Switch avses här både en särskild fysisk switch eller en uppsättning switchar (Fabric), samt en delad enhet mellan olika tjänster (VSAN för Fibre Channel och VLAN för iSCSI). Användning av två oberoende switchar/Fabric möjliggör att eventuella felpunkter undvikes.
Direktanslutningar av värdar till arrayen stöds, men rekommenderas starkt inte. Prestandan för All Flash-arrayer är tillräckligt hög. För att uppnå maximal hastighet krävs det att alla portar i arrayen används. Därför är det nödvändigt att ha minst en switch mellan värdarna och NeoSapphire™.
Två portar på värdens HBA är också ett krav för att uppnå maximal prestanda och säkerställa redundans.
Vid användning av Fibre Channel-gränssnitt krävs zoninställning för att undvika potentiella kollisioner mellan initiatorer och mål. Zoner byggs på principen 'en initiatorport – en eller flera portar i arrayen'.
I fallet med anslutning via iSCSI, när en switch delas med andra tjänster, är det absolut nödvändigt att isolera iSCSI-trafiken inom en separat VLAN. Det rekommenderas starkt att aktivera stöd för Jumbo Frames (MTU = 9000) för att öka storleken på paketen i nätverket och därmed minska mängden overheadinformation vid överföring. Det är viktigt att komma ihåg att det krävs en ändring av MTU-inställningen på alla komponenter i nätverket i kedjan 'initiator-switch-mål' för korrekt funktion.
Konfiguration av All Flash-arrayen
Arrayen levereras till kunder med redan formade grupper . Därför behöver inga åtgärder vidtas för att sammanfoga lagringsenheter till en enhetlig struktur. Det räcker att skapa volymer i erforderlig storlek och antal.
För enkelhetens skull finns det en funktion för batchskapande av flera volymer av angiven storlek. Som standard skapas 'tunna' volymer, eftersom det gör att tillgängligt lagringsutrymme kan användas mer effektivt (bland annat tack vare stöd för Space Reclamation). Rent prestandamässigt är skillnaden mellan 'tunna' och 'tjocka' volymer inte mer än 1%. Men om det krävs för att 'få ut all kapacitet' ur arrayen, kan vilken 'tunn' volym som helst konverteras till 'tjock'. Men det är viktigt att komma ihåg att denna operation är oåterkallelig.
Därefter måste man "publicera" de skapade volymerna och ställa in åtkomstbehörigheter för dem från värdarna med hjälp av ACL (IP-adresser för iSCSI och WWPN för FC) samt fysisk uppdelning av arrayportar. För iSCSI-modeller görs detta genom att skapa ett Target.
För FC-modeller sker publiceringen genom att skapa en LUN för varje port i arrayen.
För att påskynda konfigurationsprocessen kan värdarna grupperas. Om en flervägs FC HBA används på värden (vilket oftast är fallet i praktiken), så identifierar systemet automatiskt att portar från denna HBA tillhör en och samma värd tack vare WWPN som skiljer sig med ett enhet. För båda gränssnitten stöds också batchskapande av Target/LUN.
En viktig observation vid användning av iSCSI-gränssnittet är att för volymer skapa flera targets samtidigt för att öka prestandan, eftersom kön på targeten inte kan ändras och kommer att bli en flaskhals.
Konfiguration av ESXi-värdar
Från ESXi-värdar utförs grundläggande konfiguration enligt ett ganska förväntat scenario. Handlingsordning för iSCSI-anslutning:
- Lägg till Software iSCSI Adapter (krävs inte om den redan har lagts till, eller vid användning av Hardware iSCSI Adapter);
- Skapa vSwitch genom vilken iSCSI-trafik kommer att passera, och lägga till fysiska uplink och VMkernel i den;
- Lägga till adresser till Dynamic Discovery för arrayen;
- Skapa Datastore
Några viktiga kommentarer:
- I allmänhet kan man faktiskt använda en redan existerande vSwitch, men i fallet med en separat vSwitch blir hanteringen av värdinställningarna betydligt enklare.
- Det är nödvändigt att separera Management-trafik och iSCSI på separata fysiska länkar och/eller VLAN för att undvika prestandaproblem.
- IP-adresser för VMkernel och motsvarande portar i All Flash-arrayen måste ligga inom samma subnät igen på grund av prestandafrågor.
- För att säkerställa redundans enligt VMware-regler måste vSwitch ha minst två fysiska uplink
- Om Jumbo Frames används är det nödvändigt att ändra MTU både på vSwitch och på VMkernel
- Det är värt att påminna om att enligt VMware-rekommendationerna för fysiska adaptrar som ska användas för iSCSI-trafik, är det nödvändigt att konfigurera Teaming and Failover. Specifikt ska varje VMkernal arbeta endast via en uplink, den andra uplinken ska ställas in på unused. För redundans behöver man lägga till två VMkernal, var och en av dem ska arbeta via sin egen uplink.
VMkernel Adapter (vmk#)
Physical Network Adapter (vmnic#)
vmk1 (Storage01)
Aktiva adaptrar
vmnic2
Oanvända adaptrar
vmnic3
vmk2 (Storage02)
Aktiva adaptrar
vmnic3
Oanvända adaptrar
vmnic2
För anslutning via Fibre Channel krävs inga förhandsåtgärder. Man kan direkt skapa en Datastore.
Efter skapandet av Datastore är det viktigt att verifiera att Round Robin-policy används för vägar till Target/LUN för bästa prestanda.
Som standard föreslår VMware att denna policy används med schemat: 1000 förfrågningar via den första vägen, följande 1000 förfrågningar via den andra vägen osv. Denna interaktion mellan värden och en tvåkontrollerad lagring kommer att vara obalanserad. Därför rekommenderar vi att ställa in Round Robin-policy = 1 via Esxcli/PowerCLI.
Parametrar
För Esxcli:
- Lista tillgängliga LUN
esxcli storage nmp device list
- Kopiera enhetsnamnet
- Ändra Round Robin-policy
esxcli storage nmp psp roundrobin deviceconfig set —type=iops —iops=1 —device=«Device_ID»
De flesta moderna applikationer är utformade för att utbyta stora datakaplar för att maximera bandbredden och minska belastningen på processorn. Därför överför ESXi som standard in-/utfrågningar till lagringsenheten i portioner upp till 32767 KB. Men för vissa scenarier kan mindre portioner vara mer effektiva. För AccelStor-lager är de följande scenarierna:
- Den virtuella maskinen använder UEFI istället för Legacy BIOS
- vSphere Replication används
För sådana scenarier rekommenderas det att ändra Disk.DiskMaxIOSize till 4096.
För iSCSI-anslutningar rekommenderas det att ändra Login Timeout-värdet till 30 (standard 5) för att öka stabiliteten i anslutningen och stänga av fördröjningsbekräftelser för överförda paket (DelayedAck). Båda alternativen finns i vSphere Client: Host → Configure → Storage → Storage Adapters → Advanced Options för iSCSI-adaptern.
En viktig aspekt är antalet volymer som används för datastore. Det är uppenbart att man för enkelhetens skull vill skapa en stor volym för hela lagringsutrymmet. Men att ha flera volymer och därmed flera datastores har en positiv inverkan på den totala prestandan (mer om köer nedan). Därför rekommenderar vi att skapa minst två volymer.
För inte så länge sedan rekommenderade VMware att begränsa antalet virtuella maskiner på en datastore för att uppnå maximal prestanda. Men nu, särskilt med spridningen av VDI, är detta problem inte längre så pressande. Det avskaffar dock inte den gamla regeln - att distribuera virtuella maskiner som kräver intensiv IO över olika datastores. För att bestämma det optimala antalet virtuella maskiner på en volym finns det inget bättre än att utföra inom din infrastruktur.
Konfigurering av virtuella maskiner
Det finns inga speciella krav för konfiguration av virtuella maskiner, snarare är de ganska ordinära:
- Använd den senaste möjliga versionen av VM (kompatibilitet)
- Var försiktig med att ställa in storleken på RAM när virtuella maskiner placeras tätt, till exempel i VDI (eftersom en växlingsfil av samma storlek som RAM skapas som standard vid start, vilket konsumerar nyttig kapacitet och påverkar den slutliga prestandan)
- Använd de mest prestandaeffektiva adapterversionerna: VMXNET 3 för nätverksadapter och PVSCSI för SCSI
- Använd disktyp Thick Provision Eager Zeroed för maximal prestanda och Thin Provisioning för att maximalt effektivisera lagringsutrymmet
- Begränsa om möjligt arbetet för I/O-oviktiga maskiner med hjälp av Virtual Disk Limit
- Se till att installera VMware Tools
Kommentarer om köer
Kö (eller Outstanding I/Os) är antalet in-/utmatningsförfrågningar (SCSI-kommandon) som väntar på behandling vid varje given tidpunkt för en specifik enhet/applikation. Vid överbelastning av kön uppstår fel QFULL, vilket i sin tur leder till en ökning av latensparametern. Vid användning av diskbaserade (spinnande) lagringssystem gäller teoretiskt att ju högre kö, desto högre är deras prestanda. Men man bör inte överdriva, eftersom det lätt kan leda till QFULL. I fallet med All Flash-system är det å ena sidan något enklare; eftersom enheten har mycket lägre latens och därför oftast inte kräver separat justering av köernas storlek. Å andra sidan, i vissa användningssituationer (kraftig obalans i IO-kraven för specifika virtuella maskiner, tester för maximal prestanda, etc.) kan det krävas att man åtminstone förstår vilka värden som kan uppnås, och viktigast av allt, vilka sätt som finns.
På själva All Flash-enheten AccelStor finns det inga begränsningar när det gäller volymer eller in-/utmatningsportar. Om så behövs kan även en enda volym få alla resurser från enheten. Det enda begränsningen för köer förekommer hos iSCSI-mål. Av just denna anledning angavs tidigare behovet av att skapa flera (idealiskt upp till 8 stycken) mål för varje volym för att övervinna denna begränsning. Låt oss också påminna om att AccelStor-enheterna är mycket prestandainriktade lösningar. Därför bör alla gränssnittsportar i systemet användas för att uppnå maximal hastighet.
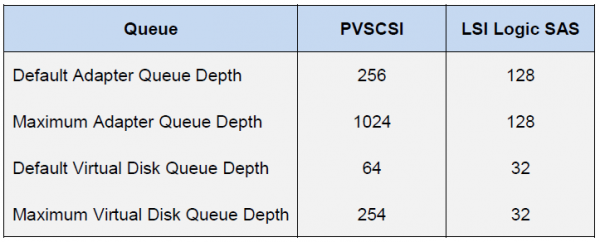
Från ESXi-värdens sida är situationen helt annorlunda. Själva värden tillämpar en praxis av likvärdig tillgång till resurser för alla deltagare. Därför finns det separata IO-köer för gästsoperativsystemet och HBA. Köerna till gästsoperativsystemet kombineras från köerna till den virtuella SCSI-adaptern och den virtuella disken:
Kön till HBA beror på den specifika typen/leverantören:
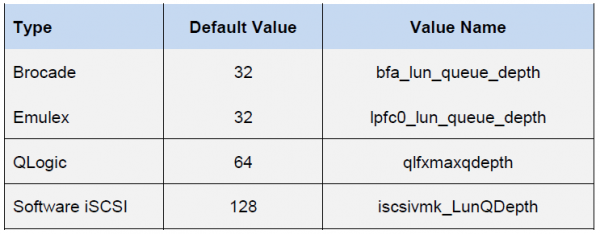
Den slutgiltiga prestandan för den virtuella maskinen kommer att bestämmas av det lägsta värdet av ködjupet (Queue Depth limit) bland värdens komponenter.
Tack vare dessa värden kan vi utvärdera prestandaindikatorer som vi kan få i en viss konfiguration. Till exempel vill vi veta den teoretiska prestandan för en virtuell maskin (utan koppling till blocket) med latens på 0,5 ms. Då blir dess IOPS = (1 000/latens) * Outstanding I/Os (Queue Depth limit)
Exempel
Exempel 1
- FC Emulex HBA Adapter
- En VM på datastore
- VMware Paravirtual SCSI Adapter
Här bestäms Queue Depth limit av Emulex HBA. Därför blir IOPS = (1000/0,5)*32 = 64K
Exempel 2
- VMware iSCSI Software Adapter
- En VM på datastore
- VMware Paravirtual SCSI Adapter
Här bestäms Queue Depth limit av Paravirtual SCSI Adapter. Därför blir IOPS = (1000/0,5)*64 = 128K
Toppmodeller av All Flash-lagringslösningar från AccelStor (till exempel ) kan uppnå en skrivprestanda på 700K IOPS vid en blockstorlek på 4K. Med en sådan blockstorlek är det uppenbart att en enda virtuell maskin inte kan belasta en sådan lagring. För detta krävs 11 (exempel 1) eller 6 (exempel 2) virtuella maskiner.
Som ett resultat av rätt konfiguration av alla beskrivna komponenter i det virtuella datacentret kan mycket imponerande resultat uppnås när det gäller prestanda.
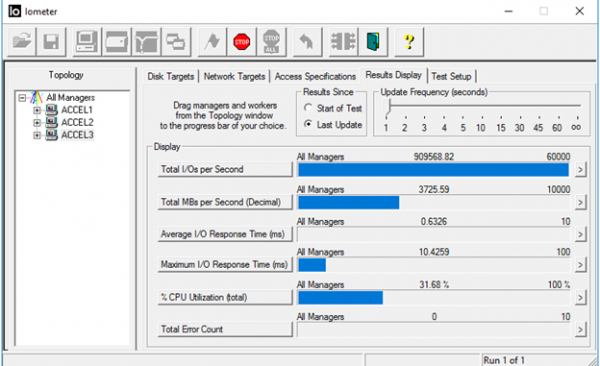
4K Random, 70% Läs/30% Skriv
I verkligheten är världen mycket mer komplex än vad som kan beskrivas med en enkel formel. På en värd finns alltid många virtuella maskiner med olika konfigurationer och krav på IO. Dessutom hanterar värdens processor in- och utdata, vars kapacitet inte är oänlig. Således, för att avslöja den fulla potentialen hos i verkligheten krävs tre värdar. Dessutom påverkar program som körs inuti de virtuella maskinerna resultaten. Därför föreslår vi för exakt sizing All Flash-lagringslösningar inom kundens infrastruktur på aktuella uppgifter.
Källa: habr.com
