

Jag heter Sergey, jag kommer från företaget ITSumma och jag vill berätta för er hur vi närmar oss reservkopiering i Kubernetes. På senare tid har jag arbetat mycket med konsultation kring implementering av olika devops-lösningar för olika team, specifikt inom projekt som använder K8s. På konferensen Uptime day 4, som handlade om reservkopiering inom komplexa arkitekturer, höll jag en presentation om reservkopiering av "kubik", och här är en fri sammanfattning. Jag varnar dock i förväg att detta inte är en direkt handbok, utan snarare en sammanställning av tankar kring ämnet.
I princip är övervakning och reservkopiering två grundläggande verktyg för att öka driftsäkerheten i varje projekt. Men i Kubernetes balanseras allt automatiskt, säger ni, allt skalas automatiskt, och om något händer kommer det automatiskt att återställas... Vid en första ytlig undersökning av ämnet svarade internet på frågan om hur olika tillvägagångssätt för reservkopiering i K8s hanteras med "varför?" Många tror att Kubernetes är en magisk lösning som befriar en från alla infrastrukturella problem och ser till att projektet aldrig faller. Men ... världen är inte vad den ser ut att vara.
Hur närmade vi oss reservkopieringsprocessen tidigare? Vi hade identiska plattformar för hosting - antingen virtuella maskiner eller fysiska servrar, servrar, som vi tillämpade tre grundläggande metoder på:
- kod- och statiksynkronisering
- konfigurationssynkronisering
- databasåtervinning
Och voilà: när som helst kan vi byta över till en reservplattform, alla är glada, vi reser oss och går.
Vad erbjuder vi för att öka den permanenta tillgången till vår Kubernetes-applikation? Det första som den inofficiella dokumentationen nämner är att installera många maskiner, göra många master-noder — antalet måste uppfylla kraven för att uppnå quorum inom klustret, och att varje master-nod ska köra etcd, API, MC, schemaläggare... Och allt verkar fantastiskt: om flera arbetande noder eller master-noder går sönder, kommer vårt kluster att ombalanseras och applikationen kommer att fortsätta att fungera. Det ser återigen ut som magi! Men ofta befinner sig vårt kluster inom en enda datacenter och detta kan orsaka vissa frågor. Vad händer om en grävmaskin gräver upp en kabel, blixten slår ner, eller en universell översvämning inträffar? Allt är förstört, vårt kluster finns inte längre. Hur ska vi hantera redundans med tanke på denna sida av problemet?
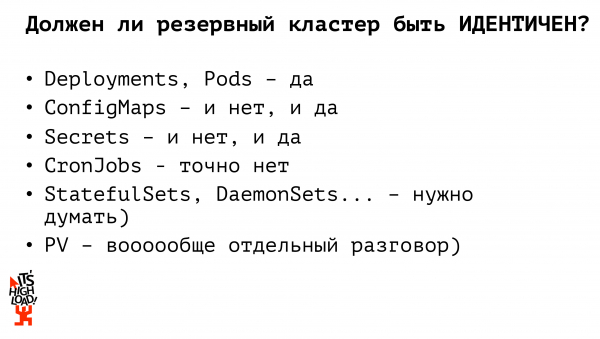
Först och främst måste ni ha ett annat kluster som är i varm reserv, det vill säga ett kluster som ni kan växla över till när som helst. Ur Kubernetes-perspektiv måste infrastrukturen vara helt identisk. Om det finns några icke-standardiserade plugins för filsystemet, anpassade lösningar för ingress, måste de vara helt identiska på era två (eller tre, eller tio, beroende på hur mycket pengar och administratörernas tid ni har) kluster. Det är nödvändigt att tydligt definiera två uppsättningar applikationer (deployment, statefulsets, daemonsets, cronjobs etc.): vilka av dem kan vara aktiva i reservkontot hela tiden och vilka är bättre att inte starta förrän vid omkopplingen.
Så, ska vårt reservkluster vara helt identiskt med vårt produktionskluster? Nej. Tidigare, när vi arbetade med monolitiska projekt och hårdvaruinfrastruktur, höll vi nästan helt identiska miljöer, men inom Kubernetes, anser jag, ska detta inte vara fallet. Låt oss titta på varför.
Till exempel, låt oss börja med de grundläggande enheterna i Kubernetes — deployments — de måste vara identiska. Applikationer måste vara aktiva och kunna hantera trafikflödet när som helst, så att vårt projekt fortsätter att fungera. Om vi pratar om konfigurationsfiler, måste vi avgöra om de bör vara identiska eller inte. Det vill säga, om vi, kloka människor, inte använder några olagliga substanser och inte har databasen i K8s, ska vi i configmaps ha åtkomstinställningar till den produktiva databasen (processen för att säkerhetskopiera den är byggd separat). Därför, för att säkerställa åtkomst till den reservdatabasen, måste vi ha en separat konfigurationsfil (configmap). Precis på samma sätt arbetar vi med secrets: lösenord för databasinloggning, API-nycklar; vid varje tidpunkt kan vi antingen ha den aktiva secret eller den reserv. Således har vi redan två Kubernetes-enheter vars reservversioner inte bör vara identiska med de aktiva. Nästa enhet vi ska fokusera på är cronjob. Cronjob på reserven får under inga omständigheter vara identiska med uppsättningen av cronjob i produktionsklustret! Om vi startar reservklustret och aktiverar alla cronjob — kommer människor till exempel att få två e-postmeddelanden samtidigt istället för ett. Eller så kommer någon datasintegrering med externa källor att ske två gånger, vilket gör att vi börjar må dåligt, gråta, skrika och klaga.
Och hur föreslår folk på internet att organisera en reservkluster? Det näst mest populära svaret efter "varför?" — användning av Kubernetes Federation.
Vad är det här? Det är, låt oss säga, en stor meta-kluster. Om vi föreställer oss Kubernetes-arkitekturen — där vi har en master och flera noder — så har vi ur federationssynpunkt också en master och flera noder, men varje nod är en separat kluster. Det betyder att vi arbetar med samma entiteter, med samma primitiva som med en enskild Kubernetes, men vi hanterar inte våra fysiska maskiner utan hela kluster. Inom federationen sker det en fullständig synkronisering av federerade resurser från föräldrar till avkommor. Till exempel, om vi har lanserat en deployment via federation — så kommer den att deployeras på varje av våra underkluster. Om vi tar en configmap eller en hemlighet och distribuerar den via federation — så kommer den att spridas över alla våra underkluster; samtidigt tillåter federation oss att anpassa våra resurser på barnen. Det vill säga, vi tog en configmap, deployerade den via federation och sedan, om vi behöver justera något på specifika kluster, går vi och justerar på det specifika klustret, och den ändringen kommer inte att synkroniseras någonstans.
Kubernetes Federation är ett relativt nytt verktyg och det stöder inte hela uppsättningen av resurser som K8s själv erbjuder: vid publiceringen av en av de första versionerna av dokumentationen nämndes endast stöd för config maps, deployment under replica set och ingress. Hemligheter stöddes inte, och arbete med volymer stöddes inte heller. Det är en för begränsad uppsättning. Särskilt om vi gillar att experimentera — till exempel genom att använda custom resource definition för att överföra egna resurser till Kubernetes — kan vi inte stoppa dem i federationen. Så det är som… en lösning som är ganska nära sanningen, men som ibland får oss att skjuta oss själva i foten. Å andra sidan tillåter federation att vi flexibelt kan hantera vår replicaset. Till exempel vill vi ha 10 repliker av vår applikation igång, och federation kommer automatiskt att fördela detta antal proportionellt mellan antalet kluster. Och allt detta går att konfigurera! Vi kan ange att på produktionsklustret behöver vi hålla 6 repliker av vår applikation, medan på reservklustret, för att spara resurser, eller för egna nöjen — bara 4 repliker av vår applikation. Det är också ganska praktiskt. Men med federation måste vi använda någon form av nya lösningar, deploya saker under loppet och få oss själva att tänka lite mer…
Finns det ett enklare sätt att närma sig kubernetes reservering? Vilka verktyg har vi överhuvudtaget?
För det första har vi alltid något slags ci/cd-system, det vill säga vi går inte manuellt in och skriver create/apply på servrarna. Systemet genererar yaml-filer för våra containrar.
För det andra har vi flera kluster, vi har antingen ett eller flera (om vi är kloka) registry som vi också har tagit och reserverat. Och det finns ett fantastiskt verktyg, kubectl, som kan arbeta med flera kluster samtidigt.
Så här är det: enligt min åsikt är den enklaste och mest korrekta lösningen för att bygga en backupkluster en primitiv parallell distribution. Det finns någon pipeline i ci/cd-systemet; först bygger vi våra containrar, testar och distribuerar applikationerna via kubectl till flera oberoende kluster. Vi kan göra samtidigt distributioner på flera kluster. Därmed hanterar vi även leveransen av konfigurationer i detta steg. Vi kan i förväg definiera en uppsättning konfigurationer för vårt produktionskluster, en uppsättning konfigurationer för backupklustret och på ci/cd-systemnivå distribuera produktionsmiljön till produktionsklustret, backupmiljön till backupklustret. Jämfört med federationen behöver vi inte gå till varje underkluster efter att ha definierat den federativa resursen och ändra något. Vi har gjort detta i förväg. Vad duktiga vi är.
Men… det finns… jag har skrivit att det finns "alla problemens rot", men det finns faktiskt två av dem. För det första, filsystemet. Det finns något PV, eller så använder vi extern lagring. Om vi lagrar filer inom klustret måste vi agera enligt de gamla metoderna, som härstammar från hårdvaruinfrastrukturer: till exempel synkronisera med lsync. Antingen det eller någon annan metod som du personligen föredrar. Vi distribuerar allt till andra maskiner och fortsätter.
För det andra, och faktiskt ett mer kritiskt bekymmer — databasen. Om vi är kloka människor och inte har databasen i Kubernetes, så är processen för datareservering enligt den gamla modellen — master-slave-replikering, sedan omställning, vi kommer att hämta replikatet och leva gott. Men om vi håller vår databas inom klustret finns det faktiskt många färdiga lösningar för att organisera samma master-slave-replikation, många lösningar för att konfigurera en databas inom Kubernetes.
Om databassäkring har det redan hållits miljarder presentationer, skrivits miljarder artiklar, det finns inget nytt här, för att vara ärlig. Sammanfattningsvis, följ dina drömmar, lev som du vill, uppfinna några komplexa lösningar för dig själv, men tänk definitivt på hur du kommer att säkra allt detta.
Och nu om hur vi i princip kommer att genomföra processen för att växla till en reservanläggning i händelse av en brand. För det första distribuerar vi stateless-applikationer parallellt. De påverkar inte affärslogiken för våra applikationer, vårt projekt. Vi kan hela tiden ha två uppsättningar av körande applikationer, och de kan börja ta emot trafik. Det är mycket viktigt i processen att växla till reservanläggningen att alltid kolla — behöver vi omdefiniera konfigurationerna? Till exempel har vi en produktionskluster av Kubernetes, en reservkluster av Kubernetes, en extern masterdatabas och en reserv masterdatabas. Vi har fyra alternativ för hur dessa applikationer i produktion kan börja interagera med varandra. Vi kan växla databasen, vilket innebär att vi behöver styra om trafiken i produktionsklustret till den nya databasen, eller så kan klustret fallera — och vi har flyttat till reserv men fortsätter att arbeta med produktionsdatabasen. Den tredje varianten är när vi har haft problem med det ena och det andra, och vi växlar båda applikationerna, omdefinierar vår konfiguration så att de nya applikationerna redan arbetar med den nya databasen.
Och vilka slutsatser kan vi dra av allt detta?
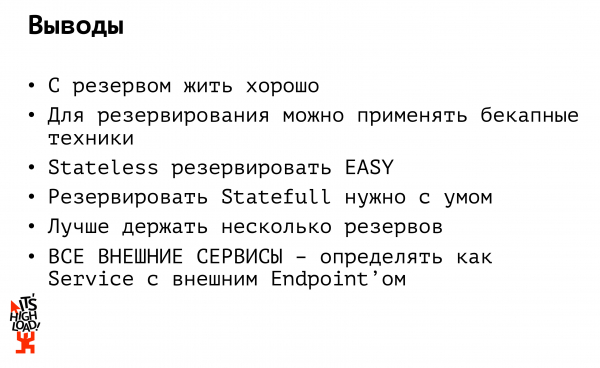
Första slutsats: Det är bra att ha en reserv. Men det är dyrt. Men i idealfallet bör man inte bara ha en reserv. Man bör i själva verket ha flera reserver. För det första bör reservet vara minst inte i en och samma datacenter, och för det andra, minst hos en annan hostingleverantör. Det har ofta hänt — och det har jag faktiskt varit med om. Tyvärr kan jag inte nämna några projekt, särskilt när det inträffade en brand i datacentret... Jag tänkte: vi växlar till reserv! Och de reservservrarna stod i samma rack...
Eller tänk dig att Amazon blir förbjudet i Ryssland (och det har hänt). Och allt: vad hjälper det att vår reserv ligger hos en annan Amazon? Den är också otillgänglig. Så jag upprepar: vi bör hålla reserv, minst i ett annat datacenter, och helst — hos en annan hostingleverantör.
Andra output: Om du har en app i Kubernetes som kommunicerar med externa källor (det kan vara både en databas eller en extern API), definiera den som en tjänst med en extern Endpoint, så att ni inte behöver deploya 15 av era appar som ansluter till samma databas vid byte. Definiera databasen som en separat tjänst, anslut till den som om den vore inom klustret: om er databas krashar kan ni ändra ip på ett ställe och fortsätta att leva lyckligt.
Och till sist: Jag älskar "kubik", precis som jag älskar att experimentera med det. Jag gillar också att dela resultaten av dessa experiment och min personliga erfarenhet. Därför har jag spelat in en serie webbinarier om K8s, välkommen till för mer information.
Källa: habr.com
