

Idéer och möten om vilka andra processer som kan automatiseras uppstår i företag av olika storlekar varje dag. Men förutom att mycket tid kan gå åt till att skapa en modell, måste man också investera tid i att utvärdera den och kontrollera att den erhållna resultaten inte är slumpmässiga. Efter implementeringen måste varje modell övervakas och kontrolleras periodiskt.
Och detta är alla steg som måste genomgås i vilket företag som helst, oavsett dess storlek. När vi talar om storleken och legacy-systemen hos Sberbank ökar antalet finjusteringar mångfalt. I slutet av 2019 användes redan över 2000 modeller i Sber. Det räcker inte med att bara utveckla en modell; det är nödvändigt att integrera med industriella system, utveckla datavitriner för att bygga modeller, och säkerställa kontroll över modellens prestanda i klustret.
Vårt team utvecklar plattformen Sber.DS. Den gör det möjligt att lösa problem med maskininlärning, påskyndar processen för hypotesprövning, förenklar i allmänhet utvecklings- och valideringsprocessen för modeller samt kontrollerar resultatet av modellens arbete i PROB.
För att inte lura era förväntningar vill jag redan nu säga att detta inlägg är en introduktion, och nedan berättas först om vad som egentligen finns under huven av plattformen Sber.DS. Berättelsen om modellens livscykel från skapelse till implementering kommer vi att berätta separat.
Sber.DS består av flera komponenter, där nyckelelementen är bibliotek, utvecklingssystem och system för modellgenomförande.
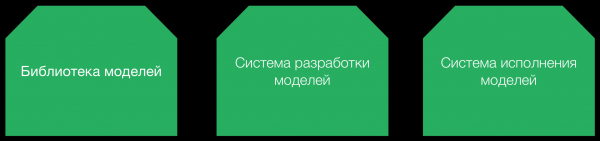
Biblioteket kontrollerar livscykeln för modellen från idén till utveckling, implementering i PROB, övervakning och avveckling. Många av bibliotekets funktioner dikteras av regulatorernas regler, såsom rapportering och lagring av utbildnings- och valideringsdata. I praktiken är detta ett register över alla våra modeller.
Utvecklingssystemet är avsett för visuell utveckling av modeller och valideringsmetoder. De utvecklade modellerna genomgår en initial validering och levereras till körsystemet för att utföra sina affärsfunktioner. I körsystemet kan modellen också ställas in på en skärm för regelbunden körning av valideringsmetoder för att övervaka dess funktion.
Systemet har flera typer av noder. Vissa är avsedda för att koppla upp mot olika datakällor, andra för att transformera rådata och berika dem (tagga). Det finns många noder för att bygga olika modeller och noder för deras validering. Utvecklaren kan ladda ner data från valfria källor, omformatera, filtrera och visualisera mellanliggande data, samt dela upp dem i delar.
Plattformen innehåller även färdiga moduler som kan dras och släppas på projektområdet. Alla åtgärder utförs med hjälp av ett visualiserat gränssnitt. Det är faktiskt möjligt att lösa uppgiften utan en enda rad kod.
Om de inbyggda funktionerna inte räcker till, erbjuder systemet möjlighet att snabbt skapa sina egna moduler. Vi har skapat ett läge för integrerad utveckling baserat på för dem som skapar nya moduler "från grunden".
Sber.DS-arkitekturen är byggd på mikrotjänster. Det finns många åsikter om vad mikrotjänster är. Vissa anser att det är tillräckligt att dela upp monolitisk kod i delar, men de arbetar fortfarande med samma databas. Vår mikrotjänst måste kommunicera med en annan mikrotjänst endast via REST API. Ingen direkt åtkomst till databasen är tillåten.
Vi strävar efter att se till att tjänsterna inte blir för stora och klumpiga: en instans bör inte konsumera mer än 4-8 gigabyte RAM och måste möjliggöra horisontell skalning av begärningar genom att starta nya instanser. Varje tjänst kommunicerar med andra endast via REST API (). Teamet som ansvarar för tjänsten är skyldig att behålla bakåtkompatibiliteten för API:et till den senaste klienten som använder det.
Applikationskärnan är skriven i Java med hjälp av Spring Framework. Lösningen designades ursprungligen för snabb distribatering i molninfrastruktur, därför är applikationen byggd med hjälp av ett containeriseringssystem (). Plattformen utvecklas ständigt, både när det gäller att öka affärsfunktionaliteten (nya anslutningar, AutoML läggs till) och när det gäller teknisk effektivitet.
En av våra plattformsunika funktioner är att vi kan köra kod utvecklad i det visuella gränssnittet på vilket system som helst för Sberbanks modellkörning. Just nu finns det två: en på Hadoop och en annan på OpenShift (Docker). Vi stannar inte här utan skapar integrationsmoduler för att köra kod på vilken infrastruktur som helst, inklusive on-premise och i molnet. När det gäller möjligheterna för effektiv integrering i Sberbanks ekosystem planerar vi också att stödja arbete med befintliga körmiljöer. I framtiden kan lösningen flexibelt integreras "rakt ur lådan" i vilket landskap som helst av vilken organisation som helst.
De som någon gång har försökt stödja en lösning som kör Python på Hadoop i PROG vet att det handlar om mer än att bara förbereda och leverera användarmiljön för Python till varje datanod. En stor mängd C/C++-bibliotek för maskininlärning som använder Python-moduler ger dig ingen ro. Man måste också komma ihåg att uppdatera paketen när nya bibliotek eller servrar tillkommer och behålla bakåtkompatibilitet med redan implementerad kod för modeller.
Det finns flera metoder för hur man gör detta. Till exempel kan man förbereda några vanliga bibliotek och implementera dem i PROG. I Hadoop-distributionen från Cloudera används vanligtvis . Dessutom finns det nu möjlighet att köra -containrar i Hadoop. I vissa enkla fall kan man leverera koden tillsammans med paketet .
Banken är mycket seriös när det gäller säkerheten för att köra tredjepartskod, därför utnyttjar vi i största möjliga utsträckning de nya möjligheterna i Linux-kärnan, där processen körs i en isolerad miljö , kan begränsa, till exempel, åtkomst till nätverket och lokala diskar, vilket avsevärt minskar möjligheterna för skadlig kod. Dataområdena för varje avdelning är skyddade och endast tillgängliga för ägarna av dessa data. Plattformen garanterar att data från ett område kan nå ett annat område, endast genom datapubliceringsprocessen med kontroll vid alla steg från åtkomst till källor till landning av data i målvitrinen.
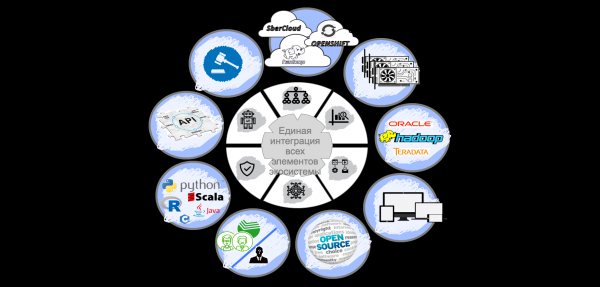
I år planerar vi att avsluta MVP-lanseringen av modeller skrivna i Python/R/Java på Hadoop. Vi har satt oss en ambitiös uppgift att lära oss att köra vilken användarmiljö som helst på Hadoop, för att inte begränsa användarna av vår plattform.
Dessutom visar det sig att många data scientist-specialister är utmärkta på matematik och statistik, skapar fantastiska modeller, men inte är så kunniga i transformationer av stora data, och de behöver hjälp av våra dataingenjörer för att förbereda träningsdataset. Vi har beslutat att hjälpa våra kollegor och skapa användarvänliga moduler för standardtransformation och beredning av funktioner för modeller på Spark-motorn. Detta gör att mer tid kan ägnas åt utvecklingen av modeller och att man inte behöver vänta på att dataingenjörerna ska förbereda en ny dataset.
Vi har människor med kunskaper inom olika områden: Linux och DevOps, Hadoop och Spark, Java och Spring, Scala och Akka, OpenShift och Kubernetes. Nästa gång kommer vi att berätta om modellbiblioteket, hur en modell går igenom livscykeln inom företaget och hur validering och implementering går till.
Källa: habr.com
