

Obs. övers.: författare till denna artikel (Luc Perkins) – utvecklaradvokat inom organisationen CNCF, som är hem för sådana Open Source-projekt som Linkerd, SMI (Service Mesh Interface) och Kuma (för övrigt, har du någon gång funderat på varför Istio inte finns med på den här listan?..). Återigen försöker han ge DevOps-gemenskapen en bättre förståelse för den trendiga hypen som kallas “service mesh”, genom att redovisa 16 karaktäristiska möjligheter som dessa lösningar erbjuder.
I dag – en av de hetaste ämnena inom mjukvaruteknik (och med rätta!). Jag anser att denna teknik är oerhört lovande och drömmer om att få bevittna dess omfattande spridning (naturligtvis när det är meningsfullt). Men den omges fortfarande av en aura av mystik för de flesta människor. Även de som är väl förtrogna med den har ofta svårt att formulera dess fördelar och vad den egentligen innebär (inklusive er ödmjuka tjänare). I artikeln kommer jag att försöka rätta till detta genom att lista olika användningsscenarier för “service-mesh”*.
* Obs. övers.: här och härefter i artikeln används just denna översättning (“service-mesh”) för den fortfarande nya termen service mesh.
Men först vill jag göra några kommentarer:
- Jag har aldrig arbetat med service-mesh och har inte använt dem utanför projekt initierade för egen utbildning. Å andra sidan har jag skrivit mycket dokumentation för den interna service-meshen i Twitter 2015 (då kallades den inte ens “service-mesh”) och deltagit i utvecklingen av webbplatsen och dokumentationen för , så det betyder något.
- Min lista är exempelvis och ofullständig. Det är helt möjligt att det finns användningsscenarier jag inte känner till, och med tiden kommer det säkert att dyka upp nya alternativ i takt med att teknologin utvecklas och dess popularitet växer.
- Samtidigt stöder långt ifrån varje befintlig implementation av service mesh alla nämnda användningsfall. Därför bör mina uttalanden som “service mesh kan…” läsas som “specifika, och kanske alla populära implementationer av service mesh kan…”.
- Ordningen på exemplen har ingen betydelse.
Kort lista:
- tjänstupptäckter;
- kryptering;
- autentisering och auktorisering;
- lastbalansering;
- circuit breaking;
- autoskalning;
- kanariedistributioner;
- blå-gröna distributioner;
- hälsokontroller;
- load shedding;
- trafikspegling;
- isolering;
- begärsfrekvensbegränsning, försök på nytt och tidsgränser;
- telemetri;
- granskning;
- visualisering.
1. Tjänstupptäckte
TL;DR: Anslut till andra tjänster i nätverket med hjälp av enkla namn.
Tjänster måste kunna automatiskt "hitta" varandra med hjälpsamma namn – till exempel, service.api.production, pets/staging eller cassandra. Molnmiljöer kännetecknas av deras elasticitet och bakom ett namn kan flera tjänstexemplar dölja sig. Det är uppenbart att det i en sådan situation är fysiskt omöjligt att hårdkoda alla IP-adresser.
Dessutom, när en tjänst hittar en annan, bör den kunna skicka förfrågningar till den tjänsten utan att oroa sig för att de hamnar hos en inaktiv instans. Med andra ord, service mesh måste övervaka tillgängligheten av alla tjänstexemplar och hålla en lista över värdar så aktuell som möjligt.
Varje service mesh implementerar sin tjänstupptäcktsmekanism på sitt eget sätt. Just nu är den mest utbredda metoden att delegera till externa processer som DNS Kubernetes. Tidigare i Twitter använde vi för dessa syften namnsystemet . Dessutom möjliggör teknologin service mesh framväxten av anpassade namngivningsmekanismer (även om jag ännu inte har sett någon implementation av SM med sådan funktionalitet).
2. Kryptering
TL;DR: Eliminera okrypterad trafik mellan tjänster och låt denna process vara automatiserad och skalbar.
Det är skönt att veta att illvilliga aktörer inte kan tränga in i ditt interna nätverk. Brandväggar hanterar detta bra. Men vad händer om en hackare ändå lyckas ta sig in? Kan de göra vad som helst med trafiken mellan tjänster? Låt oss hoppas att det inte händer. För att förhindra ett sådant scenario bör ett nätverk med noll förtroende (zero-trust) implementeras, där all trafik mellan tjänster är krypterad. De flesta moderna tjänstenätverk uppnår detta genom ömsesidig (mutual TLS, mTLS). I vissa fall fungerar mTLS över hela moln och kluster (jag tror att interplanetär kommunikation en dag kommer att fungera på liknande sätt).
Självklart är mTLS service mesh inte obligatorisk. Varje tjänst kan själva ta hand om sin TLS, men det betyder att man måste hitta ett sätt att generera certifikat, distribuera dem till tjänstens värdar, inkludera kod i applikationen som laddar dessa certifikat från filer. Ja, glöm inte att uppdatera dessa certifikat med jämna mellanrum. Tjänstenätverk automatiserar mTLS med hjälp av system som , som i sin tur automatiserar processen för utfärdande och rotation av certifikat.
3. Autentisering och auktorisering
TL;DR: Bestäm vem som är initiativtagaren av begäran, och definiera vad de har tillåtelse att göra innan begäran når tjänsten.
Tjänster vill ofta veta vem som utför begäran (autentisering), och med hjälp av denna information bestämmer de vad vad den aktuella subjekten har tillåtelse att göra (auktorisering). I det här fallet kan pronomenet "vem" dölja:
- Andra tjänster. Detta kallas "peer-autentisering". Till exempel, en tjänstvill få tillgång till tjänsten
web. Tjänstenätverk löser vanligtvis sådana problem med hjälp av mTLS: certifikat fungerar här som nödvändig identifiering.dbMänniskobrukare. Detta kallas "begäran-autentisering". - Till exempel, användare haxor69vill köpa en ny lampa. Tjänstenätverk erbjuder olika mekanismer, till exempel,
JSON Web TokensMånga av oss har gjort detta i applikationskoden. En begäran kommer in, vi kollar tabellen .och så vidare. I fallet med service mesh sker detta ännu innan begäran når tjänsten.
usersEfter att vi har fastställt vem som har skickat begäran, måste vi avgöra vad den aktuella subjekten har tillåtelse att göra. Vissa service mesh:er låter dig definiera grundläggande policyer (för vem som kan och vad de kan göra) i form av YAML-filer eller via kommandoraden, medan andra erbjuder integration med ramverk sompermissions. Det slutliga målet är att säkerställa att dina tjänster accepterar alla begärningar och vågar anta att de kommer från en pålitlig källa.
Åtgärden är tillåten. 4. Lastbalansering och TL;DR: Fördela belastningen mellan tjänsteexemplar enligt ett visst mönster.
4. Балансировка нагрузки
TL;DR: Распределяйте нагрузку по экземплярам сервиса по определенному шаблону.
En "tjänst" i en tjänste-sektor består ofta av många identiska instanser. Till exempel består tjänsten idag av 5 kopior, och imorgon kan antalet öka till 11. Förfrågningar som riktas mot cache , bör fördelas enligt ett specifikt mål. Till exempel, minimera fördröjningen eller maximera sannolikheten att koppla upp sig mot en fungerande instans. Vanligtvis används en rund-robin-algoritm, men det finns många andra - till exempel metoden för viktade cacheförfrågningar (man kan välja föredragna mål), ring (ring) hashning (användning av konsekvent hashning för upstream-värdar) eller metoden för minst antal förfrågningar (man föredrar den instans som har det minsta antalet förfrågningar). Klassiska lastbalanserare har även andra funktioner, såsom HTTP-caching och DDoS-skydd, men de är inte så aktuella för öst-väst trafik (dvs. för trafik som rör sig inom datacentret - red. anm.) (typisk användning för service mesh). Självklart är det inte nödvändigt att använda service mesh för lastbalansering, men det möjliggör att ange och kontrollera lastbalanseringspolicyer för varje tjänst från ett centraliserat styrskikt, vilket eliminerar behovet av att köra och konfigurera separata lastbalanserare i nätverksstacken. 5. Kretsavbrott (circuit breaking)
TL;DR: Stoppa trafiken till den problematiska tjänsten och kontrollera skadan vid värsta scenarier.
Om tjänsten av någon anledning inte klarar av trafiken, erbjuder service mesh flera alternativ för att lösa detta problem (andra kommer att diskuteras i de relevanta avsnitten). Kretsavbrott är det hårdaste alternativet för att koppla bort tjänsten från trafiken. Men det är inte meningsfullt i sig självt - en reservplan behövs. Det kan finnas tryckmotstånd
backpressure
på tjänster som gör förfrågningar (glöm bara inte att konfigurera din service mesh för detta!), eller till exempel att måla status-sidan röd och omdirigera användarna till en alternativ sida med "fallande val" ("Twitter är nere"). () ett avbrott kommer att ske och
Сервисные сетки позволяют не только определять, когда последует отключение и vad Detta följs av. I detta fall kan "när" inkludera vilken kombination som helst av angivna parametrar: det totala antalet förfrågningar under en viss period, antal parallella anslutningar, väntande förfrågningar, aktiva omförsök, etc.
Du skulle knappast vilja missbruka circuit breaking, men det är skönt att veta att det finns en reservplan i nödfall.
6. Automatisk skalning
TL;DR: Öka eller minska antalet instanser av tjänsten baserat på angivna kriterier.
Service-meshar är inte planeringsverktyg, så de gör inte skalning själva. Men de kan tillhandahålla information som gör att planeringsverktyg kan fatta beslut. Eftersom service-meshar har tillgång till all trafik mellan tjänster, har de omfattande information om vad som händer: vilka tjänster som har problem, vilka som är mycket underutnyttjade (de tilldelade resurserna slösas bort) osv. Till exempel skalas tjänster i Kubernetes ut beroende på hur mycket CPU och minne pods använder.
(se vår presentation " , men om du väljer att skala baserat på någon annan parameter (i vårt fall relaterad till trafik) behövs en speciell metric. Guiden" — anm. övers.)som den här , men själva processen är ganska komplicerad. Vi önskar att service-mesharna kunde förenkla det genom att bara tillåta att ange villkor som "öka antalet instanser av tjänsten , och , om antalet förfrågningar som väntar på att bli utförda överstiger en tröskel under en minut." auth7. Canarideployeringar
TL;DR: Testa nya funktioner eller versioner av tjänsten på en delmängd av användarna.
TL;DR: Испытывайте новые функции или версии сервиса на подмножестве пользователей.
Anta att du utvecklar en SaaS-produkt och planerar att lansera en ny, cool version. Du har testat den i staging, och den har fungerat utmärkt. Men ändå finns det vissa oroande tankar kring hur den kommer att bete sig i verkliga förhållanden. Med andra ord, det behövs en test av den nya versionen med riktiga uppgifter, utan att riskera användarnas förtroende. Canary-distributioner är utmärkta för detta. De gör det möjligt att visa den nya funktionen för en viss delmängd av användarna. Denna delmängd kan bestå av de mest lojala användarna, eller de som använder den gratis versionen av produkten, eller användare som har uttryckt önskan att vara
Service mesh:ar möjliggör detta genom att ange kriterier som definierar vem som ser vilken version av applikationen och därefter styra trafiken på lämpligt sätt. För tjänsterna förändras ingenting. Version 1.0 av tjänsten antar att alla förfrågningar kommer från användare som ska se just den versionen, medan version 1.1 gör samma antagande för sina egna användare. Under tiden kan du justera andelen trafik mellan den gamla och den nya versionen, genom att omdirigera en växande andel av användarna till den nya, om den fungerar stabilt och dina
8. Blå-gröna distributioner
TL;DR: Lansera den nya coola funktionen, men var beredd att snabbt rulla tillbaka allt.
Meningen är att lansera den nya "blå" tjänsten parallellt med den gamla, "gröna". Om allt går bra och den nya tjänsten presterar bra kan den gamla gradvis stängas av. (Tyvärr kommer den nya "blå" tjänsten en dag att uppleva samma öde som "gröna" och försvinna...) Blå-gröna distributioner skiljer sig från canary-distributioner genom att den nya funktionen omfattar alla användare (och inte en del); poängen här är att ha en "backup-hamn" redo i fall något går fel.
Service mesh erbjuder ett mycket bekvämt sätt att testa den "blå" tjänsten och omedelbart växla till den fungerande "gröna" om problem uppstår. För att inte tala om att de samtidigt ger massor av information (se punkt "Telemetri" nedan) om hur den "blå" tjänsten fungerar, vilket hjälper till att förstå om den är redo för fullständig drift.
Obs. övers.: Mer information om olika distributionsstrategier i Kubernetes (inklusive nämnda canary, blue/green och andra) kan läsas i .
9. Hälsokontroll
TL;DR: Håll koll på vilka tjänsteinstanser som är i drift och agera på de som inte längre fungerar.
Hälsokontroll (health check) hjälper till att avgöra om tjänsteinstanserna är redo att ta emot och behandla trafik. Till exempel kan för HTTP-tjänster hälsokontrollen se ut som en GET-förfrågan till en endpoint. /health. Svar 200 OK betyder att instansen är frisk, medan varje annat svar betyder att den inte är redo att ta emot trafik. Service mesh gör det möjligt att specificera både hur driftsförmågan kommer att kontrolleras och hur ofta denna kontroll kommer att utföras. Denna information kan sedan användas för andra syften - till exempel för belastningsbalansering och circuit breaking.
Således är hälsokontrollen inte ett självständigt användningsfall, utan används vanligtvis för att uppnå andra mål. Beroende på resultaten av hälsokontroller kan det också krävas externa åtgärder (i förhållande till andra syften för tjänstenätverk), såsom att uppdatera statusen, skapa en issue på GitHub eller fylla i en ticket i JIRA. Och service mesh erbjuder en bekväm mekanism för automatisering av allt detta.
10. Belastningshantering (load shedding)
TL;DR: Omdirigera trafik som svar på en tillfällig ökning i användningen.
Om en tjänst blir överbelastad av trafik kan du tillfälligt omdirigera en del av denna trafik till en annan plats (det vill säga "släppa", "ösa" (shed) den dit). Till exempel, till en reservtjänst eller ett datacenter, eller till en permanent. ämnet. Resultatet blir att tjänsten fortsätter att bearbeta en del av förfrågningarna istället för att krascha och sluta bearbeta allt helt. Lastavlastning är att föredra framför att bryta kedjan, men det är fortfarande oönskat att missbruka det. Det förhindrar kaskadfel som resulterar i att downstream-tjänster går ner.
11. Parallellisering/speglings av trafik.
TL;DR: Skicka en förfrågan till flera mål samtidigt.
Ibland uppkommer behovet av att skicka en förfrågan (eller ett urval av förfrågningar) till flera tjänster samtidigt. Ett typiskt exempel är att skicka en del av produktionstrafiken till en staging-tjänst. Den primära webbservern i produktionen skickar en förfrågan till den underliggande tjänsten products.production och endast till den. Och service mesh kopierar intelligens detta begäran och skickar det till products.staging, vilket webbservern inte ens misstänker.
Ett annat relaterat användningsscenario för service mesh som kan implementeras ovanpå parallellisering av trafik är . Det innebär att skicka samma förfrågningar till olika versioner av tjänsten och kontrollera om alla versioner beter sig likadant. Jag har ännu inte sett en implementation av service mesh med ett integrerat system för regressionstestning som , men själva idén verkar lovande.
12. Isolering
TL;DR: Dela upp din service mesh i mininätverk.
Också känd som segmentering, isolering är konsten att dela upp service mesh i logiskt avskilda segment som inget vet om varandra. Isolering liknar att skapa virtuella privata nätverk. Den grundläggande skillnaden är dock att du fortfarande kan dra nytta av alla fördelar med service mesh (som tjänstupptäckning), men med ökad säkerhet. Till exempel, om en angripare lyckas tränga sig in i en tjänst i ett av nätverken, kan de inte se vilka tjänster som körs i andra nätverk eller fånga deras trafik.
Dessutom kan fördelarna vara organisatoriska. Du kanske vill dela upp tjänster i nätverk beroende på företagets struktur och befriande utvecklare från den kognitiva belastningen som orsakas av att behöva hålla hela service mesh i minnet.
13. Begränsning av förfrågningar, återförsök och tidsgränser.
TL;DR: Du behöver inte längre inkludera brådskande förfrågningshantering i kodbasen.
Alla dessa aspekter kan ses som separata användningsfall, men jag valde att sammanfoga dem på grund av en gemensam egenskap: de hanterar livscykeln för förfrågningar, något som vanligtvis utförs av applikationsbibliotek. Om du utvecklar en webbserver i Ruby on Rails (inte integrerad med service mesh) som gör förfrågningar till backend-tjänster genom , måste applikationen själv avgöra vad den ska göra om N förfrågningar misslyckas. Det blir också nödvändigt att ta reda på hur mycket trafik dessa tjänster kan hantera och 'hårdkoda' dessa parametrar med hjälp av ett särskilt bibliotek. Dessutom måste applikationen avgöra när det är dags att ge upp och låta förfrågan gå ut (på timeout). För att ändra någon av ovanstående parametrar måste webbservern stängas av, konfigureras om och startas igen.
Överföring av dessa uppgifter till service mesh innebär inte bara att utvecklarna av tjänsterna inte behöver tänka på dem, utan också att de kan betraktas mer globalt. Om en komplex kedja av tjänster används, säg A → B → C → D → E, måste hela livscykeln för förfrågan beaktas. Om det är nödvändigt att förlänga timeout-värden i tjänst C, är det logiskt att göra detta en gång istället för bit för bit: uppdatera tjänstkoden och vänta på att pull-begäran ska godkännas och CI-systemet ska distribuera den uppdaterade tjänsten.
14. Telemetri
TL;DR: Samla all nödvändig (och mindre nödvändig) information från tjänsterna.
Telemetri är en allmän term som omfattar mätvärden, distribuerad spårning och loggar. Service mesh erbjuder mekanismer för att samla in och bearbeta alla tre typer av data. Här blir det lite otydligt eftersom antalet möjliga alternativ är för stort. För att samla in mätvärden finns det och andra verktyg, för att samla loggar kan man använda , , och andra. (till exempel ClickHouse med vår för K8s – övers. anm.), för distribuerad spårning finns det och så vidare. Varje service mesh kan stödja vissa verktyg och inte andra. Det blir intressant att se om projektet kan bidra till viss konvergens.
I det här fallet är fördelen med service mesh-teknologin att sidecar-behållare i princip kan samla all ovan nämnd information från sina tjänster. Med andra ord får du en enhetlig system för insamling av telemetry, och service mesh kan hantera all denna information på olika sätt. Till exempel:
- följa loggar från en viss tjänst i CLI;
- övervaka mängden begärningar från service mesh:s övervakningspanel;
- samla distribuerade spårningar och omdirigera dem till ett system som Jaeger.
Observera, subjektiv åsikt: Generellt sett är telemetry ett område där ett starkt ingripande från service mesh är oönskat. Att samla grundinformation och övervaka vissa "guldmetrics" som procentandel framgångsrika förfrågningar och latens är okej, men låt oss hoppas att vi inte blir vittnen till uppkomsten av dessa så kallade Frankenstein-stackar som försöker ersätta specialiserade system, vissa av vilka redan har visat sig vara utmärkta och väl studerade.
15. Revision
TL;DR: Den som glömmer historielektionerna är dömd att upprepa dem.
Revision är konsten att observera viktiga händelser i systemet. I fallet med service mesh kan detta innebära att spåra vem som gjorde förfrågningar till specifika endpoints hos vissa tjänster eller hur många gånger en viss händelse relaterad till säkerhet inträffat under den senaste månaden.
Det är uppenbart att revision är mycket nära kopplad till telemetry. Skillnaden är att telemetry vanligtvis förknippas med saker som prestanda och teknisk smidighet, medan revision kan ha att göra med juridiska och andra frågor som ligger utanför den strikt tekniska sfären (till exempel efterlevnad av GDPR — EU:s allmänna dataskyddsförordning).
16. Visualisering
TL;DR: Länge leva React.js — en outtömlig källa till märkliga gränssnitt.
Kanske finns det en mer passande term, men jag känner inte till den. Jag menar bara en grafisk representation av service mesh eller några av dess komponenter. Dessa visualiseringar kan inkludera indikatorer som genomsnittliga latenser, information om konfigurationen av sidecar-behållare, hälsokontroller och aviseringar.
Att ar arbeta i en tjänsteorienterad miljö innebär en mycket högre kognitiv belastning jämfört med Hans Majestäts Monolit. Därför bör kognitiv press sänkas till varje pris. Ett banalt grafiskt gränssnitt för service mesh med möjlighet att klicka på en knapp och få önskat resultat kan vara avgörande för teknologins popularitet.
Inkluderades inte i listan
Ursprungligen avsåg jag att inkludera några fler användningsscenarier i listan, men jag bestämde mig för att inte göra det. Här är de tillsammans med orsakerna till mitt beslut:
- Multi-datacenter. I min uppfattning är detta inte så mycket ett användningsscenario, utan snarare ett smalt och specifikt tillämpningsområde för tjänstenät eller en uppsättning funktioner som serviceupptäckten.
- Ingress och egress. Det är ett relaterat område, men jag begränsade mig (möjligen artificiellt) till användningsscenariot "east-west trafik". Ingress och egress förtjänar en egen artikel.
Slutsats
Detta är allt för nu! Återigen, denna lista är ganska preliminär och troligtvis ofullständig. Om du tycker att jag har missat något, eller gjort ett misstag, kontakta mig på Twitter (). Vänligen håll dig till goda uppföranderegler.
P.S. från översättaren
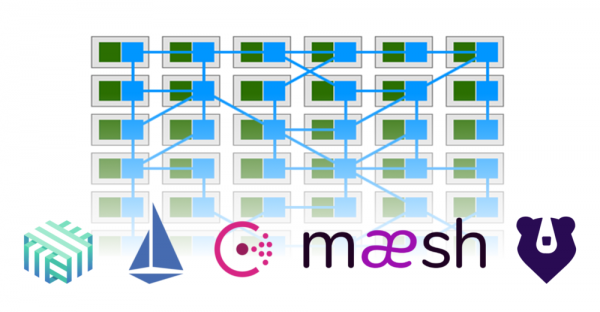
Som grund för artikelns huvudillustration har jag använt en bild från artikeln "" (författare — Gregory MacKinnon). Den visar hur en del av funktionaliteten från applikationerna (grön färg) övergick till service mesh, vilket möjliggör relationer mellan dem (blå färg).
Läs även i vår blogg:
- «»;
- «»;
- «».
Källa: habr.com
