

Serverless handlar inte om bristen på fysiska servrar. Det är inte en "mördare" av containrar eller en tillfällig trend. Det är ett nytt tillvägagångssätt för att bygga system i molnet. I dagens artikel kommer vi att beröra arkitekturen för Serverless-appar, se vilken roll leverantören av Serverless-tjänster spelar och open-source-projekt. I slutet kommer vi att diskutera frågor kring användning av Serverless.
Jag vill skriva serversidan av en applikation (även en webbshop). Det kan vara en chatt, en tjänst för publicering av innehåll eller en lastbalanserare. I vilket fall som helst blir det en hel del huvudvärk: jag måste förbereda infrastrukturen, definiera applikationens beroenden, fundera över värdoperativsystemet. Sen behöver jag uppdatera små komponenter som inte påverkar resten av monoliten. Och vi får inte glömma skalning under belastning.
Och vad om vi använder ephemeral containers där de nödvändiga beroendena redan är förinstallerade, och där själva containrarna är isolerade från varandra och från värdoperativsystemet? Vi delar monoliten i mikrotjänster som kan uppdateras och skalas oberoende av varandra. Genom att placera koden i en sådan container kan jag köra den på vilken infrastruktur som helst. Mycket bättre.
Men om man inte vill konfigurera containrar? Om man inte vill tänka på att skala applikationen. Om man inte vill betala för stillastående körda containrar när belastningen på tjänsten är minimal. Man vill bara skriva kod. Fokusera på affärslogik och få produkter på marknaden med ljusets hastighet.
Dessa tankar ledde mig till serverlösa beräkningar. Serverless i det här fallet betyder inte en fysisk avsaknad av servrar, utan avsaknaden av huvudvärk för att hantera infrastrukturen.
Idén är att applikationens logik delas upp i oberoende funktioner. De har en händelsestruktur. Varje funktion utför en "mikrouppgift". Det enda som utvecklaren behöver göra är att ladda upp funktionerna i den konsol som tillhandahålls av molnleverantören och koppla dem till händelsekällor. Koden kommer att köras på begäran i en automatiskt förberedd container och jag betalar bara för körningstiden.
Låt oss se hur utvecklingsprocessen för applikationen nu kommer att se ut.
Från utvecklarens perspektiv
Tidigare började vi prata om en applikation för en webbshop. I den traditionella metoden utför det monolitiska programmet huvuddelen av systemlogiken. Och servern med applikationen är alltid igång, även om det inte finns någon belastning.
För att övergå till serverlösa lösningar delar vi upp applikationen i mikrouppgifter. För var och en av dem skriver vi vår egen funktion. Funktionerna är oberoende av varandra och lagrar ingen tillståndsinformation (stateless). De kan till och med skrivas på olika språk. Om en av dem "faller" kommer applikationen inte helt att stanna. Applikationens arkitektur kommer att se ut så här:
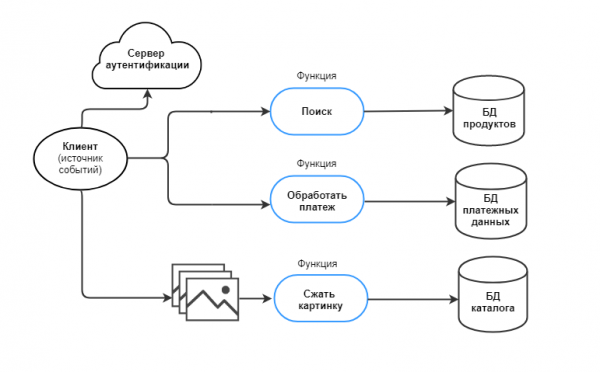
Indelningen i funktioner i Serverless liknar arbetet med mikrotjänster. Men en mikrotjänst kan utföra flera uppgifter medan en funktion i idealfallet ska utföra en enda. Tänk på att vi har som uppgift att samla statistik och returnera den på begäran av användaren. I en mikrotjänstansats utför en tjänst uppgiften med två ingångspunkter: en för skrivning och en för läsning. I serverlösa beräkningar blir det två olika funktioner som inte är kopplade till varandra. Utvecklaren sparar datorkapacitet om till exempel statistiken uppdateras oftare än den laddas ner.
Serverless-funktioner måste köras under en kort tidsperiod (timeout) som definieras av tjänsteleverantören. Till exempel är timeouten för AWS 15 minuter. Det betyder att långvariga funktioner (long-lived) måste justeras enligt kraven – detta är vad Serverless skiljer sig från andra idag populära teknologier (containrar och Platform as a Service).
Vi tilldelar varje funktion en händelse. En händelse är en trigger för en åtgärd:
Händelse
Åtgärden som funktionen utför
En bild på produkten har laddats upp till lagret
Komprimera bilden och ladda upp den till katalogen
Adressen till den fysiska butiken har uppdaterats i databasen
Lägg till den nya platsen på kartorna
Kunden betalar för produkten
Starta betalningsbehandlingen
Händelser kan vara HTTP-förfrågningar, strömmande data, meddelandeköer och så vidare. Källor till händelser är förändringar eller tillkommande data. Dessutom kan funktioner startas enligt en timer.
Arkitekturen har arbetats fram och applikationen har nästan blivit serverlös. Nästa steg är att gå till tjänsteleverantören.
Från tjänsteleverantörens sida
Serverlösa beräkningar erbjuds vanligtvis av molntjänstleverantörer. De kallas på olika sätt: Azure Functions, AWS Lambda, Google Cloud Functions, IBM Cloud Functions.
Vi kommer att använda tjänsten via konsolen eller tjänsteleverantörens personliga konto. Koden för funktionerna kan laddas upp på ett av följande sätt:
- skapa kod i inbyggda editorer via webbkonsolen,
- ladda upp ett arkiv med koden,
- arbeta med offentliga eller privata git-repositorier.
Här konfigurerar vi händelser som utlöser funktionen. Olika leverantörer kan ha olika uppsättningar av händelser.
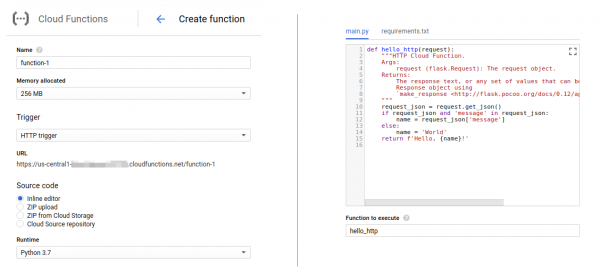
Leverantören har byggt och automatiserat en Function as a Service (FaaS) system på sin infrastruktur:
- Funktionernas kod lagras på leverantörens sida.
- När en händelse inträffar startas automatiskt containrar med en förberedd miljö på servern. Varje instans av funktionen har sin egen isolerade container.
- Från lagringen skickas funktionen till containern, beräknas och ger ett resultat.
- Antalet parallella händelser ökar – antalet containrar ökar. Systemet skalas automatiskt. Om användare inte anropar funktionen kommer den att vara inaktiv.
- Leverantören ställer in tidsgränsen för containrarna – om funktioner inte dyker upp i containern under denna tid kommer den att raderas.
På så sätt får vi Serverless "out-of-the-box". Vi betalar för tjänsten enligt pay-as-you-go-modellen och endast för de funktioner som används, och endast för den tid de användes.
För att introducera utvecklare till tjänsten erbjuder leverantörer upp till 12 månaders gratis testning, men begränsar den totala beräkningstiden, antalet förfrågningar per månad, belopp eller den effekt som används.
Den största fördelen med att arbeta med en leverantör är möjligheten att slippa oroa sig för infrastrukturen (servrar, virtuella maskiner, containrar). Från sin sida kan leverantören implementera FaaS både med egna lösningar och med hjälp av open-source verktyg. Om detta ska vi prata längre fram.
Från sidan av open source
De senaste ett par åren har open-source gemenskapen aktivt arbetat med verktyg för Serverless. Stora marknadsaktörer bidrar också till utvecklingen av serverlösa plattformar:
- Google erbjuder utvecklare sitt open-source verktyg – . I utvecklingen deltog IBM, RedHat, Pivotal och SAP;
- IBM har arbetat med Serverless-plattformen , som senare blev ett projekt under Apache Foundation;
- Microsoft har delvis öppnat koden för plattformen .
Utveckling pågår också inom området serverless-ramverk. och installeras inuti förberedda Kubernetes-kluster, fungerar både med Kubernetes och Docker Swarm. Ramverket fungerar som en speciell kontroller - på begäran förbereder det en körmiljö inuti klustret och startar sedan funktionen där.
Ramverken ger utrymme för att konfigurera verktyget efter sina behov. Så i Kubeless kan utvecklaren ställa in timeout för funktionen (standardvärdet är 180 sekunder). Fission försöker lösa problemet med kallstart genom att hålla en del av containrarna alltid påslagna (även om det innebär kostnader för resurser). OpenFaaS erbjuder en mängd olika triggeralternativ: HTTP, Kafka, Redis, MQTT, Cron, AWS SQS, NATs och flera andra.
Instruktionerna för att komma igång kan hittas i den officiella dokumentationen för ramverken. Att arbeta med dem kräver något fler färdigheter än med en leverantör - minst att kunna köra en Kubernetes-kluster via CLI. Som mest, inkludera andra open-source verktyg (som köhanteraren Kafka).
Oavsett vilken metod vi använder för att arbeta med Serverless - genom en leverantör eller med open-source - kommer vi att få en rad fördelar och nackdelar med Serverless-ansatsen.
Ur perspektivet av fördelar och nackdelar
Serverless bygger vidare på idéerna om containerinfrastruktur och mikrotjänstansats, där team kan arbeta i ett flerspråkigt läge utan att binda sig till en plattform. Byggandet av systemet förenklas och det blir lättare att åtgärda fel. Mikrotjänstarkitekturen möjliggör snabbare tillägg av ny funktionalitet till systemet jämfört med ett monolitiskt program.
Serverless minskar utvecklingstiden ytterligare, vilket gör att utvecklaren kan fokusera enbart på affärslogik och kodskrivning. Följaktligen minskar tiden för att få ut utvecklingarna på marknaden.
Som en bonus får vi automatisk skalning under belastning, och vi betalar endast för de resurser som används och endast när de används.
Som med all teknik har Serverless nackdelar.
Till exempel kan en sådan nackdel vara kallstarttiden (i genomsnitt upp till 1 sekund för språk som JavaScript, Python, Go, Java, Ruby).
Å ena sidan beror kallstarttiden i praktiken på många variabler: programmeringsspråket som funktionen är skriven i, antalet bibliotek, kodvolymen och kommunikationen med extra resurser (som databaser eller autentiseringstjänster). Eftersom utvecklaren kan hantera dessa variabler kan han minska starttiden. Men å andra sidan kan utvecklaren inte påverka tidsåtgången för att starta containern – det beror helt på leverantören.
Kallstart kan bli en varm start när funktionen återanvänder en container som tidigare kördes av en händelse. Denna situation uppstår i tre fall:
- om kunderna ofta använder tjänsten och antalet anrop till funktionen ökar;
- om leverantören, plattformen eller ramverket tillåter att vissa containrar hålls alltid igång;
- om utvecklaren kör funktioner på en timer (säg var tredje minut).
För många applikationer utgör kallstart inte ett problem. Här behöver man ta hänsyn till typen och syftet med tjänsten. En fördröjning på en sekund är inte alltid kritisk för en affärsapplikation, men kan bli kritisk för medicinska tjänster. Förmodligen passar inte en serverlös strategi i sådana fall längre.
Den nästa nackdelen med Serverless är den korta livscykeln för funktionen (timeout, som anger hur länge funktionen måste köras).
Men om man planerar att arbeta med långvariga uppgifter kan man använda en hybridarkitektur – kombinera Serverless med en annan teknologi.
Inte alla system kan fungera enligt Serverless-modellen.
Vissa applikationer kommer fortfarande att lagra data och tillstånd under körning. Vissa arkitekturer kommer att förbli monolitiska, medan vissa funktioner kommer att ha lång livslängd. Men precis som med molnteknologier och sedan containrar, har Serverless en ljus framtid.
I det här sammanhanget skulle jag vilja smidigt övergå till frågan om tillämpningen av Serverless-ansatsen.
När det gäller tillämpning
Under 2018 ökade andelen användning av Serverless . Bland företag som redan har implementerat teknologin i sina tjänster finns marknadsjättar som Twitter, PayPal, Netflix, T-Mobile, Coca-Cola. Samtidigt måste man förstå att Serverless inte är en universallösning utan ett verktyg för att lösa en viss mängd problem:
- Minska resursslöseriet. Det är inte nödvändigt att ständigt ha en virtuell maskin för tjänster med få förfrågningar.
- Behandla data "on-the-fly". Komprimera bilder, ta bort bakgrunder, ändra videokodning, arbeta med IoT-sensorer, utföra matematiska operationer.
- "Koppla ihop" andra tjänster. Git-repositorium med interna program, en chattbot i Slack kopplad till Jira och kalendern.
- Lastbalansera. Här stannar vi för att gå in mer i detalj.
Låt oss säga att det finns en tjänst som får 50 besökare. Den är knuten till en virtuell maskin med svag hårdvara. Periodvis ökar belastningen på tjänsten flera gånger. Då klarar inte den svaga hårdvaran av det.
Det är möjligt att inkludera en lastbalanserare i systemet som distribuerar belastningen, låt oss säga, på tre virtuella maskiner. I det här skedet kan vi inte exakt förutsäga belastningen, så vi håller ett antal resurser igång "som reserv". Och vi betalar överpris för inaktivitet.
I en sådan situation kan vi optimera systemet med en hybridmetod: kvarlämna en virtuell maskin bakom lastbalanseraren och sätta en länk till Serverless Endpoint med funktioner. Om belastningen överskrider en viss nivå startar lastbalanseraren instanser av funktioner som tar hand om en del av förfrågningarna.
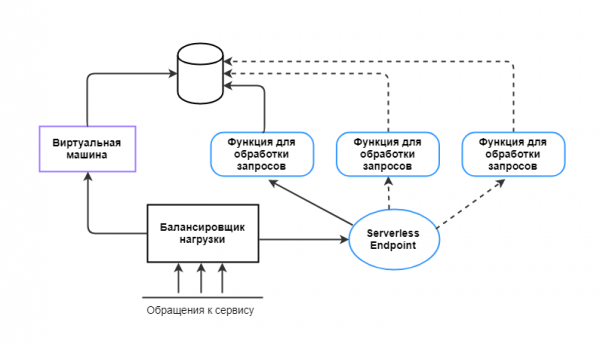
På så sätt kan Serverless användas där det är nödvändigt att intensivt bearbeta ett stort antal förfrågningar, även om det inte är så ofta. I det fallet är det mer fördelaktigt att köra flera funktioner under 15 minuter än att hela tiden ha en virtuell maskin eller server igång.
Trots alla fördelar med serverlösa beräkningar är det viktigt att först utvärdera logiken i applikationen och förstå vilka uppgifter Serverless kan lösa i det specifika fallet.
Serverless och Selectel
Hos Selectel har vi redan genom vår kontrollpanel. Nu bygger vi en egen FaaS-plattform. Vi vill att utvecklare ska kunna lösa sina uppgifter med hjälp av Serverless genom ett bekvämt, flexibelt gränssnitt.
Om du har idéer om hur den perfekta FaaS-plattformen ska se ut och hur du vill använda Serverless i dina projekt, dela dem gärna i kommentarerna. Vi kommer att beakta dina önskemål vid utvecklingen av plattformen.
Material som använts i artikeln:
Källa: habr.com
