

I den andra delen av artikeln om simulatorer av datorsystem kommer jag att fortsätta att förklara på ett enkelt och informativt sätt om datorsimulatorer, nämligen om fullplattformssimulation, som en vanlig användare oftast stöter på, samt om taktsynkronisering och banor som är mer utbredda inom utvecklarkretsar.
I Jag har berättat om vad simulatorer är generellt sett, samt om nivåerna av modellering. Nu, baserat på denna kunskap, föreslår jag att vi dyker lite djupare och pratar om fullplattformssimulation, hur man bygger banor, vad man sedan ska göra med dem, samt om taktsynkroniserad mikroarkitektur-emulering.
Fullplattformssimulator (full platform simulator), eller "En ensam kämpe är ingen kämpe"
Om det är nödvändigt att undersöka funktionen hos en specifik enhet, som ett nätverkskort, eller att skriva firmware eller drivrutiner för denna enhet, kan enheten simuleras separat. Det är dock inte särskilt praktiskt att använda den frikopplad från den övriga infrastrukturen. För att kunna köra den relevanta drivrutinen krävs en centralprocessor, minne, tillgång till buss för datatransfer med mera. Dessutom behövs ett operativsystem (OS) och nätverksstack för att drivrutinen ska fungera. Utöver detta kan en separat paketgenerator och en svarserver behövas.
Fullplattformssimulatorn skapar en miljö för att köra hela programvarustacken, som inkluderar allt från BIOS och bootloader till själva operativsystemet och dess olika delsystem, såsom nätverksstacken, drivrutinerna och användarapplikationer. För detta syfte implementeras programmodeller för de flesta enheterna i datorn: processor och minne, disk, in- och utmatningsenheter (tangentbord, mus, skärm), samt det samma nätverkskortet.
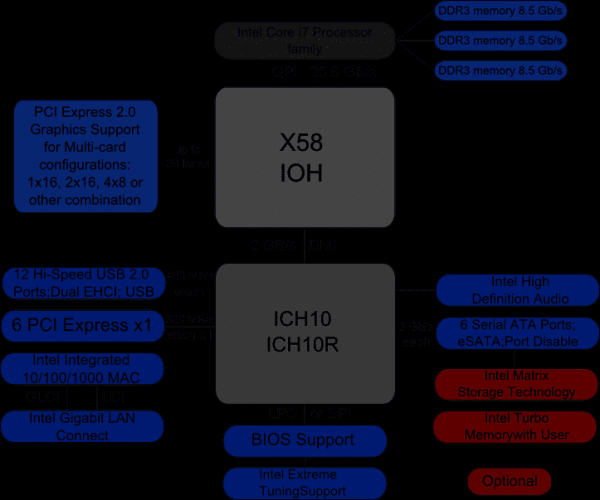
Nedan finns en blockschema över x58-chipsatsen från Intel. I en fullskalig simulering av en dator baserad på denna chipsats måste de flesta av de angivna enheterna implementeras, inklusive de som finns inuti IOH (Input/Output Hub) och ICH (Input/Output Controller Hub), som inte detaljeras i blockschemat. Även om det i praktiken finns ganska många enheter som inte används av den programvara vi planerar att köra. Modeller av sådana enheter behöver inte skapas.
Oftast implementeras fullskaliga simulatorer på processorns instruktion nivå (ISA, se ). Detta gör att simulatorn kan skapas relativt snabbt och billigt. ISA-nivån är också bra eftersom den förblir mer eller mindre konstant, till skillnad från till exempel API/ABI-nivån, som förändras oftare. Dessutom gör implementeringen på instruktion nivå det möjligt att köra så kallad oförändrad binär programvara, det vill säga att köra redan kompilerad kod utan några förändringar, precis som den används på riktig hårdvara. Med andra ord kan man göra en kopia ("dump") av hårddisken, ange den som en avbild för modellen i den fullskaliga simulatorn och – voilà! – OS och andra program startar i simulatorn utan några extra åtgärder.
Prestanda hos simulatorer
Som nämnts ovan är själva simuleringsprocessen av hela systemet, det vill säga alla dess enheter, ganska långsam. Om man dessutom implementerar allt detta på en helt detaljerad nivå, till exempel mikroarkitektur eller logisk nivå, blir utförandet extremt långsamt. Men instruktion nivå är ett lämpligt val och gör att OS och program kan köras med hastigheter som är tillräckliga för användaren för att interagera med dem bekvämt.
Här är det också lämpligt att beröra ämnet simulatorers prestanda. Vanligtvis mäts den i IPS (instructions per second), närmare bestämt i MIPS (miljoner IPS), det vill säga antalet processorinstruktioner som simulatorn utför på en sekund. Samtidigt beror simuleringshastigheten också på prestandan hos systemet som simuleringsprocessen körs på. Därför kan det vara mer korrekt att prata om "nedbromsning" (slowdown) av simulatorn jämfört med originalsistema.
De mest använda plattformssimulatorerna på marknaden, som QEMU, VirtualBox eller VmWare Workstation, erbjuder bra prestanda. För användaren kan det till och med vara osynligt att arbetet utförs i en simulator. Detta beror på den speciella virtualiseringsmöjligheten i processorer, algoritmer för binär översättning och andra intressanta saker. Detta är dock ett ämne för en separat artikel, men för att sammanfatta, så är virtualisering en hårdvarufunktion av moderna processorer som gör att simulatorer inte simulerar instruktioner, utan direkt kan överlämna dem för exekvering till den verkliga processorn, förutsatt att arkitekturerna för simulatorn och processorn liknar varandra. Binär översättning innebär att översätta gästandets maskinkod till värdmaskinkod och därefter köra den på den verkliga processorn. Resultatet är att simuleringen endast är något långsammare, typ 5-10 gånger, och ofta fungerar med samma hastighet som det verkliga systemet. Även om många faktorer påverkar detta. Till exempel, om vi vill simulera ett system med flera dussin processorer, så faller hastigheten direkt med dessa flera dussin gånger. Å andra sidan stödjer simulatorer som Simics i de senaste versionerna multiprocessorhost-konstruktioner effektivt och parallelliserar de simulerade kärnorna på de verkliga processorkärnorna.
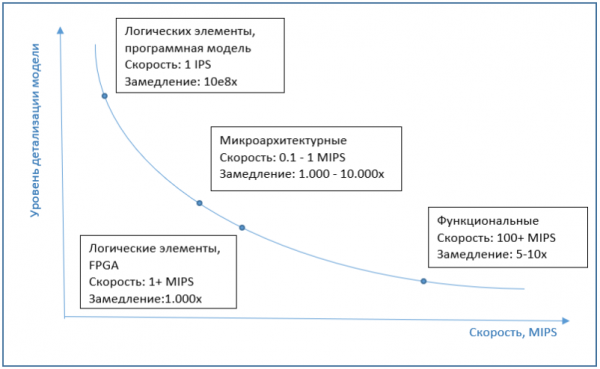
När det kommer till hastigheten av mikroarkitekturell simulering, är detta vanligtvis flera ordningar, ungefär 1000-10000 gånger, långsammare än exekveringen på en vanlig dator, utan simulering. Och implementationer på nivå av logiska element är ännu långsammare med flera ordningar. Därför används FPGA som emulator på denna nivå, vilket avsevärt ökar prestandan.
Diagrammet nedan visar den ungefärliga relationen mellan simuleringens hastighet och modellens detaljnivå.
Klockcykelsimulering
Trots den låga hastigheten på utförande är mikroarkitektur-simulatorer ganska vanliga. Modellering av interna processorblock är nödvändig för att exakt simulera tiden för att utföra varje instruktion. Här kan det uppstå missförstånd – varför ska man inte bara programmera utförandetiden för varje instruktion? Men en sådan simulator skulle fungera mycket imprecist, eftersom tiden för att utföra samma instruktion kan variera mellan olika anrop.
Ett enkelt exempel är instruktionen för minnesåtkomst. Om den begärda minnescellen finns i cache-minnet blir tiden för utförande minimal. Om denna information inte finns i cachen (cache miss) ökar tiden för att utföra instruktionen avsevärt. Därför behövs en cache-modell för noggrann simulering. Men det handlar inte bara om cache-modellen. Processorn kommer inte bara att vänta på data från minnet när den inte finns i cachen. Istället kommer den att börja utföra nästa instruktioner, välja sådana som inte beror på resultatet av läsningen från minnet. Detta kallas ”utanför ordning” (OOO, out of order execution), vilket är nödvändigt för att minimera processorstillestånd. Att ta hänsyn till allt detta när man beräknar tiden för att utföra instruktioner hjälper modelleringen av motsvarande processorblock. Bland dessa instruktioner som körs under tiden som man väntar på resultatet från minnesläsningen kan det finnas en villkorsstyrd hoppoperation. Om resultatet av villkoret är okänt för tillfället stoppar inte processorn utförandet, utan gör en ”gissning”, utför det motsvarande hoppet och fortsätter proaktivt att utföra instruktioner från hoppets plats. En sådan block, kallad branch predictor, måste också implementeras i mikroarkitektur-simulatorn.
Bilden nedan visar de grundläggande blocken i processorn, det är inte nödvändigt att känna till dem, de är endast presenterade för att visa komplexiteten i mikroarkitekturella implementationer.
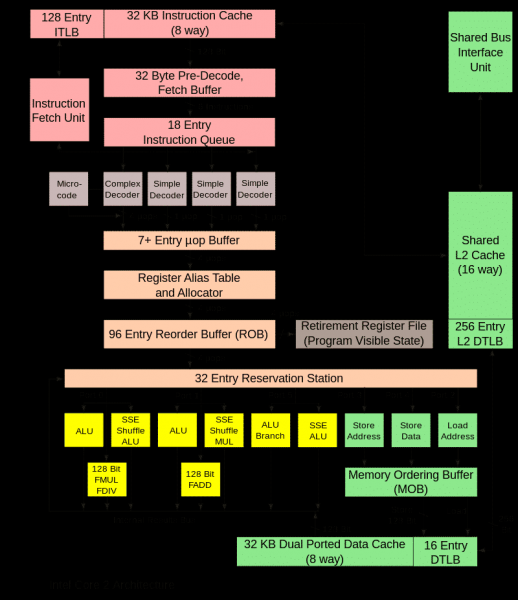
Arbetet av alla dessa block i en verklig processor synkroniseras av speciella klocksignaler, på liknande sätt som det sker i modellen. En sådan mikroarkitektursimulator kallas cyklisk (cycle accurate). Dess huvudsakliga syfte är att noggrant förutsäga prestandan hos den utvecklade processorn och/eller beräkna exekveringstiden för ett specifikt program, till exempel ett benchmark. Om värdena ligger under de nödvändiga, behöver algoritmer och processorblock justeras eller programmet optimeras.
Som nämnts ovan är cyklisk simulering mycket långsam, därför används den endast vid undersökning av vissa aspekter av programmets arbete, där det är nödvändigt att veta den verkliga hastigheten vid programexekvering och bedöma den framtida prestandan hos enheten vars prototyp simuleras.
För simuleringen av resten av programmets körning används en funktionell simulator. Hur sker sådan kombinerad användning i verkligheten? Först startas den funktionella simulatorn, där operativsystemet och allt som behövs för att köra det undersökta programmet laddas. Vi är inte intresserade av själva operativsystemet, eller de initierande stegen i programstarten, konfigurationen med mera. Men vi kan inte hoppa över dessa delar och gå direkt till att exekvera programmet från mitten. Därför körs alla dessa preliminära steg på den funktionella simulatorn. När programmet har kört fram till den punkt som intresserar oss, finns det två alternativ. Man kan byta till den cykliska modellen och fortsätta exekveringen. Den simuleringsläge där den exekverbara koden används (dvs. vanliga kompilera programfiler) kallas exekveringsdriven simulering (execution driven simulation). Detta är det mest förekommande alternativet för simulering. Det finns också en annan metod - simulering baserad på spår (trace driven simulation).
Simulering baserad på spår
Den består av två steg. Med hjälp av en funktionell simulator eller på ett verkligt system samlas och skrivs programmets åtgärder ner i en loggfil. Denna logg kallas spår (trace). Beroende på vad som undersöks kan spåret inkludera körbara instruktioner, minnesadresser, portnummer, information om avbrott.
Nästa steg är "uppspelning" av spåret, där taktfrekvensimulatorn läser spåret och utför alla instruktioner som är skrivna i det. I slutet får vi tiden för att köra detta programsegment, samt olika egenskaper för denna process, såsom träffprocent på cache.
En viktig aspekt av att arbeta med spår är determinism, det vill säga att genom att köra simuleringen på det sätt som beskrivits ovan, återskapar vi samma sekvens av åtgärder gång på gång. Detta ger möjlighet att, genom att ändra modellparametrar (cachestorlekar, buffrar och köer) och använda olika interna algoritmer eller anpassa dem, undersöka hur en viss parameter påverkar systemets prestanda och vilket alternativ som ger bäst resultat. Allt detta kan göras med prototypmodellen av en enhet innan en verklig hårdvarupr prototyp skapas.
Komplexiteten i detta tillvägagångssätt ligger i behovet av att förhandsköra applikationen och samla in spåret, samt den enorma storleken på spårfilen. Fördelarna inkluderar att det räcker att modellera endast den del av enheten eller plattformen som är av intresse, medan simulering av exekvering vanligtvis kräver en komplett modell.
Så, i den här artikeln har vi granskat egenskaperna hos plattformsövergripande simulering, diskuterat hastigheten för implementationer på olika nivåer, taktfrekvenssimulering och spår. I nästa artikel kommer jag att beskriva de viktigaste användningsscenarierna för simulatorer, både för personliga ändamål och ur ett utvecklingsperspektiv i stora företag.
Källa: habr.com
