

Hej alla. Vänner, vi delar med oss av översättningen av artikeln som är speciellt förberedd för studenter på kursen . Låt oss köra!
Apache Beam och DataFlow för realtidsrörledningar
Dagens inlägg är baserat på en uppgift som jag nyligen arbetade med på jobbet. Jag var verkligen glad över att få genomföra den och beskriva det arbete jag gjort i form av ett blogginlägg, eftersom det gav mig möjlighet att få arbeta med dataengineering samt att göra något som skulle vara mycket värdefullt för mitt team. Inte så länge sedan upptäckte jag att våra system hade en ganska stor logg av användardata relaterade till en av våra produkter för databehandling. Det visade sig att ingen hade använt dessa data, så jag blev direkt intresserad av vad vi skulle kunna lära oss om vi började analysera dem regelbundet. Men det fanns några problem på vägen. Det första problemet var att datan var lagrad i många olika textfiler som inte var tillgängliga för omedelbar analys. Det andra problemet var att de var sparade i ett stängt system, vilket innebar att jag inte kunde använda något av mina favoritverktyg för dataanalys.
Jag stod inför utmaningen att hitta ett sätt att göra åtkomsten enklare för oss och ge någon form av värde genom att integrera denna datakälla i några av våra användarinteraktionslösningar. Efter att ha funderat ett tag beslöt jag mig för att konstruera en pipeline för att överföra dessa data till en molndatabas så att jag och mitt team skulle kunna få tillgång till dem och börja dra några slutsatser. Efter att jag avslutat min specialisering i Data Engineering på Coursera för ett tag sedan, var jag ivrig att använda några verktyg från kursen i projektet.
Därför verkade lagring av data i en molndatabas vara en rimlig lösning på mitt första problem, men vad skulle jag göra med problem nummer 2? Lyckligtvis fanns det ett sätt att flytta dessa data till en miljö där jag kunde få tillgång till verktyg som Python och Google Cloud Platform (GCP). Men detta var en lång process, så jag behövde göra något som gjorde att jag kunde fortsätta utvecklingen medan jag väntade på att datatransfereringen skulle slutföras. Lösningen jag kom fram till var att skapa falska data med hjälp av biblioteket Faker i Python. Jag hade aldrig använt detta bibliotek tidigare, men insåg snabbt hur användbart det var. Genom att använda denna metod kunde jag börja skriva kod och testa pipeline utan faktiska data.
Med det sagt, i detta inlägg kommer jag att berätta hur jag byggde den pipeline som beskrivits ovan, med hjälp av några av de teknologier som är tillgängliga i GCP. Specifikt kommer jag att använda Apache Beam (Python-versionen), Dataflow, Pub/Sub och BigQuery för att samla användarloggar, transformera data och överföra dem till en databas för vidare analys. I mitt fall behövde jag bara den batchfunktionalitet som Beam erbjuder, eftersom mina data inte kom i realtid, så Pub/Sub var inte nödvändigt. Men jag kommer att nämna den strömmande versionen, eftersom det är något ni kan stöta på i praktiken.
Introduktion till GCP och Apache Beam
Google Cloud Platform erbjuder en uppsättning riktigt användbara verktyg för bearbetning av stordata. Här är några av de verktyg jag kommer att använda:
- är en meddelandetjänst som använder publikator-prenumerantmönstret (Publisher-Subscriber), vilket möjliggör för oss att ta emot data i realtid.
- är en tjänst som förenklar skapandet av datakanaler och automatiskt hanterar uppgifter som skalning av infrastruktur, vilket innebär att vi kan fokusera endast på att skriva kod för vår pipeline.
- är en molndatabas. Om du är bekant med andra SQL-databaser kommer det inte ta lång tid att förstå BigQuery.
- Och slutligen kommer vi att använda Apache Beam, särskilt fokusera på Python-versionen för att skapa vår pipeline. Detta verktyg gör det möjligt för oss att skapa en pipeline för realtids- eller batchbearbetning som integreras med GCP. Det är särskilt användbart för parallell bearbetning och passar för uppgifter av typen extraktion, transformation och laddning (ETL), så om vi behöver flytta data från en plats till en annan med transformationer eller beräkningar, är Beam ett bra val.
Det finns en mängd olika verktyg tillgängliga på GCP, vilket kan göra det svårt att hålla koll på dem alla och vad deras syfte är, men här är en sammanfattning av dem som referens.
Det finns många verktyg tillgängliga på GCP, vilket kan göra det svårt att täcka allt, inklusive deras syften, men ändå en sammanfattning för referens.
Visualisering av vår pipeline
Låt oss visualisera komponenterna i vår pipeline på figur 1. På en övergripande nivå vill vi samla in användardata i realtid, bearbeta dem och skicka dem till BigQuery. Loggar genereras när användare interagerar med produkten och skickar förfrågningar till servern, som sedan loggas. Dessa data kan vara särskilt användbara för att förstå hur användare interagerar med vår produkt och om den fungerar som den ska. Generellt sett kommer pipelinen att innehålla följande steg:
Beam gör denna process mycket enkel, oavsett om vi har en strömmande datakälla eller en CSV-fil och vill göra batchbehandling. Senare ser du att det bara finns minimala ändringar i koden som behövs för att växla mellan dem. Detta är en av fördelarna med att använda Beam.
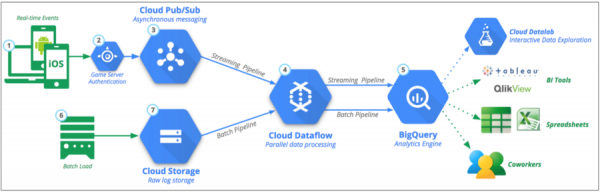
Figur 1: Huvudpipeline för data: Källa:
Skapa pseudodata med hjälp av Faker
Som jag nämnde tidigare, på grund av begränsad tillgång till data, bestämde jag mig för att skapa pseudodata i samma format som de faktiska. Det var verkligen en användbar övning, eftersom jag kunde skriva kod och testa pipelinen medan jag väntade på data. Låt oss ta en titt på Faker, om du vill veta vad mer detta bibliotek kan erbjuda. Våra användardata kommer i stort att likna exemplet nedan. Baserat på detta format kan vi generera data rad för rad för att simulera data i realtid. Dessa loggar ger oss information som datum, typ av förfrågan, svar från servern, IP-adress osv.
192.52.197.161 - - [30/Apr/2019:21:11:42] "PUT /tag/category/tag HTTP/1.1" [401] 155 "https://harris-lopez.com/categories/about/" "Mozilla/5.0 (Macintosh; PPC Mac OS X 10_11_2) AppleWebKit/5312 (KHTML, like Gecko) Chrome/34.0.855.0 Safari/5312"
Baserat på raden ovan vill vi skapa vår variabel LINE, med hjälp av 7 variabler i klamrar nedan. Vi kommer också att använda dem som variabelnamn i vårt tabellschema lite senare.
LINE = """
 {remote_addr} - - [{time_local}] "{request_type} {request_path} HTTP/1.1" [{status}] {body_bytes_sent} "{http_referer}" "{http_user_agent}"
 """
Om vi skulle göra batchbearbetning skulle koden se mycket liknande ut, även om vi skulle behöva skapa en uppsättning prover inom ett visst tidsintervall. För att använda Faker skapar vi helt enkelt ett objekt och anropar de metoder vi behöver. I synnerhet har Faker varit användbar för att skapa IP-adresser och webbplatser. Jag använde följande metoder:
fake.ipv4()
 fake.uri_path()
 fake.uri()
 fake.user_agent()
from faker import Faker
import time
import random
import os
import numpy as np
from datetime import datetime, timedelta


LINE = """
{remote_addr} - - [{time_local}] "{request_type} {request_path} HTTP/1.1" [{status}] {body_bytes_sent} "{http_referer}" "{http_user_agent}"
"""


def generate_log_line():
    fake = Faker()
    now = datetime.now()
    remote_addr = fake.ipv4()
    time_local = now.strftime('%d/%b/%Y:%H:%M:%S')
    request_type = random.choice(["GET", "POST", "PUT"])
    request_path = "\/" + fake.uri_path()

    status = np.random.choice([200, 401, 404], p = [0.9, 0.05, 0.05])
    body_bytes_sent = random.choice(range(5, 1000, 1))
    http_referer = fake.uri()
    http_user_agent = fake.user_agent()

    log_line = LINE.format(
        remote_addr=remote_addr,
        time_local=time_local,
        request_type=request_type,
        request_path=request_path,
        status=status,
        body_bytes_sent=body_bytes_sent,
        http_referer=http_referer,
        http_user_agent=http_user_agent
    )

    return log_line
Slutet av första delen.
Under de kommande dagarna kommer vi att dela med oss av fortsättningen av artikeln, och just nu ser vi traditionellt fram emot kommentarer ;-).
Källa: habr.com
