

Under åren har Pinterest 300 miljoner användare skapat över 200 miljarder pins på mer än 4 miljarder tavlor. För att betjäna denna armé av användare och den omfattande innehållsbasen har portalen utvecklat tusentals tjänster, från mikrotjänster som hanteras av några CPU:er till enorma monoliter som körs på en hel park av virtuella maskiner. Och nu har företaget riktat sin blick mot k8s. Vad är det som gör att "kubben" tilltalar "Pinterest"? Det får du veta i vår översättning av den senaste artikeln från .
Så, hundratals miljoner användare och hundratals miljarder pins. För att betjäna denna armé av användare och den omfattande innehållsbasen har vi utvecklat tusentals tjänster, från mikrotjänster som hanteras av några CPU:er till enorma monoliter som körs på en hel park av virtuella maskiner. Dessutom har vi olika ramverk som också kan kräva resurser från CPU, minne eller tillgång till I/O-operationer.
Vid stödet av denna djungel av verktyg står utvecklingsteamet inför flera problem:
- Ingen enhetlig metod för att starta arbetsmiljön. Stateless-tjänster, Stateful-tjänster och projekt under aktiv utveckling baseras på helt olika tekniska stackar. Detta har lett till skapandet av en hel utbildningskurs för ingenjörer, och det komplicerar också arbetet för vårt infrastrukturteam avsevärt.
- Utvecklare som har tillgång till sin egen park av virtuella maskiner lägger en enorm börda på interna administratörer. Som resultat drar sådana enkla uppgifter som att uppdatera OS eller AMI ut på veckor och månader. Detta leder till ökad belastning i vad som verkar vara helt vardagliga situationer.
- Svårigheter med att skapa globala infrastrukturoperationsverktyg ovanpå redan existerande lösningar. Situationen kompliceras ytterligare av att det inte är lätt att hitta ägare av virtuella maskiner. Det vill säga att vi vet inte om vi säkert kan frigöra dessa resurser för användning på andra delar av vår infrastruktur.
Containerorkestreringssystem är ett sätt att enhetliggöra hanteringen av arbetsbelastningar. De ger dig möjlighet att öka utvecklingshastigheten och förenklar infrastrukturen, eftersom alla resurser som ingår i projektet hanteras av ett centralt system.
Bild 1: Infrastrukturprioriteringar (pålitlighet, utvecklarprestanda och effektivitet).
Cloud Management Platform-teamet på Pinterest bekantade sig med K8s 2017. Under första halvan av 2017 dokumenterade vi större delen av våra produktionsresurser, inklusive API:er och alla våra webbservrar. Därefter genomförde vi en noggrann utvärdering av olika system för containerorkestrering, klusteruppbyggnad och drift. I slutet av 2017 beslutade vi oss för att använda Kubernetes. Det var tillräckligt flexibelt och hade stort stöd i utvecklarcommunityt.
Vid detta tillfälle har vi skapat egna verktyg för klusterbootstrapping baserade på Kops och migrerat befintliga infrastrukturella komponenter till Kubernetes — såsom nätverk, säkerhet, övervakning, loggning, identitetshantering och trafik. Vi har också implementerat ett arbetsbelastningssimuleringssystem för vår resurs, vars komplexitet döljs för utvecklarna. Nu fokuserar vi på att säkerställa stabilitet i klustret, dess skalning och att ansluta nya kunder.
Kubernetes: Vägen för Pinterest
Att börja arbeta med Kubernetes i stor skala på Pinterest, som en plattform som våra ingenjörer skulle älska, ledde till många svårigheter.
Som ett stort företag har vi investerat betydande resurser i infrastrukturella verktyg. Exempelvis verktyg för säkerhet som hanterar certifikat och distribuerar nycklar, trafikövervakningskomponenter, tjänstupptäcktsystem, synlighets- och loggkomponenter samt metrik. Allt detta har byggts upp för en anledning: vi har genomgått en normal väg av försök och misstag, och därför ville vi integrera allt detta i den nya infrastrukturen på Kubernetes istället för att uppfinna hjulet på nytt på en ny plattform. Denna strategi förenklade i allmänhet migreringen, eftersom all applikationsstöd redan finns, det behöver inte skapas från grunden.
Å andra sidan är modeller för belastningsprognoser inom Kubernetes (till exempel distributioner, uppgifter och daemon-set) otillräckliga för vårt projekt. Dessa användbarhetsproblem utgör enorma hinder för övergången till Kubernetes. Till exempel har vi hört hur tjänsteutvecklare klagar över bristande eller felaktig inloggningskonfiguration. Vi har också stött på felaktig användning av mallmotorer när hundratals kopior med samma specifikation och uppdrag skapats, vilket resulterat i hemska debuggingsproblem.
Det var också mycket svårt att stödja olika versioner i samma kluster. Tänk på hur komplicerat kundsupporten blir när du behöver jobba med flera versioner av samma körmiljö, med alla deras problem, buggar och uppdateringar.
Anpassade resurser och kontrollerare för Pinterest
För att underlätta implementeringen av Kubernetes för våra ingenjörer och förenkla infrastrukturen samt påskynda dess prestanda har vi utvecklat våra egna definitioner av anpassade resurser (CRD).
CRD erbjuder följande funktionaliteter:
- Sammanföra olika inbyggda resurser i Kubernetes så att de fungerar som en enhetlig belastning. Till exempel innefattar resursen PinterestService distribution, inloggningsservice och konfigurationskarta. Detta gör att utvecklare inte behöver bekymra sig om DNS-konfiguration.
- Implementera nödvändigt stöd för applikationer. Användaren behöver bara fokusera på specifikationen av containern enligt sin affärslogik medan CRD-kontrollern implementerar alla nödvändiga init-containrar, miljövariabler och pod-specifikationer. Detta ger en helt annan nivå av komfort för utvecklare.
- CRD-kontrollrar hanterar också livscykeln för egna resurser och ökar tillgängligheten för debugging. Detta inkluderar att synkronisera önskade och faktiska specifikationer, uppdatera statusen för CRD och logga händelser och mer. Utan CRD skulle utvecklare vara tvungna att hantera en mängd resurser, vilket skulle öka risken för fel.
Här är ett exempel på PinterestService och en intern resurs som styrs av vår kontrollerare:
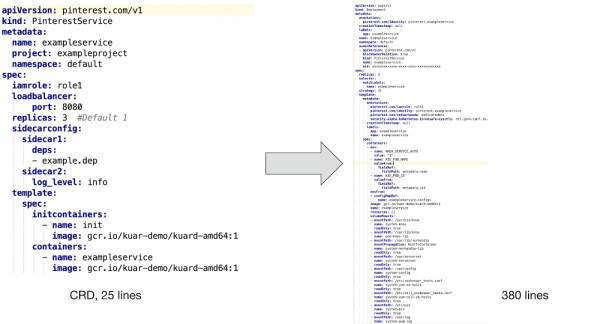
Som nämnt ovan, för att stödja en användarcontainer behöver vi integrera en initialiseringscontainer och flera tillägg för att säkerställa säkerhet, synlighet och hantering av nätverkstrafik. Dessutom har vi skapat konfigurationskarta-mallar och implementerat stöd för PVC-mallar för batchjobb, samt spåring av flera miljövariabler för att följa identifiering, resursanvändning och insamling av "skräp".
Det är svårt att föreställa sig att utvecklare skulle vilja skriva dessa konfigurationsfiler för hand utan stöd för CRD, för att inte tala om vidare stöd och felsökning av konfigurationerna.
Workflow för applikationsdeployment
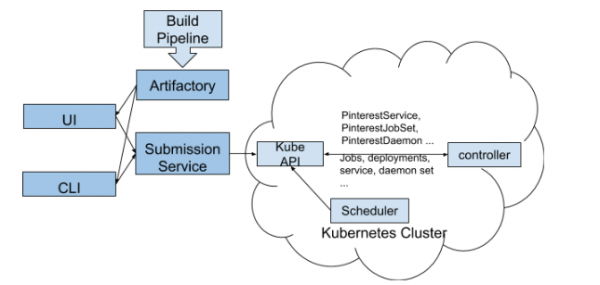
Ovanstående illustration visar hur man distribuerar en användarresurs för Pinterest i en Kubernetes-kluster:
- Utvecklare interagerar med vår Kubernetes-kluster via CLI och användargränssnitt.
- CLI / UI-verktygen hämtar YAML-konfigurationsfiler för arbetsflödet och andra byggegenskaper (samma versions-ID) från Artifactory, som sedan skickas till Job Submission Service. Detta steg säkerställer att endast fungerande versioner levereras till klustret.
- JSS fungerar som en gateway för olika plattformar, inklusive Kubernetes. Här sker användarautentisering, kvotering och delvis konfigurationsverifiering av vår CRD.
- Efter verifiering av CRD på JSS-sidan skickas informationen till k8s plattformens API.
- Vår CRD-kontrollant övervakar händelser för alla användarresurser. Den omvandlar CR till nativa k8s-resurser, lägger till nödvändiga moduler, ställer in lämpliga miljövariabler och utför andra hjälparbeten, vilket garanterar att containeranvändarapplikationer får tillräckligt med infrastrukturellt stöd.
- Sedan vidarebefordrar CRD-kontrollanten de mottagna uppgifterna till Kubernetes API för bearbetning av schemaläggaren och för att sättas i drift.
Anmärkning: detta förhandsversionsarbetsflöde skapades för de första användarna av den nya k8s-plattformen. Nu är vi i färd med att utveckla denna process för att fullt ut integrera med vår nya CI/CD. Det betyder att vi inte kan dela allt som rör Kubernetes. Vi ser fram emot att dela vår erfarenhet och berätta om teamets framsteg i detta avseende i vårt nästa blogginlägg "Bygga en CI/CD-plattform för Pinterest".
Typer av specialresurser
Baserat på Pinterests specifika behov har vi utvecklat följande CRD:er som passar olika arbetsflöden:
- PinterestService är stateless-tjänster som har varit i drift länge. Många av våra kärnsystem bygger på en uppsättning sådana tjänster.
- PinterestJobSet modellerar batchuppgifter med full cykel. Det finns ett vanligt scenarie inom Pinterest där flera uppgifter kör samma containrar parallellt, oavsett andra liknande processer.
- PinterestCronJob används ofta för små, periodiska belastningar. Detta är en wrapper för nativ cron-funktionalitet med stödsystem för Pinterest som ansvarar för säkerhet, trafik, loggar och metrik.
- PinterestDaemon inkluderar daemoner för infrastrukturen. Denna familj växer kontinuerligt eftersom vi lägger till mer stöd för våra kluster.
- PinterestTrainingJob omfattar processer för Tensorflow och Pytorch och ger samma nivå av support under körning som alla andra CRD:er. Eftersom Tensorflow och andra maskininlärningssystem används aktivt på Pinterest fanns det skäl att bygga en separat CRD kring dem.
Vi arbetar också med PinterestStatefulSet, som snart kommer att anpassas för datalager och andra stateful-system.
Stöd för körmiljö
När applikationsmodulen startas i Kubernetes, får den automatiskt ett certifikat för att identifiera sig själv. Detta certifikat används för att få tillgång till hemlagret eller för att kommunicera med andra tjänster via mTLS. Under tiden kommer containernas initialiseringskonfigurator och Daemon att ladda alla nödvändiga beroenden innan containerapplikationen startas. När allt är klart registrerar sidokontaktens trafik och Daemon modulens IP-adress i vår Zookeeper, så att kunderna kan upptäcka den. Allt detta kommer att fungera, eftersom nätverksmodulen konfigurerades innan applikationen startades.
Ovanstående är typiska exempel på stöd för arbetsbelastningar under körning. För andra typer av arbetsbelastningar kan något annat stöd krävas, men allt presenteras i form av pod-nivå sidecar, nod- eller Daemon-nivå virtuella maskiner. Vi ser till att allt detta rullas ut inom den hanterande infrastrukturen och koordineras mellan applikationerna, vilket i slutänden avsevärt minskar belastningen i fråga om tekniskt arbete och kundsupport.
Testning och QA
Vi har byggt en end-to-end testpipeline ovanpå den befintliga testinfrastrukturen i Kubernetes. Dessa tester sträcker sig över alla våra kluster. Vår pipeline har genomgått många omarbetningar innan den blev en del av produktklustret.
Förutom testningssystem har vi övervaknings- och varningssystem som ständigt bevakar statusen för systemkomponenterna, resursförbrukningen och andra viktiga indikatorer, och meddelar oss endast vid behov av mänsklig inblandning.
Alternativ
Vi övervägde vissa alternativ till anpassade resurser, såsom mutationskontrollanter och mallsystem. Men alla dessa är förenade med allvarliga svårigheter, så vi valde vägen CRD.
Mutationskontrollanten användes för att införa sidokontakter, miljövariabler och annat stöd under körning. Men den stötte på olika problem, såsom resursbindning och hantering av livet, vilket inte förekommer i CRD.
Anmärkning: Mall för system, såsom Helm-diagram, används också i stor utsträckning för att köra applikationer med liknande konfigurationer. Våra arbetsapplikationer är dock för varierande för att hanteras med hjälp av mallar. Dessutom kommer det att uppstå för många fel vid kontinuerlig driftsättning med användning av mallar.
Kommande arbete
Just nu hanterar vi en blandad belastning på alla våra kluster. För att stödja sådana processer av olika typer och storlekar arbetar vi inom följande områden:
- En uppsättning kluster distribuerar stora applikationer över olika kluster för att säkerställa skalbarhet och stabilitet.
- Att säkerställa stabilitet, skalbarhet och synlighet för klustret för att skapa en koppling mellan applikationen och dess SLA.
- Resurshantering och kvoter så att applikationer inte stör varandra, och klustrets skala kontrolleras från vår sida.
- En ny CI/CD-plattform för att stödja och distribuera applikationer i Kubernetes.
Källa: habr.com
