

Prestandaanalys och optimering — ett kraftfullt verktyg för att kontrollera prestandamatchning för kunder.
Prestandaanalys kan användas för att identifiera flaskhalsar i programmet, med en vetenskaplig ansats vid utvärdering av konfigurationsexperiment. Denna artikel definierar en generell metod för prestandaanalys och optimering med en webbserver skriven i Go som exempel.
Go är särskilt väl lämpad för detta eftersom den erbjuder profilering verktyg. pprof i standardbiblioteket.
Strategi
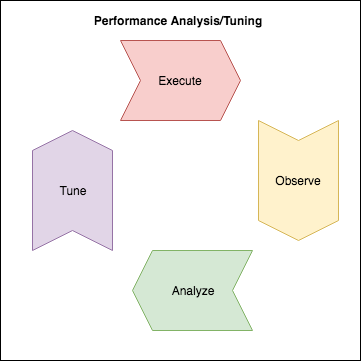
Låt oss skapa en sammanställning för vår strukturella analys. Vi kommer att försöka använda viss data för beslutsfattande istället för att göra ändringar baserat på intuition eller gissningar. För detta gör vi så här:
- Definiera optimeringsgränser (krav);
- Beräkna transaktionsbelastningen för systemet;
- Genomför test (skapa data);
- Observera;
- Analysera — uppfylls alla krav?
- Optimera vetenskapligt, formulera en hypotes;
- Genomför experiment för att verifiera denna hypotes.
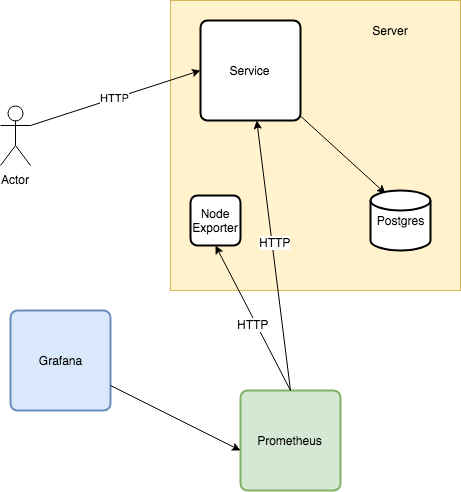
Arkitektur för en enkel HTTP-server
För denna artikel kommer vi att använda en liten HTTP-server på Golang. All kod från denna artikel kan hittas .
Det analyserade programmet är en HTTP-server som frågar Postgresql vid varje begäran. Dessutom finns Prometheus, node_exporter och Grafana för insamling och visning av applikations- och systemmetrik.
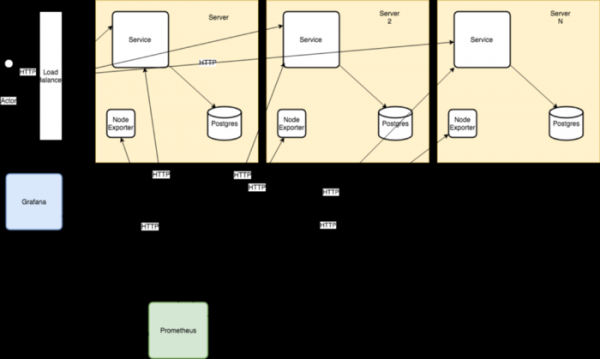
För enkelhetens skull antar vi att för horisontell skalning (och förenkling av beräkningar) varje tjänst och databas rullas ut tillsammans:
Definiera mål
I det här steget definierar vi oss själva med målet. Vad försöker vi analysera? Hur vet vi när det är dags att avsluta? I denna artikel föreställer vi oss att vi har kunder och att vår tjänst ska hantera 10 000 begärningar per sekund.
I diskuterar detaljerat val och modellering. Vi följer samma tillvägagångssätt, bygger modeller:
- Fördröjning: 99% av begärningarna ska slutföras på mindre än 60 ms;
- Kostnad: tjänsten ska förbruka den minsta summa pengar som vi anser rimligt möjlig. För detta maximerar vi genomströmningen;
- Kapacitetsplanering: det krävs en förståelse och dokumentation av hur många instanser av applikationen som behöver startas, inklusive den övergripande skalningsfunktionen, samt hur många instanser som krävs för att möta de initiala belastningskraven och säkerställa .
Fördröjningen kan kräva optimering utöver analysen, men bandbredden måste uppenbarligen analyseras. Vid användning av SRE-processen kommer kravet på fördröjning från kunden och/eller affären, representerade av produktägaren. Och vår tjänst kommer att uppfylla detta åtagande från början utan några justeringar!
Konfigurera testmiljö
Med hjälp av testmiljön kan vi generera en kontrollerad belastning på vårt system. Det kommer att skapas prestandadata om webbtjänsten för analys.
Transaktionell belastning
Denna miljö använder för att skapa anpassningsbar HTTP-förfrågningsfrekvens tills det stoppas:
$ make load-test LOAD_TEST_RATE=50
echo "POST http://localhost:8080" | vegeta attack -body tests/fixtures/age_no_match.json -rate=50 -duration=0 | tee results.bin | vegeta report
Övervakning
Under körningen kommer en transaktionell belastning att tillämpas. Utöver applikationsmetrik (antal förfrågningar, svarsfördröjningar) och operativsystemmetrik (minne, CPU, IOPS) kommer applikationsprofilering att genomföras för att förstå var det finns problem samt hur processor-tid konsumeras.
Profilering
Profilering är en typ av mätning som låter oss se vart processor-tid går när applikationen körs. Det gör det möjligt att avgöra exakt var och hur mycket processor-tid som används:
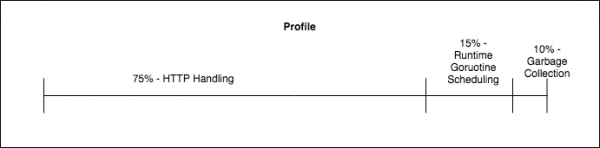
Data kan användas under analysen för att få insikt om onödigt förlorad processor-tid och onödigt utförd arbete. Go (pprof) kan generera profiler och visualisera dem i form av flame graph, med hjälp av standarduppsättningen av verktyg. Jag kommer att berätta om deras användning och konfigurationsguide lite längre ner i artikeln.
Utförande, övervakning, analys.
Vi genomför ett experiment. Vi kommer att utföra, observera och analysera tills vi är nöjda med prestandan. Vi väljer en godtyckligt låg belastning för att tillämpa den för att få resultat från de första observationerna. Vid varje efterföljande steg kommer vi att öka belastningen med en viss skalningsfaktor, vald med en viss spridning. Varje körning av belastningstestningen utförs med justering av antalet förfrågningar: make load-test LOAD_TEST_RATE=X.
50 förfrågningar per sekund
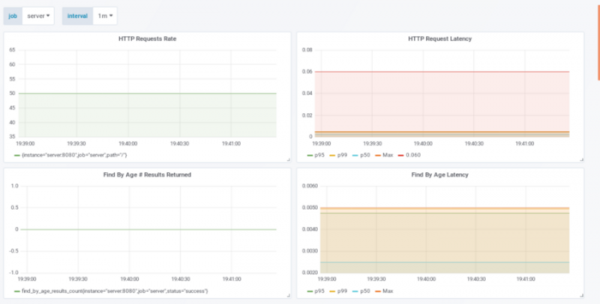
Observera de två övre graferna. Den övre vänstra visar att vår applikation hanterar 50 förfrågningar per sekund (enligt vad den tror), och den övre högra visar varaktigheten för varje förfrågan. Båda parametrarna hjälper oss att se och analysera: går vi inom våra prestandagränser eller inte. Den röda linjen i grafen HTTP Request Latency visar SLO på 60 ms. Enligt linjen ligger vi långt under vår maximala svarstid.
Låt oss titta på kostnadssidan:
10000 förfrågningar per sekund / på 50 förfrågningar per server = 200 servrar + 1
Vi kan fortfarande förbättra detta värde.
500 förfrågningar per sekund
Mer intressanta saker börjar hända när belastningen är 500 förfrågningar per sekund:
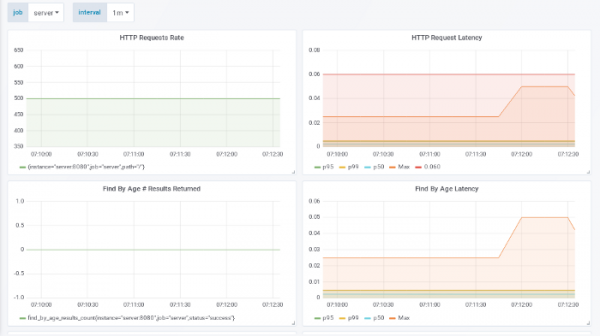
Återigen i den vänstra övre grafen ser vi att applikationen registrerar en normal belastning. Om inte, finns det ett problem på servern där applikationen är igång. Grafen med svarsfördröjning finns högst upp till höger och visar att 500 förfrågningar per sekund ledde till svarsfördröjningar på 25-40 ms. 99:e percentilen faller fortfarande inom SLO på 60 ms, som valdes ovan.
Från kostnadssynpunkt:
10000 förfrågningar per sekund / på 500 förfrågningar per server = 20 servrar + 1
Det finns fortfarande utrymme för förbättring.
1000 förfrågningar per sekund
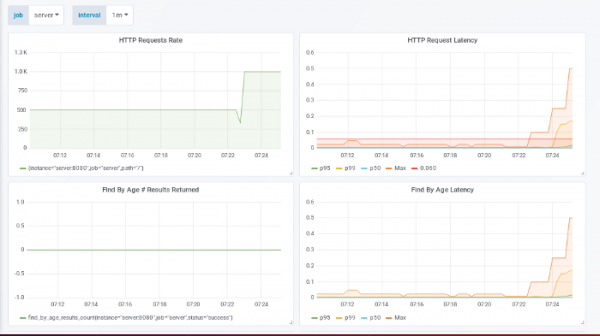
En fantastisk körning! Applikationen visar att den har hanterat 1000 förfrågningar per sekund, men gränsen för fördröjning har överskridits enligt SLO. Detta kan ses på p99-linjen i den övre högra grafen. Trots att p100-linjen är mycket högre, är de faktiska fördröjningarna över maximivärdet på 60 ms. Låt oss dyka ner i profileringen för att ta reda på vad applikationen faktiskt gör.
Profilering
För profilering sätter vi belastningen på 1000 förfrågningar per sekund, och sedan använder vi pprof för att samla in data för att ta reda på var applikationen spenderar processor tid. Detta kan göras genom att aktivera HTTP-endpointen. pprof, efter vilket du kan spara resultaten under belastning med curl:
$ curl http://localhost:8080/debug/pprof/profile?seconds=29 > cpu.1000_reqs_sec_no_optimizations.profResultaten kan visas så här:
$ go tool pprof -http=:12345 cpu.1000_reqs_sec_no_optimizations.prof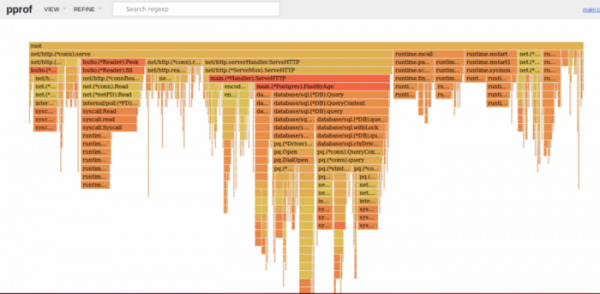
Grafen visar var och hur mycket CPU-tid applikationen använder. Enligt beskrivningen av :
X-axeln representerar stapelfyllnaden, sorterad alfabetiskt (detta är inte tid), Y-axeln visar stapeldjupet, räknat från noll i [top]. Varje rektangel är en stapelram. Ju bredare ramen är, desto oftare förekommer den i stacker. Det som är högst upp arbetar på CPU, medan det längre ner är underordnade element. Färgerna har oftast ingen betydelse utan väljs slumpmässigt för att särskilja ramar.
Analys - hypotes
För inställningen kommer vi att fokusera på att försöka hitta meningslösa CPU-åtgångar. Vi ska leta efter de största källorna till meningslös åtgång och ta bort dem. Med tanke på att profileringen tydligt visar var applikationen använder sin CPU-tid kan det hända att detta behöver göras flera gånger, och det kan krävas att ändra applikationens källkod, starta om tester och observera att prestandan närmar sig planen.
Följande Brendan Greggs rekommendationer kommer vi att läsa grafen uppifrån och ner. Varje rad visar en stapelram (funktionsanrop). Första raden är inträdespunkten i programmet, förälder till alla andra anrop (med andra ord kommer alla andra anrop att ha den i sin stack). Nästa rad är redan annorlunda:

Om du för musen över funktionsnamnet i grafen visas den totala tiden som den var i stacken under felsökningen. Funktionen HTTPServe spenderade där 65% av tiden, andra funktioner runtime.mcall, mstart och gc, tog upp resterande tid. En intressant detalj: 5% av den totala tiden spenderades på DNS-förfrågningar:
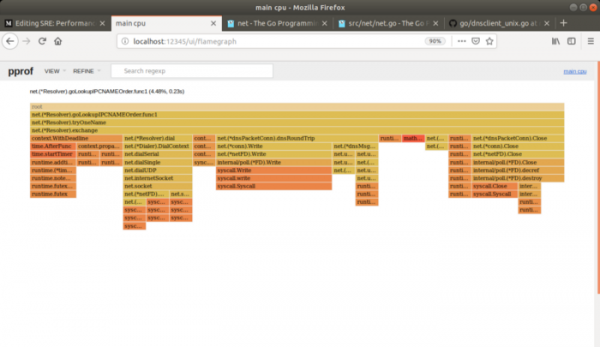
Adresserna som programmet söker tillhör Postgresql. Vi klickar på FindByAge:
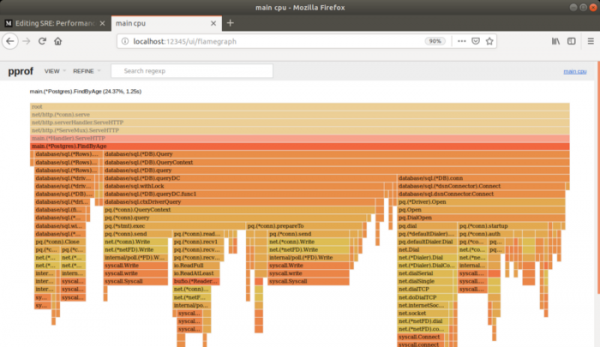
Intressant nog visar programmet att det finns tre huvudsakliga källor som bidrar till latensen: öppning/stängning av anslutningar, datainhämtning och anslutning till databasen. Grafen visar att DNS-förfrågningar, öppning och stängning av anslutningar tar cirka 13% av den totala körningstiden.
Hypotes: Återanvändning av anslutningar med hjälp av en pool bör minska tiden för en enskild HTTP-förfrågan, vilket möjliggör högre kapacitet och lägre latens..
Appinställning — experiment.
Vi uppdaterar källkoden, testar att ta bort anslutningen till Postgresql för varje begäran. Första alternativet — användning av på applikationsnivå. I detta experiment kommer vi anslutningspoolen med hjälp av sql-drivrutinen för Go:
db, err := sql.Open("postgres", dbConnectionString)
db.SetMaxOpenConns(8)

if err != nil {
   return nil, err
}
Utförande, övervakning, analys.
Efter omstart av testet med 1000 förfrågningar per sekund är det tydligt att p99 av latenserna har kommit i norm med SLO 60 ms!
Vad kostar det?
10000 förfrågningar per sekund / på 1000 förfrågningar per server = 10 servrar + 1.
Låt oss göra det ännu bättre!
2000 förfrågningar per sekund.
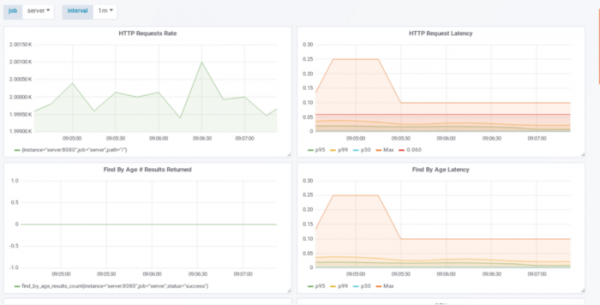
En dubblering av belastningen visar samma sak, den övre vänstra grafen visar att applikationen lyckas hantera 2000 förfrågningar per sekund, p100 är under 60 ms, p99 uppfyller SLO.
Från kostnadssynpunkt:
10000 förfrågningar per sekund / på 2000 förfrågningar per server = 5 servrar + 1.
3000 förfrågningar per sekund.
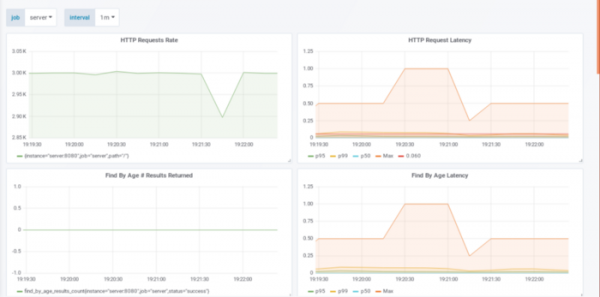
Här kan applikationen hantera 3000 förfrågningar med en p99-latens under 60 ms. SLO bryts inte, och kostnaden tas som:
10000 förfrågningar per sekund / på 3000 förfrågningar per server = 4 servrar + 1. (författaren avrundade uppåt, översättarens anm.)
Låt oss göra ett ytterligare analysomgång.
Analys - hypotes
Vi samlar in och visar resultaten från avkodningen av applikationen på 3000 förfrågningar per sekund:
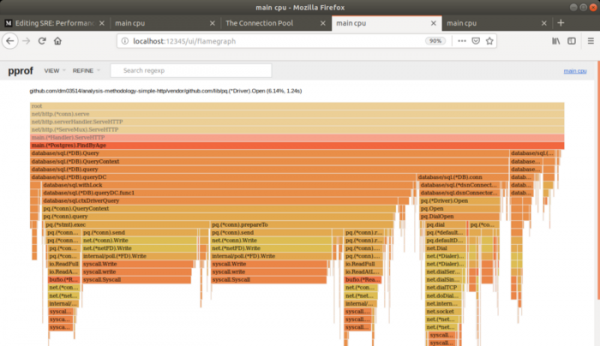
Ännu 6% av tiden spenderas på att etablera anslutningar. Inställningen av poolen har förbättrat prestandan, men det är fortfarande tydligt att applikationen fortsätter att skapa nya anslutningar till databasen.
Hypotes: Anslutningar, trots existensen av en pool, avvisas och städas fortfarande, så applikationen måste återetablera dem. Inställningen av antalet väntande anslutningar till poolens storlek bör hjälpa till med latensen genom att minimera tiden som applikationen spenderar på att skapa en anslutning..
Appinställning — experiment.
Vi försöker ställa in lika med poolens storlek (som även beskrivs i ):
db, err := sql.Open("postgres", dbConnectionString)
db.SetMaxOpenConns(8)
db.SetMaxIdleConns(8)
if err != nil {
   return nil, err
}
Utförande, övervakning, analys.
3000 förfrågningar per sekund.
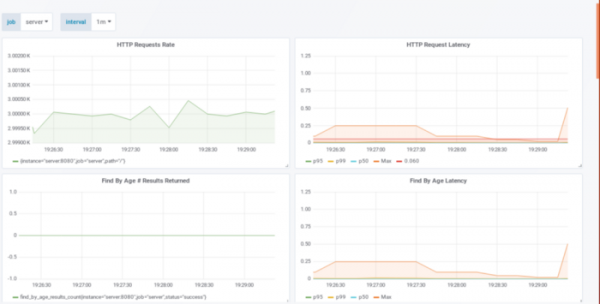
p99 under 60 ms med betydligt lägre p100!
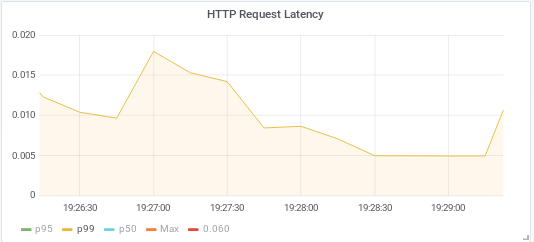
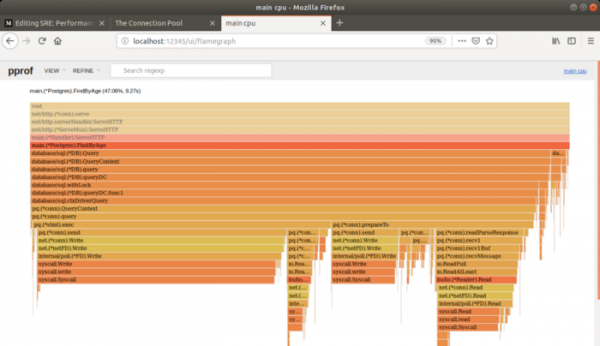
Kontrollen av flame graph visar att anslutningen inte längre är märkbar! Låt oss undersöka närmare. pg(*conn).query — vi märker inte att anslutningen etableras här heller.
Slutsats
Prestandaanalys är avgörande för att förstå om kundernas förväntningar och icke-funktionella krav uppfylls. Genom att jämföra observationer med kundernas förväntningar kan man avgöra vad som är acceptabelt och vad som inte är det. Go erbjuder effektiva verktyg, inbyggda i standardbiblioteket, som gör analysen enkel och tillgänglig.
Källa: habr.com
