

Tillkännagivande
Kolleger, jag planerar att släppa en ny serie artiklar om design av massservice-system under mitten av sommaren: "Experiment VTrade" — ett försök att skriva ett ramverk för handelssystem. Serien kommer att gå igenom teorin och praktiken för att bygga en börs, auktion och butik. I slutet av artikeln föreslår jag att vi röstar på de ämnen som intresserar er mest.
Detta är den sista artikeln i serien om distribuerade reaktiva applikationer på Erlang/Elixir. I kan man hitta de teoretiska grunderna för reaktiv arkitektur. illustrerar de grundläggande mönstren och mekanismerna för att bygga sådana system.
Idag kommer vi att ta upp frågor om utvecklingen av kodbasen och projekten som helhet.
Organisering av tjänster
I verkliga livet, vid utvecklingen av en tjänst, måste man ofta kombinera flera interaktionsmönster i en och samma kontroller. Till exempel, tjänsten users, som hanterar användarprofiler, bör svara på req-resp-förfrågningar och meddela om uppdateringar av profiler via pub-sub. Detta fall är ganska enkelt: för messaging står en kontroller som implementerar tjänstens logik och publicerar uppdateringar.
Situationen kompliceras när vi måste implementera en felresistent distribuerad tjänst. Låt oss anta att kraven på users har ändrats:
- nu måste tjänsten kunna hantera förfrågningar på 5 noder i klustret,
- ha möjlighet att utföra bakgrundsbehandling,
- samt kunna hantera abonnemangslister för uppdateringar av profiler dynamiskt.
Anmärkning: Frågan om konsekvent lagring och replikering av data ska vi inte behandla. Låt oss anta att dessa frågor har lösts tidigare och att det redan finns ett tillförlitligt och skalbart lagringsskikt i systemet, och att hanterarna har mekanismer för att interagera med det.
Den formella beskrivningen av tjänsten users har blivit mer komplex. Från programmörens perspektiv, tack vare användningen av messaging, är förändringarna minimala. För att uppfylla det första kravet måste vi konfigurera belastningsbalansering vid punktutbytet a req-resp.
Kravet på att hantera bakgrundsuppgifter uppstår ofta. I användarna kan detta vara kontroller av användardokument, bearbetning av uppladdad multimedia eller synkronisering av data med sociala nätverk. Dessa uppgifter måste fördelas på något sätt inom klustret och övervakas. Därför har vi två lösningar: antingen använda distributionsmallen från den tidigare artikeln, eller, om den inte passar, skriva en anpassad uppgiftsplanerare som på det sättet hanterar poolen av bearbetare.
Punkt 3 kräver en utvidgning av pub-sub-mallen. För att genomföra detta, efter att ha skapat en pub-sub-börspunkten, behöver vi också starta controllern för denna punkt inom vår tjänst. På så sätt flyttar vi logiken för prenumeration och avprenumeration från meddelandelagret till implementationen av användarna.
Som ett resultat visade nedbrytningen av uppgiften att för att uppfylla kraven behöver vi köra 5 instanser av tjänsten på olika noder och skapa en ytterligare entitet – en pub-sub-kontroller som ansvarar för prenumerationen.
För att starta 5 bearbetare krävs det inte att ändra koden för tjänsten. Den enda ytterligare åtgärden – konfigurera balansregler vid börspunkten, vilket vi kommer att diskutera lite senare.
Det uppstod också en ytterligare svårighet: pub-sub-kontrollern och den anpassade uppgiftsplaneraren måste arbeta i en enda instans. Återigen måste meddelandetjänsten, som är fundamental, ge en mekanism för att välja en ledare.
Val av ledare
I distribuerade system är valet av ledare – proceduren att utse en enda process som ansvarar för att planera distribuerad bearbetning av viss belastning.
I system som inte är benägna till centralisering tillämpas universella algoritmer och algoritmer baserade på konsensus, såsom paxos eller raft.
Eftersom meddelandetjänsten är en broker och en central komponent, känner den till alla kontroller av tjänsten – kandidaterna till ledare. Meddelandetjänsten kan utse en ledare utan att hålla omröstning.
Alla tjänster får efter start och anslutning till börspunkten ett systemmeddelande #'$leader'{exchange = ?EXCHANGE, pid = LeaderPid, servers = Servers}. Om LeaderPid överensstämmer med pid den aktuella processen, utses den som ledare, och listan Servers inkluderar alla noder och deras parametrar.
Vid tillkomsten av en ny och avstängningen av en fungerande nod i klustret, mottar alla tjänstkontrollerare #'$slave_up'{exchange = ?EXCHANGE, pid = SlavePid, options = SlaveOpts} och #'$slave_down'{exchange = ?EXCHANGE, pid = SlavePid, options = SlaveOpts} respektive.
På så sätt känner alla komponenter till alla förändringar, och i klustret garanteras det att en ledare finns vid varje given tidpunkt.
Medlare
För att implementera komplexa distribuerade processer för bearbetning samt för att optimera redan befintlig arkitektur är det praktiskt att använda medlare.
För att undvika att ändra tjänsternas kod och hantera till exempel uppgifter för ytterligare bearbetning, ruttning eller loggning av meddelanden, kan en proxybehandlare inkluderas framför tjänsten, som utför hela det ytterligare arbetet.
Ett klassiskt exempel på optimering av pub-sub är en distribuerad applikation med en affärskärna som genererar uppdateringshändelser, som förändringar i marknadspriser, och åtkomstlagret — N servrar som tillhandahåller websocket-API för webklienter.
Om vi löser det ”rakt på” ser kundservicen ut som följer:
- kunden upprättar anslutningar med plattformen. På serversidan, där trafiken termineras, startar en process som hanterar denna anslutning.
- i kontexten av den hanterande processen sker autentisering och prenumeration på uppdateringar. Processen anropar subscribe-metoden för ämnena.
- Efter att händelsen har genererats i kärnan, levereras den till processerna som hanterar anslutningarna.
Låt oss föreställa oss att vi har 50000 prenumeranter på ämnet "nyheter". Prenumeranterna är jämnt fördelade över 5 servrar. Som ett resultat kommer varje uppdatering som når bytespunkten att replikeras 50000 gånger: 10000 gånger på varje server, baserat på antalet prenumeranter på den. Inte riktigt en effektiv lösning, eller hur?
För att förbättra situationen kommer vi att införa en proxy som har samma namn som bytespunkten. Den globala namnregistratorn måste kunna returnera den närmaste processen efter namn, vilket är viktigt.
Vi startar denna proxy på åtkomstservrarna, och alla våra processer som hanterar websocket-API kommer att prenumerera på den, istället för på den ursprungliga pub-sub bytespunkten i kärnan. Proxyen prenumererar på kärnan endast vid unik prenumeration och replikar meddelandet som kommit in till alla sina prenumeranter.
Som ett resultat kommer 5 meddelanden att skickas mellan kärnan och åtkomstservrarna istället för 50000.
Routing och lastbalansering
Req-Resp
I den aktuella implementationen av messaging finns det 7 strategier för fördelning av förfrågningar:
default. Begäran skickas till alla kontrollerare.round-robin. Det sker en iteration och cyklisk distribution av begärningar mellan kontrollerarna.konsensus. Kontrollerarna som betjänar tjänsten delas upp i en ledare och följare. Begärningar skickas endast till ledaren.konsensus & rundrobin. I gruppen finns det en ledare, men begärningarna distribueras mellan alla medlemmar.sticky. En hash-funktion beräknas och knyts till en specifik behandlare. Efterföljande begärningar med denna signatur går till samma behandlare.sticky-fun. Vid initialisering av meddelandepunkten skickas en hashberäkningsfunktion ytterligare förstickybalansering.kul. Liknande sticky-fun, men kan också vidarebefordra, avvisa eller förbearbeta.
Strategin för distribution anges vid initialisering av meddelandepunkten.
Förutom balansering möjliggör messaging att tagga enheter. Låt oss överväga typer av taggar i systemet:
- Anslutningstag. Gör det möjligt att förstå genom vilken anslutning händelserna kom. Används när kontrollerprocessen kopplar till en meddelandepunkt, men med olika routingnycklar.
- Tjänstag. Gör det möjligt att gruppera behandlare för en tjänst och utöka routing- och balanseringsmöjligheterna. För req-resp-mönstret är routing linjär. Vi skickar en begäran till meddelandepunkten, som sedan vidarebefordrar den till tjänsten. Men om vi behöver dela upp behandlarna i logiska grupper, görs uppdelningen med hjälp av taggar. Genom att ange en tagg riktas begäran till en specifik grupp operatörer.
- Begärningstag. Gör det möjligt att särskilja svar. Eftersom vårt system är asynkront måste man kunna ange RequestTag vid skickandet av en begäran för att kunna hantera svaren från tjänsten. Genom den kan vi förstå vilket svar som kom till oss.
Pub-sub
För pub-sub är det lite enklare. Vi har en meddelandepunkt till vilken meddelanden publiceras. Meddelandepunkten distribuerar meddelanden mellan prenumeranterna som prenumererat på de routingnycklar som de behöver (man kan säga att detta är en analogi till teman).
Skalbarhet och driftssäkerhet
Skalbarheten i systemet som helhet beror på graden av skalbarhet i lagren och komponenterna i systemet:
- Tjänster skalas genom att lägga till fler noder med servicehanterare i klustret. Under erfaren drift kan man välja den optimala belastningsbalanseringspolitiken.
- Messagingtjänsten inom ett separat kluster skalas i allmänhet antingen genom att särskilt belastade utbyten flyttas till separata klusternoder eller genom att lägga till proxyprocesser i särskilt belastade områden av klustret.
- Systemets skalbarhet som en egenskap beror på flexibiliteten i arkitekturen och möjligheten att kombinera separata kluster till en enhetlig logisk entitet.
Framgången för ett projekt beror ofta på enkelheten och hastigheten i skalning. Messaging i sin nuvarande implementering växer tillsammans med applikationen. Även om vi inte har tillräckligt med kluster med 50-60 maskiner kan vi återgå till federation. Tyvärr faller ämnet federation utanför ramen för denna artikel.
Reservkraft
Vid diskussionen om belastningsbalansering har vi redan talat om reservcontroller för tjänster. Men messaging måste också vara reserverat. Vid en nod- eller maskinfel måste messaging automatiskt återställas, och det ska ske så snabbt som möjligt.
I mina projekt använder jag extra noder som tar över belastningen vid ett fel. I Erlang finns det en standardimplementation av distribuerat läge för OTP-appar. Det distribuerade läget genomför just återställning vid fel genom att starta den kraschade applikationen på en annan förhandsstartad nod. Processen är transparent, efter ett fel flyttas applikationen automatiskt till en failover-nod. Du kan läsa mer om denna funktionalitet. .
Performance
Låt oss försöka jämföra prestandan mellan rabbitmq och vår anpassade messaging.
Jag har hittat av rabbitmq-testningen utförd av openstack-teamet.
I punkt 6.14.1.2.1.2.2 i det ursprungliga dokumentet presenteras resultatet av RPC CAST:
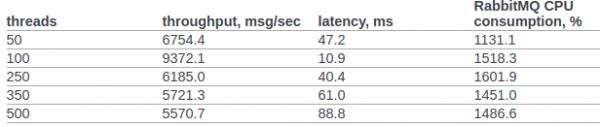
Det kommer inte att göras några ytterligare inställningar i OS-kärnan eller Erlang VM. Villkor för testning:
- erl opts: +A1 +sbtu.
- Testet i ett enda Erlang-nod körs på en gammal bärbar dator med en mobil i7.
- Klustertester genomförs på servrar med 10G-nätverk.
- Koden körs i dockercontainrar. Nätverket fungerar i NAT-läge.
Testkoden:
req_resp_bench(_) ->
  W = perftest:comprehensive(10000,
    fun() ->
      messaging:request(?EXCHANGE, default, ping, self()),
      receive
        #'$msg'{message = pong} -> ok
      after 5000 ->
        throw(timeout)
      end
    end
  ),
  true = lists:any(fun(E) -> E >= 30000 end, W),
  ok.
Scenario 1: Testet körs på en laptop med en gammal bärbar i7. Testet, messaging och tjänsten körs på samma nod i en docker-container:
Sekventiella 10000 cykler på ~0 sekunder (26987 cykler/s)
Sekventiella 20000 cykler på ~1 sekunder (26915 cykler/s)
Sekventiella 100000 cykler på ~4 sekunder (26957 cykler/s)
Parallella 2 100000 cykler på ~2 sekunder (44240 cykler/s)
Parallella 4 100000 cykler på ~2 sekunder (53459 cykler/s)
Parallella 10 100000 cykler på ~2 sekunder (52283 cykler/s)
Parallella 100 100000 cykler på ~3 sekunder (49317 cykler/s)
Scenario 2: 3 noder som körs på olika maskiner under docker (NAT).
Sekventiella 10000 cykler på ~1 sekunder (8684 cykler/s)
Sekventiella 20000 cykler på ~2 sekunder (8424 cykler/s)
Sekventiella 100000 cykler på ~12 sekunder (8655 cykler/s)
Parallella 2 100000 cykler på ~7 sekunder (15160 cykler/s)
Parallella 4 100000 cykler på ~5 sekunder (19133 cykler/s)
Parallella 10 100000 cykler på ~4 sekunder (24399 cykler/s)
Parallella 100 100000 cykler på ~3 sekunder (34517 cykler/s)
I alla fall översteg CPU-användningen inte 250%
Sammanfattning
Jag hoppas att denna cykel inte verkar som en hjärndump och att min erfarenhet kommer att vara av verklig nytta både för forskare inom distribuerade system och praktiker som står i början av sin väg att bygga distribuerade arkitekturer för sina affärssystem och som med intresse ser på Erlang/Elixir men tvekar om det är värt det...
Foto
Endast registrerade användare kan delta i omröstningen. , tack.
Vilka ämnen bör jag belysa mer detaljerat inom ramen för cykeln 'Experiment VTrade'?
Teori: Marknader, order och deras giltighetstid: DAY, GTD, GTC, IOC, FOK, MOO, MOC, LOO, LOC
Orderbok. Teori och praktik av genomförande av en bok med grupperingar
Visualisering av handel: Tickar, staplar, upplösningar. Hur man lagrar och hur man klistrar ihop
Backoffice. Planering och utveckling. Övervakning av anställda och utredning av incidenter
API. Vi går igenom vilka gränssnitt som behövs och hur man implementerar dem
Informationslagring: PostgreSQL, Timescale, Tarantool i handelssystem
Reaktivitet i handelssystem
Annat. Jag skriver i kommentarerna
6 användare röstade. 4 användare avstod.
Källa: habr.com
