

Trots att det idag finns mycket data nästan överallt, är analytiska databaser fortfarande ganska exotiska. De är dåligt kända och ännu sämre används effektivt. Många fortsätter att "äta kaktus" med MySQL eller PostgreSQL, som är designade för andra scenarier, eller sliter med NoSQL, eller betalar för mycket för kommersiella lösningar. ClickHouse ändrar spelreglerna och sänker avsevärt tröskeln för att komma in i världen av analytiska DBMS.
Rapporten från BackEnd Conf 2018 och den publiceras med talarens tillstånd.
Vem är jag och varför berättar jag om ClickHouse? Jag är utvecklingschef på LifeStreet, som använder ClickHouse. Dessutom är jag grundare av Altinity. Detta är en partner till Yandex, som främjar ClickHouse och hjälper Yandex att göra ClickHouse mer framgångsrikt. Jag är också villig att dela med mig av kunskapen om ClickHouse.
Och förresten, jag är inte bror till Petya Zaitsev. Jag får ofta frågor om detta. Nej, vi är inte bröder.
«Alla vet», att ClickHouse:
- Är mycket snabb,
- Är mycket användarvänlig,
- Används i Yandex.
Lite mindre känt är vilka företag och hur det används.
Jag ska berätta för er varför, var och hur ClickHouse används, förutom Yandex.
Jag kommer att berätta hur specifika uppgifter löses med ClickHouse i olika företag, vilka verktyg ClickHouse ni kan använda för era uppgifter, och hur de har använts i olika företag.
Jag har valt tre exempel som visar ClickHouse från olika sidor. Jag tror att det kommer att vara intressant.
Första frågan: «Varför behövs ClickHouse?». Frågan verkar ganska uppenbar, men det finns fler än ett svar.
- Det första svaret handlar om prestanda. ClickHouse är mycket snabb. Analys på ClickHouse är också mycket snabb. Det kan ofta användas där något annat fungerar mycket långsamt eller mycket dåligt.
- Det andra svaret handlar om kostnad. Och framför allt kostnaden för skalning. Till exempel är Vertica en helt utmärkt databas. Den fungerar mycket bra om ni har en ganska liten mängd terabyte data. Men när det handlar om hundratals terabyte eller petabyte, blir kostnaden för licens och support en ganska betydande summa. Och det är dyrt. Men ClickHouse är gratis.
- Det tredje svaret är driftskostnaden. Det här angreppssättet kommer lite från en annan sida. RedShift är ett utmärkt alternativ. Med RedShift kan man snabbt skapa en lösning. Det kommer att fungera bra, men varje timme, varje dag och varje månad kommer du att betala ganska mycket till Amazon, eftersom det är en mycket dyr tjänst. Google BigQuery är detsamma. Om någon har använt det vet man att man kan köra flera förfrågningar och plötsligt få en räkning på hundratals dollar.
I ClickHouse finns dessa problem inte.
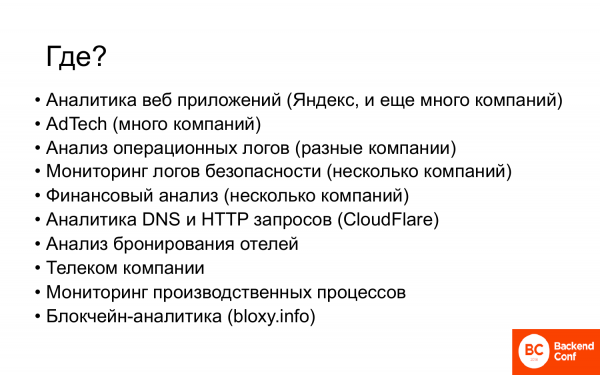
Var används ClickHouse nu? Förutom Yandex används ClickHouse i en mängd olika företag och verksamheter.
- Framför allt används det för analys av webbapplikationer, det vill säga det är ett användningsfall som kommer från Yandex.
- Många AdTech-företag använder ClickHouse.
- Många företag som behöver analysera driftsloggar från olika källor.
- Flera företag använder ClickHouse för övervakning av säkerhetsloggar. De laddar upp dem till ClickHouse, gör rapporter och får de resultat de behöver.
- Företag börjar använda det för finansiell analys, det vill säga gradvis närmar sig stora företag också ClickHouse.
- CloudFlare. Om någon följer ClickHouse har man säkert hört namnet på detta företag. Det är en av de betydande bidragsgivarna i communityn. Och de har en mycket seriös ClickHouse-installation. Till exempel har de skapat Kafka Engine för ClickHouse.
- Telekomföretag har börjat använda det. Flera företag använder ClickHouse antingen som proof of concept eller redan i produktion.
- Ett företag använder ClickHouse för att övervaka produktionsprocesser. De testar chips, registrerar massor av parametrar, det handlar om cirka 2 000 egenskaper. Och de analyserar vidare – bra partier eller dåliga.
- Blockkedjeanalys. Det finns ett sådant ryskt företag som Bloxy.info. Det handlar om analys av ethereum-nätverket. Det gjorde de också med ClickHouse.
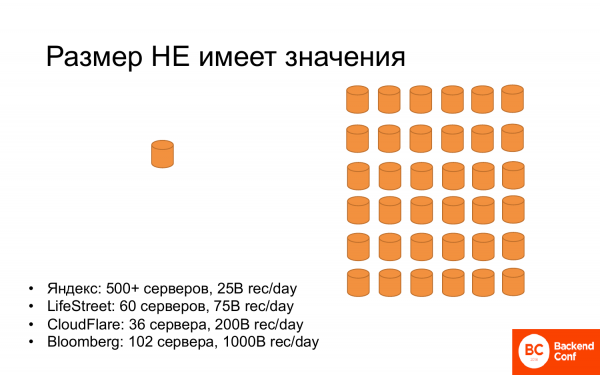
Och storleken spelar ingen roll. Många företag använder en enda liten server. Och den gör det möjligt för dem att lösa sina problem. Och ännu fler företag använder stora kluster av många servrar eller tiotals servrar.
Och om man ser på registreringarna, så:
- Yandex: 500+ servrar, de sparar 25 miljarder poster per dag där.
- LifeStreet: 60 servrar, cirka 75 miljarder poster per dag. Färre servrar, fler poster än hos Yandex.
- CloudFlare: 36 servrar, de sparar 200 miljarder poster per dag. De har ännu färre servrar och ännu mer data som de sparar.
- Bloomberg: 102 servern, cirka en biljon poster per dag. Rekordhållare för poster.
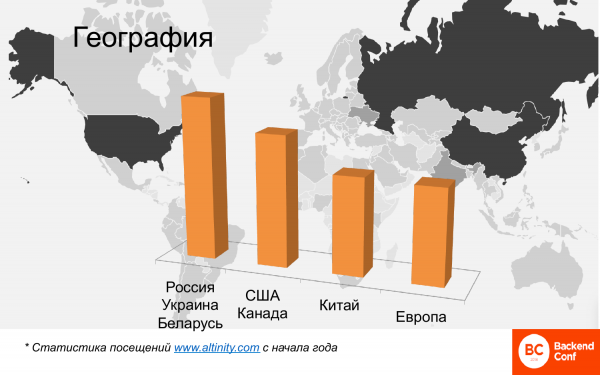
Geografiskt sett är det också mycket. Denna karta visar heatmap där ClickHouse används i världen. Här framhävs Ryssland, Kina, Amerika tydligt. Det finns få europeiska länder. Man kan särskilja 4 kluster.
Detta är en jämförande analys, här behöver man inte leta efter absoluta siffror. Detta är en analys av besökare som läser engelskspråkigt material på Altinitys webbplats, eftersom det inte finns något ryskspråkigt där. Ryssland, Ukraina, Vitryssland, dvs. den rysktalande delen av samhället, är de mest talrika användarna. Därefter följer USA och Kanada. Kina är snabbt på väg ikapp. För sex månader sedan fanns det nästan inget Kina, nu har Kina redan överträffat Europa och fortsätter växa. Gamla Europa hänger inte heller efter, och ledaren för användning av ClickHouse är, märkligt nog, Frankrike.
Varför berättar jag allt detta? För att visa att ClickHouse blir en standardlösning för analys av stora data och används redan på många ställen. Om du använder det, är du på rätt trend. Om du ännu inte använder det, behöver du inte vara rädd för att du kommer att bli ensam och ingen kommer att hjälpa dig, för många sysslar redan med detta.
Detta är exempel på verklig användning av ClickHouse i flera företag.
- Det första exemplet är ett annonsnätverk: migration från Vertica till ClickHouse. Och jag känner flera företag som har övergått från Vertica eller är i processen att göra det.
- Det andra exemplet är ett transaktionellt datalager på ClickHouse. Detta exempel bygger på antipatterns. Allt som inte bör göras i ClickHouse enligt utvecklarnas råd har här genomförts. Och det görs så effektivt att det fungerar. Och det fungerar mycket bättre än en typisk transaktionell lösning.
- Det tredje exemplet är distribuerade beräkningar på ClickHouse. Det fanns en fråga om hur ClickHouse kan integreras i Hadoop-ekosystemet. Jag kommer att visa ett exempel på hur ett företag gjorde något som liknar en map-reduce container på ClickHouse, med fokus på lokalisering av data, osv., för att beräkna en mycket icke-trivial uppgift.
- LifeStreet – Det är ett Ad Tech-företag som har allt teknologin som hör samman med ett annonsnätverk.
- Det sysslar med optimering av annonser, programmatisk budgivning.
- Mängder av data: omkring 10 miljarder händelser per dag. Händelserna kan dessutom delas upp i flera delhändelser.
- Många kunder av dessa data, och det är inte bara människor, utan mycket mer – det handlar om olika algoritmer som hanterar programmatisk budgivning.
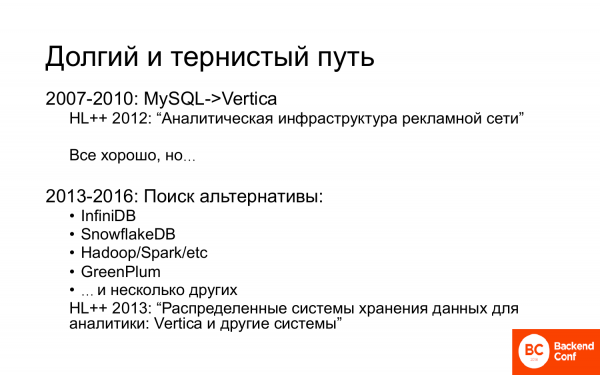
Företaget har genomgått en lång och svår väg. Jag har berättat om det på HighLoad. Först flyttade LifeStreet från MySQL (med ett kort stopp på Oracle) till Vertica. Det går att hitta berättelsen om detta.
Allt gick väldigt bra, men det blev snabbt tydligt att datamängderna växte och Vertica blev dyrt. Därför letades efter olika alternativ. Några av dem listas här. Faktum är att vi gjorde proof of concept eller ibland prestandatestning av nästan alla databaser som var tillgängliga på marknaden mellan 2013 och 2016 och som ungefär passade våra krav på funktionalitet. Jag berättade också om några av dem på HighLoad.
Uppgiften var att migrera från Vertica i första hand, eftersom datamängderna växte. Och de växte exponentiellt under flera år. Sedan nådde de en platå, men ändå. När vi prognostiserade denna tillväxt var det uppenbart att affärens krav på datamängder som behövde analyseras snart skulle handla om petabyte. Och att betala för petabyte är redan mycket dyrt, så vi letade efter alternativ för vart man skulle gå.
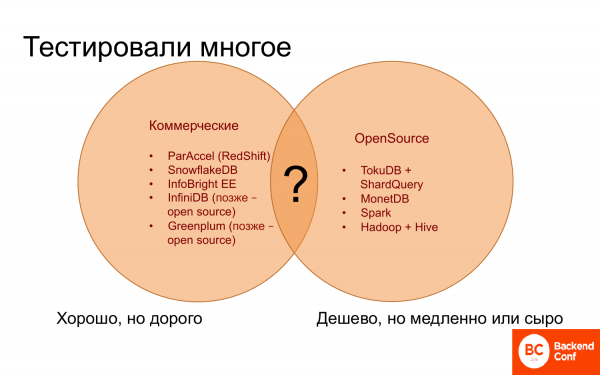
Vart skulle man gå? Under lång tid var det helt oklart vart man skulle ta vägen, eftersom det å ena sidan finns kommersiella databaser som fungerar ganska bra. Vissa fungerar nästan lika bra som Vertica, andra lite sämre. Men de är alla dyra, och ingenting billigare eller bättre har kunnat hittas.
Å andra sidan finns det open source-lösningar, som inte är så många, med andra ord kan de räknas på händerna när det gäller analys. De är gratis eller billiga, men fungerar långsamt. Oftast saknar de nödvändig och användbar funktionalitet.
Det fanns ingenting som kombinerade det bra som finns i kommersiella databaser och allt det gratis som finns i open source — ingenting fanns.
Ingenting fanns förrän plötsligt Yandex, som en trollkarl med en kanin ur hatten, presenterade ClickHouse. Det var en oväntad lösning; fortfarande idag ställs frågan: "Varför?", men ändå.
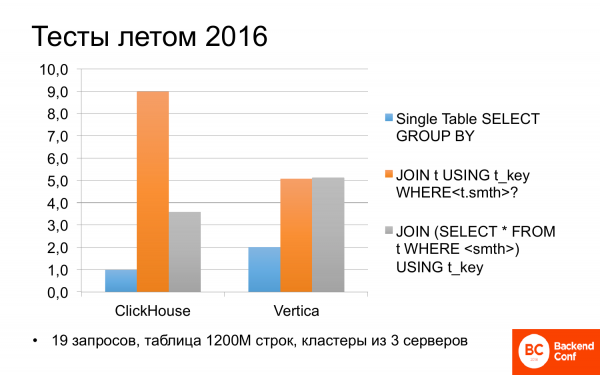
Och redan sommaren 2016 började vi titta på vad ClickHouse är. Och det visade sig att det ibland kan vara snabbare än Vertica. Vi testade olika scenarier med olika frågor. Och om frågan använde bara en tabell, dvs. utan några joins, var ClickHouse två gånger snabbare än Vertica.
Jag tog mig friheten att titta på mer tester från Yandex härom dagen. Där är det samma sak: ClickHouse är två gånger snabbare än Vertica, därför pratar de ofta om det.
Men om frågorna innehåller joins, så blir det inte så entydigt. Och ClickHouse kan vara långsammare än Vertica med två gånger. Men om man gör små justeringar av frågan och skriver om den, så blir det ungefär lika. Inte dåligt. Och gratis.
Så när vi fick testresultaten och såg på detta från olika vinklar, åkte LifeStreet över till ClickHouse.
Detta är 2016, påminner jag er. Det var som i en anekdot om möss som grät och stack sig, men fortsatte äta kaktus. Det har beskrivits utförligt, det finns video om det osv.
Jag kommer därför inte att gå in detaljerat på detta, jag kommer bara att berätta om resultaten och några intressanta saker som jag inte berättade då.
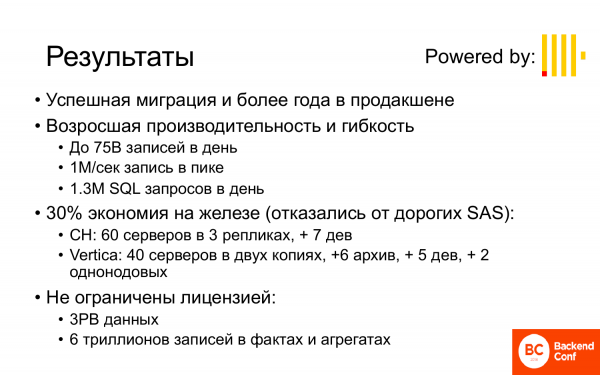
Resultaten är:
- Lyckad migrering och systemet har redan varit i produktion i mer än ett år.
- Prestanda och flexibilitet har ökat. Från 10 miljarder poster som vi kunde lagra på en dag, och det under en kort tid, lagrar LifeStreet nu 75 miljarder poster per dag och kan göra det i tre månader eller mer. Om man räknar på max, kan det sparas upp till en miljon händelser per sekund. Mer än en miljon SQL-frågor per dag kommer in i detta system, huvudsakligen från olika robotar.
- Trots att fler servrar används för ClickHouse än för Vertica, har vi sparat pengar på hårdvara eftersom Vertica använde ganska dyra SAS-diskar. I ClickHouse användes SATA. Och varför? För att i Vertica är insert synkront. Och synkronisering kräver att diskarna inte bromsar upp för mycket, och att nätverket inte heller bromsar, dvs. det är en ganska kostsam operation. Men i ClickHouse är insert asynkront. Dessutom kan man alltid skriva allt lokalt, inga extra kostnader för detta, så att data i ClickHouse kan infogas mycket snabbare än i Vertica även på inte de snabbaste diskarna. Och för läsning är det ungefär lika. Läsningen på SATA, om de sitter i RAID, är ganska snabb.
- Ingen licensbegränsningar, det vill säga 3 petabyte data på 60 servrar (20 servrar utgör en replik) och 6 triljoner poster i fakta och aggregat. Inget liknande kunde tillåtas på Vertica.
Nu går jag över till praktiska aspekter i detta exempel.
- Första är en effektiv schema. Schema påverkar mycket.
- Andra är generering av effektiv SQL.
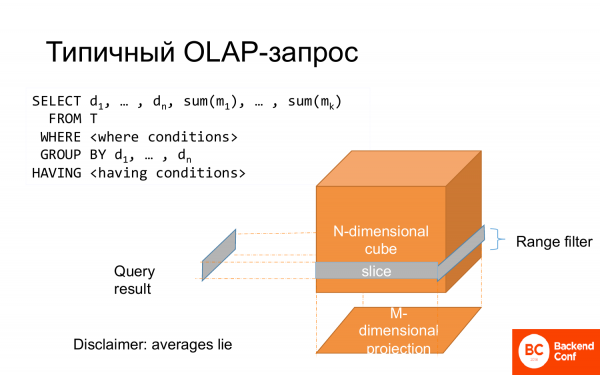
Typisk OLAP-fråga är en select. Vissa kolumner går i group by, andra kolumner går i aggregatfunktioner. Det finns where, som kan betraktas som ett snitt av kuben. Hela group by kan ses som en projektion. Därför kallas detta multidimensionell dataanalys.
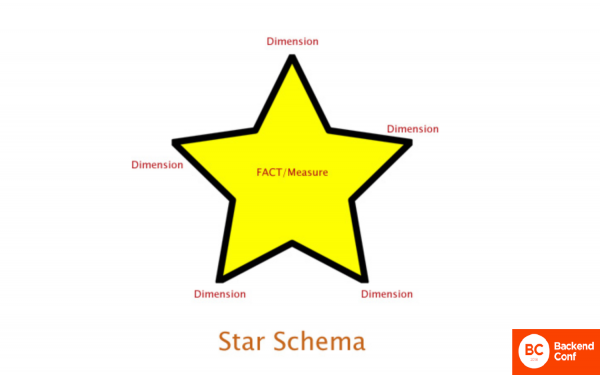
Och ofta modelleras detta som en stjärn-schema, där det finns en central fakta och egenskaper för detta fakta på sidorna, utefter strålar.
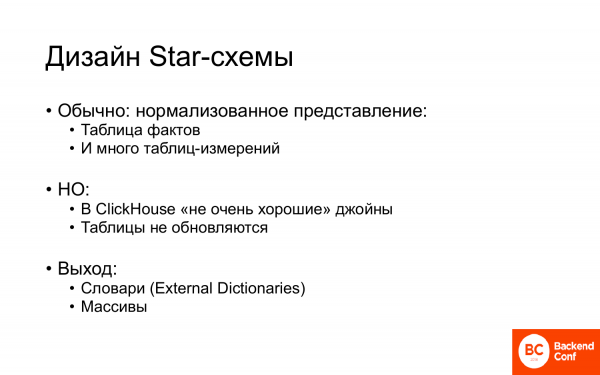
Och ur ett fysiskt designsynpunkt, hur detta läggs på tabeller, så görs vanligtvis en normaliserad representation. Du kan denormalisera, men det är kostsamt i disk och inte särskilt effektivt för frågor. Därför görs vanligtvis en normaliserad representation, det vill säga en faktatabell och många mångdimensionella tabeller.
Men i ClickHouse fungerar detta dåligt. Det finns två skäl:
- Första är att ClickHouse inte har särskilt bra joins, det vill säga joins finns, men de är dåliga. Fortfarande dåliga.
- Andra är att tabellerna inte uppdateras. Vanligtvis i dessa tabeller som omger stjärn-schema, behöver man ändra något. Till exempel, kundens namn, företagets namn och så vidare. Och detta fungerar inte.
Och det finns en lösning för detta i ClickHouse. Faktiskt två:
- Den första är att använda ordböcker. Externa ordböcker är det som hjälper till att lösa problemet med stjärn-schema till 99%, med uppdateringar och annat.
- Den andra är att använda arrayer. Arrayer hjälper också till att slippa joins och problem med normalisering.
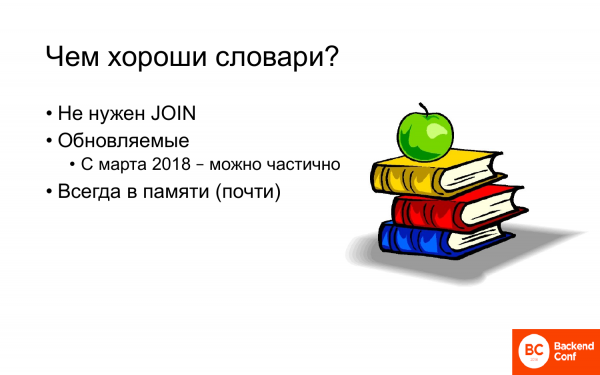
- Inga joins behövs.
- Uppdateringsbara. Från och med mars 2018 introducerades en icke-dokumenterad funktion (du hittar inte detta i dokumentationen) att delvis uppdatera ordböcker, det vill säga de poster som har ändrats. Praktiskt sett fungerar det som en tabell.
- Alltid i minnet, så joins med ordböcker fungerar snabbare än om det vore en tabell som ligger på disken och som kanske inte ens är i cache, sannolikt inte.
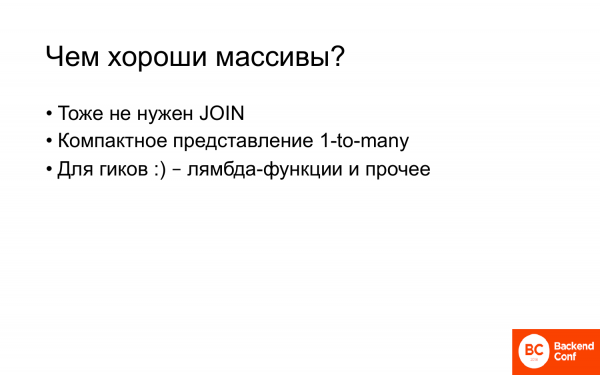
- Inga joins behövs heller.
- Detta är en kompakt representation 1 till många.
- Och enligt min åsikt, är arrayer skapade för nördar. Det handlar om lambda-funktioner och mer.
Det här är inget tomt prat. Det är en mycket kraftfull funktionalitet som gör att man kan göra många saker på ett mycket enkelt och elegant sätt.
Typiska exempel som hjälper till att hantera arrayer. Dessa exempel är enkla och ganska tydliga:
- Sökning efter taggar. Om du har hashtags där och vill hitta vissa poster med en hashtag.
- Sökning efter key-value-par. Det finns också vissa attribut med ett värde.
- Lagring av listor med nycklar som du behöver översätta till något annat.
Alla dessa uppgifter kan lösas utan arrayer. Taggar kan läggas i en sträng och väljas med ett reguljärt uttryck eller i en separat tabell, men då måste man göra joins.
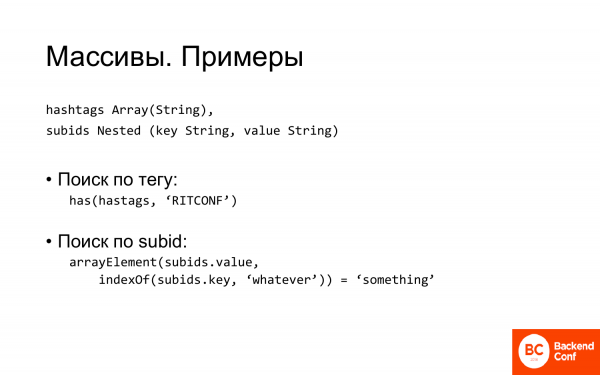
I ClickHouse behöver man inte göra något alls, det räcker med att beskriva en array string för hashtags eller skapa en inbäddad struktur för system som key-value.
Inbäddad struktur – kanske inte det mest lyckade namnet. Det är två arrayer med en gemensam del i namnet och vissa relaterade egenskaper.
Och att söka efter taggen är mycket enkelt. Det finns en funktion has, som kontrollerar om det finns ett element i arrayen. Allt, vi har hittat alla poster som rör vår konferens.
Sökning efter subid är lite mer komplicerad. Först måste vi hitta indexet för nyckeln, och sedan ta elementet med det indexet och kontrollera att värdet är det vi behöver. Men ändå mycket enkelt och kompakt.
Ett reguljärt uttryck som du skulle vilja skriva om du höll allting i en sträng skulle för det första vara klumpigt. För det andra skulle det ta mycket längre tid än två arrayer.
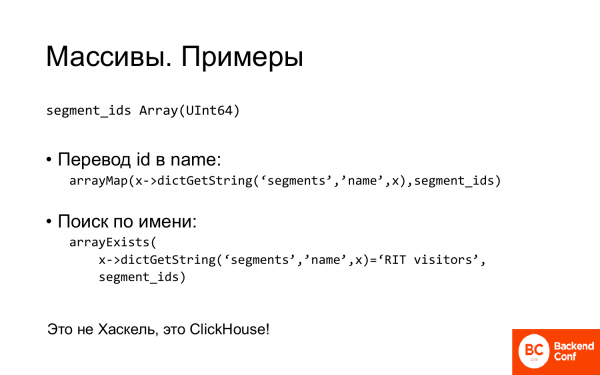
Ett annat exempel. Du har en array där du lagrar ID. Och du kan översätta dem till namn. Funktionen arrayMap. Det är en typisk lambda-funktion. Du skickar lambda-uttryck till den. Och den hämtar namnvärdet för varje ID från ordboken.
På liknande sätt kan man göra en sökning. En predikatfunktion skickas, som kontrollerar vilken överenskommelse elementen har.
Dessa saker förenklar schemat kraftigt och löser många problem.
Men nästa problem som vi stötte på och som jag vill nämna är effektiva förfrågningar.
- I ClickHouse finns det ingen förfrågningsplanerare. Överhuvudtaget ingen.
- Men ändå måste man planera komplexa förfrågningar. I vilka fall?
- Om det finns flera joinkommandon i en förfrågan som du kapslar in i delfrågor, är ordningen för hur de utförs viktig.
- För det andra, om förfrågan är distribuerad. För i en distribuerad förfrågan utförs endast den innersta delfrågan distribuerat, medan allt annat skickas till en server som du är ansluten till och utförs där. Så om du har distribuerade förfrågningar med många join, är det viktigt att välja rätt ordning.
Och även i enklare fall kan det ibland vara bra att göra schemaläggarens arbete och skriva om förfrågningen lite.
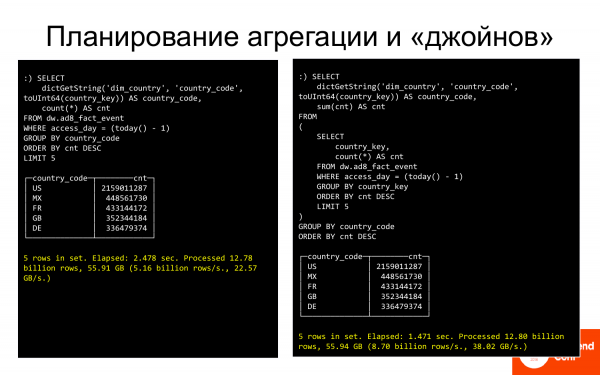
Här är ett exempel. På vänster sida en förfrågan som visar de fem bästa länderna. Den körs på 2,5 sekunder, om jag minns rätt. På höger sida samma förfrågan, men lite omskriven. Istället för att gruppera på strängar, grupperar vi på nycklar (int). Och det går snabbare. Sedan kopplade vi en ordbok till resultatet. Istället för 2,5 sekunder körs förfrågan på 1,5 sekunder. Det är bra.
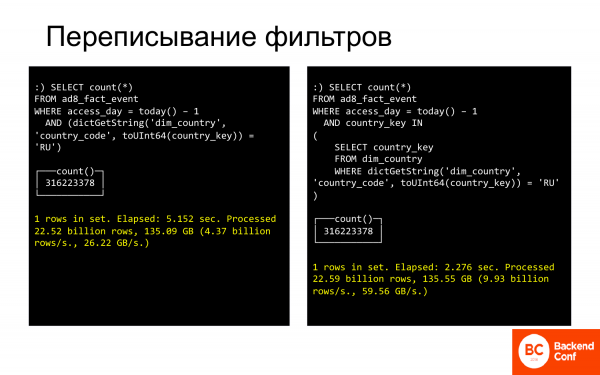
Ett liknande exempel med omformulering av filter. Här är en förfrågan om Ryssland. Den körs på 5 sekunder. Om vi skriver om den så att vi jämför siffror med en uppsättning av de nycklar som hör till Ryssland, kommer det att bli mycket snabbare.
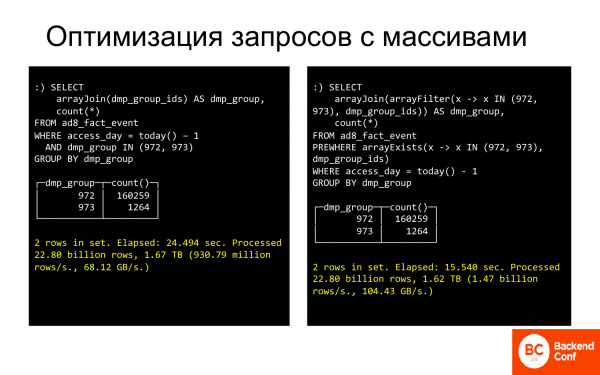
Det finns många sådana knep. Och de kan avsevärt snabba upp förfrågningar som du tror redan fungerar snabbt, eller tvärtom, som fungerar långsamt. De kan göras ännu snabbare.
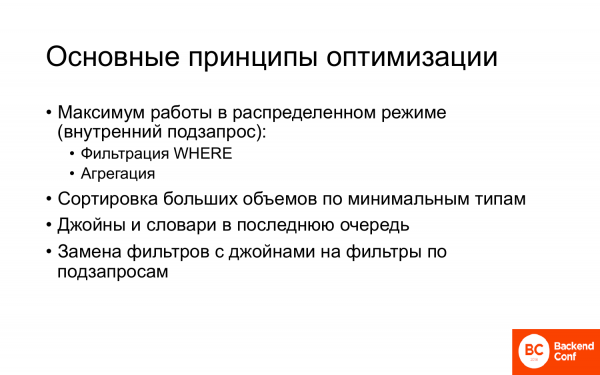
- Maximalt med arbete i distribuerat läge.
- Sortering efter de minsta typerna, som jag gjorde med ints.
- Om det finns några joins, ordböcker, är det bättre att utföra dem i sista hand, när du har data som åtminstone delvis är grupperad, så att joinoperationen eller anropet till ordboken kommer att krävas färre gånger och därmed gå snabbare.
- Ersättning av filter.
Det finns även andra tekniker, inte bara de jag demonstrerade. Och alla dessa kan ibland avsevärt snabba upp exekveringen av förfrågningar.
Vi går vidare till nästa exempel. Företag X från USA. Vad gör de?
Det fanns en uppgift:
- Offline-länkning av reklamtransaktioner.
- Modellering av olika länkningar.
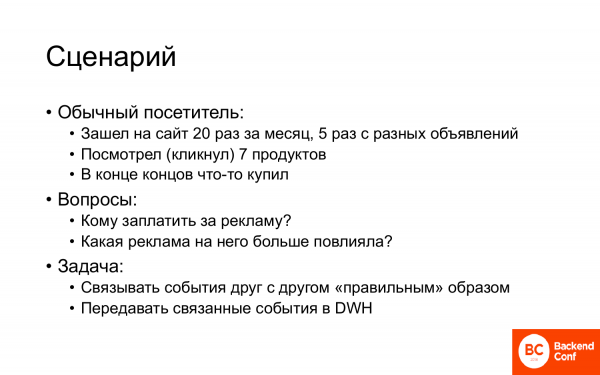
Vad består scenariot av?
En vanlig besökare går in på webbplatsen, till exempel 20 gånger i månaden, från olika annonser eller bara ibland utan annonser, eftersom de kommer ihåg sidan. De tittar på olika produkter, lägger dem i kundvagnen och tar sedan bort dem. Och till slut köper de något.
Rimliga frågor: 'Vem ska betala för annonseringen, om det behövs?' och 'Vilken annons påverkade dem, om den gjorde det?'. Det vill säga, varför köpte de och hur gör man för att människor som liknar denna person också skall köpa?
För att lösa denna uppgift måste man koppla samman händelser som inträffar på webbplatsen på rätt sätt, det vill säga bygga en relation mellan dem. Sedan måste de skickas för analys till DWH. Och på grundval av denna analys bygga modeller för vem och vilken annons som ska visas.
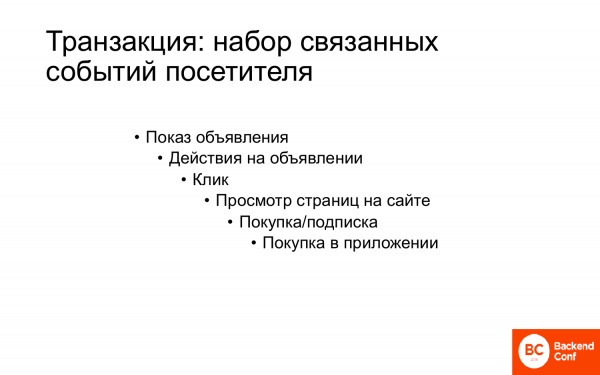
En reklamtransaktion är en uppsättning relaterade händelser för en användare som börjar med visning av en annons, sedan sker något, och eventuellt ett köp, och sedan kan det bli fler köp. Till exempel, om det handlar om en mobilapplikation eller ett mobilspel, så brukar installationen av appen ske gratis, men om det görs något mer där, kan det kräva pengar. Ju mer en person spenderar i appen, desto mer värdefull är de. Men för detta måste allt kopplas samman.
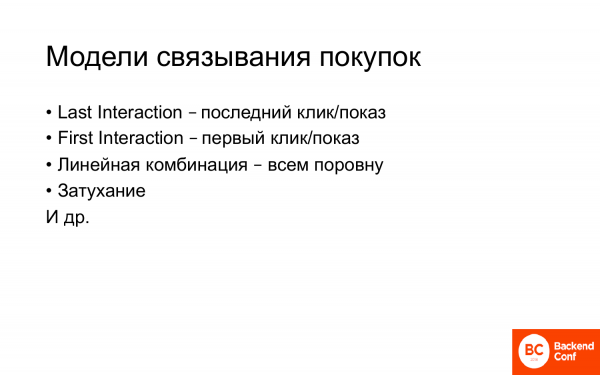
Det finns många modeller för att koppla samman.
De mest populära är:
- Last Interaction, där interaction är antingen ett klick eller en visning.
- First Interaction, det vill säga det första som ledde personen till webbplatsen.
- Linjär kombination – alla får lika.
- Avtagande.
- Och andra.
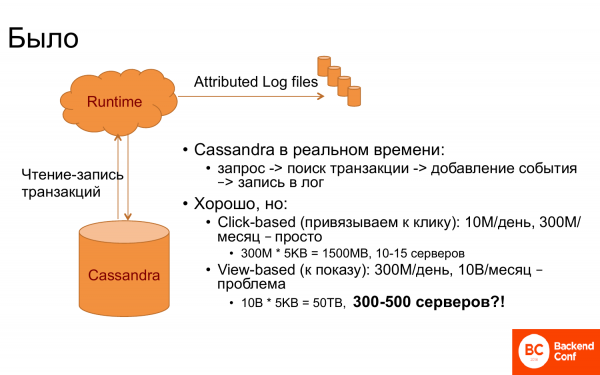
Och hur fungerade allt detta ursprungligen? Det fanns Runtime och Cassandra. Cassandra användes som transaktionslagring, det vill säga den lagrade alla relaterade transaktioner. När en händelse kom till Runtime, till exempel visning av en sida eller något annat, gjordes en förfrågan till Cassandra – finns denna person eller inte. Sedan hämtades transaktionerna som rör dem. Och kopplingen gjordes.
Och om man hade tur att förfrågan innehöll transaction id, var det lätt. Men vanligtvis har man inte tur. Därför behövde man leta efter den senaste transaktionen eller transaktionen med den senaste klicket och så vidare.
Och allt fungerade väldigt bra så länge kopplingen var till den senaste klickningen. För det finns det, säg, 10 miljoner klick om dagen, 300 miljoner per månad, om man sätter fönstret till en månad. Och eftersom det här måste finnas helt i minnet i Cassandra för att det ska fungera snabbt, eftersom det krävs en snabb Runtime-respons, behövdes ungefär 10-15 servrar.
Men när man ville koppla transaktionen till visningen så blev det genast inte lika roligt. Och varför? Det är tydligt att man behöver lagra 30 gånger fler händelser. Och därmed behövs 30 gånger fler servrar. Så det blir något astronomiskt siffror. Att ha upp till 500 servrar för att göra kopplingen, men att det faktiskt är betydligt färre servrar under Runtime, det är någon slags felaktig siffra. Så man började tänka på vad man skulle göra.
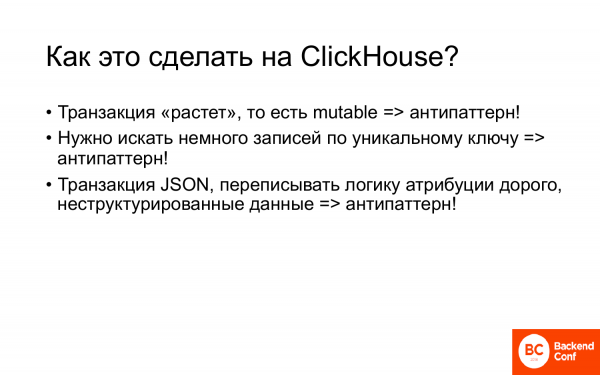
Och man kom till ClickHouse. Men hur gör man det på ClickHouse? Vid första anblick verkar det vara en uppsättning anti-mönster.
- Transaktionen växer, vi kopplar till den fler och fler händelser, dvs. den är muterbar, och ClickHouse fungerar inte särskilt bra med muterbara objekt.
- När en besökare kommer till oss, måste vi hämta dennes transaktioner med nyckeln, baserat på dennes besöks-ID. Det är också en punktfråga, vilket inte görs så i ClickHouse. Normalt i ClickHouse görs stora ...scanningar, men här måste vi hämta flera poster. Det är också ett anti-mönster.
- Dessutom var transaktionen i json, men man ville inte skriva om den, så man ville lagra json ostrukturerat, och om det behövdes, extrahera något från den. Och det är också ett anti-mönster.
Dvs. en uppsättning anti-mönster.
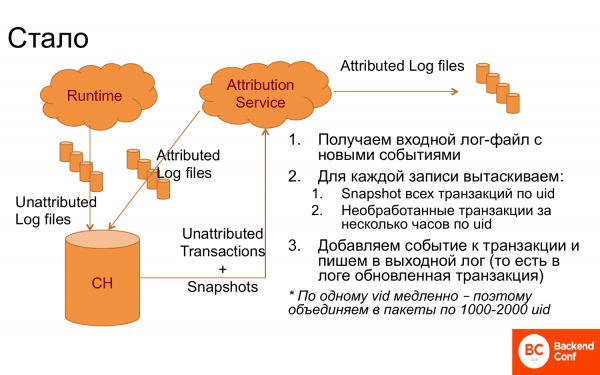
Men trots allt lyckades man skapa ett system som fungerade mycket bra.
Vad gjordes? ClickHouse infördes, dit loggar samlades i poster. En attributtjänst infördes som hämtade loggar från ClickHouse. Efter detta hämtade man transaktioner för varje post baserat på besöks-ID, som kanske ännu inte var färdigbehandlade, plus snapshotar, dvs. redan kopplade transaktioner, det vill säga resultatet av tidigare arbete. Från dem byggde man logik, valde rätt transaktion, kopplade nya händelser. Loggade på nytt i loggen. Loggen skickades tillbaka till ClickHouse, dvs. det är ett ständigt cykliskt system. Dessutom skickades den till DWH för analys.
Det fungerade inte så bra i den formen. För att göra det enklare för ClickHouse när det kom förfrågningar baserade på visit-id, grupperade vi dessa förfrågningar i block om 1 000-2 000 visit-id och hämtade alla transaktioner för 1 000-2 000 personer. Då fungerade allt.
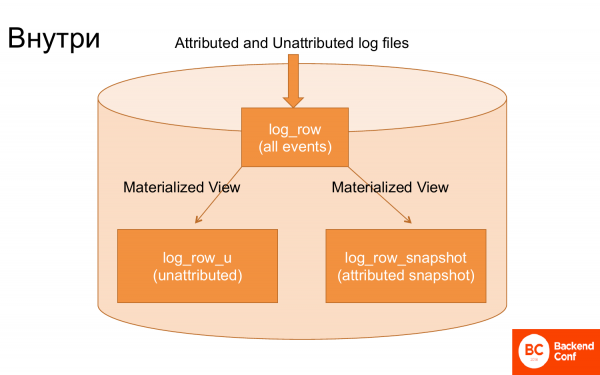
Om man tittar inuti ClickHouse finns det totalt 3 huvudtabeller som hanterar allt detta.
Den första tabellen dit loggarna laddas, och loggarna laddas nästan utan bearbetning.
Den andra tabellen. Genom en materialiserad vy extraherades de loggar som ännu inte fick tilldelade händelser, dvs. osammanhängande. Och genom den materialiserade vyn extraherades transaktionerna för att bygga en snapshot. Det vill säga, en speciell materialiserad vy byggde snapshoten, som var det senaste ackumulerade tillståndet av transaktionen.
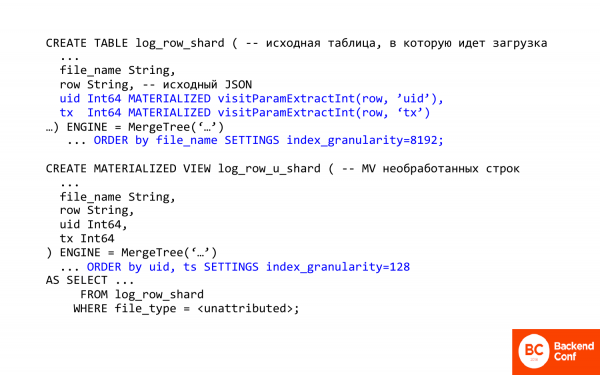
Här är texten skriven på SQL. Jag skulle vilja kommentera några viktiga punkter i den.
Den första viktiga punkten är möjligheten i ClickHouse att extrahera kolumner, fält från json. Det finns några metoder i ClickHouse för att arbeta med json. De är mycket, mycket primitiva.
visitParamExtractInt tillåter att extrahera attribut från json, dvs. första träffen aktiveras. Och på så sätt kan man hämta transaktions-id eller visit-id. Det är en.
Det andra – här används ett smart materialiserat fält. Vad innebär detta? Det betyder att du inte kan infoga det i tabellen, dvs. det infogas inte, det beräknas och lagras vid infogningen. Vid infogningen gör ClickHouse arbetet åt dig. Och det som senare behövs extraheras från json.
I det här fallet är den materialiserade vyn för obearbetade rader. Den använder första tabellen med nästan råa loggar. Vad gör den? För det första ändrar den sorteringen, dvs. sorteringen sker nu baserat på visit-id, eftersom vi snabbt behöver hämta just den specifika personens transaktion.
Den andra viktiga punkten är index_granularity. Om du har sett MergeTree är index_granularity normalt ställt på 8 192 som standard. Vad innebär detta? Det är en parameter för indexets sparsitet. I ClickHouse är indexet sparsam, det indexerar aldrig varje post. Det gör detta var 8 192. Detta är bra när mycket data ska räknas, men dåligt när det är lite, eftersom overheaden blir stor. Genom att minska index_granularity minskar vi overheaden. Det går inte att minska till ett eftersom minnet kan vara otillräckligt. Indexet lagras alltid i minnet.
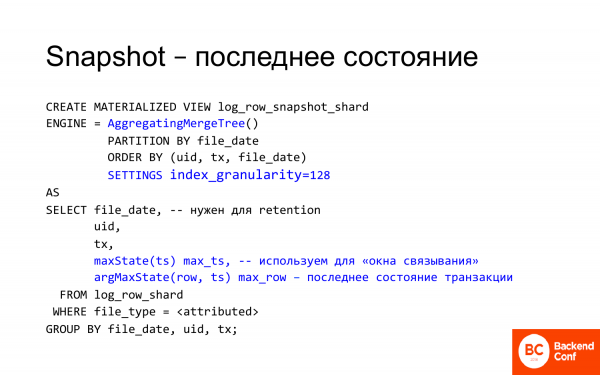
Snapshotet använder några intressanta funktioner från ClickHouse.
För det första, AggregatingMergeTree. I AggregatingMergeTree lagras argMax, dvs. det är tillståndet för transaktionen som motsvarar den senaste tidsstämpeln. Nya transaktioner genereras kontinuerligt för varje besökare. I det senaste tillståndet av den här transaktionen har vi lagt till en händelse och fått ett nytt tillstånd. Det hamnade åter i ClickHouse. Genom argMax i denna materialiserade vy kan vi alltid få den aktuella statusen.
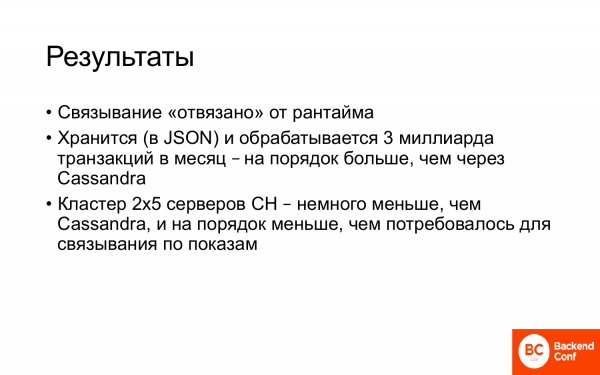
- Bindning 'frikopplad' från Runtime.
- Upp till 3 miljarder transaktioner lagras och bearbetas varje månad. Det är avsevärt mer än vad som var fallet med Cassandra, dvs. i ett typiskt transaktionssystem.
- En kluster av 2x5 ClickHouse-servrar. 5 servrar och varje server har en replika. Det är till och med färre än vad som krävdes i Cassandra för att göra click based atribuering, här har vi impression based. Det vill säga, istället för att öka antalet servrar 30 gånger, har de lyckats minska det.
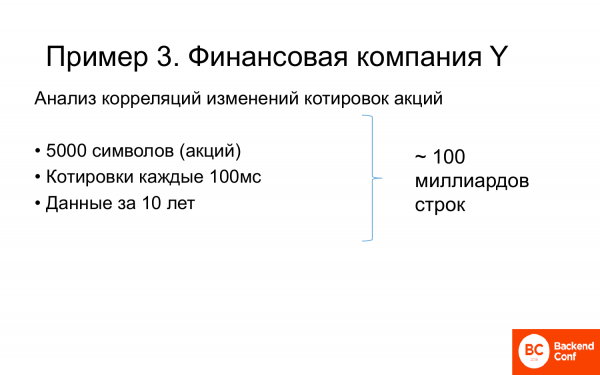
Och det sista exemplet – ett finansföretag Y som analyserade korrelationer i aktiekurser.
Och uppgiften var följande:
- Det finns ungefär 5 000 aktier.
- Kursen är känd var 100:e millisekund.
- Data har samlats in under 10 år. Tydligen har en del företag mer data, andra mindre.
- Totalt ungefär 100 miljarder rader.
Och man behövde beräkna korrelationen i förändringarna.
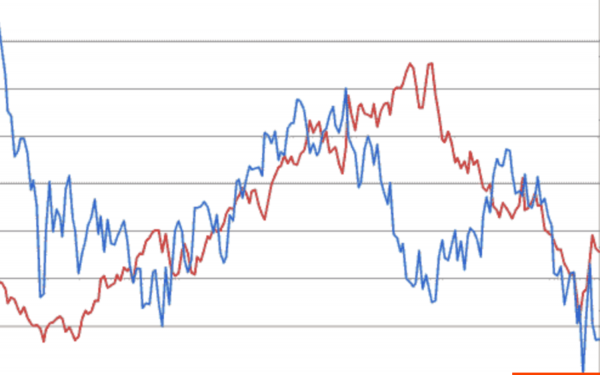
Här är två aktier och deras kurser. Om den ena går upp och den andra går upp, så är det en positiv korrelation, dvs. när den ena växer, växer den andra. Om den ena går upp, som i slutet av grafen, och den andra går ner, så är det en negativ korrelation, dvs. när den ena växer, faller den andra.
Genom att analysera dessa ömsesidiga förändringar kan man göra förutsägelser på den finansiella marknaden.
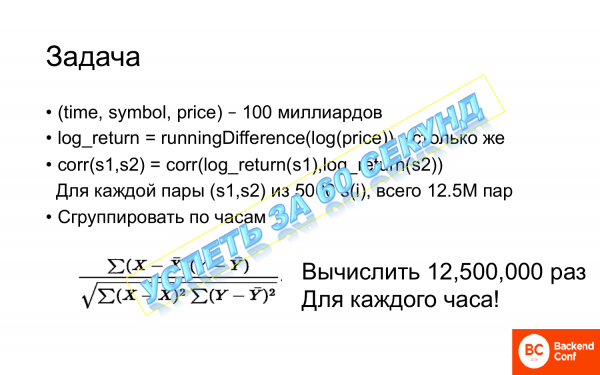
Men uppgiften är svår. Vad görs för detta? Vi har 100 miljarder poster som innehåller: tid, aktie och pris. Först måste vi beräkna 100 miljarder gånger runningDifference från algoritmen för priset. RunningDifference är en funktion i ClickHouse som beräknar skillnaden mellan två rader sekventiellt.
Därefter måste vi beräkna korrelationen, och korrelationen måste beräknas för varje par. För 5 000 aktier är paren 12,5 miljoner. Och det är mycket, dvs. 12,5 gånger måste vi beräkna en sådan korrelationsfunktion.
Och om någon har glömt, så är ͞x och ͞y – det matematiska förväntade värdet enligt urvalet. Det innebär att man inte bara måste beräkna rötter och summor, utan också beräkna ytterligare summor inom dessa summor. En massa beräkningar måste göras 12,5 miljoner gånger, och dessutom måste vi gruppera efter timmar. Vi har också många timmar. Och allt måste göras på 60 sekunder. Det är ett skämt.
Vi måste verkligen hinna med på något sätt, eftersom allt detta fungerade väldigt, väldigt långsamt, innan ClickHouse kom.
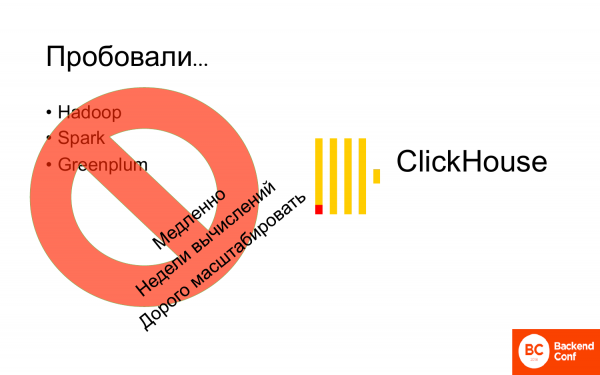
De försökte beräkna detta på Hadoop, på Spark, på Greenplum. Och allt var antingen mycket långsamt eller dyrt. Det vill säga, det gick att beräkna, men det blev senare dyrt.
Och sedan kom ClickHouse och allt blev mycket bättre.
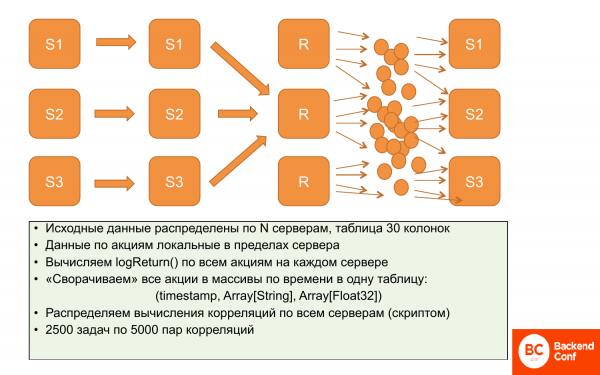
Jag påminner om att vårt problem handlar om datalokalitet, så korrelationerna kan inte lokaliseras. Vi kan inte samla en del av datan på en server, en annan del på en annan och beräkna, vi måste ha all data överallt.
Vad gjorde de? Ursprungligen var datan lokaliserad. På varje server lagrades data för prissättning av ett visst aktieutbud. Och de överlappar inte. Så man kan parallellt och oberoende beräkna logReturn, allt detta sker parallellt och distribuerat.
Därefter beslutade man att minska datamängden utan att förlora uttrycksfullheten. Minska det med hjälp av arrayer, det vill säga att för varje tidssegment skapa en array av aktier och en array av priser. På så sätt tar datan mycket mindre utrymme. Och det är mer bekvämt att arbeta med dem. Det är nästan parallella operationer, det vill säga vi beräknar delvis parallellt och skriver sedan till servern.
Efter detta kan det replikeras. Bokstaven «r» betyder att vi har replikerat dessa data. Det vill säga, vi har samma data på alla tre servrar – dessa arrayer.
Och sedan med ett speciellt skript från detta urval av 12,5 miljoner korrelationer som måste beräknas, kan man göra paket. Det vill säga, 2 500 uppgifter med 5 000 par korrelationer. Och denna uppgift beräknas på en specifik ClickHouse-server. Den har all data, eftersom datan är identisk och den kan beräkna dem sekventiellt.
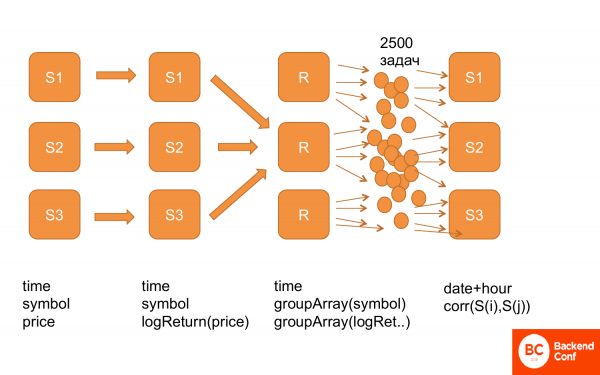
Ännu en gång, hur det ser ut. Först har vi alla data i följande struktur: tid, aktier, pris. Sedan beräknade vi logReturn, det vill säga data i samma struktur, men istället för pris har vi nu logReturn. Därefter omarbetade vi dem, det vill säga vi fick tid och groupArray för aktier och priser. Vi replikerade dem. Och efter detta genererade vi en mängd uppgifter och matade ClickHouse så att den kunde räkna dem. Och det fungerar.
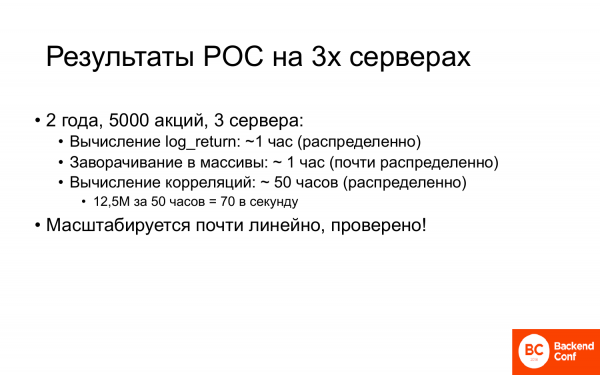
På proof of concept-uppgiften var det en deluppgift, det vill säga vi tog mindre data. Och allt på tre servrar.
De första två stegen: beräkning av log_return och inpackning i arrayer tog ungefär en timme vardera.
Beräkningen av korrelationen tog cirka 50 timmar. Men 50 timmar är lite, eftersom det tidigare tog dem veckor. Det var en stor framgång. Och om man räknar så beräknades allt 70 gånger per sekund på detta kluster.
Men det viktigaste är att detta system praktiskt taget är utan flaskhalsar, det vill säga det skalas nästan linjärt. Och de har verifierat det. Framgångsrikt skalade de det.
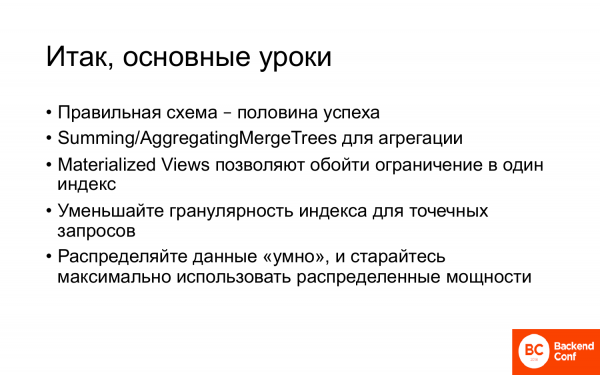
- En korrekt struktur är hälften av framgången. Och en korrekt struktur innebär användning av alla nödvändiga ClickHouse-teknologier.
- Summing/AggregatingMergeTrees är teknologier som möjliggör aggregering eller beräkning av snapshot-state som ett särskilt fall. Och det förenklar många saker avsevärt.
- Materialized Views gör det möjligt att kringgå begränsningen med en index. Kanske uttryckte jag mig inte så tydligt, men när vi laddade loggar, var de råa loggarna i en tabell med ett index, medan på attributloggarna var de i en tabell, det vill säga samma data, bara filtrerade, men indexet var helt annat. Det verkar som samma data, men olika sortering. Och Materialized Views gör det möjligt, om du behöver det, att kringgå sådana begränsningar i ClickHouse.
- Minska indexets granuläritet för punktförfrågningar.
- Och fördela data smart, försök att maximalt lokalisera data inom servern. Och se till att förfrågningar också använder lokaliseringen där det är möjligt.
Sammanfattningsvis kan man säga att ClickHouse nu har etablerat sig inom både kommersiella databaser och open source-databaser, dvs. främst för analytiska syften. Det passar utmärkt in i detta landskap. Dessutom börjar det sakta men säkert att tränga undan andra alternativ, eftersom du inte behöver InfiniDB när du har ClickHouse. Vertica kan snart bli overflödig om de inte förbättrar sitt SQL-stöd. Använd det!
—Tack för presentationen! Mycket intressant! Har det gjorts några jämförelser med Apache Phoenix?
- Nej, jag har inte hört att någon har gjort sådana jämförelser. Vi på Yandex försöker hålla koll på alla jämförelser mellan ClickHouse och olika databaser. För om det någon gång visar sig att något är snabbare än ClickHouse, kan Aleksej Milovidov inte sova om nätterna och börjar snabbt öka hastigheten. Jag har inte hört talas om en sådan jämförelse.
(Aleksej Milovidov) Apache Phoenix är en SQL-motor på HBase. HBase är huvudsakligen avsedd för nyckel-värde-arbetsflöden. Varje rad kan ha ett godtyckligt antal kolumner med godtyckliga namn. Detta gäller också för system som HBase och Cassandra. Där fungerar inte tunga analytiska frågor särskilt bra. Eller så kan du tro att de fungerar bra om du inte har någon erfarenhet av ClickHouse.
Tack
God dag! Jag har redan varit ganska intresserad av detta ämne eftersom jag har ett analytiskt subsystem. Men när jag tittar på ClickHouse får jag intrycket att ClickHouse är väldigt bra för analys av händelser, mutable. Och om jag behöver analysera mycket affärsdata med massor av stora tabeller, passar ClickHouse, såvitt jag förstår, inte särskilt bra? Särskilt om de förändras. Stämmer det eller finns det exempel som kan motbevisa detta?
Det är sant. Och det gäller för merparten av specialiserade analytiska databaser. De är anpassade för en eller flera stora tabeller som är mutabla, och för många små som förändras långsamt. Det vill säga, ClickHouse fungerar inte som Oracle, där man kan lagra allt och bygga mycket komplexa frågor. För att effektivt använda ClickHouse måste man bygga schemat på ett sådant sätt som fungerar bra i ClickHouse. Det innebär att man ska undvika överdriven normalisering, använda ordböcker och försöka göra färre långa relationer. Om man bygger schemat på det här sättet kan man lösa liknande affärsproblem i ClickHouse mycket mer effektivt än i en traditionell relationsdatabas.
Tack för presentationen! Jag har en fråga angående det senaste finansiella fallet. De hade analys. Det var nödvändigt att jämföra hur det går upp och ner. Och jag förstår att ni byggde systemet just för den analysen? Om de imorgon till exempel skulle behöva en annan rapport baserad på dessa data, måste man bygga om schemat och ladda data igen? Det vill säga, göra någon form av förbearbetning för att få fram en fråga?
Självklart, det handlar om att använda ClickHouse för en mycket specifik uppgift. Den skulle mer traditionellt kunna lösas inom ramen för Hadoop. För Hadoop är det en perfekt uppgift. Men det är väldigt långsamt på Hadoop. Min avsikt är att visa att man kan lösa uppgifter på ClickHouse som vanligtvis hanteras med helt andra medel, men göra det mycket mer effektivt. Det är verkligen skräddarsytt för en specifik uppgift. Självklart, om det finns en liknande uppgift kan den lösas på liknande sätt.
Förstått. Ni sa att det tog 50 timmar. Är det från början, när data laddades eller när ni fick resultaten?
Ja, ja.
Bra, tack så mycket.
Det är på en 3-server kluster.
Hej! Tack för presentationen! Allt är väldigt intressant. Jag ska fråga lite mindre om funktionaliteten, utan mer om användningen av ClickHouse ur ett stabilitetsperspektiv. Har ni råkat ut för några problem, har ni behövt återställa? Hur beter sig ClickHouse i så fall? Och har ni någonsin upplevt att en replik också kraschar? Vi har, till exempel, stött på problemet med att ClickHouse ibland går över sina gränser och kraschar.
Självklart finns det inga perfekta system. Och ClickHouse har sina egna problem. Men har ni hört talas om att Yandex.Metrica har haft långvariga driftstopp? Antagligen inte. Den har fungerat pålitligt sedan ungefär 2012-2013 med ClickHouse. Jag kan också berätta om min erfarenhet. Vi har aldrig haft totala driftstopp. Vissa delvisa problem har kunnat uppstå, men de har aldrig varit kritiska nog för att påverka verksamheten seriöst. Sådant har aldrig hänt. ClickHouse är tillräckligt pålitligt och kraschar inte slumpmässigt. Man behöver inte oroa sig för det. Det är inget ofärdigt system. Det har bevisats av många företag.
Hej! Du sa att man måste tänka igenom datastrukturen noggrant från början. Men vad händer om det redan har inträffat? Jag har data som strömmar på. Det har gått sex månader, och jag inser att jag inte kan fortsätta så här; jag måste ladda om data och hantera dem på något sätt.
Det beror självklart på ditt system. Det finns flera sätt att göra detta praktiskt taget utan avbrott. Till exempel kan du skapa en Materialized View, där du skapar en annan databasstruktur, om den kan mappas entydigt. Det vill säga, om det tillåter mappning med hjälp av ClickHouse, det vill säga extrahera vissa saker, ändra primärnyckel, ändra partitionering, så kan du skapa en Materialized View. Du kan skriva över dina gamla data där, och nya kommer att skrivas automatiskt. Sedan kan du enkelt växla till att använda Materialized View, och därefter byta skrivning och ta bort den gamla tabellen. Det är verkligen ett sätt utan avbrott.
Tack.
Källa: habr.com
