

I denna studie ville jag titta på vilka prestandaförbättringar som kan uppnås genom att använda datakälla ClickHouse istället för PostgreSQL. Jag är medveten om de prestandafördelar jag får med ClickHouse. Kommer dessa fördelar att bevaras om jag får åtkomst till ClickHouse från PostgreSQL via en externa dataskal (FDW)?
De databasmiljöer som utforskas är PostgreSQL v11, clickhousedb_fdw och ClickHouse-databasen. I slutändan kommer vi att köra olika SQL-frågor från PostgreSQL v11 som dirigeras genom vår clickhousedb_fdw till ClickHouse-databasen. Sedan kommer vi att se hur FDW:s prestanda jämförs med samma frågor som körs i ren PostgreSQL och ren ClickHouse.
Databasen Clickhouse
ClickHouse är ett kolumnbaserat databashanteringssystem med öppen källkod som kan nå prestanda 100-1000 gånger snabbare än traditionella databaser, kapabel att hantera mer än en miljard rader på mindre än en sekund.
Clickhousedb_fdw
clickhousedb_fdw är en extern dataskal för ClickHouse-databasen, eller FDW, som är ett projekt med öppen källkod från Percona. .
.
Som du kommer att se ger det FDW för ClickHouse, vilket tillåter SELECT from och INSERT INTO ClickHouse-databasen från PostgreSQL v11-servern.
FDW stöder avancerade funktioner som aggregate och join. Detta ökar avsevärt prestandan genom att använda resurser från den fjärrservern för dessa resurskrävande operationer.
Benchmark-miljö
- Supermicro-server:
- Intel® Xeon® CPU E5-2683 v3 @ 2.00GHz
- 2 socklar / 28 kärnor / 56 trådar
- Minne: 256GB RAM
- Lagring: Samsung SM863 1.9TB Enterprise SSD
- Filsystem: ext4/xfs
- OS: Linux smblade01 4.15.0-42-generic #45~16.04.1-Ubuntu
- PostgreSQL: version 11
Benchmark-tester
Istället för att använda en maskin-skapad dataset för detta test använde vi data "Prestanda över tid, rapporterad om operatörens drifttid" från 1987 till 2018. Du kan få tillgång till datan .
Databasens storlek är 85 GB, vilket ger en tabell med 109 kolumner.
Benchmark-frågor
Här är frågorna jag använde för att jämföra ClickHouse, clickhousedb_fdw och PostgreSQL.
Q#
Frågan innehåller Aggregat och Group By
Q1
SELECT DayOfWeek, count(*) AS c FROM ontime WHERE Year >= 2000 AND Year <= 2008 GROUP BY DayOfWeek ORDER BY c DESC;
Q2
VÄLJ Dag i veckan, count(*) AS c FRÅN ontime DÄR DepDelay>10 OCH År >= 2000 OCH År <= 2008 GRUPPERA EFTER Dag i veckan BESTÄLL EFTER c DESC;
Q3
VÄLJ Ursprung, count(*) AS c FRÅN ontime DÄR DepDelay>10 OCH År >= 2000 OCH År <= 2008 GRUPPERA EFTER Ursprung BESTÄLL EFTER c DESC BEGRÄNSA TILL 10;
Q4
VÄLJ Frakt, count() FRÅN ontime DÄR DepDelay>10 OCH År = 2007 GRUPPERA EFTER Frakt BESTÄLL EFTER count() DESC;
Q5
VÄLJ a.Frakt, c, c2, c1000/c2 som c3 FRÅN ( VÄLJ Frakt, count() AS c FRÅN ontime DÄR DepDelay>10 OCH År=2007 GRUPPERA EFTER Frakt ) a INRE FÖRENING ( VÄLJ Frakt,count(*) AS c2 FRÅN ontime DÄR År=2007 GRUPPERA EFTER Frakt) b på a.Frakt=b.Frakt BESTÄLL EFTER c3 DESC;
Q6
VÄLJ a.Frakt, c, c2, c1000/c2 som c3 FRÅN ( VÄLJ Frakt, count() AS c FRÅN ontime DÄR DepDelay>10 OCH År >= 2000 OCH År = 2000 OCH År <= 2008 GRUPPERA EFTER Frakt ) b på a.Frakt=b.Frakt BESTÄLL EFTER c3 DESC;
Q7
VÄLJ Frakt, avg(DepDelay) * 1000 AS c3 FRÅN ontime DÄR År >= 2000 OCH År <= 2008 GRUPPERA EFTER Frakt;
Q8
VÄLJ År, avg(DepDelay) FRÅN ontime GRUPPERA EFTER År;
Q9
välj År, count(*) som c1 FRÅN ontime GRUPPERA EFTER År;
Q10
VÄLJ avg(cnt) FRÅN (VÄLJ År,Månad,count(*) AS cnt FRÅN ontime DÄR DepDel15=1 GRUPPERA EFTER År,Månad) a;
Q11
välj avg(c1) från (välj År,Månad,count(*) som c1 FRÅN ontime GRUPPERA EFTER År,Månad) a;
Q12
VÄLJ Ursprung stadsnamn, Dest stadsnamn, count(*) AS c FRÅN ontime GRUPPERA EFTER Ursprung stadsnamn, Dest stadsnamn BESTÄLL EFTER c DESC BEGRÄNSA TILL 10;
Q13
VÄLJ Ursprung stadsnamn, count(*) AS c FRÅN ontime GRUPPERA EFTER Ursprung stadsnamn BESTÄLL EFTER c DESC BEGRÄNSA TILL 10;
Frågan Innehåller Föreningar
Q14
VÄLJ a.År, c1/c2 FRÅN ( välj År, count()1000 som c1 FRÅN ontime DÄR DepDelay>10 GRUPPERA EFTER År) a INRE FÖRENING (välj År, count(*) som c2 FRÅN ontime GRUPPERA EFTER År ) b på a.År=b.År BESTÄLL EFTER a.År;
Q15
VÄLJ a.”År”, c1/c2 FRÅN ( välj “År”, count()1000 som c1 FRÅN fontime DÄR “DepDelay”>10 GRUPPERA EFTER “År”) a INRE FÖRENING (välj “År”, count(*) som c2 FRÅN fontime GRUPPERA EFTER “År” ) b på a.”År”=b.”År”;
Tabell-1: Frågor som används i benchmark
Frågeexekveringar
Här är resultaten för varje fråga när den kördes under olika inställningar av databasen: PostgreSQL med och utan index, egen ClickHouse och clickhousedb_fdw. Tiden visas i millisekunder.
Q#
PostgreSQL
PostgreSQL (Indexerad)
ClickHouse
clickhousedb_fdw
Q1
27920
19634
23
57
Q2
35124
17301
50
80
Q3
34046
15618
67
115
Q4
31632
7667
25
37
Q5
47220
8976
27
60
Q6
58233
24368
55
153
Q7
30566
13256
52
91
Q8
38309
60511
112
179
Q9
20674
37979
31
81
Q10
34990
20102
56
148
Q11
30489
51658
37
155
Q12
39357
33742
186
1333
Q13
29912
30709
101
384
Q14
54126
39913
124
1364212
Q15
97258
30211
245
259
Tabell-1: Tid som krävs för att köra de frågor som används i benchmark
Visa resultat
Grafen visar tiden för att köra frågan i millisekunder, X-axeln visar nummer på frågan från tabellerna ovan, och Y-axeln visar tiden för att köra i millisekunder. Resultaten från ClickHouse och data som erhållits från postgres med hjälp av clickhousedb_fdw visas. Tabellen visar att det finns en enorm skillnad mellan PostgreSQL och ClickHouse, men en minimal skillnad mellan ClickHouse och clickhousedb_fdw.
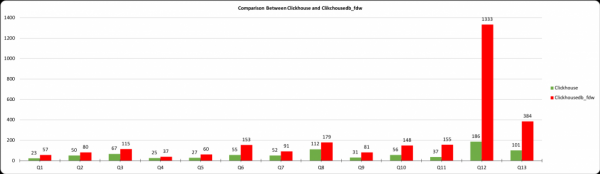
Denna graf visar skillnaden mellan ClickhouseDB och clickhousedb_fdw. För de flesta frågor är overheadkostnaderna för FDW inte så stora och knappt märkbara, förutom för Q12. Denna fråga inkluderar föreningar och ORDER BY-klausulen. På grund av ORDER BY GROUP/BY och ORDER BY hoppar inte ner till ClickHouse.
I tabell 2 ser vi en ökning av tiden för förfrågningarna Q12 och Q13. Jag upprepar, detta orsakas av ORDER BY-satsen. För att bekräfta detta har jag utfört förfrågningarna Q-14 och Q-15 med och utan ORDER BY-sats. Utan ORDER BY-satsen tar det 259 ms, medan det med ORDER BY tar 1364212 ms. För att felsöka denna förfrågan förklarar jag båda förfrågningarna, och här är resultaten av förklaringen.
Q15: Utan ORDER BY-sats
bm=# EXPLAIN VERBOSE SELECT a."Year", c1/c2
     FROM (SELECT "Year", count(*)*1000 AS c1 FROM fontime WHERE "DepDelay" > 10 GROUP BY "Year") a
     INNER JOIN(SELECT "Year", count(*) AS c2 FROM fontime GROUP BY "Year") b ON a."Year"=b."Year";
Q15: Förfrågan utan ORDER BY-sats
QUERY PLAN
Hash Join  (cost=2250.00..128516.06 rows=50000000 width=12)
Output: fontime."Year", (((count(*) * 1000)) / b.c2)
Inner Unique: true   Hash Cond: (fontime."Year" = b."Year")
->  Foreign Scan  (cost=1.00..-1.00 rows=100000 width=12)
Output: fontime."Year", ((count(*) * 1000))
Relations: Aggregate on (fontime)
Remote SQL: SELECT "Year", (count(*) * 1000) FROM "default".ontime WHERE (("DepDelay" > 10)) GROUP BY "Year"
->  Hash  (cost=999.00..999.00 rows=100000 width=12)
Output: b.c2, b."Year"
->  Subquery Scan on b  (cost=1.00..999.00 rows=100000 width=12)
Output: b.c2, b."Year"
->  Foreign Scan  (cost=1.00..-1.00 rows=100000 width=12)
Output: fontime_1."Year", (count(*))
Relations: Aggregate on (fontime)
Remote SQL: SELECT "Year", count(*) FROM "default".ontime GROUP BY "Year"(16 rows)
Q14: Förfrågan med ORDER BY-sats
bm=# EXPLAIN VERBOSE SELECT a."Year", c1/c2 FROM(SELECT "Year", count(*)*1000 AS c1 FROM fontime WHERE "DepDelay" > 10 GROUP BY "Year") a
     INNER JOIN(SELECT "Year", count(*) as c2 FROM fontime GROUP BY "Year") b  ON a."Year"= b."Year"
     ORDER BY a."Year";
Q14: Förfrågningsplan med ORDER BY-sats
QUERY PLAN
Merge Join  (cost=2.00..628498.02 rows=50000000 width=12)
Output: fontime."Year", (((count(*) * 1000)) / (count(*)))
Inner Unique: true   Merge Cond: (fontime."Year" = fontime_1."Year")
->  GroupAggregate  (cost=1.00..499.01 rows=1 width=12)
Output: fontime."Year", (count(*) * 1000)
Group Key: fontime."Year"
->  Foreign Scan on public.fontime  (cost=1.00..-1.00 rows=100000 width=4)
Remote SQL: SELECT "Year" FROM "default".ontime WHERE (("DepDelay" > 10))
            ORDER BY "Year" ASC
->  GroupAggregate  (cost=1.00..499.01 rows=1 width=12)
Output: fontime_1."Year", count(*)         Group Key: fontime_1."Year"
->  Foreign Scan on public.fontime fontime_1  (cost=1.00..-1.00 rows=100000 width=4)

Remote SQL: SELECT "Year" FROM "default".ontime ORDER BY "Year" ASC(16 rows)
Utdata
Resultaten av dessa experiment visar att ClickHouse verkligen erbjuder god prestanda, och att clickhousedb_fdw ger prestandafördelar från ClickHouse till PostgreSQL. Även om det finns vissa overheadkostnader med att använda clickhousedb_fdw, är dessa marginella och jämförbara med den prestanda som uppnås vid direkt användning av ClickHouse-databasen. Detta bekräftar också att fdw i PostgreSQL ger imponerande resultat.
Telegramchatt för Clickhouse
Telegramchatt för PostgreSQL
Källa: habr.com
