

Översättningen av artikeln är särskilt utarbetad för studenter i kursen .
är mjukvaruutvecklare, Go-entusiast och älskar att lösa komplexa problem. Han är också underhållare av Prometheus och medgrundare av Kubernetes SIG instrumentation. Tidigare var han produktionsingenjör på SoundCloud och ledde ett övervakningsteam på CoreOS. För närvarande arbetar han på Google.
är infrastrukturingenjör på Improbable. Han är intresserad av ny teknik och utmaningar inom distribuerade system. Han har erfarenhet av lågnivåprogrammering på Intel, har bidragit till Mesos och har produktionsvana som SRE på global nivå inom Improbable. Han arbetar med att förbättra världen av mikrotjänster. Hans tre passioner: Golang, open source och volleyboll.
Genom att titta på vår flaggskeppsprodukt SpatialOS kan du gissa att Improbable behöver en högdynamisk molninfrastruktur på global nivå med dussintals Kubernetes-kluster. Vi var bland de första som började använda ett övervakningssystem . Prometheus kan spåra miljontals metrik i realtid och kommer med ett kraftfullt frågespråk som gör det möjligt att hämta den information som behövs.
Enkelheten och tillförlitligheten hos Prometheus är en av dess främsta fördelar. Men när vi nått en viss skala har vi stött på några nackdelar. För att lösa dessa problem utvecklade vi — ett projekt med öppen källkod, skapat av Improbable, för sömlös transformation av befintliga Prometheus-kluster till ett enhetligt övervakningssystem med obegränsat lagringsutrymme för historiska data. Thanos finns tillgängligt på Github .
Våra mål med Thanos
Vid en viss skala uppstår problem som går bortom vad vanliga Prometheus kan hantera. Hur kan vi på ett tillförlitligt och kostnadseffektivt sätt lagra petabyte av historiska data? Är det möjligt utan att kompromissa med svarstiden på förfrågningar? Kan vi få tillgång till alla metrik som finns på olika Prometheus-servrar med ett enda API-anrop? Kan vi på något sätt kombinera replikerade data som samlats med hjälp av Prometheus HA?
För att lösa dessa frågor skapade vi Thanos. I de kommande avsnitten beskriver vi hur vi angrep dessa frågor och förklarar målen vi hade.
Förfrågan av data från flera instanser av Prometheus (global query)
Prometheus erbjuder en funktionell strategi för sharding. Även en enda Prometheus-server ger tillräcklig skalbarhet för att frigöra användare från komplexiteten med horisontell sharding i praktiskt taget alla användningsfall.
Även om detta är en utmärkt distributionsmodell, krävs det ofta åtkomst till data från olika Prometheus-servrar via ett enda API eller UI — global view. Naturligtvis finns det en möjlighet att visa flera frågor på ett enda Grafana-panel, men varje fråga kan endast utföras på en enda Prometheus-server. Å andra sidan kan du med Thanos begära och aggregera data från flera Prometheus-servrar, eftersom alla är tillgängliga från en enda slutpunkt.
Tidigare, för att få global view i Improbable, organiserade vi våra Prometheus-instanser i en flerlagers . Detta innebar att skapa en meta-server för Prometheus som samlar in vissa mätvärden från varje "blad"-server.
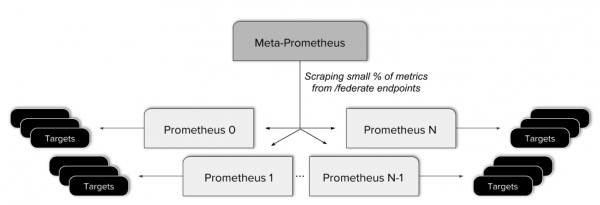
Denna strategi visade sig vara problematisk. Det ledde till en mer komplicerad konfiguration, en extra potentiell felpunkt och användning av komplexa regler för att säkerställa att den federerade slutpunkten endast tillhandahöll nödvändiga data. Dessutom tillåter federation av detta slag inte en verklig global view, eftersom inte alla data är tillgängliga från en enda API-begäran.
Detta är nära relaterat till en enhetlig vy av data som samlats in på hög tillgängliga (high-availability, HA) Prometheus-servrar. HA-modellen för Prometheus samlar oberoende in data två gånger, vilket är så enkelt att det knappt kan bli enklare. Men att använda en sammanslagen och deduplicerad vy av båda flödena skulle vara mycket mer praktiskt.
Självklart finns det ett behov av hög tillgänglighet för Prometheus-servrar. Vi på Improbable tar faktiskt minutlig övervakning av data på allvar, men att ha en enda instans av Prometheus i klustret utgör en enskild felpunkt. Varje konfigurationsfel eller maskinvarufel kan potentiellt leda till förlust av viktiga data. Även en enkel distribution kan leda till små avbrott i insamlingen av mätvärden, eftersom omstart kan ta betydligt längre tid än skrapningsintervallet.
Pålitlig lagring av historiska data
Billigt, snabbt och långsiktigt lagring av metrik är vår dröm (delad av de flesta användare av Prometheus). På Improbable var vi tvungna att ställa in lagringsperioden för metrik till nio dagar (för Prometheus 1.8). Detta lägger uppenbara begränsningar på hur långt tillbaka vi kan titta.
Prometheus 2.0 har blivit bättre på det här området eftersom antalet tidsserier inte längre påverkar den totala prestandan på servern (se ). Trots det lagrar Prometheus data på lokala diskar. Även om högpresterande datakompression kan minska användningen av lokala SSD:er avsevärt, finns det ändå en gräns för mängden historiska data som kan lagras.
Dessutom bryr vi oss på Improbable om tillförlitlighet, enkelhet och kostnad. Stora lokala diskar är svårare att hantera och säkerhetskopiera. De är dyrare och kräver fler verktyg för säkerhetskopiering, vilket leder till onödig komplexitet.
Nedprovning
När vi började arbeta med historiska data insåg vi att det finns fundamentala svårigheter med O-storlek, vilket gör förfrågningar långsammare och långsammare när vi arbetar med data över veckor, månader och år.
En standardlösning på detta problem är — att minska samplingfrekvensen av signalen. Genom att sänka samplingfrekvensen kan vi "skala ner" till ett längre tidsintervall och behålla samma antal prover, vilket gör att förfrågningarna förblir responsiva.
Nedprovning av gamla data är ett oundvikligt krav för alla lösningar för långsiktig lagring och går bortom vanilj-Prometheus.
Ytterligare mål
Ett av de ursprungliga målen för Thanos-projektet var sömlös integration med alla befintliga installationer av Prometheus. Det andra målet var enkel drift med minimala inträdesbarriärer. Alla beroenden bör enkelt tillfredsställas både för små och stora användare, vilket också innebär en låg grundkostnad.
Thanos-arkitektur
Efter att ha listat våra mål i det föregående avsnittet, låt oss arbeta med dem och se hur Thanos löser dessa problem.
Global vy
För att få en global vy över befintliga Prometheus-instanser måste vi koppla en enhetlig ingångspunkt för förfrågningar med alla servrar. Det är just detta som komponenten Thanos gör. . Den distribueras bredvid varje Prometheus-server och fungerar som en proxy, som betjänar lokala Prometheus-data via gRPC-gränssnittet Store API, vilket möjliggör val av tidsseriedata baserat på etiketter och tidsintervall.
Å andra sidan finns en horisontellt skalbar komponent Querier utan tillstånd, som gör lite mer än att helt enkelt svara på PromQL-förfrågningar via standard Prometheus HTTP API. Komponenterna Querier, Sidecar och andra Thanos interagerar via .
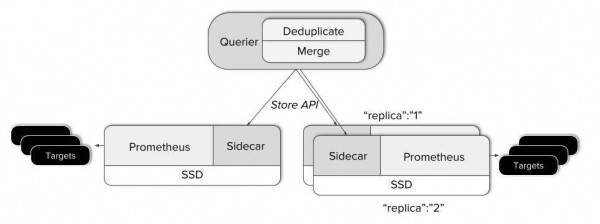
- Querier, när den tar emot en förfrågan, ansluter till motsvarande Store API-server, det vill säga till våra Sidecar och hämtar tidsseriedata från motsvarande Prometheus-servrar.
- Därefter kombinerar den svaren och utför PromQL-förfrågan. Querier kan kombinera både icke-överlappande data och duplicerade data från HA-Prometheus-servrar.
Detta löser huvuddelen av vårt pussel — att kombinera data från isolerade Prometheus-servrar till en enhetlig vy. Faktum är att Thanos kan användas enbart för denna funktion. Inga ändringar krävs på befintliga Prometheus-servrar!
Ingen begränsad lagringstid!
Men förr eller senare kommer vi att vilja spara data som går utöver den normala lagringstiden för Prometheus. För lagring av historiska data valde vi objektlagring. Det är allmänt tillgängligt i alla moln och även i lokala datacenter och är mycket kostnadseffektivt. Dessutom är nästan all objektlagring tillgänglig via det välkända S3 API:et.
Prometheus skriver data från RAM till disk ungefär varje två timmar. En block med sparad data innehåller all information för en bestämd tidsperiod och är oföränderlig. Detta är väldigt praktiskt, eftersom Thanos Sidecar enkelt kan övervaka datakatalogen för Prometheus och, när nya block dyker upp, ladda dem till objektlagringsbehållare.
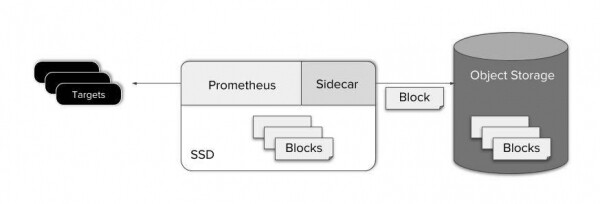
Laddning till objektlagring omedelbart efter att de skrivits till disk gör det också möjligt att bevara enkelheten av "skraparen" (Prometheus och Thanos Sidecar). Det förenklar underhåll, kostnader och systemdesign.
Som ni ser är backup av data mycket enkelt att genomföra. Men hur är det med förfrågan om data i objektlagring?
Thanos Store-komponenten fungerar som en proxy för att hämta data från objektlagringen. Precis som Thanos Sidecar deltar den i gossip-klustret och implementerar Store API. Därför kan befintliga Querier se den som Sidecar, som en ytterligare källa för tidsseriedata — ingen speciel konfiguration krävs.
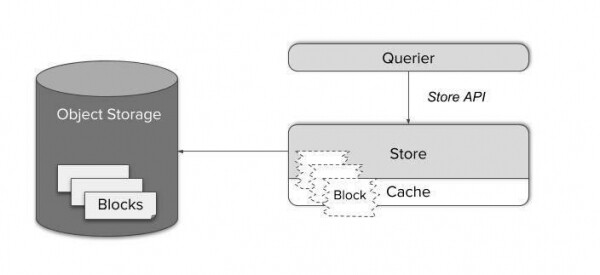
Tidsseriedata block består av flera stora filer. Att hämta dem vid behov skulle vara ganska ineffektivt, och lokalt cachelagring skulle kräva enormt mycket minne och diskutrymme.
Istället vet Store Gateway hur man hanterar Prometheus lagringsformat. Med en smart frågeplanerare och cachelagring av endast de nödvändiga indexdelarna av blocken har det blivit möjligt att minska komplexa förfrågningar till ett minimum av HTTP-förfrågningar till filer i objektlagring. På så sätt kan antalet förfrågningar minskas med fyra till sex ordningar och uppnå svarstider som överlag är svåra att särskilja från förfrågningar om data på lokal SSD.
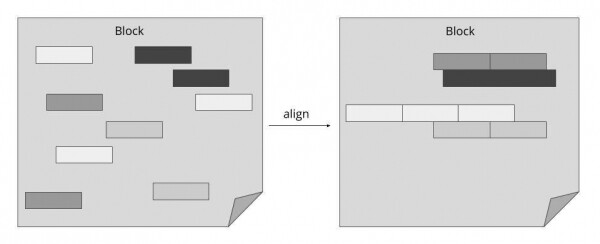
Som visas i diagrammet ovan minskar Thanos Querier kostnaderna för en förfrågan om data i objektlagring avsevärt genom att använda Prometheus lagringsformat och placera relaterade data nära varandra. Genom att använda denna metod kan vi kombinera många separata förfrågningar till ett minimalt antal bulk-operationer.
Kompaktering och nedprovning
När en ny tidsseriedatablock framgångsrikt har laddats upp till objektlagringen betraktar vi det som "historiska" data, som genast blir tillgängliga via Store Gateway.
Men efter en tid samlas block från samma källa (Prometheus med Sidecar) och utnyttjar inte längre hela potentialen för indexering. För att lösa detta problem införde vi ytterligare en komponent som kallas Compactor. Den tillämpar helt enkelt den lokala kompakteringsmekanismen för Prometheus på historiska data i objektlagringen och kan köras som ett enkelt periodiskt batchjobb.
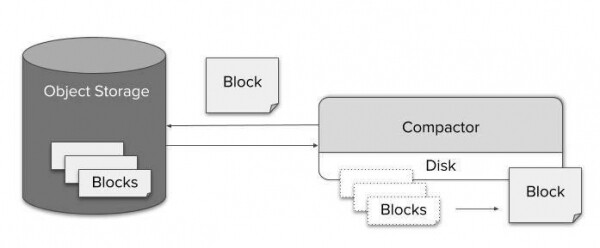
Genom effektiv komprimering innebär en lagringsförfrågan under en längre tid inga problem med avseende på datastorlek. Men de potentiella kostnaderna för att packa upp en miljard värden och köra dem genom en förfrågningsbehandlare kommer oundvikligen att leda till en kraftig ökning av förfrågningsutförandetiden. Å andra sidan, eftersom varje pixel på skärmen motsvarar hundratals datapunkter, blir det omöjligt att ens visualisera data i full upplösning. Därför är nedsampling inte bara möjlig, utan det kommer inte att leda till märkbar förlust av noggrannhet.
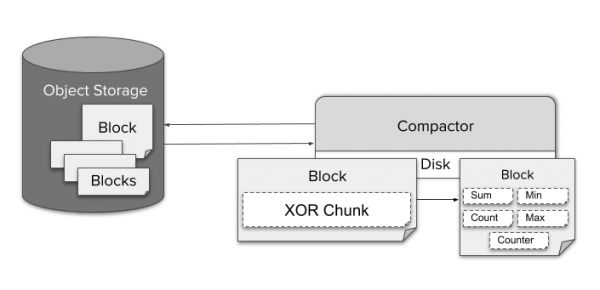
För nedsampling av data aggregerar Compactor kontinuerligt data med upplösning om fem minuter och en timme. För varje obearbetat fragment, kodad med TSDB XOR-komprimering, lagras olika typer av aggregerade data, såsom min, max eller sum för en block. Detta gör det möjligt för Querier att automatiskt välja aggregeringen som är lämplig för den aktuella PromQL-förfrågan.
För att använda data med reducerad noggrannhet krävs ingen särskild konfiguration av användaren. Querier växlar automatiskt mellan olika upplösningar och obearbetade data när användaren zoomar in och ut. Om så önskas kan användaren hantera detta direkt via parameter "step" i förfrågan.
Eftersom kostnaden för att lagra en GB är låg, så sparar Thanos som standard originaldata, data med upplösning om fem minuter och en timme. Det finns ingen anledning att ta bort originaldata.
Recording rules
Även med Thanos är recording rules en väsentlig del av övervakningsstacken. De minskar komplexiteten, fördröjningen och kostnaderna för förfrågningar. De är också bekväma för användarna att få aggregerade data om mätvärden. Thanos bygger på vanliga Prometheus-instans, så det är fullt acceptabelt att lagra recording rules och alerting rules på den befintliga Prometheus-servern. Men i vissa fall kanske detta inte är tillräckligt:
- Globala alert och regel (till exempel, ett meddelande när en tjänst är nere på mer än två av tre kluster).
- Regeln för data utanför den lokala lagringen.
- Strävan att lagra alla regler och alert i ett och samma ställe.
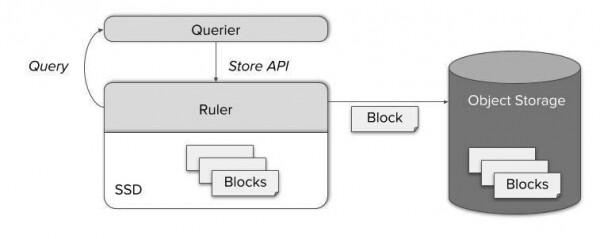
För alla dessa fall inkluderar Thanos en separat komponent som kallas Ruler, som beräknar regler och larm genom Thanos Queries. Genom att tillhandahålla det välkända StoreAPI kan Query-noden få tillgång till nyligen beräknade metrikvärden. Senare lagras dessa också i en objektlagring och blir tillgängliga genom Store Gateway.
Thanos kraft
Thanos är tillräckligt flexibelt för att anpassas efter dina krav. Detta är särskilt användbart vid migrering från en enkel Prometheus. Låt oss snabbt gå igenom komponenterna i Thanos med ett litet exempel. Så här kan du överföra din vanliga Prometheus till världen av "obegränsad metriklagring":
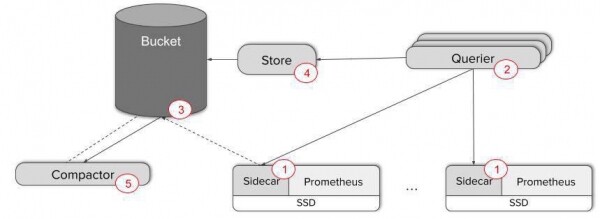
- Lägg till Thanos Sidecar till dina Prometheus-servrar – till exempel, som en intilliggande container i en Kubernetes-pod.
- Distribuera flera repliker av Thanos Querier för att möjliggöra datavisning. Vid detta skede är det lätt att ställa in gossip mellan Scraper och Querier. Använd metrikvärdet 'thanos_cluster_members' för att kontrollera komponenternas interaktion.
Bara dessa två steg är tillräckliga för att säkerställa en global vy och sömlös deduplicering av data från potentiella HA-repliker av Prometheus! Anslut bara dina instrumentpaneler till HTTP-endpointen för Querier eller använd Thanos UI direkt.
Men om du behöver säkerhetskopiera metrik och långsiktig lagring, krävs ytterligare tre steg:
- Skapa en AWS S3- eller GCS-bucket. Ställ in Sidecar för att kopiera data till dessa buckets. Nu kan du minimera lokal datalagring.
- Distribuera Store Gateway och anslut den till den befintliga gossip-klustret. Nu kan du skicka förfrågningar till data i säkerhetskopiorna!
- Distribuera Compactor för att öka effektiviteten för förfrågningar över längre tidsperioder genom att använda komprimering och nedprovering.
Om du vill veta mer, tveka inte att titta på våra och !
På bara fem steg har vi omvandlat Prometheus till ett pålitligt övervakningssystem med global vy, obegränsad lagringstid och potentiell hög tillgänglighet för metrik.
Pull request: vi behöver dig!
har varit ett projekt med öppen källkod från början. Den sömlösa integrationen med Prometheus och möjligheten att använda bara en del av Thanos gör det till ett utmärkt val för att skala övervakningssystemet utan onödig ansträngning.
Vi är alltid glada över GitHub Pull Requests och Issues. Tveka inte att kontakta oss via GitHub Issues eller Slack., om du har frågor eller feedback, eller om du vill dela din erfarenhet! Om du gillar det vi gör på Improbable, tveka inte att höra av dig — !
Källa: habr.com
