

Jag föreslår att ni bekantar er med avrapporteringen från början av 2016 av Andrej Salnikov "Typiska fel i applikationer som leder till bloat i PostgreSQL"
I den här rapporten kommer jag att gå igenom de vanligaste felen i applikationer som uppstår under design- och kodningsfasen av applikationen. Jag kommer endast att ta upp de fel som leder till bloat i PostgreSQL. Vanligtvis är detta början på slutet för systemets prestanda som helhet, även om det från början inte fanns några tecken på detta.
Jag hälsar er alla välkomna! Denna föreläsning är inte lika teknisk som den föregående från min kollega. Den här föreläsningen riktar sig främst till utvecklare av backend-system, eftersom vi har ett ganska stort antal kunder. Och alla gör samma misstag. Det är om dessa jag kommer att berätta. Jag kommer att förklara vilka katastrofala och negativa konsekvenser dessa fel kan leda till.
Varför uppstår felen? De uppstår av två anledningar: antingen genom tur, att det kanske fungerar, eller av okunskap om vissa mekanismer som händer på nivån mellan databasen och applikationen, samt i själva databasen.
Jag kommer att ge er tre exempel med hemska bilder av hur allt blev dåligt. Jag kommer kort att beskriva de mekanismer som förekommer där. Och hur man kan hantera dem när de inträffar, samt vilka förebyggande metoder som kan användas för att undvika fel. Jag kommer att berätta om hjälpprogram och ge användbara länkar.
Jag använde en testdatabas där jag hade två tabeller. En tabell för kundkonton och den andra för transaktioner på dessa konton. Med viss periodicitet uppdaterar vi saldona på dessa konton.
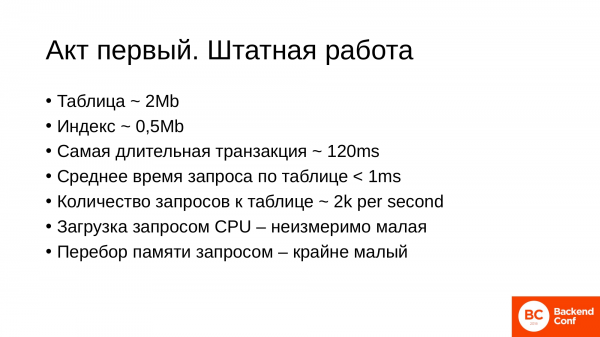
Ursprungliga data för tabellen: den är ganska liten, 2 MB. Svarstiden för databasen och specifikt för tabellen är också mycket bra. Och en ganska bra belastning – 2 000 operationer per sekund på tabellen.
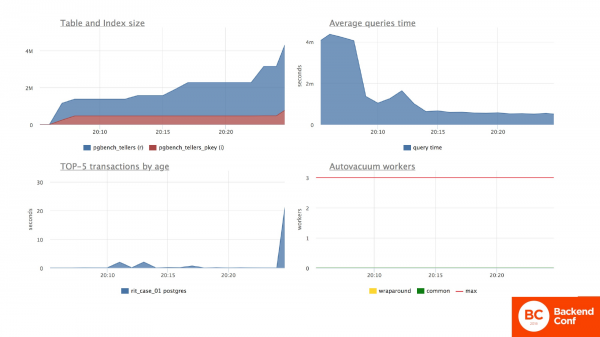
Och genom denna föreläsning kommer jag att visa er grafer så att det tydligt ska framgå vad som händer. Det kommer alltid att finnas 2 bilder med grafer. Den första bilden visar vad som händer i allmänhet på servern.
Och i denna situation ser vi att vi verkligen har en tabell av liten storlek. Indexet är litet, på 2 MB. Detta är den första grafen till vänster.
Den genomsnittliga svarstiden för servern är också stabil och låg. Detta är den övre grafen till höger.
Den nedersta vänstra grafen visar de längsta transaktionerna. Vi ser att transaktionerna genomförs snabbt. Och autovakuum fungerar ännu inte här, eftersom det var ett starttest. Framöver kommer det att fungera och vara till nytta för oss.
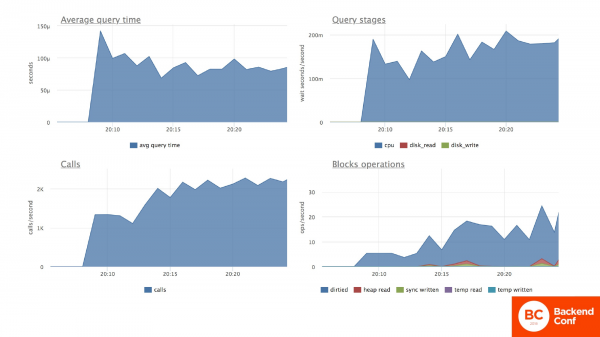
Den andra bilden kommer alltid att handla om den testade tabellen. I den här situationen uppdaterar vi kontinuerligt saldot på kundens konton. Och vi ser att den genomsnittliga svarstiden för uppdateringsoperationen är ganska bra, mindre än en millisekund. Vi ser också att CPU-resurserna (det är den övre högra grafen) förbrukas jämnt och i ganska små mängder.
Den nedre högra grafen visar hur mycket operativ och diskminne vi går igenom i sökandet efter vår nödvändiga rad innan vi uppdaterar den. Och antalet operationer på tabellen – 2000 per sekund, precis som jag nämnde tidigare.
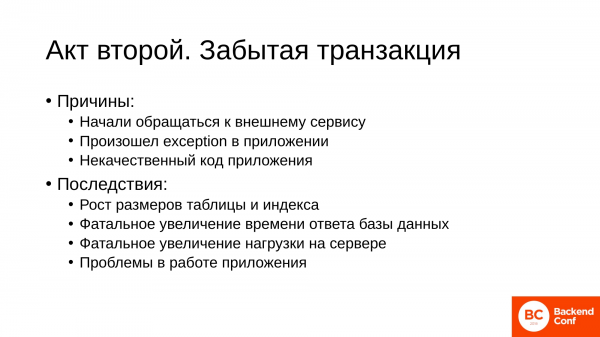
Och nu händer det en tragedi. Av någon anledning uppstår en lång glömd transaktion. Orsakerna är vanligtvis banala:
- En av de vanligaste situationerna är att vi i applikationskoden börjar anropa en extern tjänst. Och den tjänsten svarar inte oss. Det vill säga, vi öppnade en transaktion, gjorde en ändring i databasen och gick för att läsa e-post i applikationen eller till en annan tjänst i vår infrastruktur, och av någon anledning svarar den inte oss. Och vår session hänger i ett tillstånd – oklart när det ska lösas.
- Den andra situationen är när det i koden av någon anledning uppstod ett undantag. Och vi i undantaget inte hanterade stängningen av transaktionen. Och vi har fått en hängande session med en öppen transaktion.
- Och den sista – det är också ett ganska vanligt fall. Det handlar om undermålig kod. Vissa ramverk öppnar en transaktion. Den hänger, och du kan vara ovetande om att den hänger i applikationen.
Vad leder sådana saker till?
Till att våra tabeller och index börjar svälla kraftigt. Det här är just den effekt som kallas bloat. För databasen kommer det att innebära att vi får en dramatisk ökning i databasens svarstid, ökad belastning på databasservern. Och som ett resultat kommer applikationen att lida. För om du i koden tog 10 millisekunder för en förfrågan till databasen, 10 millisekunder för din logik, så fungerade din funktion på 20 millisekunder. Men nu kommer situationen att bli helt sorglig.
Låt oss se vad som händer. Den vänstra nedre grafen visar att vi har en långvarig transaktion. Och om vi tittar på den vänstra övre grafen ser vi att storleken på tabellen, som var två megabyte, plötsligt har ökat till 300 megabyte. Samtidigt har mängden data i tabellen inte förändrats, dvs. det finns en stor mängd skräp.
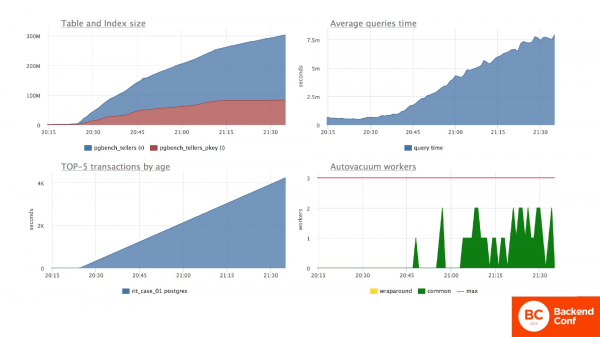
Den övergripande situationen för medelservartid har också förändrats flera gånger. Det vill säga alla förfrågningar till servern har börjat sjunka kraftigt. Samtidigt har interna Postgres-processer i form av autovakuum startat, som försöker göra något och förbrukar resurser.
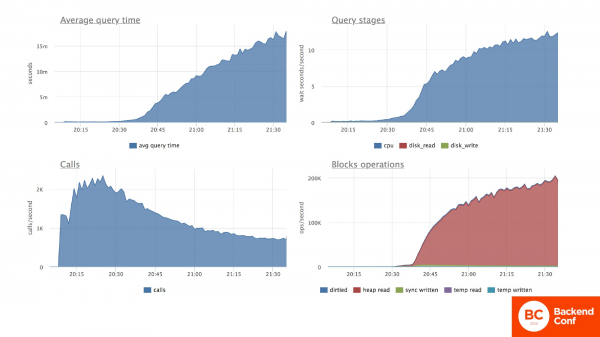
Vad händer med vår tabell? Samma sak. Medel svarstid för tabellen har ökat flera gånger. När vi ser på de använda resurserna, ser vi att belastningen på processorn har ökat kraftigt. Det är den övre högra grafen. Den har ökat eftersom processorn måste gå igenom massor av värdelösa rader för att hitta en enda som behövs. Det är den nedre högra grafen. Som ett resultat har antalet anrop per sekund börjat sjunka kraftigt eftersom databasen inte hinner bearbeta samma mängd förfrågningar.
Vi måste komma tillbaka till livet. Vi går in på internet och får reda på att långvariga transaktioner orsakar problem. Vi hittar och dödar denna transaktion. Och nu fungerar allt som det ska. Allt fungerar bra.
Vi lugnar ner oss, men efter ett tag börjar vi märka att applikationen inte fungerar som den gjorde före incidenten. Förfrågningar bearbetas fortfarande långsammare, och faktiskt betydligt långsammare. I mitt fall är det en och en halv till två gånger långsammare. Belastningen på servern är också högre än den var före incidenten.
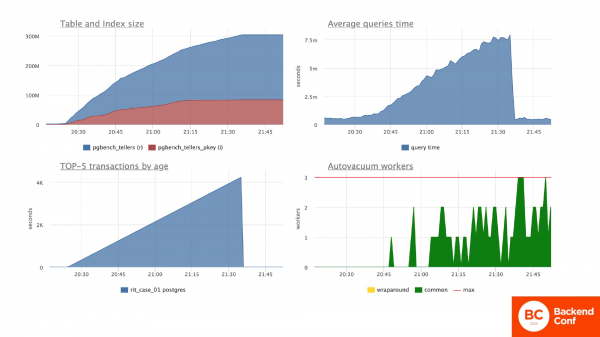
Och frågan är: "Vad händer med databasen vid det tillfället?". Med databasen sker följande: I grafen för transaktioner ser ni att den har stannat och det finns verkligen inga långvariga transaktioner där. Men storleken på tabellen har under incidenten ökat katastrofalt. Och har inte minskat sedan dess. Medeltiden för databasen har stabiliserats. Svaren verkar komma fram i en acceptabel hastighet för oss. Autovakuum har blivit mer aktivt och har börjat göra något med tabellen, för det behöver bearbeta en större mängd data.
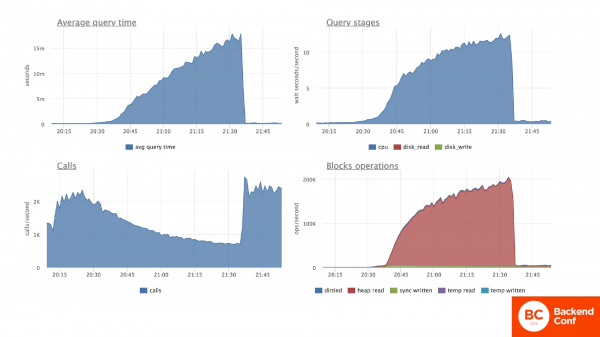
Specifikt för den testade fakturatabellen, där vi ändrar saldon: svarstiden på förfrågan verkar ha återgått till det normala. Men i själva verket är den en och en halv gång högre.
Och när det gäller CPU-belastningen ser vi att den inte har återgått till rätt nivå innan kraschen. Orsaken döljer sig precis i den nedre högra grafen. Det är tydligt att något slags minnesöverskott sker där. D.v.s. för att hitta den nödvändiga raden förbrukar vi serverresurser i databasen när vi går igenom onödiga data. Antalet transaktioner per sekund har stabiliserats.
Överlag är det bra, men situationen är värre än vad den var. En tydlig nedgång i databasen som en följd av vår applikation som arbetar med denna databas.
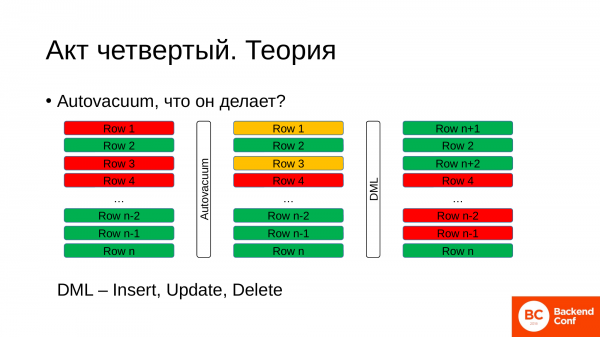
Och för att förstå vad som händer där, om ni inte var på den föregående presentationen, så kommer lite teori nu. Teorin om den interna processen. Vad är autovakuum och vad gör det?
Kort sagt för att förstå. Vid någon tidpunkt har vi en tabell. I tabellen finns rader. Dessa rader kan vara aktiva, livliga, viktiga för oss nu. På bilden är de markerade i grönt. Och det finns döda rader, som redan har använts, har uppdaterats, nya poster har tillkommit. De är markerade eftersom de inte längre intresserar databasen. Men de ligger kvar i tabellen på grund av PostgreSQL:s egenskaper.
Vad behövs autovakuum för? Autovakuum kommer vid något tillfälle, kontaktar databasen och frågar: "Ge mig vänligen id för den äldsta transaktionen som för närvarande är öppen i databasen." Databasen returnerar detta id. Och autovakuum, baserat på detta, går igenom raderna i tabellen. Om det ser att vissa rader har förändrats av betydligt äldre transaktioner, har det rätt att markera dem som rader som vi kan återanvända i framtiden genom att skriva nya data där. Detta är en bakgrundsprocess.
Under tiden fortsätter vi att arbeta med databasen, fortsätter att göra olika ändringar i tabellen. Och på dessa rader, som vi kan återanvända, skriver vi ny data. På så sätt får vi ett kretslopp, d.v.s. hela tiden uppstår det döda gamla rader, istället skriver vi nya rader som vi behöver. Och detta är ett normalt tillstånd för att arbeta med PostgreSQL.
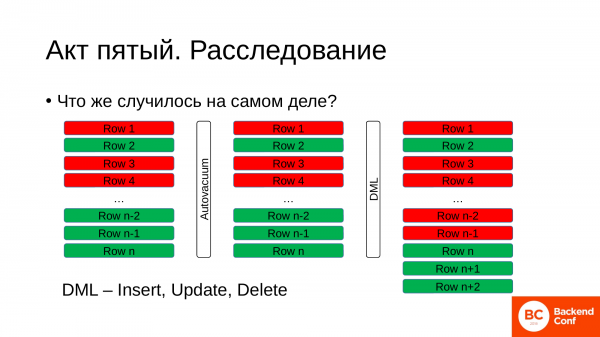
Vad hände under kraschen? Hur gick processen till där?
Vi hade en tabell i något tillstånd, vissa rader levande och andra döda. Autofragmentering kom. Den frågade databasen om vilken som var vår äldsta transaktion och vilket id den hade. Den fick det id som kan vara flera timmar gammalt eller bara tio minuter. Det beror på hur hög belastning ni har i databasen. Sedan började den leta efter rader som den kan märka som återanvändbara. Men den hittade inga sådana rader i vår tabell.
Men under tiden fortsätter vi att arbeta med tabellen. Vi gör något i den, uppdaterar, ändrar data. Vad har databasen att göra under tiden? Den har inget annat att göra än att skriva nya rader i slutet av den befintliga tabellen. På så sätt börjar storleken på tabellen att öka.
För vårt arbete behöver vi egentligen gröna rader. Men under ett sådant problem får vi att procentandelen gröna rader är extremt låg i hela tabellen.
När vi gör en förfrågan måste databasen gå igenom alla rader: både röda och gröna, för att hitta den nödvändiga raden. Effekten av att tabellen svullnar upp med onödiga data kallas 'bloat', som också slukar vårt diskutrymme. Kommer ni ihåg, det var 2 MB, nu är det 300 MB? Och nu, byt megabyte mot gigabyte så kommer ni snabbt att förlora alla era disresurser.
Vilka konsekvenser kan det få för oss?
- I mitt exempel har tabellen och indexet vuxit med 150 gånger. Hos vissa av våra kunder har det inträffat mer fatala fall när det helt enkelt börjar ta slut på diskutrymme.
- Storleken på tabellerna minskar aldrig av sig själv. Autofragmentering kan i vissa fall klippa av svansen på tabellen om det bara finns döda rader. Men eftersom en konstant rotation sker kan en grön rad hänga kvar i slutet och inte uppdateras, medan alla andra kommer att skrivas någonstans i början av tabellen. Men det är ett så osannolikt scenario att ni inte bör hoppas på att er tabell kommer att minska i storlek.
- Databasen måste gå igenom hela högen av onödiga rader. Och vi slösar med disresurser, slösar med CPU-resurser och elektricitet.
- Och detta påverkar direkt vår applikation, för om vi i början använde 10 millisekunder för en begäran, 10 millisekunder för vår kod, så började vi under kraschen att använda en sekund för begäran och 10 millisekunder för koden, det vill säga applikationens prestanda sjönk ordentligt. När kraschen löstes började vi använda 20 millisekunder för begäran och 10 millisekunder för koden. Det betyder att vi fortfarande har en prestandaförlust på en och en halv gång. Och allt detta på grund av en transaktion som fryst, möjligtvis på vårt fel.
- Och frågan är: "Hur får vi tillbaka allt?" Så att allt fungerar bra och begärningarna går lika snabbt som före kraschen.
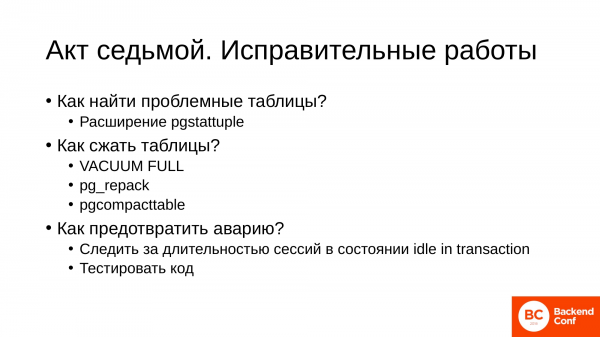
För detta finns en viss arbetscykel som genomförs.
Först måste vi hitta de problematiska tabellerna som har svullnat. Vi förstår att för vissa tabeller går inspelningen mer aktivt, för andra mindre aktivt. Och för detta används tillägget . Genom att installera detta tillägg kan du skriva frågor som hjälper dig att hitta tabeller som har svullnat kraftigt.
Efter att du har funnit dessa tabeller måste de komprimeras. För detta finns redan verktyg. I vårt företag använder vi tre verktyg. Den första är den inbyggda VACUUM FULL. Den är grym, strikt och obarmhärtig, men ibland är den mycket användbar. och – detta är externa verktyg för komprimering av tabeller. Och de är mer skonsamma mot databasen.
De används beroende på vad som är mer bekvämt för dig. Men jag kommer att berätta mer om detta i slutet. Det viktiga är att det finns tre verktyg. Det finns att välja på.
Efter att vi har gjort alla korrigeringar och säkerställt att allt fungerar bra, måste vi veta hur vi hindrar denna situation i framtiden:
- Det är ganska enkelt att förebygga. Man behöver hålla koll på längden på sessionerna på mästerservern. Särskilt farliga sessioner i tillståndet idle in transaction. Det är de som precis har öppnat en transaktion, gjort något och sedan gått därifrån eller bara fryst, förlorat sig i koden.
- Och för er, som utvecklare, är det viktigt att testa koden vid uppkomsten av sådana situationer. Det är inte svårt att göra. Det kommer att vara en nyttig kontroll. Ni undviker många "barnsjukdomar" relaterade till långa transaktioner.
I wanted to show you on these graphs how the table and database behavior changed after I performed a VACUUM FULL on the table. This is not in production.
The table size immediately returned to a normal working state of a few megabytes. This did not significantly affect the average response time on the server.
However, specifically for our test table, where we updated the account balances, we see that the average response time for the data update query has decreased to pre-incident levels. The CPU resources consumed for executing this query have also fallen to pre-incident levels. The bottom right graph shows that we are now finding exactly the row we need immediately, without sifting through a bunch of dead rows that existed before the table compression. The average query response time has remained approximately at the same level, but here I might have a deviation due to my hardware.
This concludes the first story. It is the most common one and happens to everyone, regardless of the client's experience or how qualified the programmers are. Sooner or later, this occurs.
The second story, where we distribute the load and optimize server resources.
- We have grown and become quite serious. We understand that we have a replica and it would be good to balance the load: write to the Master and read from the replica. This situation usually arises when we want to prepare some reports or ETL. The business is very pleased with this. It greatly desires various reports with plenty of complex analysis.
- The reports take hours, as complex analytics can't be computed in milliseconds. We, as diligent folks, write the code. We perform inserts in the application, writing to the Master and executing reports on the replica.
- We distribute the load.
- Everything works excellently. We are doing great.
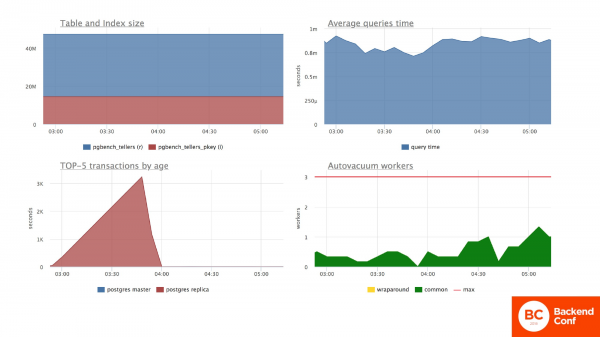
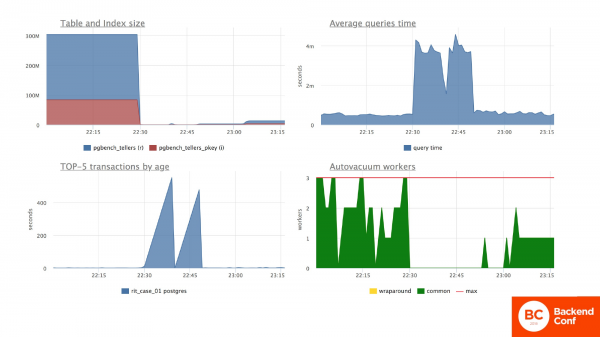
And how does this situation look? Specifically on these graphs, I also added the duration of transactions from the replica. All other graphs pertain only to the Master server.
Rapporttabellen har vuxit vid det här laget. Vi ser att den genomsnittliga svarstiden för servern är stabil. Vi noterar att det finns en långvarig transaktion på repliken som pågår i två timmar. Vi ser att autovakuumen arbetar lugnt och bearbetar döda rader. Allt är bra.
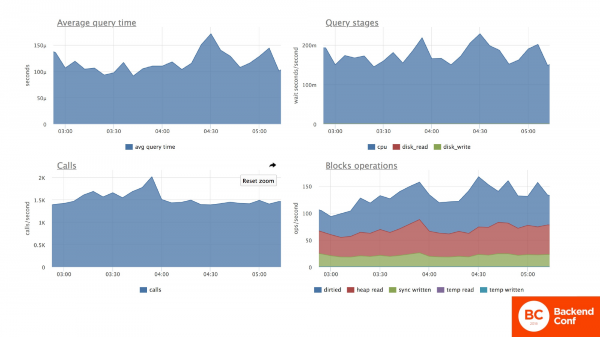
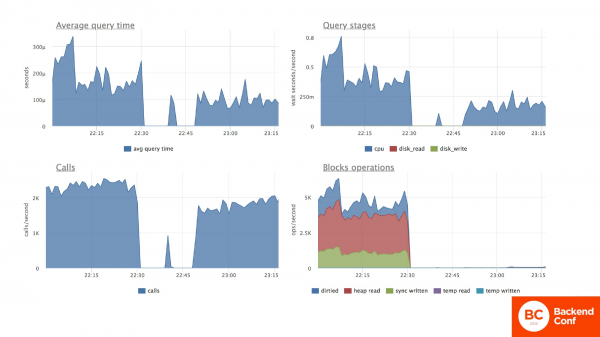
Specifikt för den aktuella tabellen fortsätter vi att uppdatera saldon. Vi har också stabil svarstid för förfrågan och stabil resursanvändning. Allt är bra.
Allt är bra tills dessa rapporter börjar skjutas upp på grund av konflikter med replikationen. De skjuts upp med konstant periodicitet.
Vi går ut på nätet och börjar läsa varför detta händer. Och vi hittar en lösning.
Den första lösningen är att öka replikationsfördröjningen. Vi vet att vår rapport tar tre timmar. Vi sätter replikationsfördröjningen till tre timmar. Vi startar allt, men vi har fortfarande problem med att rapporterna ibland skjuts upp.
Vi vill att allt ska vara perfekt. Vi fortsätter leta. Och vi hittar en fantastisk inställning på nätet – hot_standby_feedback. Vi aktiverar det. Hot_standby_feedback låter oss hålla autovakuumets arbete på Master. På så sätt slipper vi helt konflikter vid replikation. Allt fungerar bra med rapporterna.
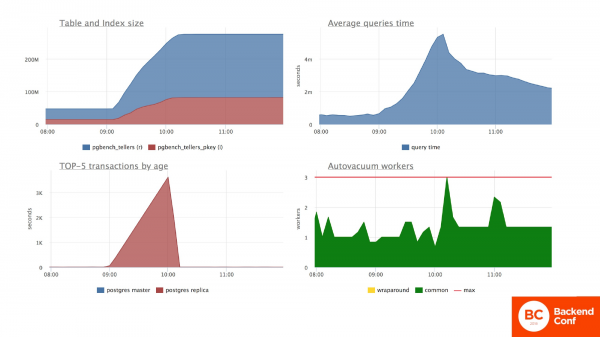
Och vad händer med Master-servern under tiden? Med Master-servern har vi total katastrof. Just nu observerar vi graferna när jag aktiverade båda dessa inställningar. Vi ser att sessionen på repliken på något sätt börjar påverka situationen på Master-servern. Det påverkar verkligen, eftersom den har pausat autovakuumet som rensar döda rader. Storleken på tabellen har återigen skjutit i höjden. Den genomsnittliga frågetiden för hela databasen har också skjutit i höjden. Autovakuumen har blivit något ansträngda.
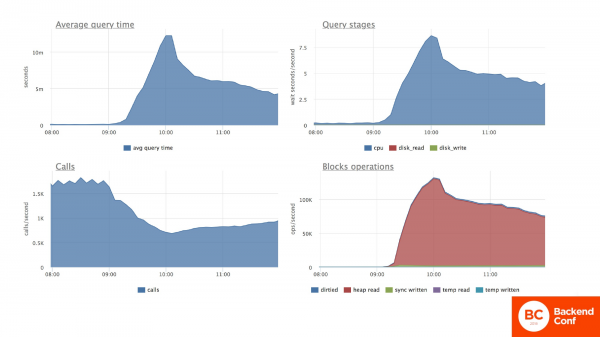
Specifikt för vår tabell ser vi att datan också har skjutit i höjden. Resursanvändningen för CPU har också ökat kraftigt. Vi går återigen igenom ett stort antal döda, meningslösa rader. Och svarstiden för denna tabell och antalet transaktioner har minskat.
Hur skulle det se ut om vi inte visste vad jag pratat om tidigare?
- Vi börjar leta efter problem. Om vi har stött på problem i första delen vet vi att det kan bero på en lång transaktion och vi kollar på Master. Problemet finns på vår Master. Den har problem. Den blir varm och dess Load Average närmar sig hundra.
- Förfrågningar där hänger sig, men vi ser inga långvariga transaktioner. Och vi förstår inte vad som är fel. Vi förstår inte var vi ska leta.
- Vi kontrollerar serverhårdvaran. Kanske har vår raid kraschat. Kanske har ett minnesmodul brunnit. Vad som helst kan hända. Men nej, servrarna är nya, allt fungerar utmärkt.
- Alla springer omkring: administratörer, utvecklare och direktören. Inget hjälper.
- Och plötsligt börjar allt oannonserat att återställas av sig självt.
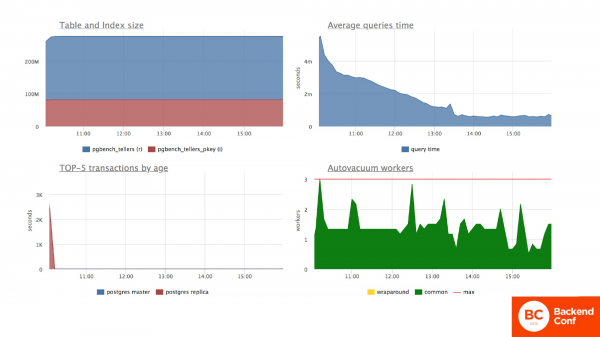
På replikan har en förfrågan under tiden utförts och skickats iväg. Vi fick en rapport. Företaget är fortfarande nöjt. Som vi ser har vår tabell växt igen och visar inga tecken på minskning. På grafen med sessioner har jag lämnat ett stycke av denna långa transaktion från replikan så att ni kan bedöma hur lång tid det tar innan situationen stabiliseras.
Sessionen har avslutats. Och först efter en tid kommer servern mer eller mindre i ordning. Och den genomsnittliga svarstiden på förfrågningar på Master-servern normaliseras. För äntligen har autovacuum fått möjlighet att rensa upp, markera dessa döda rader. Och ju snabbt det arbetar, desto snabbare kommer vi i ordning.
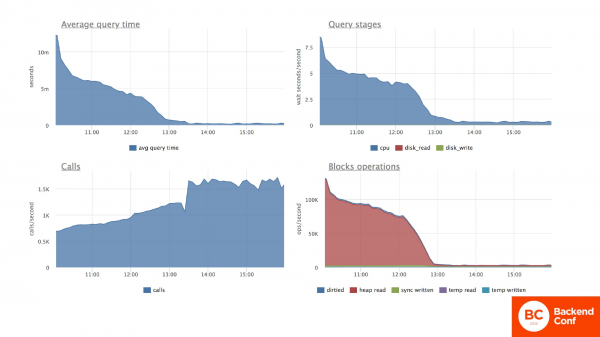
På den testade tabellen, där vi uppdaterar saldon på konton, ser vi ett exakt samma mönster. Den genomsnittliga tiden för kontouppdatering normaliseras också gradvis. CPU-användningen minskar också. Och antalet transaktioner per sekund återgår till det normala. Men inte till det normala som vi hade innan avbrottet.
I vilket fall får vi en prestationsförlust precis som i första fallet, en och en halv till två gånger, ibland ännu mer.
Vi verkar ha gjort allt rätt. Fördelat lasten. Utrustningen står inte still. Vi har förnuftigt delat upp förfrågningarna, men ändå blev allt dåligt.
- Ska vi inte aktivera hot_standby_feedback? Ja, det rekommenderas vanligtvis inte att aktivera det utan starka skäl. Eftersom den här inställningen direkt påverkar Master-servern och pausar autovakuumet där. Om du aktiverar det på en replik och glömmer bort det kan du skada Master och få stora problem med applikationen.
- Ska vi öka max_standby_streaming_delay? Ja, det är faktiskt så. Om du har en tre timmar lång rapport och inte vill att den ska krascha på grund av replikationskonflikter, så öka bara fördröjningen. Långa rapporter kräver aldrig data som just nu kommit in i databasen. Om den är tre timmar lång, kör du den för någon gammal dataperiod. Tre timmars fördröjning eller sex timmars fördröjning spelar ingen roll, men då får du stabilt dina rapporter och slipper krascher.
- Självklart måste vi övervaka långa sessioner på repliker, särskilt om du har bestämt dig för att aktivera hot_standby_feedback på repliken. För det kan hända vad som helst. Vi gav denna replik till en utvecklare för att han skulle testa förfrågningar. Han skrev en besynnerlig förfrågan. Startade den och gick för att dricka te, och vi fick en överbelastad Master. Eller vi lät ett olämpligt program gå dit. Situationerna är olika. Sessioner på repliker måste övervakas lika noggrant som på Master.
- Och om du har snabba och långa förfrågningar på repliker, så är det bättre att dela upp dem för belastningsfördelning. Det här hänvisar till streaming_delay. För snabba förfrågningar, ha en replik med liten replikationsfördröjning. För långa rapporteringsförfrågningar, ha en replik som kan ligga efter med 6 timmar eller en dag. Det är en helt normal situation.
Vi eliminerar konsekvenserna på samma sätt:
- Vi hittar uppblåsta tabeller.
- Och komprimerar dem med det mest lämpliga verktyget för oss.
Den andra historien har nu avslutats. Låt oss gå vidare till den tredje historien.
Också ganska vanlig för oss, där vi gör en migrering.
- Varje programprodukt växer. Kraven på den förändras. Vi vill alltid utvecklas. Och ibland händer det att vi måste uppdatera data i tabellen, genomföra en uppdatering inom ramen för vår migrering för den nya funktionalitet som vi introducerar i vår utveckling.
- Det gamla dataformatet fungerar inte längre. Anta att vi nu går till den andra tabellen där jag har transaktioner för dessa konton. Och säg att de var i rubel, men vi har beslutat att öka noggrannheten och göra det i kopecker. För detta behöver vi göra en uppdatering: fältet med transaktionssumman multiplicera med hundra.
- I den moderna världen använder vi automatiserade verktyg för versionskontroll av databaser. Låt oss anta att . Vi skriver ner vår migration där. Testar den på vår testdatabas. Allt är utmärkt. Uppdateringen lyckas. Det blockerar arbetet under en tid, men vi får den uppdaterade datan. Och vi kan köra ny funktionalitet på detta. Vi har testat allt, kontrollerat. Allt är bekräftat.
- Vi genomförde planerat arbete, genomförde migrationen.
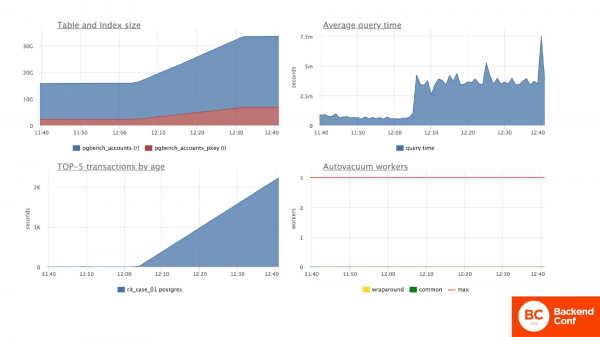
Här är migrationen med uppdateringen presenterad för er. Eftersom detta handlar om transaktioner för konton var tabellen 15 GB. Och eftersom vi uppdaterar varje rad har vi genom uppdateringen fördubblat tabellen, eftersom vi har skrivit över varje rad.
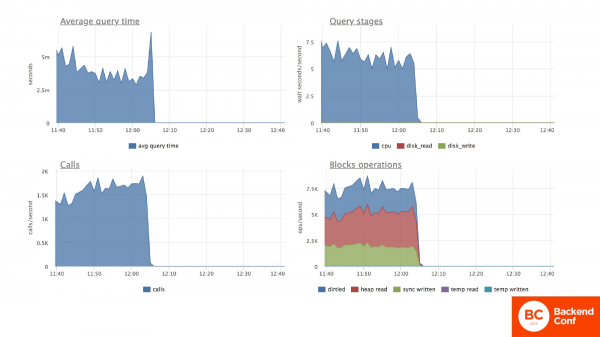
Under migrationen kunde vi inte göra något med den här tabellen, eftersom alla förfrågningar till den köades och väntade på att denna uppdatering skulle avslutas. Men här vill jag påpeka siffrorna på den vertikala axeln. Alltså hade vi genomsnittlig förfrågningstid före migrationen på cirka 5 millisekunder och belastning på processorn, antal blockoperationer för minnesläsning av disken mindre än 7,5.
Vi genomförde migrationen och fick återigen problem.
Migrationen lyckades, men:
- Den gamla funktionaliteten tar längre tid att utföra.
- Tabellen har återigen växt i storlek.
- Belastningen på servern har återigen blivit större än den var.
- Och naturligtvis, medan vi fortfarande arbetar med den funktionalitet som fungerade bra, har vi förbättrat den lite grann.
Och det är återigen bloat som återigen försvårar vårt liv.
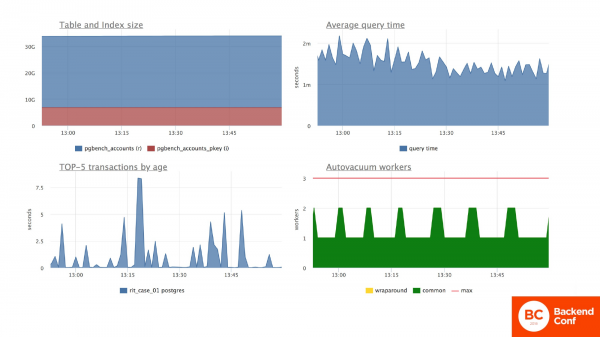
Här visar jag att tabellen, precis som i de tidigare två fallen, inte tänker återvända till sina tidigare storlekar. Den genomsnittliga belastningen på servern verkar vara rimlig.
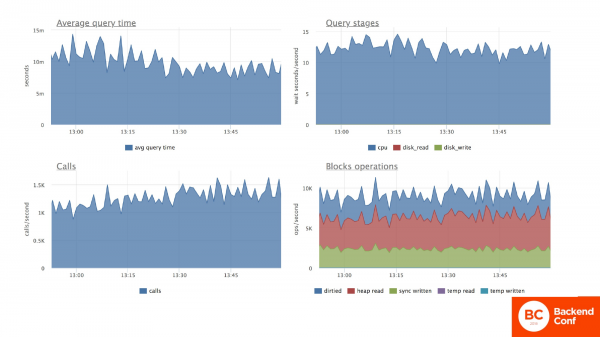
Om vi tittar på tabellen med räkningar, så ser vi att den genomsnittliga förfrågan har dubblats för denna tabell. Belastningen på processorn och antalet rader som bearbetas i minnet har ökat till över 7,5, jämfört med tidigare. För processorerna har det ökat med 2 gånger, för blockoperationerna med 1,5 gånger, dvs. vi har fått en degradering av serverns prestanda. Och följaktligen är det en degradering av prestandan för vår applikation. Samtidigt har antalet anrop förblivit ungefär på samma nivå.
Och det viktigaste här är att förstå hur man korrekt gör sådana migreringar. Och de måste göras. Vi gör dessa migreringar ganska ofta.
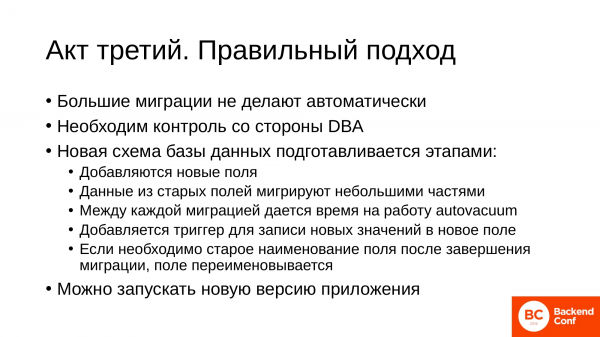
- Sådana stora migreringar görs inte automatiskt. De måste alltid övervakas.
- Det behövs kontroll från en kunnig person. Om du har en DBA i teamet, låt denne göra det. Det är deras jobb. Om inte, så bör den mest erfarna personen som vet hur man arbetar med databaser göra det.
- Den nya databasschemat, även om vi uppdaterar en kolumn, förbereder vi alltid i steg, dvs. i förväg innan den nya versionen av applikationen rullas ut:
- Nya fält läggs till där vi kommer att lagra de uppdaterade data.
- Vi flyttar data från det gamla fältet till det nya fältet i små delar. Varför gör vi detta? För det första kontrollerar vi alltid processen under den här processen. Vi vet att vi redan har flyttat så och så många batchar och har så och så många kvar.
- En annan positiv effekt är att vi mellan varje sådan batch stänger en transaktion, öppnar en ny, och detta ger möjligheten för autovakuumet att arbeta på tabellen, märka döda rader för återanvändning.
- För rader som kommer att dyka upp under applikationens gång (vår gamla applikation kör fortfarande) lägger vi till en trigger som skriver nya värden i de nya fälten. I vårt fall – det innebär multiplikation med hundra av det gamla värdet.
- Om vi är helt envisa och vill ha samma fält, så vid slutet av alla migreringar och innan vi rullar ut den nya versionen av applikationen, byter vi helt enkelt namn på fälten. De gamla till ett påhittat namn och de nya fälten byter vi namn till gamla.
- Och först efter detta lanserar vi den nya versionen av applikationen.
Och på så sätt kommer vi inte att få bloat och vi kommer inte att få en sänkning av prestanda.
Här avslutades den tredje historien.
Och nu ska vi gå lite mer in på verktygen som jag nämnde i den allra första historien.
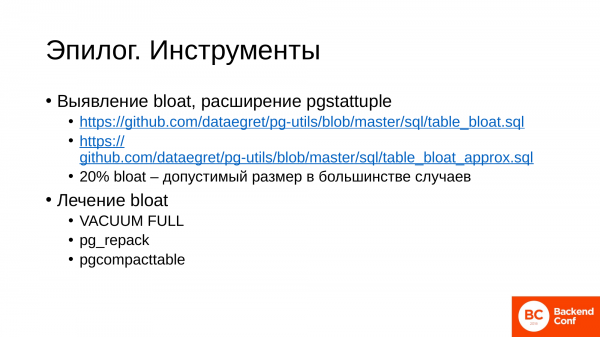
Innan du börjar leta efter bloat, bör du definitivt installera tillägget .
För att ni inte ska behöva hitta på frågorna själva, har vi redan skrivit dessa frågor i vårt arbete. Ni kan använda dem. Här presenteras två frågor.
- Den första tar ganska lång tid att köra, men den ger dig exakta värden för bloat i tabellen.
- Den andra går snabbare och är mycket effektiv när du behöver göra en snabb bedömning – finns det bloat eller inte i tabellen. Och du bör också förstå att bloat i en Postgres-tabell alltid finns. Det är en egenhet av dess MVCC-modell.
- Och 20 % bloat är normalt för tabeller i de flesta fall. Det vill säga, du behöver inte oroa dig och komprimera denna tabell.
Hur man identifierar tabeller som har svällt, det har vi klargjort, särskilt när de har svällt med onödiga data.
Nu om hur man åtgärdar bloat:
- Om vi har en liten tabell och bra diskar, det vill säga för en tabell under en gigabyte går det bra att använda VACUUM FULL. Det kommer att ta en exklusiv lås på tabellen i några sekunder och sen klarar det allt snabbt och effektivt. Vad gör VACUUM FULL? Det tar en exklusiv lås på tabellen och kopierar levande rader från gamla tabeller till en ny tabell. Och i slutet byter det plats på dem. Gamla filer tas bort, nya sätts istället för de gamla. Men under sin operation tar det en exklusiv lås på tabellen. Det betyder att du inte kan göra något med denna tabell: varken skriva till den, läsa från den eller modifiera den. Och VACUUM FULL kräver extra diskutrymme för att lagra data.
- Nästa verktyg . I sin funktion är det mycket lik VACUUM FULL, eftersom det också kopierar data från gamla filer till nya och byter ut dem i tabellen. Men det tar inte en exklusiv lås på tabellen i början av sin operation, utan gör det först när det har färdiga data för att byta ut filerna. Diskresurskraven är liknande VACUUM FULL. Du behöver extra utrymme på disken, vilket ibland kan vara kritiskt om du har terabyte-stora tabeller. Och det är ganska resurskrävande på processorn, eftersom det arbetar aktivt med in- och utdata.
- Det tredje verktyget är . Den hanterar resurser på ett mer varsamt sätt eftersom den fungerar enligt något andra principer. Huvudpoängen med pgcompacttable är att den vid uppdateringar flyttar alla levande rader till början av tabellen. Och sedan kör den vacuum på denna tabell, eftersom vi vet att vi har levande rader i början och döda rader i slutet. Vacuum skär sedan bort den svansen, det vill säga att det inte kräver mycket extra diskutrymme. Dessutom kan det också optimeras för resurser.
Allt med verktygen.
Om du tycker att ämnet med bloat är intressant och vill gräva djupare, här är några användbara länkar:
- – det är en presentation av min kollega. Den handlar allmänt om vart utrymmet tar vägen i Postgres under dess arbete och liv. Och det finns en väldigt stor och detaljerad teknisk del för databasadministratörer om bloat.
- – det är en länk till vårt repository, där vi lagrar en massa användbara skript för att kontrollera databasens tillstånd. Där kan du hitta skript för att söka efter bloat.
- och länkar till verktyg som hjälper dig att optimera tabeller.
- – det är ett inlägg av min kollega. Där går han ganska seriöst och detaljerat in på bloat på en nivå nära databasadministratörer.
Jag har här försökt att visa en skrämselhicka för utvecklarna, eftersom de är våra direkta kunder till databaser och måste förstå vilka konsekvenser olika handlingar kan leda till. Jag hoppas att jag lyckades. Tack för uppmärksamheten!
Frågor
Tack för presentationen! Du pratade om hur man kan identifiera problem. Men hur kan man förhindra dem? Det vill säga, jag hade en situation där förfrågningar hängde inte bara för att de kontaktade externa tjänster. Det var bara några galna joins. Det fanns några små harmlösa förfrågningar som hängde i ett dygn och sedan började skapa kaos. Det liknar mycket det du beskriver. Hur kan man övervaka detta? Ska man ständigt sitta och kolla vilken förfrågan som hänger? Hur kan man förhindra detta?
I det här fallet är det en uppgift för administratörerna i ditt företag, inte nödvändigtvis för DBA.
Jag är administratör.
I PostgreSQL finns det en vy som heter pg_stat_activity, där hängande förfrågningar visas. Och du kan se hur länge den har hängt där.
Måste jag gå in och kolla var femte minut?
Ställ in cron och kontrollera. Om du har en långvarig begäran, skriv ett mail och allt. Det vill säga, du behöver inte titta med ögonen, det går att automatisera. Du får ett mail, och du reagerar på det. Eller så kan du avfyra det automatiskt.
Finns det uppenbara orsaker till varför detta händer?
Jag har nämnt några. Andra mer komplexa exempel. Och diskussionen kan ta lång tid.
Tack för presentationen! Jag ville klargöra kring verktyget pg_repack. Om det inte gör en exklusiv låsning, då…
Det gör en exklusiv låsning.
… ...kan jag potentiellt förlora data. Ska min applikation inte registrera något under den tiden?
Nej, den fungerar lugnt med tabellen, det vill säga pg_repack flyttar först alla levande rader som finns. Självklart sker det någon registrering i tabellen. Den lägger bara till den sista biten.
Det vill säga, gör den i slutänden faktiskt?
I slutet tar den en exklusiv låsning för att byta plats på de här filerna.
Kommer det att gå snabbare än VACUUM FULL?
VACUUM FULL, när det startade, tog direkt en exklusiv låsning. Och förrän den har gjort allt, släpper den den inte. Och pg_repack tar en exklusiv låsning endast vid tidpunkten för filbyten. Just då kan du inte skriva dit, men alla data går inte förlorade, allt kommer att vara i ordning.
Hej! Du pratade om hur autovacuum fungerar. Det fanns en graf med röda, gula och gröna celler. Det vill säga, de gula – han markerade dem som raderade. Och följaktligen kan man skriva något nytt i dem?
Ja. Postgres tar inte bort rader. Det är dess specifikation. Om vi uppdaterar en rad, markerar vi den gamla som raderad. Där sätts id för transaktionen som ändrade den raden, och vi skriver in en ny rad. Och vi har sessioner som potentiellt kan läsa dem. Vid någon tidpunkt blir de helt gamla. Och syftet med autovacuum är att den går igenom dessa rader och markerar dem som onödiga. Och dit kan man skriva om data.
Jag förstår. Men frågan handlar lite inte om det. Jag har inte avslutat. Låt oss anta att vi har en tabell. Den har fält med variabel storlek. Och om jag försöker sätta in något nytt kan det kanske inte få plats i den gamla cellen.
Nej, hela raden uppdateras oavsett. Postgres har två datalagermodeller. Den väljer baserat på datatyp. Det finns data som lagras direkt i tabellen, och så finns det tos-data. Det handlar om stora datamängder: text, json. De lagras i separata tabeller. Och i dessa tabeller händer samma sak med bloat, det vill säga exakt samma sak. De är bara separerade.
Tack för presentationen! Hur acceptabelt är det att använda statement timeout för att begränsa längden på förfrågningar?
Mycket acceptabelt. Vi använder det överallt. Och eftersom vi inte har våra egna tjänster, utan erbjuder fjärrsupport, så finns det en ganska varierad kundbas. Alla är ganska nöjda med det. Det finns cron-jobb som gör kontroller. Det diskuteras helt enkelt längden på sessionerna med kunden, innan vi avslutar dem. Det kan vara en minut, det kan vara 10 minuter. Det beror på belastningen på databasen och dess syfte. Men vi använder pg_stat_activity för alla.
Tack för presentationen! Jag försöker anpassa din presentation till mina applikationer. Och det verkar som om vi alltid startar en transaktion, och alltid avslutar den. Om något undantag inträffar, så sker rollback ändå. Och här började jag fundera. En transaktion kan ju startas implicit. Det är nog en vink till tjejen. Om jag bara gör en uppdatering av en post, startar transaktionen i PostgreSQL och avslutas den först när anslutningen kopplas ur?
Om du pratar om applikationsnivån nu, så beror det på vilken drivrutin du använder, vilken ORM som används. Det finns mycket inställningar. Om auto commit är aktiverat då startar och avslutas transaktionen direkt.
Det vill säga, avslutas den genast efter uppdateringen?
Det beror på inställningarna. Jag nämnde en inställning. Denna auto commit. Den är ganska utbredd. Om den är aktiverad så öppnas och stängs transaktionen. Om du inte uttryckligen sa "start transaction" och "end transaction", utan bara körde en fråga i sessionen.
Hej! Tack för presentationen! Tänk att vi har en databas som växer och växer och nu tar det slut på utrymmet på servern. Finns det några verktyg för att åtgärda denna situation?
Utrymmet på servern bör helst övervakas.
Till exempel, om DBA får en kopp kaffe, var på semester, osv.
När ett filsystem skapas, så reserveras åtminstone en del utrymme där inga data skrivs.
Och om det blir helt noll?
Det kallas reserverat utrymme, vilket innebär att det kan frigöras och beroende på hur stort det är, så får ni ledigt utrymme. Jag vet inte hur mycket det är som standard. I ett annat fall kan man behöva leverera diskar för att ha tillräckligt med utrymme för att utföra återställningsoperationen. Man kan ta bort en tabell som man garanterat inte behöver.
Finns det andra verktyg?
Det är alltid manuellt arbete. Man ser på plats vad som är bäst att göra, eftersom det finns kritiska och icke-kritiska data. Och för varje databas och tillämpning som arbetar med den beror det på företaget. Beslutet fattas alltid på plats.
Tack för presentationen! Jag har två frågor. För det första, ni visade bilder där ni visade att vid hängande transaktioner ökar både storleken på tabellutrymmet och storleken på indexet. Och längre fram i presentationen fanns många verktyg som packar tabellen. Men vad händer med indexet?
De packar också.
Men vakuum påverkar inte indexet?
Vissa verktyg arbetar med indexet. Till exempel pg_rapack, pgcompacttable. Vakuum återskapar index, det påverkar dem. Syftet med VACUUM FULL är att skriva om allt, det arbetar med allt.
Och den andra frågan. Jag förstod inte varför rapporter på repliker så starkt beror på själva replikeringen. Jag hade för mig att rapporter är läsning och replikering är skrivning.
Var uppstår konflikten vid replikering? Vi har en Master där processerna sker. Vi har en autovakuumprocess. Vad gör autovakuum egentligen? Det tar bort gamla rader. Om vi har en begäran på repliken under tiden som läser dessa gamla rader, och på Master har det hänt att autovakuum markerat dessa rader som möjliga för överskrivning, så har vi skrivit om dem. När ett paket data kommer och vi måste skriva om de rader som begäran på repliken behöver, då kommer replikationsprocessen att vänta på den timeout ni har ställt in. Sedan kommer PostgreSQL att avgöra vad som är viktigare för den. Och replikeringen är viktigare än begäran, och den kommer att avbryta begäran för att genomföra dessa ändringar på repliken.
Andrey, jag har en fråga. Är de här fantastiska diagrammen du visade under presentationen resultatet av något av dina verktyg? Hur konstruerades diagrammen?
Detta är en tjänst .
Är detta en kommersiell produkt?
Ja. Det är en kommersiell produkt.
Källa: habr.com
