

Nyligen stötte jag på en ganska ovanlig uppgift att ställa in routing för MetalLB. Det skulle inte vara något problem, eftersom det vanligtvis inte krävs några extra åtgärder för MetalLB, men i vårt fall har vi en ganska stor kluster med en ganska enkel nätverkskonfiguration.
I denna artikel kommer jag att berätta hur man ställer in source-based och policy-based routing för det externa nätverket i din kluster.
Jag kommer inte att gå in på installation och konfiguration av MetalLB i detalj, eftersom jag utgår från att du redan har viss erfarenhet. Låt oss gå direkt till saken, nämligen konfigurationen av routingen. Så vi har fyra fall:
Fall 1: När ingen konfigurering krävs
Låt oss gå igenom ett enkelt fall.
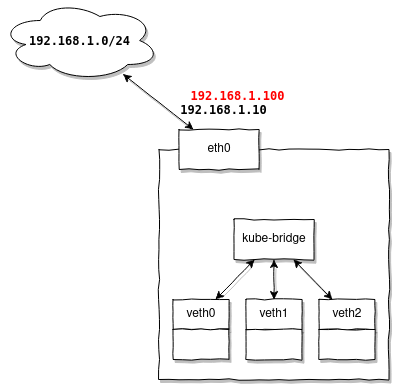
Ytterligare routing konfiguration krävs inte när de adresser som MetalLB tillhandahåller ligger i samma subnet som adresserna för dina noder.
Till exempel har du ett subnet 192.168.1.0/24, det finns en router 192.168.1.1, och dina noder får adresser: 192.168.1.10-30, då kan du för MetalLB konfigurera intervallet 192.168.1.100-120 och vara säker på att de kommer att fungera utan någon ytterligare konfiguration.
Varför så? För att dina noder redan har konfigurerade rutter:
# ip route
default via 192.168.1.1 dev eth0 onlink
192.168.1.0/24 dev eth0 proto kernel scope link src 192.168.1.10
Och adresser från samma intervall kommer att återanvända dem utan några ytterligare åtgärder.
Fall 2: När ytterligare konfiguration krävs
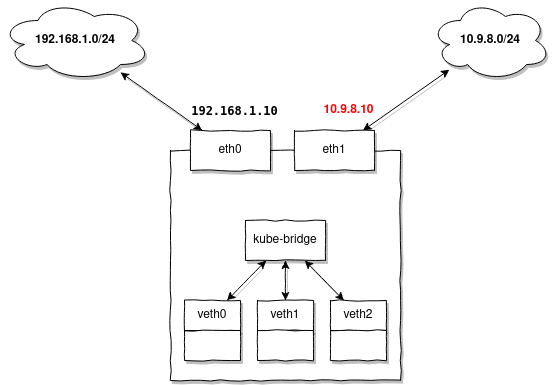
Du bör ställa in ytterligare rutter varje gång dina noder inte har en konfigurerad IP-adresser eller rutt till subnätet för vilket MetalLB tillhandahåller adresser.
Låt mig förklara lite mer ingående. Varje gång MetalLB tillhandahåller en adress kan det liknas vid en enkel tilldelning som:
ip addr add 10.9.8.7/32 dev loObservera att:
- a) Adressen tilldelas med prefix
/32vilket betyder att rutt till subnätet för den automatiskt inte kommer att läggas till (det är bara en adress) - b) Adressen kopplas till vilken nodens gränssnitt som helst (till exempel loopback). Här är det värt att nämna hur Linux-nätverksstacks funktioner. Det spelar ingen roll vilket gränssnitt du lägger till adressen, kärnan kommer alltid att hantera arp-förfrågningar och skicka arp-svar på vilket som helst av dem, detta beteende anses vara korrekt och dessutom används det ganska ofta i en dynamisk miljö som Kubernetes.
Detta beteende kan konfigureras, till exempel genom att aktivera strikt arp:
echo 1 > /proc/sys/net/ipv4/conf/all/arp_ignore
echo 2 > /proc/sys/net/ipv4/conf/all/arp_announce
I det här fallet kommer arp-svar endast att skickas om gränssnittet uttryckligen innehåller en specifik IP-adress. Denna inställning är obligatorisk om du planerar att använda MetalLB och din kube-proxy fungerar i IPVS-läge.
MetalLB använder dock inte kärnan för att bearbeta arp-förfrågningar, utan gör det själv i användarläget, så denna alternativ kommer inte att påverka MetalLB:s funktion.
Låt oss återvända till vår uppgift. Om det inte finns någon rutt för de tilldelade adresserna på dina noder, lägg till den i förväg på alla noder:
ip route add 10.9.8.0/24 dev eth1Fall 3: När du behöver source-based routing
Source-based routing behöver du konfigurera när du tar emot paket genom en separat gateway, inte den som är inställd som standard, så att svarspaketen också måste gå genom denna gateway.
Till exempel har du samma subnet 192.168.1.0/24 tilldelat för dina noder, men du vill tilldela externa adresser med hjälp av MetalLB. Anta att du har flera adresser från subnettet 1.2.3.0/24 som ligger i VLAN 100, och du vill använda dem för att få åtkomst till Kubernetes-tjänster utifrån.
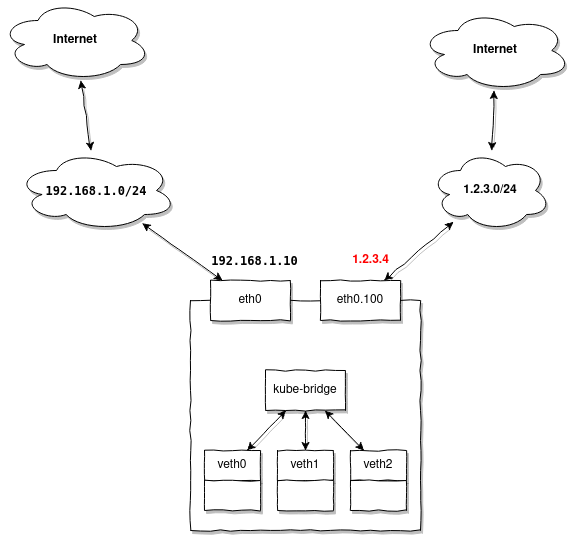
När du gör en förfrågan till 1.2.3.4 gör du förfrågningar från ett annat subnet än 1.2.3.0/24 och väntar på svar. Den nod som för tillfället är master för den tilldelade MetalLB-adressen 1.2.3.4, kommer att ta emot paket från routern 1.2.3.1, men svaret måste nödvändigtvis skickas tillbaka samma väg, genom 1.2.3.1.
Eftersom vår nod redan har en inställd default gateway 192.168.1.1, så kommer svaret som standard att gå dit, och inte till 1.2.3.1, genom vilken vi tog emot paketet.
Hur hanterar vi denna situation?
I det här fallet måste du förbereda alla dina noder så att de är redo att hantera externa adresser utan ytterligare konfiguration. Det vill säga för det ovanstående exemplet måste du i förväg skapa ett VLAN-gränssnitt på noden:
ip link add link eth0 name eth0.100 type vlan id 100
ip link set eth0.100 up
Och sedan lägga till rutter:
ip route add 1.2.3.0/24 dev eth0.100 table 100
ip route add default via 1.2.3.1 table 100
Observera att rutter vi lägger till i en separat routingtabell 100 den kommer endast att innehålla två rutter som är nödvändiga för att skicka svarspaketet genom gateway 1.2.3.1, som ligger bakom gränssnittet eth0.100.
Nu behöver vi lägga till en enkel regel:
ip rule add from 1.2.3.0/24 lookup 100som tydligt säger: om källadressen för paketet ligger i 1.2.3.0/24, då ska routingtabellen användas 100. I den har vi redan beskrivit en väg som skickar den genom 1.2.3.1
Fall 4: När policy-baserad routing behövs
Nätverks Topologi som i det föregående exemplet, men låt oss säga att du också vill ha möjligheten att komma åt externa adresser i poolen 1.2.3.0/24 från dina pods:
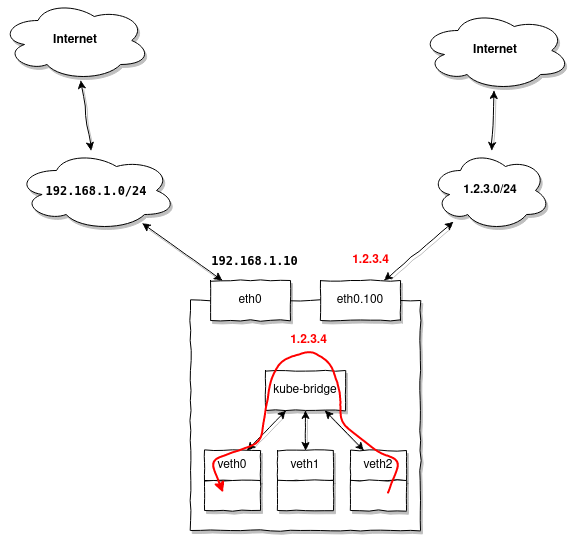
Det unika är att när man kontaktar en adress i 1.2.3.0/24, kommer svaret att nå noden och ha källaadressen inom området 1.2.3.0/24 och kommer lydigt att skickas till eth0.100, men vi vill att Kubernetes ska omdirigera det till vår första podd som initialt genererade förfrågan.
Att lösa detta problem visade sig vara utmanande, men det blev möjligt tack vare policy-baserad routing:
För att bättre förstå processen, låt mig ge dig ett flödesschema för netfilter:
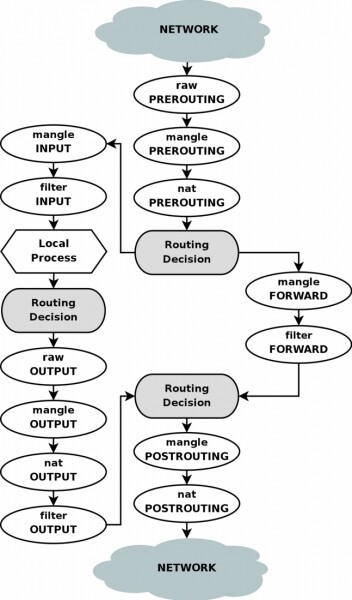
Först, som i det föregående exemplet, låt oss skapa en extra routingtabell:
ip route add 1.2.3.0/24 dev eth0.100 table 100
ip route add default via 1.2.3.1 table 100
Nu lägger vi till några regler i iptables:
iptables -t mangle -A PREROUTING -i eth0.100 -j CONNMARK --set-mark 0x100
iptables -t mangle -A PREROUTING  -j CONNMARK --restore-mark
iptables -t mangle -A PREROUTING -m mark ! --mark 0 -j RETURN
iptables -t mangle -A POSTROUTING -j CONNMARK --save-mark
Dessa regler kommer att märka inkommande anslutningar på gränssnittet eth0.100, märkning av alla paket med taggen 0x100, samma tagg kommer också att användas för svaren inom en och samma anslutning.
Nu kan vi lägga till en routingregel:
ip rule add from 1.2.3.0/24 fwmark 0x100 lookup 100Det vill säga alla paket med källaadressen 1.2.3.0/24 och taggen 0x100 ska routas med hjälp av tabellen 100.
Således kommer andra paket som tas emot på ett annat gränssnitt inte att omfattas av denna regel, vilket tillåter dem att routas med standardmetoderna i Kubernetes.
Det finns en annan aspekt, i Linux finns det så kallad reverse path filter som ställer till det genom att utföra en enkel kontroll: för alla inkommande paket ändrar den källaadressen i paketet med avsändarens adress och kontrollerar om paketet kan skickas ut genom samma gränssnitt som det mottogs på, om inte, filtreras det.
Problemet är att det i vårt fall kommer att fungera inkorrekt, men vi kan stänga av det:
echo 0 > /proc/sys/net/ipv4/conf/all/rp_filter
echo 0 > /proc/sys/net/ipv4/conf/eth0.100/rp_filter
Observera att det första kommandot kontrollerar det globala beteendet hos rp_filter, om det inte stängs av, kommer det andra kommandot inte att ha någon effekt. Ändå kommer de andra gränssnitten att förbli med rp_filter aktiverat.
För att inte helt begränsa fungerar filtret kan vi använda implementeringen rp_filter för netfilter. Genom att använda rpfilter som en iptables-modul kan man ställa in ganska flexibla regler, till exempel:
iptables -t raw -A PREROUTING -i eth0.100 -d 1.2.3.0/24 -j RETURN
iptables -t raw -A PREROUTING -i eth0.100 -m rpfilter --invert -j DROP
aktivera rp_filter på gränssnittet eth0.100 för alla adresser utom 1.2.3.0/24.
Källa: habr.com
