

Alla gott!
Jag heter Nikita och är teamledare för ingenjörerna på Cian. En av mina uppgifter i företaget är att minska antalet incidenter relaterade till infrastrukturen i produktion till noll.
Det som kommer att diskuteras här har orsakat oss mycket smärta, och målet med denna artikel är att förhindra andra från att upprepa våra misstag eller åtminstone minimera deras påverkan.
Inledning
Länge sedan, när Cian bestod av monoliter och det inte fanns några indikationer på mikrotjänster, mätte vi tillgängligheten av resurser genom att kontrollera 3–5 sidor.
Svarar de — allt är bra, svarar de inte under en längre tid — alarm. Hur länge de ska vara nere för att det ska räknas som en incident avgjordes av folk på möten. Ingenjörsteamet deltog alltid i utredningen av incidenten. När utredningen var klar skrev vi en postmortem — en slags rapport som skickades via e-post i formatet: vad som hände, hur länge det varade, vad man gjorde i stunden, vad vi kommer att göra i framtiden.
Huvudsidorna på webbplatsen eller hur vi vet att vi har nått botten
För att kunna förstå prioriteten av fel har vi identifierat de mest kritiska sidorna för affärsfunktionaliteten på webbplatsen. Genom dem räknar vi antalet lyckade/olyckade förfrågningar och tidsöverskridanden. På så sätt mäter vi uptime.
Anta att vi har kommit fram till att det finns ett antal superviktiga delar av webbplatsen som ansvarar för huvudservicen — sökning och publicering av annonser. Om antalet förfrågningar som avslutades med ett fel överstiger 1% — är det en kritisk incident. Om felprocenten under 15 minuter i primetime överstiger 0,1% — då räknas det också som en kritisk incident. Dessa kriterier täcker merparten av incidenterna, medan andra ligger utanför ramen för denna artikel.
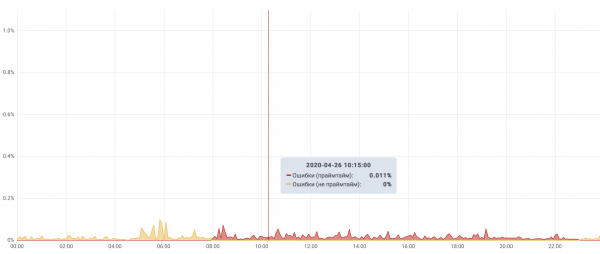
Topp bästa incidenterna på Cian
Så vi har definitivt lärt oss att identifiera när en incident har inträffat.
Nu är varje incident detaljerat beskriven och återspeglas i en epic i Jira. För övrigt: för detta har vi skapat ett separat projekt, som vi kallade FAIL — där man endast kan skapa epics.
Om man samlar alla misslyckanden från de senaste åren, så ligger följande i topp:
- incidenter relaterade till mssql;
- incidenter orsakade av externa faktorer;
- adminfel.
Vi kommer att stanna vid adminfelen mer i detalj, samt några andra intressanta misslyckanden.
Femte plats — "Vi ordnar upp i DNS"
Det var en ruggig tisdag. Vi bestämde oss för att organisera DNS-klustret.
Vi ville migrera interna DNS-servrar från bind till powerdns, och avsatte helt separata servrar för detta, där det endast fanns DNS.
Vi placerade en DNS-server i varje plats i våra datacenter, och nu kom stunden att flytta zonerna från bind till powerdns och byta infrastrukturen till de nya servrarna.
I den mest intensiva fasen av flytten, servrar, som som angivits i lokala cachande bind-servrar på alla servrar, återstod bara en, som låg i datacentret i Sankt Petersburg. Detta datacenter hade från början deklarerats som icke-kritiskt för oss, men blev plötsligt en single point of failure.
Just under denna flytt kraschade kanalen mellan Moskva och Sankt Petersburg. Vi befann oss faktiskt utan DNS i fem minuter och återhämtade oss när hostingleverantören problemen åtgärdades.
Slutsatser:
Tidigare har vi åsidosatt externa faktorer när vi förberett oss för arbetet, men nu har vi även inkluderat dem i listan över vad vi förbereder oss på. Och nu strävar vi efter att alla komponenter är reservdelar n-2, och under arbetets gång kan vi sänka denna nivå till n-1.
- Under upprättandet av handlingsplanen, markera punkter där tjänsten kan falla och tänk igenom scenarier där allt går "fruktansvärt fel" i förväg.
- Distribuera interna DNS-servrar över olika geolokationer/datacenter/ställ/omkopplare/inmatningar.
- Installera en lokal cachande DNS-server på varje server, som omdirigerar förfrågningar till de primära DNS-servrarna, och i händelse av att den inte är tillgänglig kommer den att svara från cachen.
Fjärde plats — "Ordning i Nginx"
En vacker dag bestämde vårt team att "det är nog nu", och processen för refaktorering av nginx-konfigurationerna startade. Huvudmålet var att ge konfigurationerna en intuitivt begriplig struktur. Tidigare var allt "historiskt betingat" och bar ingen logik. Nu har vi flyttat varje server_name till en namngiven fil och sorterat alla konfigurationer i mappar. För övrigt innehåller konfigurationen 253949 rader eller 7836520 tecken och är nästan 7 megabyte stor. Den övergripande strukturens nivå:
Nginx-struktur
├── access
│   ├── allow.list
...
│   └── whitelist.conf
├── geobase
│   ├── exclude.conf
...
│   └── geo_ip_to_region_id.conf
├── geodb
│   ├── GeoIP.dat
│   ├── GeoIP2-Country.mmdb
│   └── GeoLiteCity.dat
├── inc
│   ├── error.inc
...
│   └── proxy.inc
├── lists.d
│   ├── bot.conf
...
│   ├── dynamic
│   └── geo.conf
├── lua
│   ├── cookie.lua
│   ├── log
│   │   └── log.lua
│   ├── logics
│   │   ├── include.lua
│   │   ├── ...
│   │   └── utils.lua
│   └── prom
│       ├── stats.lua
│       └── stats_prometheus.lua
├── map.d
│   ├── access.conf
│   ├── ..
│   └── zones.conf
├── nginx.conf
├── robots.txt
├── server.d
│   ├── cian.ru
│   │   ├── cian.ru.conf
│   │   ├── ...
│   │   └── my.cian.ru.conf
├── service.d
│   ├── ...
│   └── status.conf
└── upstream.d
    ├── cian-mcs.conf
    ├── ...
    └── wafserver.conf
Det har blivit betydligt bättre, men under omdöpning och fördelning av konfigar fick en del av dem fel filändelse och kom inte med i direktivet include *.conf. Som en följd av detta blev vissa värdar otillgängliga och återgav 301 till startsidan. Eftersom svarskoden inte var 5xx/4xx, märkte vi det inte genast, utan först på morgonen. Efter detta började vi skriva tester för att kontrollera infrastrukturkomponenter.
Slutsatser:
- Strukturera konfigurationerna korrekt (inte bara nginx) och tänk igenom strukturen i ett tidigt skede av projektet. På så sätt gör du dem mer begripliga för teamet, vilket i sin tur minskar TTM.
- Skriv tester för vissa infrastrukturkomponenter. Till exempel: kontrollera att alla viktiga server_name ger rätt status, + svarstext. Det räcker att ha bara några skript till hands som kontrollerar de grundläggande funktionerna i komponenten, så att du inte panikartat ska försöka komma ihåg vad mer som behöver kontrolleras mitt i natten.
Tredje plats — "Plötsligt tog det slut på utrymme i Cassandra"
Data växte stadigt, och allt gick bra tills det ögonblick då reparationen av stora keyspaces i Cassandra-klustret började misslyckas, eftersom de inte kan genomföra kompaktion.
En blödig dag nästan förvandlades klustret till en pumpa, nämligen:
- det återstod cirka 20% totalt i klustret;
- det går inte att helt lägga till noder, eftersom cleanup inte genomförs efter att noder lagts till på grund av brist på utrymme på partitionerna;
- prestandan faller försiktigt, eftersom kompaktionen inte fungerar;
- klustret arbetar i nödläge.
Utträde – vi har lagt till ytterligare 5 noder utan rensning, efter vilket vi började systematiskt ta bort från klustret och sedan återinföra, som tomma noder, där det inte fanns något utrymme kvar. Tiden som lagts ner har varit betydligt mer än vi hade önskat. Det fanns en risk för delvis eller fullständig otillgänglighet av klustret.
Slutsatser:
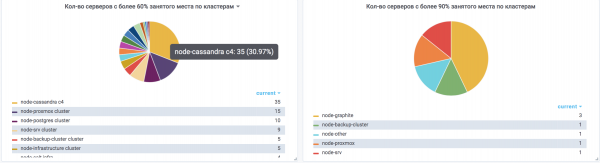
- På alla servrar med Cassandra bör högst 60% av utrymmet vara använt på varje partition.
- De bör vara belastade till högst 50% av CPU.
- Man bör inte bortse från kapacitetsplanering och det måste övervägas för varje komponent beroende på dess specifika behov.
- Ju fler noder i klustret, desto bättre. Servrar som innehåller en liten mängd data får snabbare omstart, och ett sådant kluster är lättare att återställa.
Andra plats – 'Data försvann från consul key-value storage'
För tjänsteupptäckten använder vi, precis som många andra, Consul. Men vi använder även dess key-value för blue-green deployment av monoliten. Där lagras information om aktiva och inaktiva upstreams, som byter plats under deployment. För detta har en deploymenttjänst skrivits som interagerade med KV. Vid något tillfälle försvann data från KV. Vi återställde det från minnet, men med vissa fel. Som en följd av detta blev belastningen på upstreams ojämt fördelad under distributionen, och vi fick många 502-fel på grund av överbelastning av backend-maskinerna på CPU. I slutändan flyttade vi från Consul KV till Postgres, därifrån är det inte så lätt att ta bort dem.
Slutsatser:
- Tjänster utan någon form av autentisering bör inte innehålla kritiska uppgifter för webbplatsens funktion. Till exempel, om du inte har autentisering i ES – skulle det vara bäst att förbjuda åtkomst på nätverksnivå från alla platser där det inte behövs, lämna endast de nödvändiga och dessutom göra action.destructive_requires_name: true.
- Öva på mekanismen för säkerhetskopiering och återställning i förväg. Till exempel, skapa ett skript (till exempel på Python) som kan både säkerhetskopiera och återställa.
Första plats – 'Kapten Otydlighet'
Vid något tillfälle märkte vi en ojämn belastning på nginx upstreams när det fanns fler än 10 servrar i backend. Eftersom round-robin dirigerade förfrågningar från den första till den sista upstream i ordning, och varje reload av nginx började från början, fick de första upstreams alltid fler förfrågningar än de andra. Som ett resultat arbetade de långsammare och hela webbplatsen drabbades. Detta blev allt mer påtagligt i takt med att trafiken ökade. Att bara uppdatera nginx för att inkludera random fungerade inte — vi var tvungna att göra om en massa lua-kod som inte gick att använda i version 1.15 (vid den tidpunkten). Vi var tvungna att patcha vår nginx 1.14.2 och införa stöd för random. Detta löste problemet. Denna bugg vinner i kategorin 'kapten uppenbarhet'.
Slutsatser:
Det var mycket intressant och spännande att undersöka denna bugg).
- Bygg en övervakning som hjälper till att snabbt upptäcka liknande fluktuationer. Till exempel kan man använda ELK för att övervaka rps för varje backend av varje upstream, och följa deras svarstider ur nginx:s perspektiv. I det här fallet hjälpte det oss att identifiera problemet.
De flesta av felen kunde ha undvikits med en mer noggrann inställning till det man gör. Man måste alltid komma ihåg Murphys lag: Anything that can go wrong will go wrong, och bygga komponenter med den i åtanke.
Källa: habr.com
