

Heisenbergs osäkerhetsprincip säger att man inte kan mäta ett objekts position och dess hastighet samtidigt. Om objektet rör sig så har det ingen position. Om det finns en position – då har det ingen hastighet.
När det kommer till mikrotjänster på Red Hat OpenShift-plattformen (som drivs av Kubernetes), kan de tack vare lämplig öppen mjukvara rapportera både sin prestanda och sitt tillstånd samtidigt. Detta motbevisar förstås inte den gamla Heisenberg, men det eliminerar osäkerheten vid arbete med molnapplikationer. Istio gör det enkelt att organisera spårning och övervakning av sådana applikationer för att hålla allt under kontroll.
Vi bestämmer oss för terminologin
Pod spårning (Tracing) förstår vi som loggning av systemaktivitet. Det låter ganska allmänt, men en av de grundläggande reglerna här är att skicka spårningsdata till ett lämpligt lagringsutrymme utan att bekymra sig om deras formatering. Allt arbete med att söka och analysera data överlämnas till deras användare. I Istio används Jaeger spårningssystem som implementerar OpenTracing datamodellen.
Spår (Traces, och ordet "spår" används här i betydelsen "tecken", som i exempelvis ballistisk analys) kommer vi att kalla de data som helt beskriver en förfråga eller en arbetsenhet, som sagt, "från och med till tillbaka". Till exempel, allt som händer från det ögonblick användaren trycker på en knapp på en webbsida tills data returneras, inklusive alla involverade mikrotjänster. Man kan säga att ett spår helt och hållet beskriver (eller modellerar) förfrågans väg dit och tillbaka. I Jaeger gränssnittet bryts spåren ner i komponenter längs tidsaxeln, ungefär som en kedja kan delas upp i individuella länkar. Skillnaden är att istället för länkar består spåret av så kallade span.
Span – är intervallet från början av en arbetsenhet till dess avslutning. För att fortsätta analogin kan man säga att varje span representerar en individuell länk i kedjan. En span kan ha (eller inte ha) en eller flera underliggande spans. Som en följd av detta kommer den högsta nivån av span (root span) att ha samma totala varaktighet som det spår det hör till.
Övervakning övervakning av ditt system – med ögon, via UI eller automatiseringsverktyg. Grunden för övervakning ligger i spårningsdata. I Istio implementeras övervakning med hjälp av Prometheus och har en motsvarande UI. Prometheus stöder automatisk övervakning med hjälp av aviseringar Alerts och Alert Managers.
Vi lämnar snitt
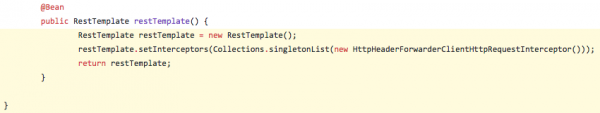
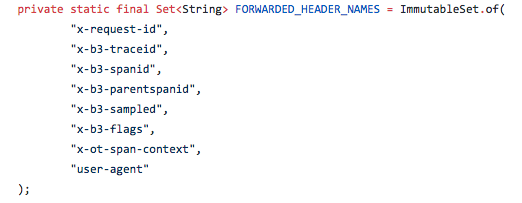
För att spårning ska vara möjlig måste applikationen skapa en samling av spans. Dessa måste exporteras till Jaeger, som i sin tur skapar en visuell representation av spårningen. Bland annat markerar dessa spans operationens namn, samt tidsstämplar för dess början och slut. Överföringen av spans sker genom att omdirigera HTTP-begärans huvuden som är avsedda för Jaeger från inkommande till utgående begärningar. Beroende på vilket programmeringsspråk som används kan detta kräva några mindre ändringar i applikationens källkod. Nedan följer ett exempel på Java-kod (vid användning av Spring Boot-ramverket) som lägger till B3 (Zipkin-stil) huvuden till din begäran i konfigurationsklassen i Spring:
Följande huvudinställningar används:
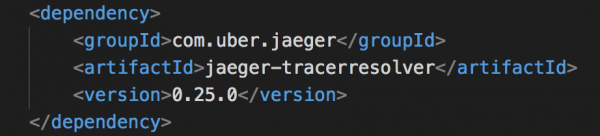
Om du använder Java kan du lämna koden oförändrad och i stället lägga till några rader i Maven POM-filen samt ange miljövariabler. Här är de rader som måste läggas till i POM.XML-filen för att integrera Jaeger Tracer Resolver:
Och de motsvarande miljövariablerna anges i Dockerfile:
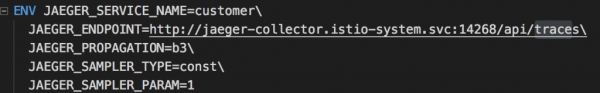
Nu är allt konfigurerat, och våra mikrotjänster kommer att börja generera spårningsdata.
Översiktligt
Istio inkluderar ett enkelt kontrollpanel baserat på Grafana. När allt är konfigurerat och fungerar på Red Hat OpenShift PaaS (i vårt exempel är Red Hat OpenShift och Kubernetes installerade på minishift), startas denna panel med följande kommando:
open "$(minishift openshift service grafana -u)\/d\/1\/istio-dashboard?refresh=5⩝Id=1"
Grafana-panelen gör det möjligt att snabbt utvärdera systemets prestanda. Ett utdrag av denna panel visas i bilden nedan:
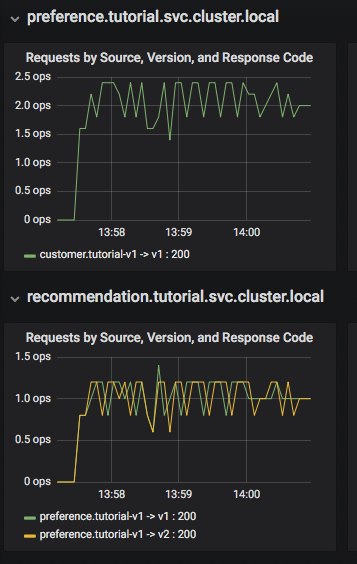
Här kan vi se att mikrotjänsten customer anropar mikrotjänsten preference v1, som i sin tur anropar mikrotjänsterna recommendation v1 och v2. På Grafana-panelen finns det ett Dashboard Row-block för hög nivå av metrik, såsom det totala antalet förfrågningar (Global Request Volume), andelen lyckade förfrågningar (success rates) samt 4xx-fel. Dessutom finns det en visning av Server Mesh med grafer för varje tjänst och ett block Services Row för att se detaljerad information om varje container för varje tjänst.
Nu dyker vi djupare.
Med en korrekt konfigurerad Istio-tracer kan du, så att säga, direkt ut ur lådan fördjupa dig i systemets prestandaanalys. I Jaeger UI kan du se spårningar och se hur långt och djupt de går, samt visuellt lokalisera flaskhalsar i prestandan. Vid användning av Red Hat OpenShift på minishift-plattformen startar du Jaeger UI med följande kommando:
minishift openshift service jaeger-query --in-browser
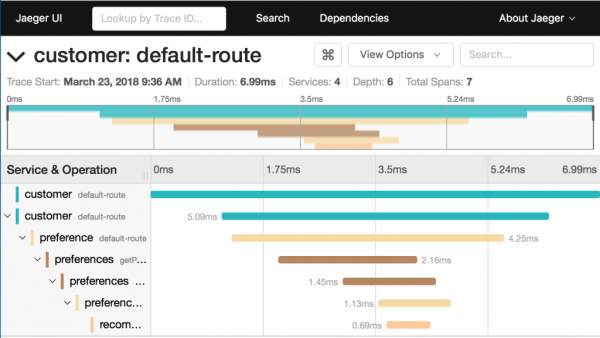
Vad kan vi säga om spårningen på den här skärmen:
- Den delas upp i 7 span.
- Den totala exekveringstiden är 6,99 ms.
- Mikrotjänsten recommendation, som är den sista i kedjan, tar 0,69 ms.
Denna typ av diagram gör det möjligt att snabbt förstå situationen när prestandan för hela systemet påverkas av en enda icke-fungerande tjänst.
Och nu komplicerar vi uppgiften genom att köra två instanser av mikrotjänsten recommendation:v2 med kommandot oc scale —replicas=2 deployment/recommendation-v2. Här är vad vi har efter detta när det gäller poddar:
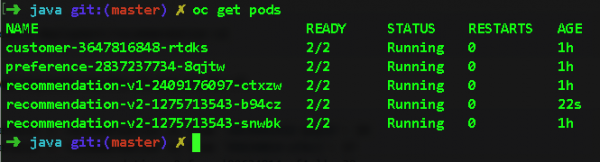
Om vi nu går tillbaka till Jaeger och expanderar span för tjänsten recommendation, kommer vi att se vilken pod förfrågningarna dirigeras till. På så sätt kan vi lätt lokalisera förseningar på nivån av en specifik pod. Titta på node_id-fältet:
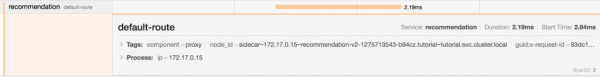
Var och hur allt går
Nu går vi till Prometheus-gränssnittet och ser ganska förväntat att förfrågningar mellan den andra och första versionen av tjänsten recommendation fördelas med en förhållande på 2:1, strikt baserat på antalet aktiva poddar. Detta diagram kommer att förändras dynamiskt när poddar skalas upp och ner, vilket är särskilt användbart vid Canary Deployment (vi kommer att titta närmare på detta deploymentschema nästa gång).
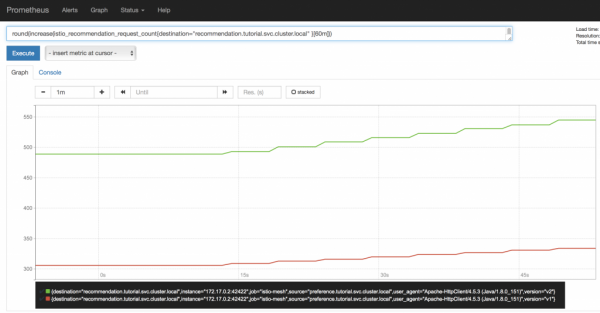
Det här är bara början
I själva verket har vi idag bara lätt berört en skatt av nyttig information om Jaeger, Grafana och Prometheus. Det var främst vårt syfte – att vägleda er i rätt riktning och öppna upp perspektiven för Istio.
Och kom ihåg, allt detta är redan inbyggt i Istio. Genom att använda vissa programmeringsspråk (till exempel Java) och ramverk (till exempel Spring Boot) kan allt detta implementeras utan att röra koden i applikationerna. Ja, koden måste modifieras något om du använder andra språk, framför allt Node.js eller C#. Men eftersom spårbarhet (läs: "tracing") är en av de obligatoriska kraven för att bygga pålitliga molnsystem, måste du i vilket fall som helst justera koden, oavsett om du har Istio eller inte. Så varför inte lägga ner ansträngningarna på ett mer meningsfullt sätt?
Åtminstone för att alltid kunna svara på frågorna "var?" och "hur snabbt?" med 100% säkerhet.
Kaosengineering i Istio: så var det tänkt
Att kunna bryta saker hjälper till att se till att de inte går sönder
Programvarutestning är inte bara komplicerat utan också viktigt. Samtidigt är testning för korrekthet (till exempel om en funktion returnerar rätt resultat) en sak, medan testning under opålitliga nätverksförhållanden är en helt annan uppgift (det antas ofta att nätverket alltid fungerar utan avbrott, och detta är en av åtta missuppfattningar om distribuerad computing). En av svårigheterna med att lösa detta problem är hur man kan simulera fel i systemet eller införa dem avsiktligt genom så kallad felinjektion. Detta kan göras genom att modifiera applikationens källkod. Men då testar du inte din ursprungliga kod, utan en version som speciellt simulerar fel. Som ett resultat riskerar du att hamna i de dödliga fällorna av felinjektion och konfronteras med gejserbuggar – fel som försvinner när man försöker upptäcka dem.
Och nu visar vi hur Istio hjälper till att hantera dessa svårigheter på ett ögonblick.
Så här ser det ut när allt fungerar perfekt
Låt oss överväga följande scenario: vi har två poddar för vår mikrotjänst recommendation, som vi tog från Istio-handboken. En podd är märkt som v1, och den andra som v2. Som vi ser fungerar allt utmärkt tills vidare:
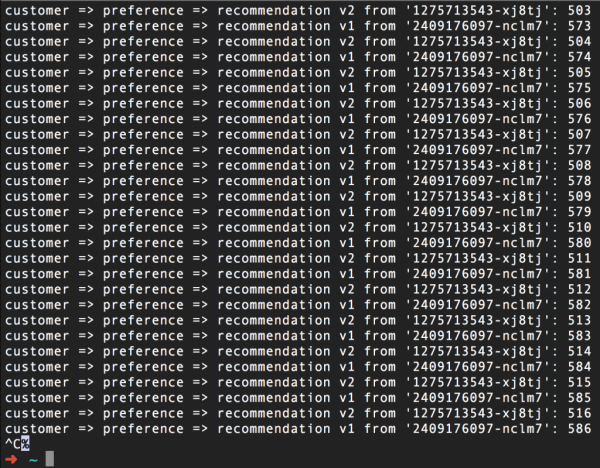
(För övrigt är numret till höger bara en räknare för varje pod.)
Men vi behöver ju inte detta, eller hur? Låt oss försöka bryta allt utan att röra koden.
Vi skapar avbrott i mikrotjänsten
Nedan finns en yaml-fil för routingregeln i Istio, som i hälften av fallen kommer att ge ett fel (fel) servern 503):
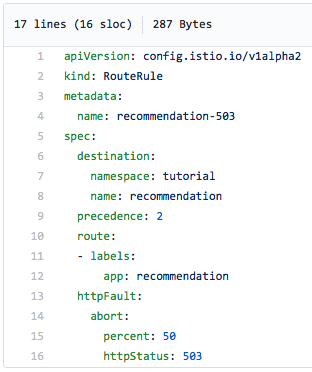
Observera att vi uttryckligen anger att ett 503-fel ska returneras i hälften av fallen.
Så här ser skärmbilden ut för den curl-kommando som körs i en loop efter att vi aktiverar denna regel för att simulera avbrott. Som vi ser, returnerar hälften av förfrågningarna ett 503-fel oavsett vilken pod – v1 eller v2 – de går till:
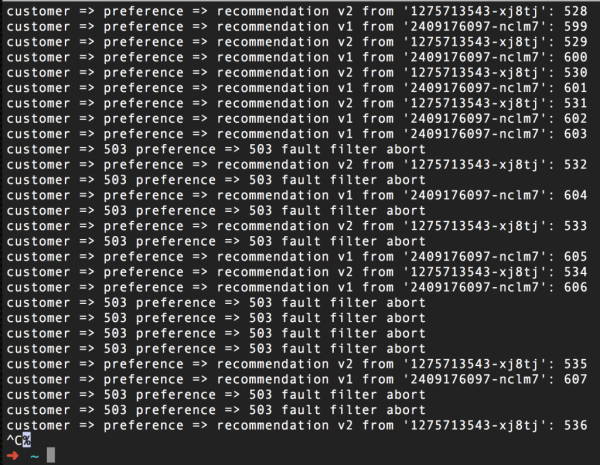
För att återställa normal drift räcker det att ta bort denna regel, i vårt fall med kommandot istioctl delete routerule recommendation-503 -n tutorial. Här är 'Tutorial' namnet på projektet Red Hat OpenShift där vår Istio-handledning körs.
Vi inför konstgjorda fördröjningar
Konstgjorda 503-fel hjälper till att testa systemets motståndskraft mot avbrott, men att kunna förutse och hantera fördröjningar bör imponera ännu mer på dig. Och fördröjningar händer oftare i verkliga livet än avbrott. En långsam mikrotjänst är en cancer för hela systemet. Med Istio kan du testa koden som rör hanteringen av fördröjningar utan att ändra den. Först visar vi hur man gör detta i fall av konstgjorda nätverksfördröjningar.
Observera att efter sådan testning kan det hända att du behöver (eller vill) förbättra din kod. Den goda nyheten är att i detta fall kommer du att agera proaktivt snarare än reaktivt. Så här bör utvecklingscykeln se ut: kodning-testning-feedback-kodning-testning…
Så här ser regeln ut, som… Men vet du vad? Istio är så enkelt, och denna yaml-fil är så tydlig att allt i detta exempel talar för sig självt, ta bara en titt:
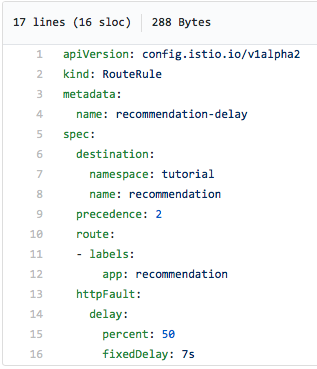
I hälften av fallen kommer vi att få en 7-sekunders fördröjning. Och det är verkligen inte samma sak som att vi skulle ha lagt till en sleep-kommando i koden, eftersom Istio faktiskt fördröjer förfrågan med 7 sekunder. Eftersom Istio stöder Jaeger-spårning kan denna fördröjning observeras tydligt i Jaeger-gränssnittet, som visas i skärmdumpen nedan. Observera den långa förfrågan i det övre högra hörnet av diagrammet – dess varaktighet är 7,02 sekunder:
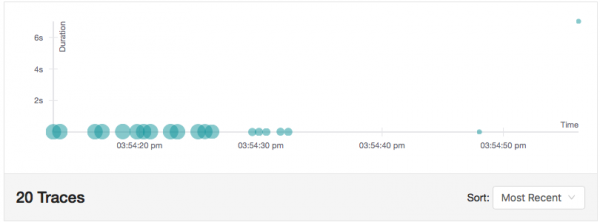
Detta scenario tillåter oss att testa koden under nätverksfördröjningar. Och det är tydligt att om vi tar bort denna regel, kommer vi att eliminera den artificiella fördröjningen. Låt oss upprepa oss, men vi gjorde allt detta utan att röra koden.
Inte ge upp och inte backa
En annan användbar funktion för kaosingenjörskonst i Istio är möjligheten att göra om förfrågningar till tjänsten ett visst antal gånger. Poängen här är att inte sluta försöka när den första förfrågan misslyckas med fel 503 – och kanske, vid det N:te försöket, har vi tur. Kanske tjänsten bara vilade för en stund av någon anledning. Ja, denna anledning bör vi nog gräva fram och åtgärda. Men det är senare, så låt oss försöka få systemet att fortsätta fungera först.
Så, vi vill att tjänsten med jämna mellanrum ska ge ett fel 503, och Istio efter det ska försöka att kontakta den igen. Och här behövs tydligt ett sätt att generera fel 503 utan att röra koden själv...
Vänta, stopp! Vi gjorde just detta.
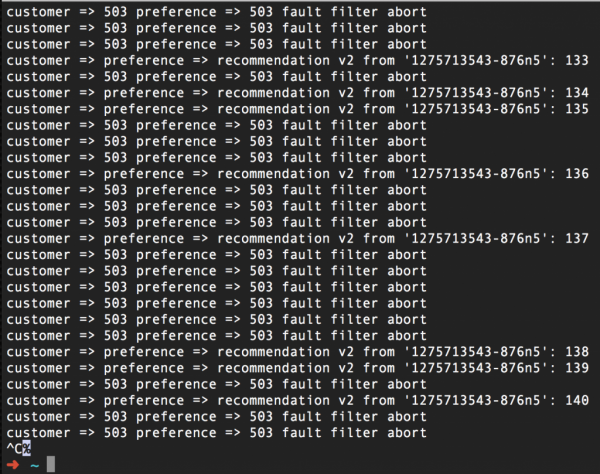
Denna fil kommer att göra så att tjänsten recommendation-v2 i hälften av fallen ger ett fel 503:
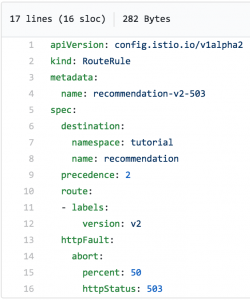
Det är uppenbart att en del förfrågningar kommer att misslyckas:
Och nu involverar vi Istio-funktionen Retry:
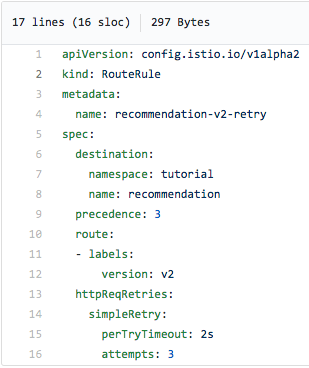
Denna rutningsregel gör tre omförsök med två sekunders intervall och bör minska (eller helst helt ta bort) fel 503:
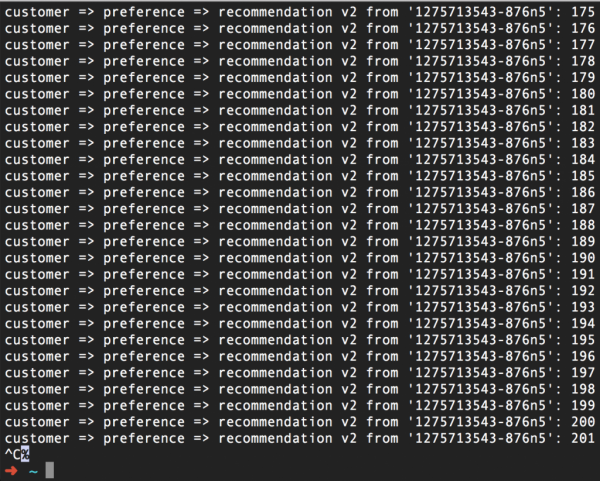
Sammanfattningsvis: vi har gjort så att Istio, för det första, genererar fel 503 för hälften av förfrågningarna. För det andra, utför samma Istio tre försök att kontakta tjänsten vid fel 503. Som ett resultat fungerar allt utmärkt. Således, genom att använda funktionen Retry, har vi hållit vårt löfte att inte ge upp och inte backa.
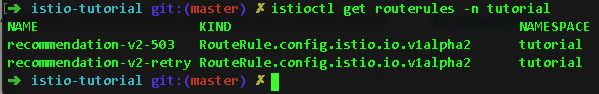
Och ja, vi gjorde det igen, utan att röra koden. Allt vi behövde var två rutningsregler i Istio:
Hur man inte sviker användaren eller att sju inte väntar på en
Och nu vänder vi situationen in och ut och undersöker scenariot där det endast är värt att inte ge efter eller ge upp under en viss bestämd tid. Sedan måste vi helt enkelt sluta försöka bearbeta begäran för att inte få alla att vänta på en trögrörlig tjänst. Med andra ord kommer vi inte att försvara den förlorade positionen, utan istället dra oss tillbaka till en reservfront för att inte låta webbplatsens användare lida av osäkerhet.
I Istio kan man ställa in en tidsgräns för begärningsbehandling. Om tjänsten överskrider denna tidsgräns returneras felkod 504 (Gateway Timeout) – allt detta görs återigen genom Istios konfiguration. Men vi måste lägga till kommandot sleep i tjänstens källkod (och givetvis genomföra en ombyggnad och omdeploy), för att simulera en långsam tjänst. Tyvärr går det inte att göra på något annat sätt.
Så vi har infogat en tre sekunder lång sleep i koden för tjänsten recommendation v2, återbyggt den aktuella bilden och genomfört en omdeploy av containern, och nu kommer vi att lägga till en tidsgräns med hjälp av följande routingregel i Istio:
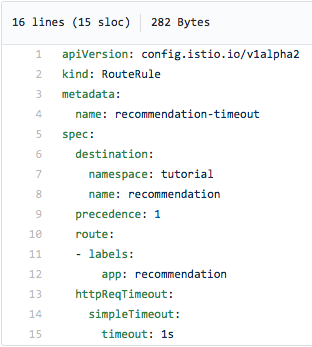
I skärmbilden ovan kan vi se att vi slutar att försöka kontakta tjänsten recommendation om vi inte får något svar inom en sekund, det vill säga även innan felkod 504 inträffar. Efter att denna routingregel tillämpats (och med en tre sekunder lång sleep i koden för tjänsten recommendation:v2), får vi följande resultat:
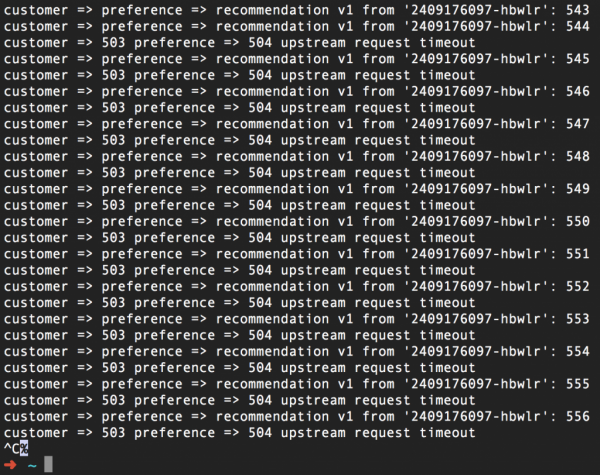
Vi upprepar oss, men tidsgränsen kan ställas in utan att vidröra källkoden. En extra bonus här är att du nu kan modifiera din kod så att den reagerar på tidsgränsen, och enkelt testa dessa ändringar med hjälp av Istio.
Och nu allt tillsammans
Att skapa lite kaos med hjälp av Istio är ett utmärkt sätt att testa din kod och systemets tillförlitlighet som helhet. Mönster för fallback, bulkhead och circuit breaker, metoder för att skapa artificiella fel och förseningar, samt återkommande anrop och tidsgränser kommer att vara mycket användbara vid skapandet av robusta molnsystem. Tillsammans med Kubernetes och Red Hat OpenShift kommer dessa verktyg att hjälpa dig att möta framtiden med självförtroende.
Källa: habr.com
