

Troligtvis har ingen idag längre några frågor om varför man bör samla in service-metrik. Ett logiskt nästa steg är att ställa in en alert som notifierar om eventuella avvikelser i data via de kanaler som passar dig (e-post, Slack, Telegram). I vår online-hotellbokningstjänst flödar alla metrik från våra tjänster in i InfluxDB och visas i Grafana, där grundläggande alerting också är konfigurerat. För uppgifter som "behöver räkna något och jämföra med detta" använder vi Kapacitor.
Kapacitor är en del av TICK-stacken som kan bearbeta metrik från InfluxDB. Den kan koppla samman flera mätningar (join), beräkna något användbart från de erhållna data, skriva resultaten tillbaka till InfluxDB och skicka en alert till Slack/Twitter/e-post.
Hela stacken har en fantastisk och detaljerad , men det finns alltid användbara saker som inte anges uttryckligen i manualerna. I denna artikel har jag valt att sammanställa en rad sådana användbara och kanske inte självklara tips (den grundläggande syntaxen för TICKscript beskrivs ) och visa hur de kan tillämpas med exempel på en av våra uppgifter.
Låt oss köra!
float & int, beräkningsfel
Ett helt standardproblem som löses via casting:
var alert_float = 5.0
var alert_int = 10
data|eval(lambda: float("value") > alert_float OR float("value") < float("alert_int"))
Användning av default()
Om taggen/fältet inte är ifyllt kommer det att uppstå beräkningsfel:
|default()
        .tag('status', 'empty')
        .field('value', 0)
fill i join (inner vs outer)
Per default kommer join att avvisa punkter där data saknas (inner).
Vid fill('null') kommer en outer join att utföras, efter vilken man behöver göra default() och fylla de tomma värdena:
var data = res1
    |join(res2)
        .as('res1', 'res2')
        .fill('null')
    |default()
        .field('res1.value', 0.0)
        .field('res2.value', 100.0)
Det finns ändå en nyans här. Om en av serierna (res1 eller res2) i exemplet ovan är tom, kommer den slutgiltiga serien (data) också att vara tom. Det finns flera biljetter om detta på GitHub (, , ) – vi väntar på fixar och lider lite.
Användning av villkor i beräkningar (if i lambda)
|eval(lambda: if("value" > 0, true, false)
De senaste fem minuterna från pipelinen under perioden
Till exempel, om du behöver jämföra värdena för de senaste fem minuterna med föregående vecka. Du kan ta två datauppsättningar med två separata batchar eller hämta en del av datan från en större period:
|where(lambda: duration((unixNano(now()) - unixNano("time"))/1000, 1u) < 5m)
Ett alternativ för de sista fem minuterna kan vara att använda noden BarrierNode, som skär av data tidigare än angiven tid:
|barrier()
        .period(5m)
Exempel på användning av Go-mallar i meddelanden
Mallarna följer formatet från paketet , nedan några vanliga uppgifter.
if-else
Vi håller ordning utan att trigga folk med överflödig text:
|alert()
    ...
    .message(
        '{{ if eq .Level "OK" }}Det är okej nu{{ else }}Chefen, allt är trasigt{{end}}'
    )
Två decimaler efter kommatecknet i meddelandet
Förbättrar läsbarheten i meddelandet:
|alert()
    ...
    .message(
        'nu värdet är {{ index .Fields "value" | printf "%0.2f" }}'
    )
Utvärdering av variabler i meddelandet
Vi ger mer information i meddelandet för att svara på frågan 'Varför skriker det?'
var warnAlert = 10
  |alert()
    ...
    .message(
       'Dagens värde är mindre än '+string(warnAlert)+'%'
    )
Unik identifierare för alerten
Nödvändig när det finns mer än en grupp i datan, annars genereras bara en alert:
|alert()
      ...
      .id('{{ index .Tags "myname" }}\/{{ index .Tags "myfield" }}')
Anpassade handlers
I en stor lista av handlers finns exec, vilket gör det möjligt att köra ditt eget skript med överförda parametrar (stdin) – bara kreativitet!
En av våra anpassningar är ett litet Python-skript för att skicka meddelanden till Slack.
Först ville vi skicka en bild från Grafana i meddelandet, skyddad av autentisering. Sedan ville vi skriva OK i tråden till den föregående alerten från samma grupp, istället för ett separat meddelande. Lite senare ville vi även lägga till det vanligaste felet de senaste X minuterna i meddelandet.
Ett separat ämne – kopplingar till andra tjänster och åtgärder initierade av alerten (bara om din övervakning fungerar tillräckligt bra).
Exempel på beskrivning av en handler, där slack_handler.py är vårt egna skript:
topic: slack_graph
id: slack_graph.alert
match: level() != INFO AND changed() == TRUE
kind: exec
options:
  prog: \/sbin\/slack_handler.py
  args: ["-c", "CHANNELID", "--graph", "--search"]
Hur debuggar man?
Alternativ med loggutskrift
|log()
      .level("error")
      .prefix("något")
Visa (cli): kapacitor -url :9092 logs lvl=error
Alternativ med httpOut
Visar data i den aktuella pipeline:
|httpOut('något')
Visa (get): :9092\/kapacitor\/v1\/tasks\/task_name\/något
Schema för exekvering
- Varje task returnerar ett exekveringsträd med användbara siffror i formatet .
- Vi tar block .
- Vi sätter in i visaren, .
Var annars kan man få timestamp i influxdb vid bakåtupptagning
timestamp i influxdb vid omvänd registrering
Till exempel ställer vi in en alert för antalet förfrågningar per timme (groupBy(1h)) och vill spara den inträffade alerten i influxdb (för att snyggt visa att det finns ett problem på grafen i grafana).
influxDBOut() kommer att spara timestamp-värdet tid från alerten, vilket innebär att punkten på grafen kommer att sparas tidigare/efter att alerten kommit.
När precision krävs: vi löser detta problem genom att kalla på en anpassad handler som sparar data i influxdb med den aktuella timestampen.
docker, bygg och distribution
Vid starten kan kapacitor ladda upp uppgifter, mallar och handlare från en katalog som anges i konfigurationsfilen under blocket [load].
För att korrekt skapa en uppgift behövs följande saker:
- Filnamn – utvidgas till id/namn på skriptet
- Typ – stream/batch
- dbrp – nyckelord för att ange vilken databas + policy skriptet arbetar i (dbrp «supplier».«autogen»)
Om det i någon batch-uppgift inte finns en rad med dbrp, kommer hela tjänsten vägra att starta och ärligt skriva detta i loggen.
I chronograf får denna rad dock inte vara, den accepteras inte via gränssnittet och ger ett felmeddelande.
En hack vid byggandet av containern: Dockerfile avslutas med -1 om det finns rader med //.+dbrp, vilket gör att man genast förstår orsaken till felet vid byggandet.
join ett till många
Exempeluppgift: Man behöver ta 95:e percentilen av tjänstetiden för en vecka, jämföra varje minut av de senaste 10 med detta värde.
Det går inte att göra join ett till många, last/mean/median för grupp av punkter omvandlar noden till stream, och ett felmeddelande "cannot add child mismatched edges: batch -> stream" returneras.
Resultatet av batchen, som en variabel i lambda-uttrycket, sätts inte in heller.
Det finns ett alternativ att spara nödvändiga siffror från den första batchen i en fil via udf och ladda upp den filen via sideload.
Vad löste vi med detta?
Vi har omkring 100 hotellleverantörer, till var och en av dem kan det finnas flera anslutningar, låt oss kalla det en kanal. Det finns ungefär 300 av dessa kanaler, var och en av kanalerna kan brytas. Blant de inspelade mätvärdena kommer vi att övervaka felenivå (requests och errors).
Varför inte grafana?
Alerts för fel som ställts in i grafana har flera nackdelar. Vissa är kritiska, för andra kan man blunda, beroende på situationen.
Grafana kan inte göra beräkningar mellan mätvärden + alerting, och vi behöver ju raten (requests-errors)/requests.
Felen ser elaka ut:
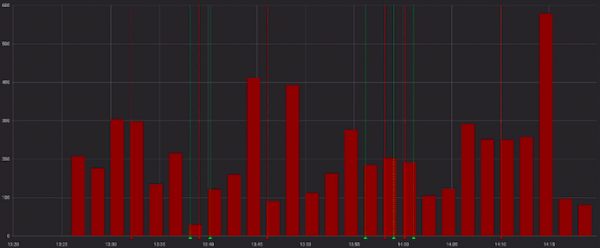
Och mindre elaka när man ser dem med lyckade förfrågningar:
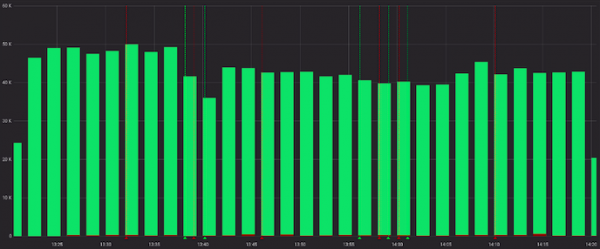
Okej, vi kan förhandsberäkna hastigheten i tjänsten fram till Grafana, och i vissa fall kan det fungera. Men inte i vårt fall, eftersom varje kanal har sin egen relation som räknas som 'normal', och larm fungerar på statiska värden (vi letar med ögonen, ändrar om det larmar ofta).
Här är exempel på 'normal' för olika kanaler:
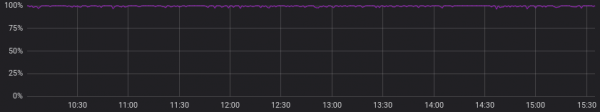
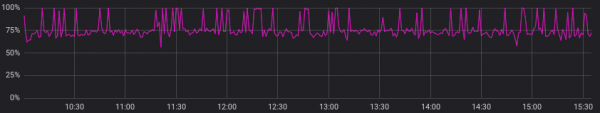
Låt oss bortse från tidigare punkt och anta att alla leverantörer har en 'normal' bild som är liknande. Nu är allt bra, kan vi klara oss med larm i Grafana?
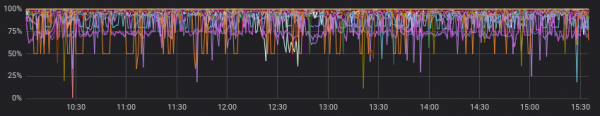
Vi kan, men vi vill verkligen inte, för vi måste välja ett av alternativen:
a) skapa många diagram för varje kanal separat (och plåga oss själva med underhållet)
b) behålla ett diagram med alla kanaler (och tappa bort oss i färgglada linjer och inställda larm)
Hur gjorde vi?
Återigen, dokumentationen har ett bra start exempel (), som vi kan titta på eller använda som grund i liknande uppgifter.
Vad vi gjorde i slutändan:
- slå samman två serier på några timmar, gruppering efter kanaler;
- fyller serierna per grupp om det inte fanns några data;
- jämför medianen för de senaste 10 minuterna med tidigare data;
- skriker om vi upptäcker något;
- skriver de beräknade hastigheterna och inträffade larm i influxdb;
- skickar ett användbart meddelande till slack.
Enligt min åsikt lyckades vi maximalt få till allt vi helst skulle vilja ha som utgång (och till och med lite mer med anpassade handlare).
På github.com kan man se och av det resulterande skriptet.
Exempel på den resulterande koden:
dbrp "supplier"."autogen"
var name = 'requests.rate'
var grafana_dash = 'pczpmYZWU/mydashboard'
var grafana_panel = '26'
var period = 8h
var todayPeriod = 10m
var every = 1m
var warnAlert = 15
var warnReset = 5
var reqQuery = 'SELECT sum("count") AS value FROM "supplier"."autogen"."requests"'
var errQuery = 'SELECT sum("count") AS value FROM "supplier"."autogen"."errors"'

var prevErr = batch
 |query(errQuery)
 .period(period)
 .every(every)
 .groupBy(1m, 'channel', 'supplier')

var prevReq = batch
 |query(reqQuery)
 .period(period)
 .every(every)
 .groupBy(1m, 'channel', 'supplier')

var rates = prevReq
 |join(prevErr)
 .as('req', 'err')
 .tolerance(1m)
 .fill('null')
 // fyll med nollor om det inte fanns några
 |default()
 .field('err.value', 0.0)
 .field('req.value', 0.0)
 // if i lambda: beräkna hastighet, endast om det fanns fel
 |eval(lambda: if("err.value" > 0, 100.0 * (float("req.value") - float("err.value")) / float("req.value"), 100.0))
 .as('rate')

// skriv de beräknade värdena till Influx
rates
 |influxDBOut()
 .quiet()
 .create()
 .database('kapacitor')
 .retentionPolicy('autogen')
 .measurement('rates')

// välj data för de senaste 10 minuterna och beräkna medianen
var todayRate = rates
 |where(lambda: duration((unixNano(now()) - unixNano("time")) / 1000, 1u)  warnAlert)
 .warnReset(lambda: ("prev.median" - "today.median") < warnReset)
 .flapping(0.25, 0.5)
 .stateChangesOnly()
 // samla länken till grafana dashboard grafik i meddelandet
 .message(
 '{{ .Level }}: {{ index .Tags "channel" }} err/req ratio ({{ index .Tags "supplier" }})
{{ if eq .Level "OK" }}Det är okej nu{{ else }}
'+string(todayPeriod)+' median är {{ index .Fields "today.median" | printf "%0.2f" }}%, jämfört med tidigare '+string(period)+' är {{ index .Fields "prev.median" | printf "%0.2f" }}%{{ end }}
http://grafana.ostrovok.in/d/'+string(grafana_dash)+
'?var-supplier={{ index .Tags "supplier" }}&var-channel={{ index .Tags "channel" }}&panelId='+string(grafana_panel)+'&fullscreen&tz=UTC0300'
 )
 .id('{{ index .Tags "name" }}\/{{ index .Tags "channel" }}')
 .levelTag('level')
 .messageField('message')
 .durationField('duration')
 .topic('slack_graph')

// "today.median" dupliceras som "value", samt skriver de andra fälten för alarmet i Influx (keep)
trigger
 |eval(lambda: "today.median")
 .as('value')
 .keep()
 |influxDBOut()
 .quiet()
 .create()
 .database('kapacitor')
 .retentionPolicy('autogen')
 .measurement('alerts')
 .tag('alertName', name)
Och vad är resultatet?
Kapacitor är utmärkt på att utföra övervakning och larm med många gruppering, göra ytterligare beräkningar på redan inspelade mätvärden, utföra anpassade åtgärder och köra skript (udf).
Ingångströskeln är inte särskilt hög – prova det om Grafana eller andra verktyg inte helt tillfredsställer dina önskemål.
Källa: habr.com
