

Ett kort introduktionsord
Jag anser att vi skulle kunna genomföra fler uppgifter om vi fick steg-för-steg-instruktioner som skapar en klar väg för vad och hur man ska göra. Jag själv minns situationer i mitt liv där jag inte kunde komma igång med ett projekt eftersom det var svårt att förstå var jag skulle börja. Kanske såg du för länge sedan ordet "Data Science" på internet och tänkte att det låg långt borta för dig, och att de som arbetar med det är någonstans i en annan värld. Men de är faktiskt här. Och kanske har en artikel från detta område dykt upp i ditt flöde tack vare dessa personer. Det finns gott om kurser som kan hjälpa dig att lära dig detta hantverk. Här kommer jag att hjälpa dig att ta ditt första steg.
Är du redo? Jag säger direkt att du behöver kunna Python 3, eftersom jag kommer att använda det här. Jag rekommenderar också att du installerar Jupyter Notebook i förväg, eller kollar hur man använder Google Colab.
Steg ett
Kaggle är din stora hjälp i detta avseende. I princip kan man klara sig utan det, men jag kommer att berätta mer om det i en annan artikel. Det är en plattform där tävlingar i Data Science hålls. I varje tävling kommer du i början att få en enorm mängd erfarenhet av att lösa olika typer av problem, utveckla appar och arbeta i team, vilket är viktigt idag.
Vi tar vår uppgift därifrån. Den heter: "Titanic". Villkoret är följande: förutsäga om varje individ överlever. Generellt sett handlar arbetet för någon som sysslar med DS, om att samla in data, bearbeta data, träna en modell, göra prognoser och så vidare. På Kaggle får vi möjlighet att hoppa över datainsamlingssteget — de finns redan på plattformen. Vi behöver bara ladda ner dem och sedan kan vi börja arbeta!
Det kan göras på följande sätt:
i fliken Data finns filerna som innehåller data


Vi har laddat ner data, förberett våra Jupyter-notebookar och...
Steg två
Hur laddar vi nu ner dessa data?
För det första importerar vi de nödvändiga biblioteken:
import pandas as pd
import numpy as np
Pandas låter oss ladda ner .csv-filer för vidare bearbetning.
Numpy behövs för att representera vår datatabell som en matris med siffror.
Låt oss gå vidare. Vi tar filen train.csv och laddar den till oss:
dataset = pd.read_csv('train.csv')
Vi kommer att referera till vårt dataset train.csv genom variabeln dataset. Låt oss se vad som finns där:
dataset.head()
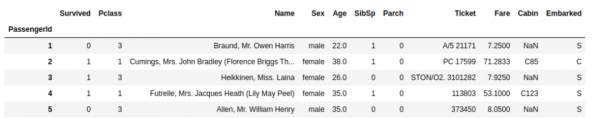
Funktionen head() låter oss se de första raderna av dataramen.
Kolumnen Survived är våra resultat som är kända i denna dataram. I uppgiften behöver vi förutsäga kolumnen Survived för data test.csv. Dessa data innehåller information om andra passagerare på Titanic, vars utfall är okända för oss som löser uppgiften.
Så, vi delar upp vår tabell i beroende och oberoende data. Här är det enkelt. Beroende data är de data som beror på oberoende, det som finns i resultaten. Oberoende data är de data som påverkar utfallet.
Till exempel har vi följande dataset:
«Vova studerade datavetenskap — nej.
Vova fick 2 i datavetenskap.»
Betyget i datavetenskap beror på svaret på frågan: studerade Vova datavetenskap? Klart? Låt oss gå vidare, vi är nu närmare målet!
Den traditionella variabeln för oberoende data är X. För beroende data är det y.
Vi gör följande:
X = dataset.iloc[ : , 2 : ]
y = dataset.iloc[ : , 1 : 2 ]
Vad är detta? Med funktionen iloc[:, 2: ] säger vi till Python: jag vill se i variabeln X de data som börjar från den andra kolumnen (inklusive och under förutsättning att räkningen börjar från noll). I den andra raden säger vi att vi vill se i y de data från den första kolumnen.
[ a:b, c:d ] — detta är konstruktionen som vi använder inom parenteserna. Om ingen variabel anges kommer de att behållas som standard. Det vill säga att vi kan ange [:,: d] så får vi alla kolumner i dataramen, förutom de som börjar med nummer d och framåt. Variablerna a och b definierar raderna, men vi behöver alla, så vi lämnar det som standard.
Låt oss se vad vi har fått:
X.head() 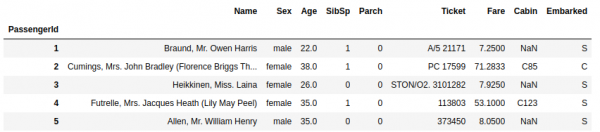
y.head() 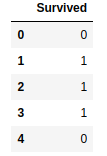
För att förenkla denna lilla lektion kommer vi att ta bort kolumner som kräver särskild "vård", eller som helt enkelt inte påverkar överlevnaden. De innehåller data av typen str.
count = ['Name', 'Ticket', 'Cabin', 'Embarked']
X.drop(count, inplace=True, axis=1)
Super! Vi går vidare till nästa steg.
Steg tre
Här kommer vi att behöva koda våra data så att maskinen bättre förstår hur dessa data påverkar resultatet. Men vi ska bara koda vissa data, nämligen typ str som vi har lämnat. Kolumnen "Sex". Hur vill vi koda? Vi föreställer oss uppgifterna om en persons kön som en vektor: 10 — manligt, 01 — kvinnligt.
För att börja kommer vi att översätta våra tabeller till en NumPy-matris:
X = np.array(X)
y = np.array(y)
Och nu kollar vi:
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder

ct = ColumnTransformer(transformers=[('encoder', OneHotEncoder(), [1])],
                       remainder='passthrough')
X = np.array(ct.fit_transform(X))
Biblioteket sklearn är ett riktigt häftigt bibliotek som låter oss genomföra hela arbetet inom Data Science. Det innehåller ett stort antal intressanta modeller för maskininlärning och låter oss dessutom förbereda data.
OneHotEncoder kommer att låta oss koda könet på personen i den representation vi har beskrivit. Två klasser kommer att skapas: manlig och kvinnlig. Om personen är en man, kommer 1 att skrivas i kolumnen „manlig” och 0 i „kvinnlig”.
Efter OneHotEncoder() står [1] — det betyder att vi vill koda kolumn nummer 1 (räknat från noll).
Bra. Låt oss gå vidare!
Som regel händer det att vissa data förblir ofyllda (dvs NaN — not a number). Till exempel finns det information om en person: hans namn, kön. Men vi har ingen information om hans ålder. I sådana fall kommer vi att använda följande metod: vi hittar medelvärdet för alla kolumner och om några data saknas i en kolumn, så fyller vi tomrummet med medelvärdet.
from sklearn.impute import SimpleImputer
imputer = SimpleImputer(missing_values=np.nan, strategy='mean')
imputer.fit(X)
X = imputer.transform(X)
Och nu tar vi hänsyn till att det finns situationer där data är mycket spridda. Vissa data ligger inom intervallet [0:1], medan andra kan gå över hundratals och tusentals. För att utesluta sådana spridningar och för att datorn ska vara mer exakt i beräkningarna, kommer vi att skala datan, normalisera den. Låt alla tal inte överstiga tre. För detta använder vi funktionen StandardScaler.
from sklearn.preprocessing import StandardScaler
sc = StandardScaler()
X[:, 2:] = sc.fit_transform(X[:, 2:])
Nu ser våra data ut så här:

Bra! Vi är redan nära vårt mål!
Tredje steget
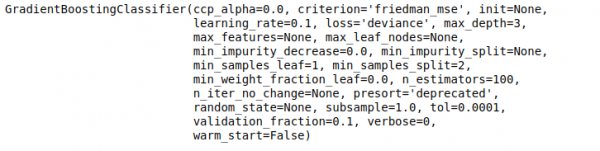
Låt oss träna vår första modell! I sklearn-biblioteket kan vi hitta en mängd intressanta saker. Jag tillämpade Gradient Boosting Classifier-modellen för denna uppgift. Vi använder en klassificerare eftersom vår uppgift är klassificering. Vi måste förutsäga om det tillhör 1 (överlevde) eller 0 (överkörd).
from sklearn.ensemble import GradientBoostingClassifier
gbc = GradientBoostingClassifier(learning_rate=0.5, max_depth=5, n_estimators=150)
gbc.fit(X, y)
Fit-funktionen talar om för Python: Låt modellen leta efter samband mellan X och y.
Mindre än en sekund och modellen är klar.
Hur tillämpar vi den? Nu får vi se!
Steg fem. Slutsats
Nu behöver vi ladda upp tabellen med våra testdata, för vilka vi måste göra en förutsägelse. För denna tabell kommer vi att göra samma saker som vi gjorde för X.
X_test = pd.read_csv('test.csv', index_col=0)

count = ['Name', 'Ticket', 'Cabin', 'Embarked']
X_test.drop(count, inplace=True, axis=1)

X_test = np.array(X_test)

from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder
ct = ColumnTransformer(transformers=[('encoder', OneHotEncoder(), [1])],
                       remainder='passthrough')
X_test = np.array(ct.fit_transform(X_test))

from sklearn.impute import SimpleImputer
imputer = SimpleImputer(missing_values=np.nan, strategy='mean')
imputer.fit(X_test)
X_test = imputer.transform(X_test)

from sklearn.preprocessing import StandardScaler
sc = StandardScaler()
X_test[:, 2:] = sc.fit_transform(X_test[:, 2:])
Låt oss tillämpa vår modell!
gbc_predict = gbc.predict(X_test)
Klart. Vi har gjort en förutsägelse. Nu måste vi skriva den till csv och ladda upp den på webben.
np.savetxt('my_gbc_predict.csv', gbc_predict, delimiter=",", header = 'Survived')
Färdigt. Vi har fått en fil som innehåller förutsägelser för varje passagerare. Nu är det bara att ladda upp dessa lösningar på webben och få en bedömning av förutsägelsen. Denna enkla lösning ger inte bara 74 % korrekta svar på publikens tester, utan också en viss kickstart inom Data Science. De mest nyfikna kan när som helst skriva till mig och ställa frågor. Tack till alla!
Källa: habr.com
