

Först och främst, när man börjar arbeta med ett nytt dataset, är det viktigt att förstå det. För att göra detta bör man till exempel ta reda på värdenas intervall, deras typer samt hur många saknade värden som finns.
Biblioteket pandas erbjuder oss många användbara verktyg för att utföra utforskande dataanalys (Exploratory Data Analysis, EDA). Men innan man använder dessa, är det vanligtvis bra att börja med mer allmänna funktioner, som df.describe(). Dock är det värt att notera att dessa funktioner har sina begränsningar, och de initiala stegen i arbetet med vilket dataset som helst under EDA liknar ofta varandra.
Författaren till materialet som vi publicerar idag säger att han inte är en anhängare av att göra repetitiva saker. I sin strävan efter verktyg som kan utföra utforskande dataanalys snabbt och effektivt, har han hittat biblioteket . Resultaten från detta bibliotek presenteras inte i form av enstaka mått, utan som en ganska detaljerad HTML-rapport som innehåller det mesta av den information som kan behövas om de analyserade data innan man går vidare till mer ingående arbete med dem.
Här kommer vi att diskutera användningen av biblioteket pandas-profiling med hjälp av Titanic-datasetet.
Utforskande dataanalys med hjälp av pandas
Jag bestämde mig för att experimentera med pandas-profiling på Titanic-datasetet eftersom det innehåller data av olika typer samt saknade värden. Jag anser att pandas-profiling är särskilt intressant när data ännu inte har rengjorts och kräver ytterligare bearbetning beroende på deras egenskaper. För att framgångsrikt genomföra en sådan bearbetning måste man veta var man ska börja och vad man bör fokusera på. Här kommer funktionerna i pandas-profiling till nytta.
Först importerar vi data och använder pandas för att få fram beskrivande statistiska mått:
# импорт необходимых пакетов
import pandas as pd
import pandas_profiling
import numpy as np

# импорт данных
df = pd.read_csv('/Users/lukas/Downloads/titanic/train.csv')

# вычисление показателей описательной статистики
df.describe()
Efter att ha kört denna kodsnutt får vi vad som visas i följande bild.
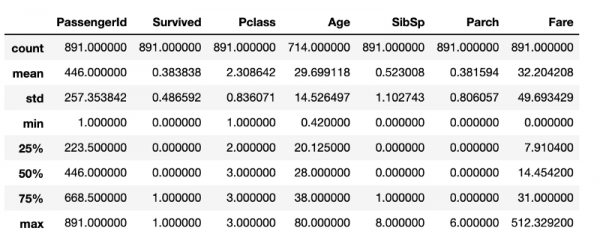
De beskrivande statistiska måtten som erhållits med hjälp av standardverktygen i pandas
Även om här finns mycket användbar information, innehåller den inte allt som skulle vara intressant att veta om de undersökta data. Till exempel kan man anta att det finns 891 rader i dataramens struktur. DataFrameOm detta behöver kontrolleras, behövs en rad kod till som definierar storleken på dataramen. Även om dessa beräkningar inte är särskilt resurskrävande, kommer upprepning av dem med säkerhet att leda till tidsförluster, vilket sannolikt är bättre att spendera på datarensning.
Explorativ dataanalys med hjälp av pandas-profiling
Nu ska vi göra samma sak med hjälp av pandas-profiling:
pandas_profiling.ProfileReport(df)Att köra ovanstående kodrad kommer att skapa en rapport med indikatorer för den explorativa dataanalysen. Koden som visas ovan kommer att producera information om data, men det går att göra så att resultatet blir en HTML-fil som till exempel kan visas för någon.
Den första delen av rapporten kommer att innehålla en sektion med Översikt, som ger grundläggande information om data (antalet observationer, antal variabler och så vidare). Dessutom kommer den att innehålla en lista med varningar som informerar analytikern om vad som är värt att uppmärksamma. Dessa varningar kan ge en hint om vad som bör prioriteras i datarensningen.
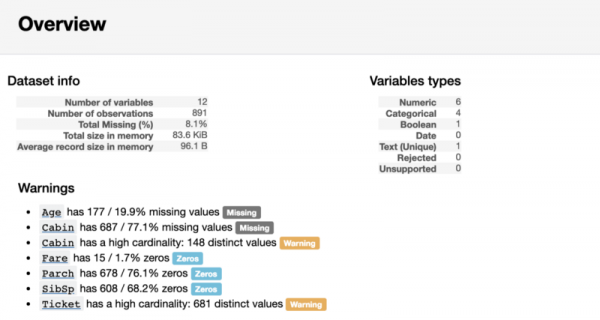
Översikt av rapporten
Explorativ analys av variabler
Efter avsnittet Översikt i rapporten kan man finna användbar information om varje variabel. Detta inkluderar, bland annat, små diagram som beskriver fördelningen av varje variabel.
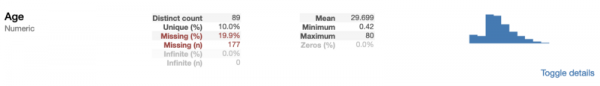
Information om den numeriska variabeln Ålder
Som vi kan se från det föregående exemplet ger pandas-profiling oss flera användbara indikatorer, såsom procentandel och antal saknade värden, samt deskriptiv statistik som vi redan har sett. Eftersom Ålder är en numerisk variabel, gör visualiseringen av dess fördelning i form av ett histogram att vi kan dra slutsatsen att vi har en högerskev fördelning.
Vid granskning av den kategoriska variabeln skiljer sig de visade indikatorerna något från de som hittades för den numeriska variabeln.
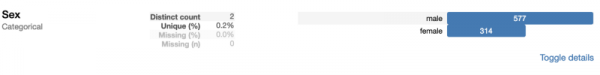
Information om den kategoriska variabeln Kön
Det vill säga, istället för att hitta medelvärdet, minimum och maximum, har pandas-profilering biblioteket funnit antalet klasser. Eftersom Kön — en binär variabel vars värden representeras av två klasser.
Om du, precis som jag, älskar att utforska kod, kan du vara intresserad av hur pandas-profilering biblioteket beräknar dessa indikatorer. Att lära sig om detta, med tanke på att koden till biblioteket är öppen och tillgänglig på GitHub, är inte så svårt. Eftersom jag inte är en stor fan av att använda "svarta lådor" i mina projekt, har jag tagit en titt på källkoden till biblioteket. Till exempel, så här ser mekanismen för bearbetning av numeriska variabler ut, representerad av funktionen :
def describe_numeric_1d(series, **kwargs):
    """Beräkna sammanfattande statistik för en numerisk (`TYPE_NUM`) variabel (en Series).
    Skapa även histogram (mini och fullständigt) av dess distribution.
    Parametrar
    ----------
    series : Series
        Den variabel som ska beskrivas.
    Returerar
    -------
    Series
        Beskrivningen av variabeln som en Series med index som är statistiknycklar.
    """
    # Formatera ett tal som en procent. Till exempel, 0.25 blir 25%.
    _percentile_format = "{:.0%}"
    stats = dict()
    stats['type'] = base.TYPE_NUM
    stats['mean'] = series.mean()
    stats['std'] = series.std()
    stats['variance'] = series.var()
    stats['min'] = series.min()
    stats['max'] = series.max()
    stats['range'] = stats['max'] - stats['min']
    # För att undvika att räkna ut det flera gånger
    _series_no_na = series.dropna()
    for percentile in np.array([0.05, 0.25, 0.5, 0.75, 0.95]):
        # Dropna() är en tillfällig lösning för https://github.com/pydata/pandas/issues/13098
        stats[_percentile_format.format(percentile)] = _series_no_na.quantile(percentile)
    stats['iqr'] = stats['75%'] - stats['25%']
    stats['kurtosis'] = series.kurt()
    stats['skewness'] = series.skew()
    stats['sum'] = series.sum()
    stats['mad'] = series.mad()
    stats['cv'] = stats['std'] / stats['mean'] if stats['mean'] else np.NaN
    stats['n_zeros'] = (len(series) - np.count_nonzero(series))
    stats['p_zeros'] = stats['n_zeros'] * 1.0 / len(series)
    # Histogram
    stats['histogram'] = histogram(series, **kwargs)
    stats['mini_histogram'] = mini_histogram(series, **kwargs)
    return pd.Series(stats, name=series.name)
Även om denna kod är ganska stor och komplex kan den faktiskt förstås ganska enkelt. Det handlar om att det finns en funktion i källkoden till biblioteket som avgör variabeltyper. Om det visar sig att biblioteket stöter på en numerisk variabel, kommer den ovan nämnda funktionen att finna de indikatorer vi diskuterade. Denna funktion använder standardpandas-operationer för att arbeta med objekt av typen Series, liknande series.mean(). Resultaten av beräkningarna sparas i en ordlista stats. Histogrammen skapas med hjälp av en anpassad version av funktionen matplotlib.pyplot.hist. Anpassningen syftar till att funktionen ska kunna arbeta med olika typer av datamängder.
Korrelationsmått och urval av undersökta data
Efter analysen av variablerna i pandas-profiling, kommer avsnittet Korrelationer att visa Pearson- och Spearman-korrelationsmatriser.
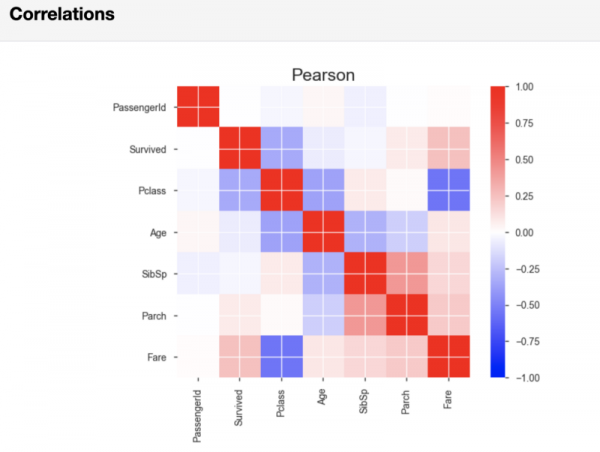
Pearson-korrelationsmatris
Om det behövs kan du i den kodrad som kör rapportgenereringen ange tröskelvärden som används vid beräkningen av korrelationen. Genom att göra detta kan du specificera vilken styrka av korrelationen som anses viktig för din analys.
Och till sist, i rapporten från pandas-profiling, i avsnittet Urval, visas som exempel ett utdrag av data från början av datamängden. Det här tillvägagångssättet kan leda till obehagliga överraskningar, eftersom de första observationerna kan vara ett urval som inte representerar hela datamängdens egenskaper.
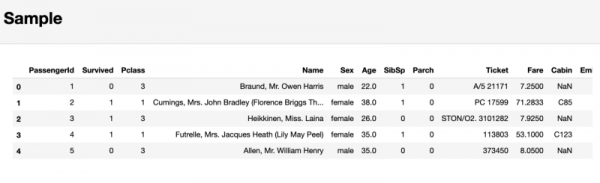
Avsnittet som innehåller urval av undersökta data
Som en följd av detta rekommenderar jag inte att fokusera på det sista avsnittet. Istället är det bättre att använda kommandot df.sample(5), som slumpmässigt väljer 5 observationer från datamängden.
Sammanfattning
Sammanfattningsvis kan man säga att pandas-profiling-biblioteket ger analytikern några användbara möjligheter som kommer till nytta när man snabbt vill få en allmän uppfattning om data eller ge någon en rapport om utforskande dataanalys. Den verkliga hanteringen av data, med beaktande av deras egenskaper, genomförs, precis som utan pandas-profiling, manuellt.
Om du vill se hur hela den utforskande dataanalysen ser ut i en Jupyter-notebook — ta en titt på mitt projekt skapat med hjälp av nbviewer. Och i GitHub-repoet kan du hitta motsvarande kod.
Kära läsare! Hur börjar du analysera nya datamängder?
Källa: habr.com
