

Netflix — marknadsledare inom internet-TV — är företaget som skapade och aktivt utvecklar detta segment. Netflix är inte bara känt för sin omfattande katalog av filmer och serier, tillgängliga från nästan vilken plats som helst på planeten och på alla enheter med skärm, utan också för sin pålitliga infrastruktur och unika ingenjörskultur.
Ett tydligt exempel på Netflix strategi för att utveckla och underhålla komplexa system presenterades på DevOops 2019. — chef för utveckling på Netflix. Han är alumn från fakulteten för Datavetenskap på NNGU, och Sergey är en av de första ingenjörerna i Open Connect — CDN-teamet på Netflix. Han har byggt övervaknings- och analyssystem för videodata, lanserat den populära tjänsten FAST.com för att mäta internethastighet och har de senaste åren arbetat med att optimera internetförfrågningar så att Netflix-appen fungerar så snabbt som möjligt för användarna.
Föredraget fick utmärkta recensioner från konferensens deltagare, och vi har förberett en textversion för er.
I föredraget berättade Sergey detaljerat
- om vad som påverkar fördröjningen av internetförfrågningar mellan klienten och servern;
- hur man minskar dessa fördröjningar;
- hur man designar, upprätthåller och övervakar felresistenta system;
- hur man uppnår resultat på kort tid med minimal risk för verksamheten;
- hur man analyserar resultat och lär sig av misstagen.
Svar på dessa frågor är viktiga inte bara för dem som arbetar i stora företag.
De presenterade principerna och teknikerna bör varje person som utvecklar och underhåller internetprodukter känna till och praktisera.
Vidare — berättelsen från talarens perspektiv.
Vikten av internethastighet
Hastigheten på internetförfrågningar är direkt kopplad till affärer. Låt oss ta shoppingområdet som exempel: företaget Amazon sa 2009 Antalet mobila enheter ökar, liksom antalet mobilsidor och appar. Om din sida laddar längre än 3 sekunder, förlorar du cirka hälften av användarna.
Sedan så tar Google hänsyn till hur snabbt din sida laddar i sökresultaten: ju snabbare sidan är, desto högre placering får den i Google.
Anslutningshastighet är också viktig inom finansiella institutioner där fördröjning är kritisk. År 2015 avslutade företaget Hibernia Networks en kabeldragning mellan New York och London för 400 miljoner dollar för att minska fördröjningen mellan städerna med 6 ms. Tänk dig, 66 miljoner dollar för 1 ms minskning av fördröjning!
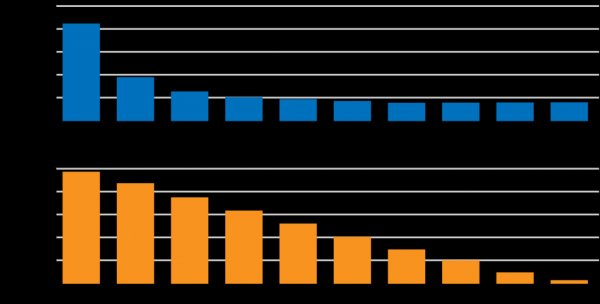
Enligt , hastigheten på anslutningen över 5 Mbit/s slutar påverka laddningstiden för en typisk webbplats direkt. Det finns dock en linjär relation mellan fördröjningen av anslutningen och laddningstiden för sidan:
Men Netflix är inte en typisk produkt. Effekten av fördröjning och hastighet på användaren är ett aktivt forsknings- och utvecklingsområde. Det finns laddning av applikationen och val av innehåll som beror på fördröjning, men laddning av statiska element och streaming beror också på hastigheten på anslutningen. Analys och optimering av de nyckelfaktorer som påverkar kvaliteten på tjänsten för användaren är ett aktivt forskningsområde för flera team inom Netflix. Ett av målen är att minska fördröjningen mellan Netflix-enheter och den molnbaserade infrastrukturen.
I rapporten kommer vi att fokusera på att minska fördröjningen (latency) med exempel från Netflix-infrastrukturen. Vi kommer att se på hur vi praktiskt kan närma oss design-, utvecklings- och driftprocesser för komplexa distribuerade system och använda tiden på innovation och resultat snarare än på att diagnostisera driftsproblem och fel.
Inom Netflix
Tusentals olika enheter stöder Netflix-appar. Deras utveckling hanteras av fyra olika team som gör separata versioner av klienter för Android, iOS, TV och webbläsare. Vi lägger mycket tid och kraft på att förbättra och anpassa användargränssnittet. För detta ändamål genomför vi parallellt hundratals A/B-tester.
Personalisering stöds av hundratals mikrotjänster i AWS-molnet som tillhandahåller personligt anpassade data för användaren, begärningshantering, telemetri, Big Data och Encoding. Trafikvisualiseringen ser ut så här:
Till vänster finns entry point, och sedan fördelas trafiken mellan flera hundra mikrotjänster som stöds av olika backend-team.
En annan viktig komponent i vår infrastruktur är Open Connect CDN, som levererar statiskt innehåll till slutanvändaren — video, bilder, kod för klienter, osv. CDN ligger på anpassade servrar (OCA — Open Connect Appliance). Inuti finns SSD- och HDD-disksystem som styrs av en optimerad FreeBSD, med NGINX och en uppsättning tjänster. Vi designar och optimerar hårdvaru- och programkomponenter så att en sådan CDN-server kan skicka så mycket data som möjligt till användarna.
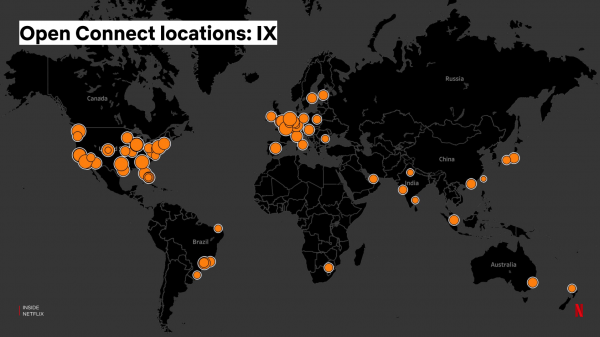
"Väggen" av dessa servrar på internettrafikens utbytespunkt (Internet eXchange — IX) ser ut så här:
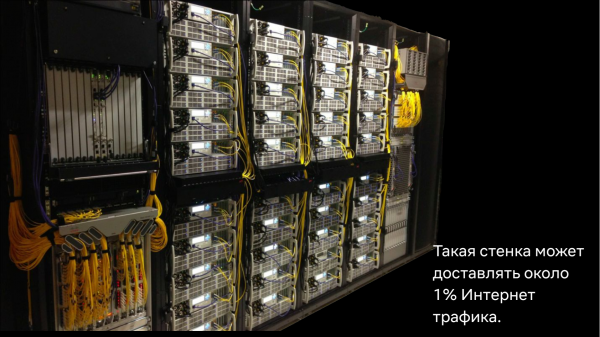
Internet Exchange ger möjlighet för internetleverantörer och innehållsleverantörer att "koppla ihop" med varandra för en mer direkt datautbyte på internet. Det finns cirka 70-80 Internet Exchange-punkter runt om i världen där våra servrar är installerade, och vi hanterar själva deras installation och underhåll:
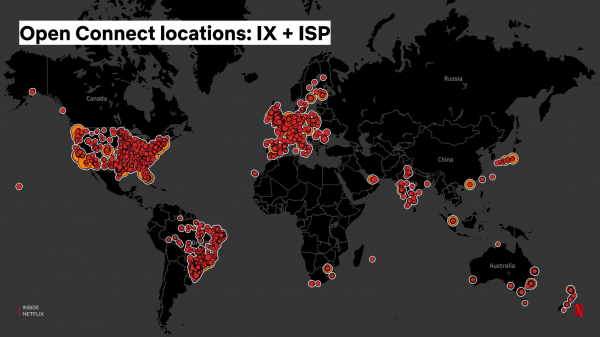
Dessutom tillhandahåller vi också servrar direkt till internetleverantörer, som de installerar i sitt nätverk, vilket förbättrar lokaliseringen av Netflix-trafiken och strömmande kvalitet för användarna:
En uppsättning AWS-tjänster ansvarar för dirigering av videoförfrågningar från kunder till CDN-servrar, samt konfiguration av själva servrarna — uppdatering av innehåll, programkod, inställningar osv. För detta har vi också byggt ett backbone-nätverk som ansluter servrar på Internet Exchange-punkter med AWS. Backbone-nätverket är ett globalt nätverk av fiberoptiska kablar och routrar, som vi kan designa och konfigurera utifrån våra behov.
uttalandet , vår CDN-infrastruktur levererar under peak timmar ungefär ⅛ av det globala internettrafiken och ⅓ av trafiken i Nordamerika, där Netflix har funnits längst. Imponerande siffror, men för mig är en av de mest otroliga prestationerna att hela CDN-systemet utvecklas och underhålls av ett team på mindre än 150 personer.
Ursprungligen var CDN-infrastrukturen designad för att leverera videodata. Men med tiden insåg vi att vi även kunde använda den för att optimera dynamiska förfrågningar från kunder till AWS-molnet.
Om att påskynda internet
I dag har Netflix 3 AWS-regioner, og forsinkelsen av forespørselen til skyen vil avhenge av hvor langt kunden er fra den nærmeste regionen. Samtidig har vi en rekke CDN-servere som brukes til levering av statisk innhold. Er det en måte å bruke denne infrastrukturen på for å akselerere dynamiske forespørsel? Dessverre kan vi ikke cache disse forespørslene — APIene er personaliserte og hvert resultat er unikt.
La oss lage en proxy på CDN-serveren og begynne å kjøre trafikken gjennom den. Vil dette være raskere?
Materie
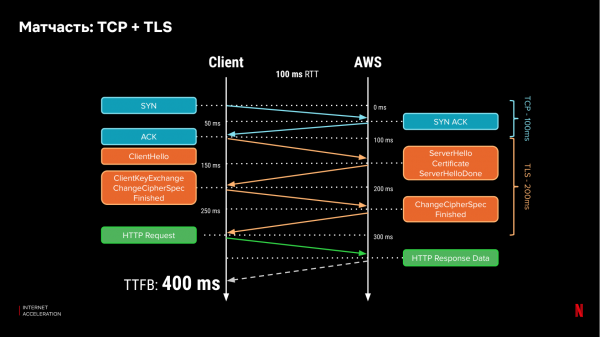
La oss huske hvordan nettverksprotokoller fungerer. I dag bruker størstedelen av trafikken på internett HTTPs, som er avhengig av lavere nivå protokoller som TCP og TLS. For at klienten skal koble seg til serveren, gjennomfører den et handshake, og for å opprette en sikker forbindelse må klienten utveksle meldinger med serveren tre ganger, og minst én gang til for å overføre data. Med en forsinkelse på ett utvekslingsparti (RTT) på 100 ms trenger vi 400 ms for å motta det første databit:
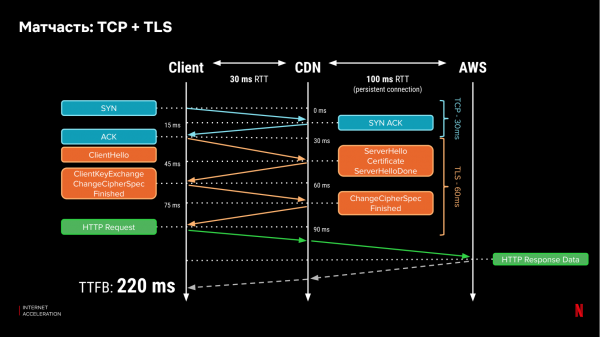
Hvis sertifikatene er plassert på CDN-serveren, kan vi betydelig redusere tiden for «håndtrykk» mellom klienten og serveren, hvis CDN er nærmere. Anta at forsinkelsen til CDN-serveren er 30 ms. Da vil det ta 220 ms for å få det første databit:
Men fordelene slutter ikke der. Når forbindelsen allerede er opprettet, øker TCP congestion window (mengden informasjon som kan overføres parallelt over denne forbindelsen). Hvis et dataparti går tapt, reduserer de klassiske implementasjonene av TCP-protokollen (som TCP New Reno) det åpne «vinduet» med halvparten. Økningen av congestion window, og hastigheten på gjenoppretting fra tap, avhenger igjen av forsinkelsen (RTT) til serveren. Hvis denne forbindelsen bare går til CDN-serveren, vil gjenopprettingen være raskere. Tap av pakker er en standardforeteelse, spesielt for trådløse nettverk.
Internetkapaciteten kan minska, särskilt under rusningstid på grund av trafik från användare, vilket kan leda till "köer". Det finns ingen möjlighet på internet att ge prioritet åt vissa förfrågningar framför andra. Till exempel, att ge prioritet åt mindre och tidskänsliga förfrågningar i förhållande till "tunga" datastreams som belastar nätverket. I vårt fall gör dock vår egen backbone-nätverk det möjligt att göra detta på en del av begäran — mellan CDN och molnet, och vi kan konfigurera det helt. Vi kan ställa in så att små och fördröjningskänsliga paket prioriteras, medan större datastreams skickas något senare. Ju närmare CDN är kunden, desto mer effektivitet.
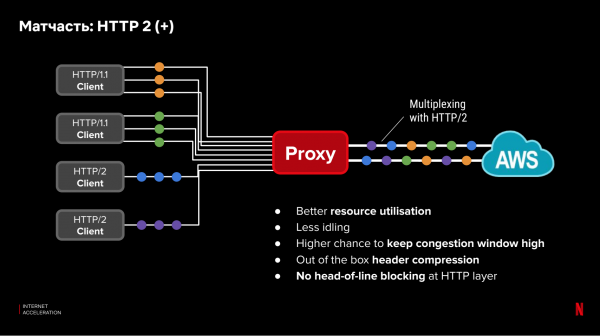
Dessutom påverkar aprotokollen på applikationsnivå (OSI-nivå 7) latensen. Nya protokoll som HTTP/2 gör det möjligt att optimera prestandan för parallella förfrågningar. Men vi har Netflix-kunder med äldre enheter som inte stöder nya protokoll. Inte alla kunder kan uppgraderas eller optimeras. Medan mellan CDN-proxy och molnet har vi full kontroll och möjlighet att använda nya, optimala protokoll och inställningar. Den ineffektiva delen med gamla protokoll kommer endast att agera mellan kunden och CDN-servern. Dessutom kan vi multiplexera förfrågningar på en redan etablerad anslutning mellan CDN och molnet, vilket förbättrar utnyttjandet av anslutningen på TCP-nivån:
Mäta
Trots att teorin lovar förbättringar, kastar vi oss inte direkt in i produktion. Istället måste vi först bevisa att idén fungerar i praktiken. För detta behöver vi svara på några frågor:
- Hastighet: Kommer proxy vara snabbare?
- Pålitlighet: Kommer det oftare att gå sönder?
- Komplexitet: Hur integrera med applikationer?
- Kostnad: Hur mycket kostar det att driftsätta ytterligare infrastruktur?
Låt oss titta närmare på vår metod för att utvärdera den första punkten. De övriga behandlas på liknande sätt.
För att analysera hastigheten på förfrågningar vill vi få data för alla användare, utan att spendera mycket tid på utveckling och utan att bryta produktionen. För detta finns det flera angreppssätt:
- RUM, eller passiv mätning av förfrågningar. Vi mäter tiden för nuvarande förfrågningar från användarna och säkerställer fullständig användartäckning. Nackdelen är en inte särskilt stabil signal på grund av många faktorer, såsom olika storlekar på förfrågningarna, behandlingstid på servern och klienten. Dessutom kan man inte testa en ny konfiguration utan effekt på produktion.
- Laboratorietester. Speciella servrar och infrastruktur som imiterar kunder. Genom dessa utför vi nödvändiga tester. På så sätt får vi fullständig kontroll över mätresultaten och ett tydligt signal. Men det finns ingen fullständig täckning av enheter och användarlägen (särskilt med en tjänst över hela världen och stöd för tusentals enhetsmodeller).
Hur kan man kombinera fördelarna med båda metoderna?
Vårt team har hittat en lösning. Vi skrev en liten kodsnutt – en probe – som vi integrerade i vår applikation. Prober låter oss göra helt kontrollerade nätverkstester från våra enheter. Det fungerar på följande sätt:
- Strax efter att appen har laddats ner och den initiala aktiviteten har avslutats startar vi våra prober.
- Kunden gör en begäran till servern och får ett "recept" för testet. Receptet är en lista med URL-adresser som HTTP(s) begäran ska göras mot. Utöver detta konfigurerar receptet begärningsparametrar: fördröjningar mellan begärningar, mängd begärda data, HTTP(s) headers osv. Dessutom kan vi parallellt testa flera olika recept – vid begäran om konfiguration bestäms slumpmässigt vilket recept som ska ges.
- Tidpunkten för start av proben väljs så att den inte krockar med aktiv användning av nätverksresurser på kunden. I praktiken väljs tiden när kunden inte är aktiv.
- Efter att ha mottagit receptet gör kunden begärningar till var och en av URL-adresserna parallellt. Begäran till varje adress kan upprepas – så kallade "pulser". Vid den första pulsen mäter vi hur lång tid det tog att etablera en koppling och ladda ner data. Vid den andra pulsen mäter vi tiden för att ladda ner data via den redan etablerade kopplingen. Före den tredje kan vi sätta en fördröjning och mäta hastigheten för att återetablera kopplingen osv.
Under test, we measure all parameters that the device can obtain:
- DNS request time;
- TCP connection setup time;
- TLS connection setup time;
- time to receive the first byte of data;
- total loading time;
- status code result.
- After all pulses are completed, the sample downloads the results of all measurements for analytics.
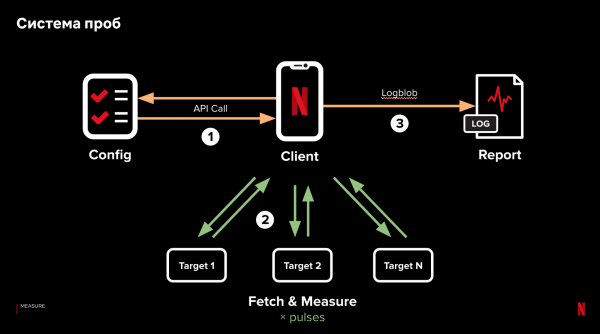
Key points include minimal dependence on client logic, data processing on the server, and measuring concurrent requests. This allows us to isolate and test the impact of various factors influencing request performance, varying them within a single recipe, and obtaining results from real clients.
Such infrastructure has proven useful not only for analyzing request performance. Currently, we have 14 active recipes, over 6,000 samples per second, receiving data from all corners of the earth with full device coverage. If Netflix were to purchase such a service from third-party companies, it would cost millions of dollars a year, with much worse coverage.
Testing the theory in practice: prototype
With such a system, we were able to assess the efficiency of the CDN proxy on request latency. Now we need to:
- create a proxy prototype;
- deploy the prototype on the CDN;
- determine how to route clients to the proxy on a specific CDN server;
- compare performance with requests to AWS without a proxy.
The task is to quickly evaluate the effectiveness of the proposed solution. For the prototype implementation, we chose Go due to its good network libraries. We installed the proxy prototype as a static binary on each CDN server to minimize dependencies and simplify integration. In the initial implementation, we maximized the use of standard components and made small modifications for HTTP/2 connection pooling and request multiplexing.
För att balansera mellan AWS-regioner har vi använt en geografisk DNS-databas, samma som används för att balansera kunder. För att välja en CDN-server för kunden använder vi TCP Anycast för servrar i Internet Exchange (IX). I detta alternativ använder vi en IP-adress för alla CDN-servrar, vilket gör att kunden dirigeras till CDN-servern med det minsta antalet IP-hops. Vi har ingen kontroll över routern för att konfigurera TCP Anycast på CDN-servrar som är installerade hos internetleverantörer (ISP), så vi använder , enligt vilken kunder dirigeras till internetleverantörer för videostreaming.
Så, vi har tre typer av vägar för begäran: till molnet via öppna internet, via en CDN-server i IX eller via en CDN-server belägen hos internetleverantören. Vårt mål är att förstå vilken väg som är bäst och vilken nytta vi får av proxy jämfört med hur begärningar dirigeras i produktion. För detta använder vi ett testsystem på följande sätt:
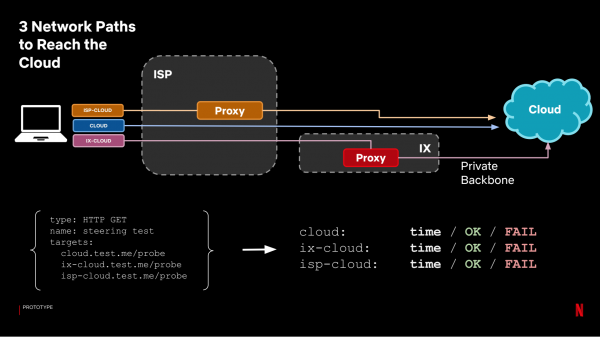
Varje väg blir ett separat mål, och vi ser på den tid vi fått. För analysen slår vi samman proxyresultaten i en grupp (väljer den bästa tiden mellan IX och ISP-proxy), och jämför med tiden för begärningar till molnet utan proxy:
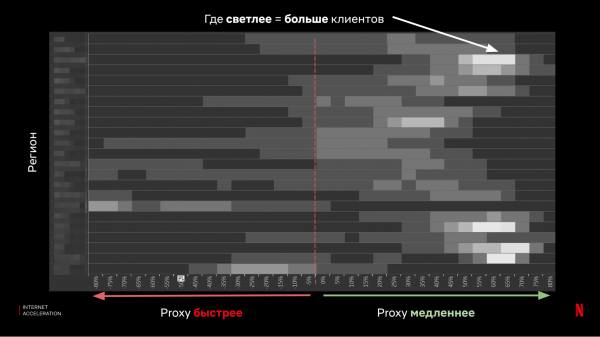
Som man kan se, visade resultaten sig vara otydiga — i de flesta fall ger proxy en bra acceleration, men det finns också tillräckligt med kunder där situationen avsevärt försämras.
I slutändan gjorde vi flera viktiga saker:
- Utvärderade den förväntade prestandan för begärningar från kunder till molnet via CDN-proxy.
- Fick data från riktiga kunder, från alla typer av enheter.
- Förstod att teorin inte bekräftades till 100% och det initiala förslaget med CDN-proxy skulle inte fungera för oss.
- Vi riskerade inte — vi ändrade inte produktionskonfigurationen för kunderna.
- Vi brakade ingenting.
Prototyp 2.0
Så, vi går tillbaka till ritbordet och upprepar processen från början.
Idén — istället för 100% proxy kommer vi för varje kund att bestämma den snabbaste vägen och dirigera begärningar dit — det vill säga, vi kommer att göra det som kallas klientstyrning.
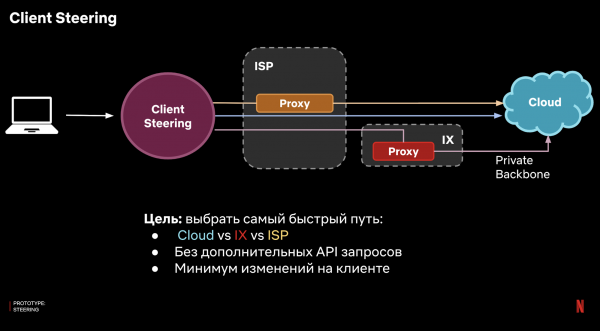
Hur ska vi implementera detta? Vi kan inte använda logik på serversidan, eftersom syftet är att ansluta till denna server. Vi måste på något sätt göra detta på klienten. Och helst ska vi göra det med minsta möjliga komplexitet för att undvika integrationsfrågor med ett stort antal klientplattformar.
Svaret är att använda DNS. I vårt fall har vi en egen DNS-infrastruktur, och vi kan ställa in en domänzon för vilken våra servrar kommer att vara auktoritativa. Det fungerar så här:
- Klienten gör en begäran till DNS-servern med hjälp av en värd, till exempel api.netflix.com.
- Begäran når vår DNS-server.
- DNS-servern vet vilken väg som är snabbast för denna klient och ger den motsvarande IP-adressen.
Det finns en ytterligare komplexitet i lösningen: auktoritativa DNS-leverantörer ser inte klientens IP-adress och kan endast se IP-adressen till den rekursiva resolver som klienten använder.
I slutändan måste vår auktoritativa resolver fatta beslut inte för enskilda klienter, utan för en grupp av klienter baserat på den rekursiva resolvern.
För att lösa detta använder vi samma probes, aggregerar mätresultaten från klienterna mot varje rekursiv resolver och avgör vart denna grupp ska dirigeras – via proxy genom IX med hjälp av TCP Anycast, genom ISP-proxy eller direkt till molnet.
Vi får ett sådant system:
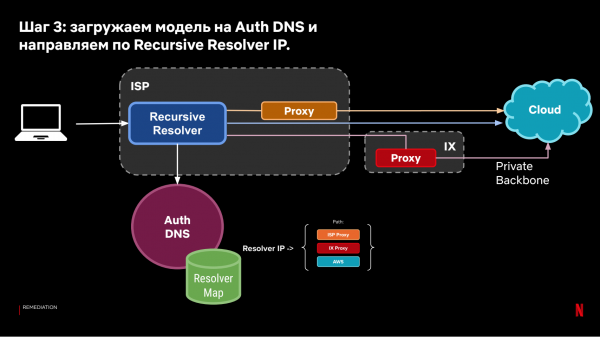
Den resulterande modellen för DNS-styrning gör att vi kan rikta klienter baserat på historiska observationer av hastigheten på anslutningar från klienter till molnet.
återigen, frågan är – hur effektivt kommer detta tillvägagångssätt att fungera? För att svara på detta använder vi återigen vårt system för probes. Så vi ställer in en konfiguration av recency, där en av målen följer DNS-styrning, den andra går direkt till molnet (nuvarande produktion).
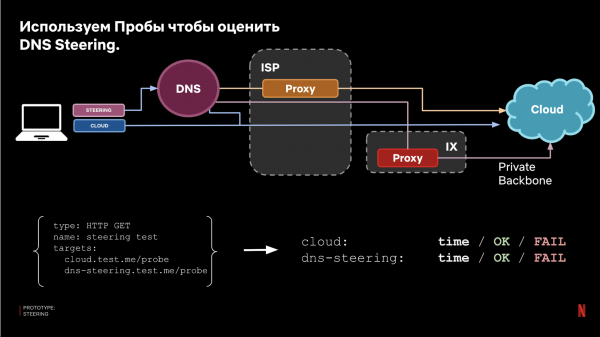
I slutändan jämför vi resultaten och får en uppskattning av effektiviteten:
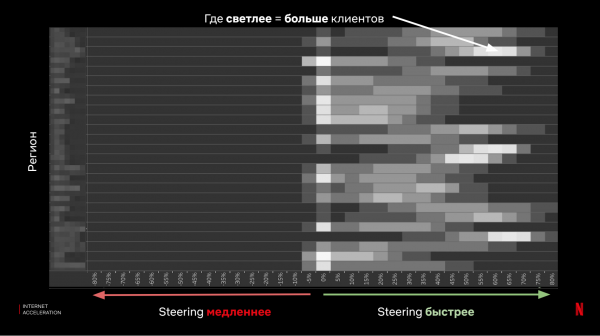
Som ett resultat lärde vi oss flera viktiga saker:
- Vi utvärderade den förväntade prestandan för begärningar från klienter till molnet med hjälp av DNS-styrning.
- Fick data från riktiga kunder, från alla typer av enheter.
- Vi bevisade effektiviteten av den föreslagna idén.
- Vi riskerade inte — vi ändrade inte produktionskonfigurationen för kunderna.
- Vi brakade ingenting.
Nu till det svåra – vi kör i produktion.
Det lättaste ligger nu bakom oss — vi har en fungerande prototyp. Den svåra delen är att skala lösningen för all Netflix-trafik, rulla ut den till 150 miljoner användare, tusentals enheter, hundratals mikrotjänster och ständigt föränderliga produkter och infrastruktur. Netflix-servrarna tar emot miljoner förfrågningar per sekund, och det är lätt att bryta tjänsten med en oförsiktig handling. Samtidigt vill vi dynamiskt styra trafiken genom tusentals CDN-servrar på internet, där saker ständigt förändras och går sönder, ofta vid de mest olämpliga tillfällena.
Och trots allt detta finns det tre ingenjörer i teamet som ansvarar för utveckling, distribution och fullständig support av systemet.
Så vi kommer att prata om lugn och hälsosam sömn härnäst.
Hur fortsätter vi utvecklingen istället för att spendera all tid på support? Kärnan i vårt tillvägagångssätt bygger på tre principer:
- Vi minskar den potentiella skalan av fel (blast radius).
- Vi förbereder oss för överraskningar — förväntar oss att saker går sönder, oavsett testning och personlig erfarenhet.
- Gradvis nedgradering (graceful degradation) — om något inte fungerar som det ska, ska det automatiskt repareras, även om det inte är det mest effektiva sättet.
Det visade sig att i vårt fall, med detta tillvägagångssätt för problem, kan vi hitta en enkel och effektiv lösning och betydligt förenkla systemsupporten. Vi insåg att vi kunde lägga till en liten mängd kod i klienten för att övervaka fel med nätverksförfrågningar orsakade av anslutningsproblem. Vid nätverksfel gör vi en fallback direkt till molnet. Denna lösning kräver inte stora ansträngningar från klientteam, men minskar avsevärt risken för oväntade fel och överraskningar för oss.
Naturligtvis, trots fallback, följer vi fortfarande en strikt disciplin i utvecklingsprocessen:
- Test på prover.
- A/B-testning eller Canaries.
- Gradvis lansering (progressive rollout).
Med prover har tillvägagångssättet beskrivits — förändringar testas först med hjälp av en konfigurerad recept.
För canary-testning behöver vi få jämförbara par av servrar, där vi kan jämföra hur systemet fungerar före och efter förändringar. För detta väljer vi par av servrar från våra många CDN-webbplatser som får jämförbar trafik:
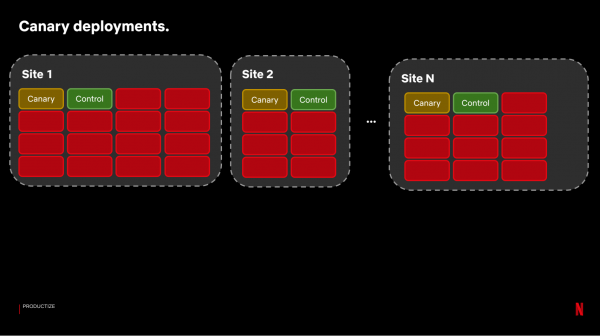
Därefter placerar vi byggnaden med ändringar på Canary-servrar. För att utvärdera resultaten kör vi ett system som jämför cirka 100-150 metriker med en kontrollgrupp av servrar:
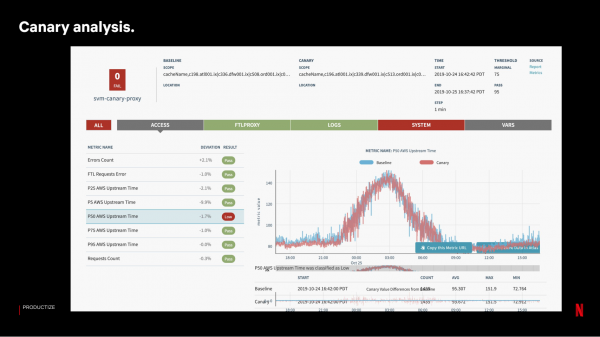
Om Canary-testningen lyckas gör vi en gradvis release i vågor. På varje webbplats uppdaterar vi inte servrarna samtidigt — förlusten av en hel webbplats vid problem har en större påverkan på användartjänsten än förlusten av samma antal servrar, men på olika platser.
Överlag beror effektiviteten och säkerheten i tillvägagångssättet på mängden och kvaliteten av insamlade metriker. För vårt system för att påskynda förfrågningar samlar vi in metriker från alla möjliga komponenter:
- från kunder — antal sessioner och förfrågningar, fallback rates;
- proxy — statistik om antal och tid för förfrågningar;
- DNS — antal och resultat av förfrågningar;
- cloud edge — antal och tid för behandling av förfrågningar i molnet.
Allt detta samlas i en enhetlig pipeline, och beroende på behov beslutar vi vilka metriker som ska skickas till realtidsanalys och vilka som ska gå till Elasticsearch eller Big Data för mer detaljerad diagnostik.
Övervakar
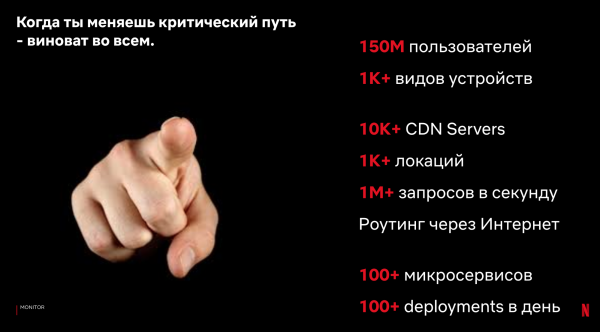
I vårt fall gör vi ändringar på den kritiska vägen för förfrågningar mellan klienten och servern. Under tiden är antalet olika komponenter på klienten, servern och vägen genom internet enorma. Ändringar på klienten och servern sker ständigt — genom arbetet av tiotals team och naturliga förändringar i ekosystemet. Vi är i mitten — vid diagnostik av problem finns det stor risk att vi är involverade. Därför behöver vi tydligt förstå hur vi ska definiera, samla in och analysera metriker för att snabbt lokalisera problem.
Idealiskt sett — full tillgång till alla typer av metriker och filter i realtid. Men det finns väldigt många metriker, så kostnadsfrågan kommer upp. I vårt fall separerar vi metriker och utvecklingsverktyg enligt följande:
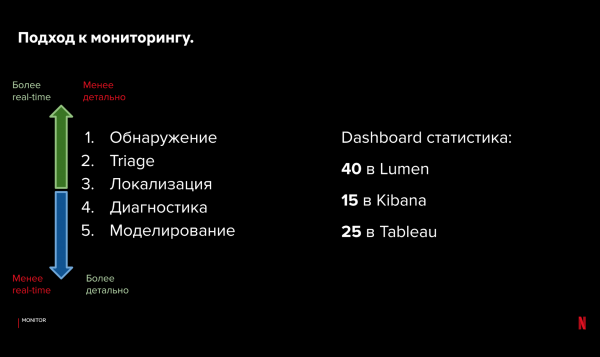
För att upptäcka och triagera problem använder vi vårt eget realtids system med öppen källkod och — för visualisering. Det lagrar aggreggaterade metriker i minnet, är pålitligt och integreras med alertsystemet. För lokalisering och diagnostik har vi tillgång till loggar från Elasticsearch och Kibana. För statistisk analys och modellering — använder vi big data och visualisering i Tableau.
Det verkar som att det är mycket svårt att arbeta med en sådan metod. Men med en hierarkisk organisation av mätningar och verktyg kan vi snabbt analysera problemet, identifiera typ av problem och sedan fördjupa oss i detaljerade mätningar. För att lokalisera källan till ett fel tar vi i genomsnitt omkring 1-2 minuter. Efter det arbetar vi redan med det specifika teamet på diagnostik — från tiotals minuter till flera timmar.
Även om diagnosen görs snabbt, vill vi inte att det ska hända ofta. I bästa fall får vi ett kritiskt alert bara när det finns en betydande påverkan på tjänsten. För vårt system för cachning av förfrågningar har vi bara 2 alert som kommer att informera oss:
- andel av Client Fallback — bedömning av kundbeteende;
- andel av Probe errors — data om stabiliteten hos nätverkskomponenter.
Dessa kritiska alert övervakar om systemet fungerar för de flesta användare. Vi tittar på hur många kunder som utnyttjade fallback om de inte kunde få en snabbare förfrågan. I genomsnitt har vi mindre än 1 kritisk notis per vecka, även om det sker en stor mängd förändringar i systemet. Varför är det tillräckligt för oss?
- Det finns en klientfallback om vår proxy inte fungerar.
- Det finns ett automatiskt styrsystem som reagerar på problem.
Om det senaste, vår probesystem och systemet för automatisk vägval för förfrågningar från klienten till molnet, gör det möjligt att automatiskt hantera vissa problem.
Låt oss återgå till vår konfiguration av proverna och 3 kategorier av vägar. Förutom laddningstid kan vi även titta på faktiskt leverans. Om det inte gick att ladda data, kan vi genom att titta på resultaten från olika vägar avgöra var och vad som har gått fel, och om vi kan återställa det automatiskt genom att ändra begärans väg.
Exempel:
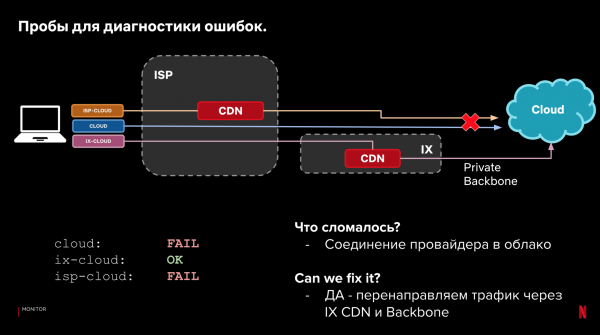
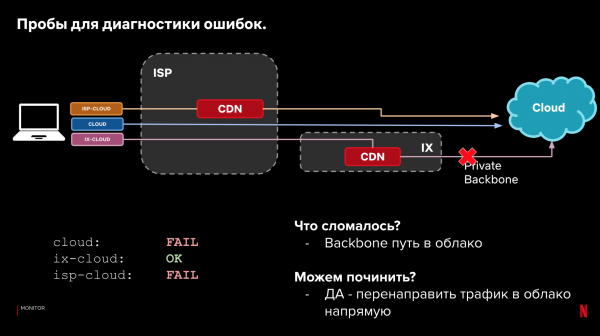
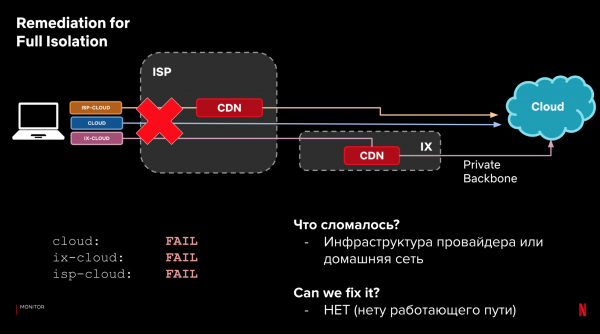
Denna process kan automatiseras. Integrera den i styrsystemet. Och lära det att reagera på problem med prestanda och tillförlitlighet. Om något börjar gå fel — reagera, om det finns en bättre alternativ. Samtidigt är en omedelbar reaktion inte kritisk, tack vare fallback på klienterna.
Således kan principerna för systemunderhåll formuleras så här:
- minska omfattningen av fel;
- samla mätningar;
- automatiskt åtgärda fel, om vi kan;
- om vi inte kan — meddela;
- Vi arbetar med dashboards och triage-verktyg för snabb respons.
Lärdomar
Det tar inte mycket tid att skriva en prototyp. I vårt fall var den klar redan efter 4 månader. Med den fick vi nya mätvärden, och efter 10 månader från utvecklingens början fick vi vår första produktions trafik. Sedan började det tråkiga och mycket svåra arbetet: att gradvis produktifiera och skala systemet, migrera den huvudsakliga trafiken och lära av misstagen. Denna effektiva process kommer inte att vara linjär — trots alla ansträngningar kan man inte förutsäga allt. Mycket mer effektivt är snabb iteration och respons på nya data.
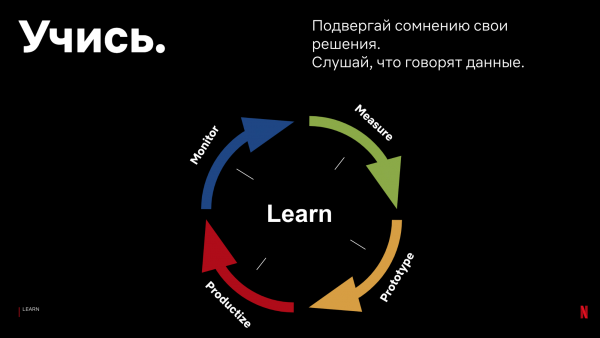
Baserat på vår erfarenhet kan vi rekommendera följande:
- Lita inte på din intuition.
Vår intuition har ständigt svikit oss, trots den enorma erfarenheten hos teammedlemmarna. Till exempel, vi felbedömde den uppskattade förbättringen från att använda CDN-proxyer eller beteendet hos TCP Anycast.
- Hämta data från produktion.
Det är viktigt att så snabbt som möjligt få tillgång till åtminstone en liten mängd produktionsdata. Antalet unika fall, konfigurationer och inställningar i labbmiljöer är praktiskt taget omöjligt att få. Snabb tillgång till resultaten gör att vi snabbare kan upptäcka potentiella problem och beakta dem i systemarkitekturen.
- Följ inte andras råd och resultat — samla dina egna data.
Följ principerna för insamling och analys av data, men ta inte blint andras resultat och påståenden. Endast du kan veta exakt vad som fungerar för dina användare. Ditt system och dina kunder kan skilja sig avsevärt från andra företag. Lyckligtvis är verktyg för analys nu tillgängliga och lätta att använda. De resultat du får kanske inte stämmer överens med vad Netflix, Facebook, Akamai och andra företag hävdar. I vårt fall skiljer sig prestandan för TLS, HTTP2 eller statistiken för DNS-förfrågningar från resultaten från Facebook, Uber, Akamai — eftersom vi har andra enheter, kunder och datastreamar.
- Sträva inte efter trendiga fenomen utan behov och utvärdering av effektivitet.
Börja enkelt. Det är bättre att skapa ett enkelt fungerande system på kort tid än att lägga ner enormt mycket tid på att utveckla komponenter som du inte behöver. Lös de problem och utmaningar som är viktiga baserat på dina mätningar och resultat.
- Var beredd på nya tillämpningar.
Precis som det är svårt att förutsäga alla problem är det också svårt att på förhand förutsäga fördelarna och tillämpningarna. Låt dig inspireras av startups — deras förmåga att anpassa sig efter kundernas behov. I ditt fall kan du upptäcka nya problem och lösningar. I vårt projekt hade vi som mål att minska fördröjningen av förfrågningar. Men under analysen och diskussionerna insåg vi att vi även kunde använda proxyservrar:
- för att balansera trafik mellan AWS-regioner och minska kostnader;
- för att modellera stabilitet i CDN;
- för att konfigurera DNS;
- för att konfigurera TLS/TCP.
Slutsats
I presentationen beskriver jag hur Netflix löser utmaningen att snabba upp internetförfrågningar mellan kunder och molnet. Hur vi samlar in data genom att använda mätpunkter hos kunderna, och använder den insamlade historiska datan för att styra produktionsförfrågningar från kunder genom den snabbaste vägen på internet. Hur vi använder principerna för nätverksprotokoll, vår CDN-infrastruktur, backbone-nätverket och DNS-servrar för att uppnå detta.
Men vår lösning är bara ett exempel på hur vi på Netflix har implementerat ett sådant system. Vad som fungerade för oss. Den praktiska delen av min presentation för er handlar om de principer för utveckling och underhåll som vi följer för att uppnå bra resultat.
Vår lösning på problemet kanske inte passar er. Men teorin och utvecklingsprinciperna kvarstår, även om ni inte har en egen CDN-infrastruktur, eller om den skiljer sig avsevärt från vår.
Betydelsen av hastighet på förfrågningar för verksamheten kvarstår också. Och även för en enkel tjänst måste du göra val: mellan "moln"-leverantörer, serverens placering, CDN och DNS-leverantörer. Ditt val kommer att påverka effektiviteten av internetförfrågningar för dina kunder. Och för dig är det viktigt att mäta och förstå denna påverkan.
Börja med enkla lösningar, och tänk på hur du förändrar produkten. Lär dig under processen och förbättra systemet baserat på data från dina kunder, din infrastruktur och ditt företag. Tänk på möjligheten av oväntade fel under designfasen. Då kan du snabba upp din utvecklingsprocess, förbättra lösningens effektivitet, undvika överbelastning på supporten och sova gott.
I år i onlineformat. Du kommer att kunna ställa frågor till en av DevOps-fäderna, John Willis själv!
Källa: habr.com
