

I denna artikel kommer jag att förklara hur du på 30 minuter kan ställa in en miljö för maskininlärning, skapa ett neuralt nätverk för bildigenkänning och sedan köra samma nätverk på en grafisk processor (GPU).
Låt oss först definiera vad ett neuralt nätverk är.
I vårt fall är det en matematisk modell samt dess program- eller hårdvaruimplementation, uppbyggd enligt principerna för organisation och funktion av biologiska neurala nätverk — nätverk av nervceller i en levande organism. Detta begrepp uppstod vid studiet av processer i hjärnan och i ett försök att modellera dessa processer.
Neurala nätverk programmeras inte på det traditionella sättet, de tränas. Möjligheten att träna är en av de största fördelarna med neurala nätverk jämfört med traditionella algoritmer. Tekniskt sett innebär träning att hitta vikterna på kopplingarna mellan neuroner. Under träningsprocessen kan det neurala nätverket identifiera komplexa beroenden mellan ingångs- och utgångsdata, samt utföra generalisering.
Ur ett maskininlärningsperspektiv är ett neuralt nätverk ett specifikt fall av mönsterigenkänning, diskriminantanalyser, klusteranalysmetoder och andra metoder.
Utrustning
Först låt oss gå igenom hårdvaran. Vi behöver en server med ett installerat operativsystem Linux. Hårdvaran för maskininlärningssystem behöver vara tillräckligt kraftfull och därmed dyr. För dem som inte har en bra dator tillgänglig rekommenderar jag att titta på erbjudanden från molnleverantörer. Den behövda servern kan snabbt hyras och man betalar bara för den tid som används.
I projekt där det krävs skapande av neurala nätverk använder jag servrar från en av de ryska molnleverantörerna. Företaget erbjuder molnservrar speciellt för maskininlärning med kraftfulla grafiska processorer (GPU) Tesla V100 från NVIDIA. Kort sagt: användning av en server med GPU kan vara tiotals gånger mer effektiv (snabb) jämfört med en motsvarande server där beräkningar görs av en CPU (den välkända centrala processorn). Detta uppnås tack vare särskild arkitektur för GPU, som snabbare hanterar beräkningar.
För att genomföra exemplen som beskrivs nedan har vi hyrt en sådan server i några dagar:
- SSD-disk 150 GB
- RAM 32 GB
- Processor Tesla V100 16 Gb med 4 kärnor
På maskinen installerades Ubuntu 18.04.
Installerar miljön
Nu ska vi installera allt som behövs för att arbeta på servern. Eftersom vår artikel framför allt är för nybörjare, kommer jag att prata om några punkter som kommer att vara användbara för dem.
Mycket av arbetet när man konfigurerar miljön görs via kommandoraden. De flesta användare använder Windows som arbets-OS. Standardkonsolen i detta operativsystem lämnar mycket att önska. Därför kommer vi att använda ett bekvämt verktyg . Ladda ner mini-versionen och starta Cmder.exe. Därefter måste vi koppla upp oss mot servern via SSH-protokollet:
ssh root@server-ip-or-hostnameI stället för server-ip-or-hostname anger du IP-adressen eller DNS-namnet på din server. Skriv sedan in ditt lösenord, och vid en lyckad anslutning bör vi få något liknande detta meddelande.
Welcome to Ubuntu 18.04.3 LTS (GNU/Linux 4.15.0-74-generic x86_64)Det främsta språket för att utveckla ML-modeller är Python. Den mest populära plattformen för dess användning på Linux är .
Låt oss installera det på vår server.
Vi börjar med att uppdatera den lokala paketchefen:
sudo apt-get updateInstallerar curl (kommandoradsverktyg):
sudo apt-get install curlLaddar ner den senaste versionen av Anaconda Distribution:
cd /tmp
curl –O https://repo.anaconda.com/archive/Anaconda3-2019.10-Linux-x86_64.sh
Startar installationen:
bash Anaconda3-2019.10-Linux-x86_64.shUnder installationen behöver du bekräfta licensavtalet. Vid en lyckad installation bör du se detta:
Thank you for installing Anaconda3!För utveckling av ML-modeller finns det nu ett antal ramverk tillgängliga, vi arbetar med de mest populära: och .
Användningen av ramverket gör det möjligt att öka hastigheten på utvecklingen och använda redan färdiga verktyg för standarduppgifter.
I det här exemplet kommer vi att arbeta med PyTorch. Vi installerar det:
conda install pytorch torchvision cudatoolkit=10.1 -c pytorchNu behöver vi starta Jupyter Notebook — ett populärt utvecklingsverktyg för ML-specialister. Det gör att du kan skriva kod och omedelbart se resultaten av dess körning. Jupyter Notebook ingår i Anaconda och är redan installerad på vår server. Vi behöver ansluta till den från vårt skrivbordssystem.
För att göra detta först startar vi Jupyter på servern och anger port 8080:
jupyter notebook --no-browser --port=8080 --allow-rootDärefter öppnar vi en ny flik i vår konsol Cmder (övre menyn — New console dialog) och ansluter till servern via SSH på port 8080:
ssh -L 8080:localhost:8080 root@server-ip-or-hostnameNär vi anger den första kommandot kommer vi att erbjudas länkar för att öppna Jupyter i vår webbläsare:
To access the notebook, open this file in a browser:
        file://root/.local/share/jupyter/runtime/nbserver-18788-open.html
    Or copy and paste one of these URLs:
        http://localhost:8080/?token=cca0bd0b30857821194b9018a5394a4ed2322236f116d311
     or http://127.0.0.1:8080/?token=cca0bd0b30857821194b9018a5394a4ed2322236f116d311
Vi använder länken för localhost:8080. Kopiera den fullständiga sökvägen och klistra in den i adressfältet i din lokala webbläsare. Jupyter Notebook öppnas.
Vi skapar en ny notebook: New — Notebook — Python 3.
Vi kontrollerar att alla komponenter vi har installerat fungerar korrekt. Vi skriver in ett exempel på PyTorch-kod i Jupyter och kör det (knapp: Run):
from __future__ import print_function
import torch
x = torch.rand(5, 3)
print(x)
Resultatet bör se ungefär ut så här:
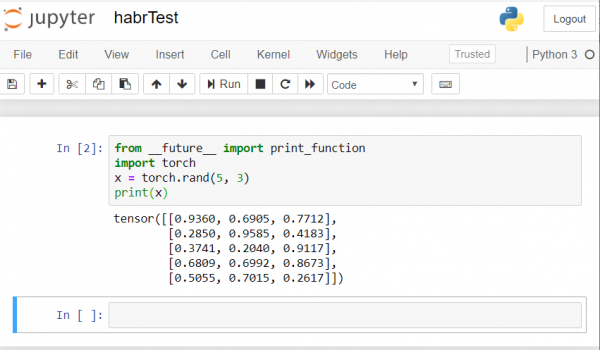
Om du får ett liknande resultat har vi konfigurerat allt korrekt och kan börja utveckla ett neuralt nätverk!
Vi skapar ett neuralt nätverk
Vi kommer att skapa ett neuralt nätverk för bildigenkänning. Vi tar detta som utgångspunkt .
För träning av nätverket kommer vi att använda den offentliga datamängden CIFAR10. Den har klasser: "flygplan", "bil", "fågel", "katt", "hjort", "hund", "groda", "häst", "skepp", "lastbil". Bilderna i CIFAR10 har storleken 3x32x32, det vill säga 3-kanaliga färgbilder med storleken 32×32 pixlar.
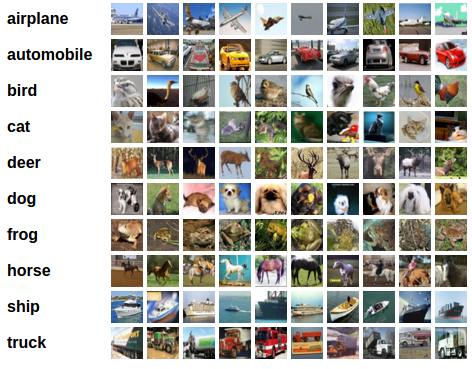
För vårt arbete kommer vi att använda den skapade PyTorch-paketet för bildbehandling — torchvision.
Vi kommer att genomföra följande steg i ordning:
- Nedladdning och normalisering av träningsoch testdatamängder
- Definiera det neuronala nätverket
- Träna nätverket på träningsdata
- Testa nätverket med testdata
- Vi upprepar träningen och testningen med hjälp av GPU
All kod nedan kommer vi att köra i Jupyter Notebook.
Nedladdning och normalisering av CIFAR10
Kopiera och kör följande kod i Jupyter:
import torch
import torchvision
import torchvision.transforms as transforms

transform = transforms.Compose(
    [transforms.ToTensor(),
     transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))])

trainset = torchvision.datasets.CIFAR10(root='./data', train=True,
                                        download=True, transform=transform)
trainloader = torch.utils.data.DataLoader(trainset, batch_size=4,
                                          shuffle=True, num_workers=2)

testset = torchvision.datasets.CIFAR10(root='./data', train=False,
                                       download=True, transform=transform)
testloader = torch.utils.data.DataLoader(testset, batch_size=4,
                                         shuffle=False, num_workers=2)

classes = ('plane', 'car', 'bird', 'cat',
           'deer', 'dog', 'frog', 'horse', 'ship', 'truck')
Svaret ska se ut så här:
Nedladdning av https://www.cs.toronto.edu/~kriz/cifar-10-python.tar.gz till ./data/cifar-10-python.tar.gz
Extrahering av ./data/cifar-10-python.tar.gz till ./data
Filer har redan laddats ner och verifierats
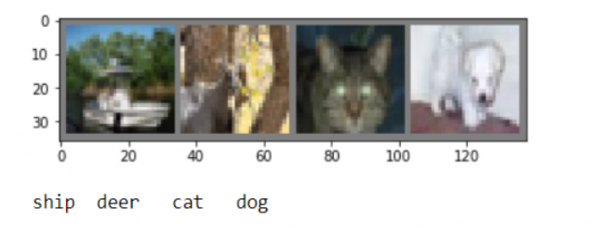
Vi kommer att visa några träningsbilder för verifiering:
import matplotlib.pyplot as plt
import numpy as np

# funktioner för att visa en bild

def imshow(img):
    img = img / 2 + 0.5     # avnormalisera
    npimg = img.numpy()
    plt.imshow(np.transpose(npimg, (1, 2, 0)))
    plt.show()

# hämta några slumpmässiga träningsbilder
dataiter = iter(trainloader)
images, labels = dataiter.next()

# visa bilder
imshow(torchvision.utils.make_grid(images))
# skriv ut etiketter
print(' '.join('%5s' % classes[labels[j]] for j in range(4)))
Definiera det neuronala nätverket
Vi börjar med att se hur ett neuralt nätverk för bildigenkänning fungerar. Det är ett enkelt feedforward-nätverk. Det tar indata, skickar dem genom flera lager ett efter ett och ger slutligen utdata.
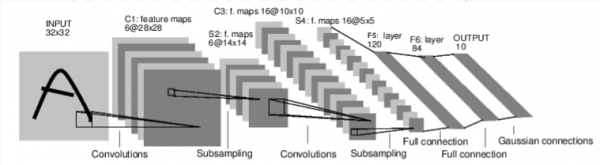
Låt oss skapa ett liknande nätverk i vår miljö:
import torch.nn as nn
import torch.nn.functional as F

class Net(nn.Module):
    def __init__(self):
        super(Net, self).__init__()
        self.conv1 = nn.Conv2d(3, 6, 5)
        self.pool = nn.MaxPool2d(2, 2)
        self.conv2 = nn.Conv2d(6, 16, 5)
        self.fc1 = nn.Linear(16 * 5 * 5, 120)
        self.fc2 = nn.Linear(120, 84)
        self.fc3 = nn.Linear(84, 10)

    def forward(self, x):
        x = self.pool(F.relu(self.conv1(x)))
        x = self.pool(F.relu(self.conv2(x)))
        x = x.view(-1, 16 * 5 * 5)
        x = F.relu(self.fc1(x))
        x = F.relu(self.fc2(x))
        x = self.fc3(x)
        return x

net = Net()
Vi definierar också en förlustfunktion och en optimizer
import torch.optim as optim

criterion = nn.CrossEntropyLoss()
optimizer = optim.SGD(net.parameters(), lr=0.001, momentum=0.9)
Träna nätverket på träningsdata
Vi börjar träningen av vårt neurala nätverk. Jag vill påpeka att efter att du kör den här koden, måste du vänta en stund tills den är klar. Det tog mig 5 minuter. Att träna nätverket tar tid.
 for epoch in range(2):  # loop over the dataset multiple times

    running_loss = 0.0
    for i, data in enumerate(trainloader, 0):
        # get the inputs; data is a list of [inputs, labels]
        inputs, labels = data

        # zero the parameter gradients
        optimizer.zero_grad()

        # forward + backward + optimize
        outputs = net(inputs)
        loss = criterion(outputs, labels)
        loss.backward()
        optimizer.step()

        # print statistics
        running_loss += loss.item()
        if i % 2000 == 1999:    # print every 2000 mini-batches
            print('[%d, %5d] loss: %.3f' %
                  (epoch + 1, i + 1, running_loss / 2000))
            running_loss = 0.0

print('Finished Training')
Vi får följande resultat:
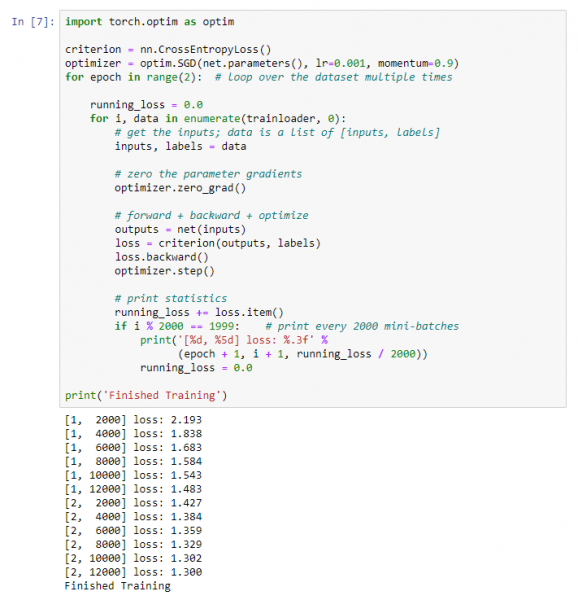
Sparar vår tränade modell:
PATH = './cifar_net.pth'
torch.save(net.state_dict(), PATH)
Testa nätverket med testdata
Vi har tränat nätverket med hjälp av träningsdata. Men vi måste kontrollera om nätverket faktiskt har lärt sig något.
Vi kommer att kontrollera detta genom att förutsäga klassens etikett som det neurala nätverket ger och kontrollera den mot den verkliga etiketten. Om förutsägelsen är korrekt lägger vi till exemplet i listan över korrekta förutsägelser.
Låt oss visa en bild från testdatasetet:
dataiter = iter(testloader)
images, labels = dataiter.next()

# print images
imshow(torchvision.utils.make_grid(images))
print('GroundTruth: ', ' '.join('%5s' % classes[labels[j]] for j in range(4))) 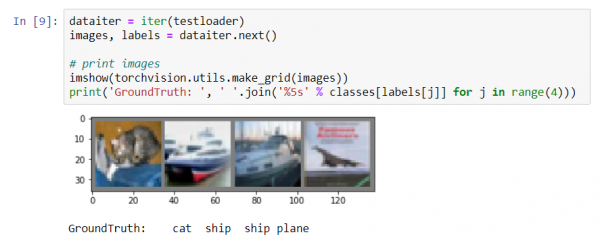
Nu ber vi det neurala nätverket att berätta för oss vad som finns på dessa bilder:
net = Net()
net.load_state_dict(torch.load(PATH))

outputs = net(images)

_, predicted = torch.max(outputs, 1)

print('Predicted: ', ' '.join('%5s' % classes[predicted[j]]
                              for j in range(4)))
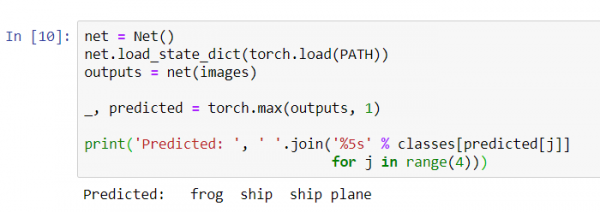
Resultaten verkar ganska bra: nätverket identifierade tre bilder korrekt av fyra.
Låt oss se hur nätverket presterar på hela datasetet.
correct = 0
total = 0
with torch.no_grad():
    for data in testloader:
        images, labels = data
        outputs = net(images)
        _, predicted = torch.max(outputs.data, 1)
        total += labels.size(0)
        correct += (predicted == labels).sum().item()

print('Accuracy of the network on the 10000 test images: %d %%' % (
100 * correct / total)) 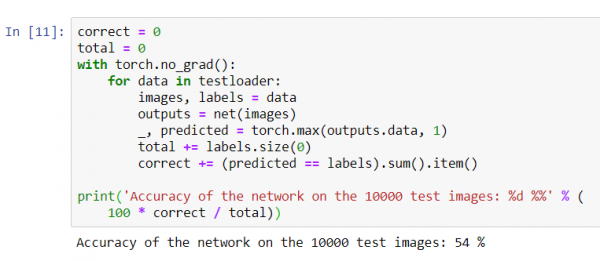
Det verkar som om nätverket vet något och fungerar. Om det hade klassificerat på ett slumpmässigt sätt skulle noggrannheten vara 10%.
Låt oss nu se vilka klasser nätverket identifierar bäst:
class_correct = list(0. for i in range(10))
class_total = list(0. for i in range(10))
with torch.no_grad():
    for data in testloader:
        images, labels = data
        outputs = net(images)
        _, predicted = torch.max(outputs, 1)
        c = (predicted == labels).squeeze()
        for i in range(4):
            label = labels[i]
            class_correct[label] += c[i].item()
            class_total[label] += 1


for i in range(10):
    print('Accuracy of %5s : %2d %%' % (
classes[i], 100 * class_correct[i] / class_total[i])) 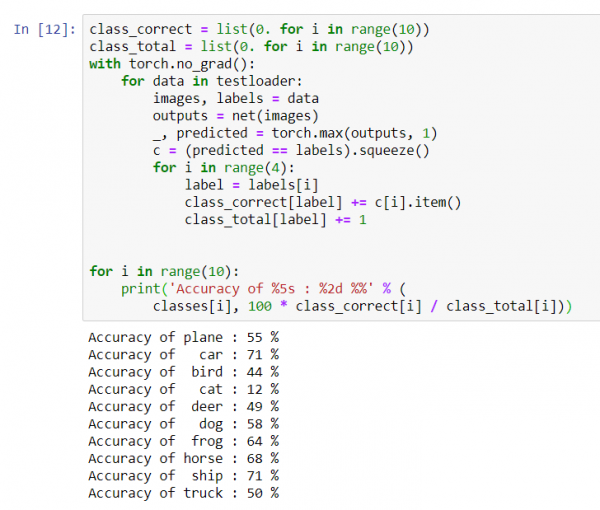
Det verkar som att nätverket mest korrekt identifierar bilar och fartyg: 71% noggrannhet.
Så nätverket fungerar. Nu ska vi försöka köra det på en grafisk processor (GPU) och se vad som förändras.
Träning av neuronnät på GPU
Först ska jag kort förklara vad CUDA är. CUDA (Compute Unified Device Architecture) — en plattform för parallella beräkningar, utvecklad av NVIDIA, för allmänna beräkningar på grafiska processorer (GPU). Med CUDA kan utvecklare avsevärt snabba upp beräkningsapplikationer genom att utnyttja grafiska processorer. På vår server, som vi har köpt, är denna plattform redan installerad.
Låt oss först definiera vår GPU som den första synliga CUDA-enheten.
device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
# Anta att vi är på en CUDA-maskin, detta bör skriva ut en CUDA-enhet:
print(device) 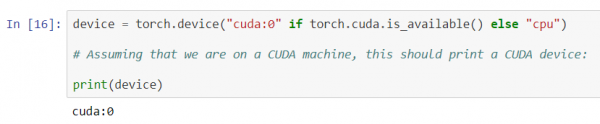
Skickar nätverket till GPU:
net.to(device)Vi måste också skicka indata och mål vid varje steg till GPU:
inputs, labels = data[0].to(device), data[1].to(device)Låt oss träna nätverket igen, denna gång på GPU:
import torch.optim as optim

criterion = nn.CrossEntropyLoss()
optimizer = optim.SGD(net.parameters(), lr=0.001, momentum=0.9)
for epoch in range(2):  # loop over the dataset multiple times

    running_loss = 0.0
    for i, data in enumerate(trainloader, 0):
        # get the inputs; data is a list of [inputs, labels]
    inputs, labels = data[0].to(device), data[1].to(device)

        # zero the parameter gradients
        optimizer.zero_grad()

        # forward + backward + optimize
        outputs = net(inputs)
        loss = criterion(outputs, labels)
        loss.backward()
        optimizer.step()

        # print statistics
        running_loss += loss.item()
        if i % 2000 == 1999:    # print every 2000 mini-batches
            print('[%d, %5d] loss: %.3f' %
                  (epoch + 1, i + 1, running_loss / 2000))
            running_loss = 0.0

print('Finished Training')
Denna gång var nätverkets träningade tid ungefär 3 minuter. Kom ihåg att samma steg på en vanlig processor tog 5 minuter. Skillnaden är inte betydande, och det beror på att vårt nätverk inte är så stort. När vi använder större datamängder för träning kommer skillnaden i hastighet mellan GPU och traditionell processor att öka.
Det verkar som att vi har kommit till slutet. Vad vi lyckades åstadkomma:
- Vi gick igenom vad en GPU är och valde en server där den är installerad;
- Vi ställde in den programmiljö som krävs för att skapa ett neuronnät;
- Vi skapade ett neuronnät för bildigenkänning och tränade det;
- Vi upprepade träningen av nätverket med hjälp av GPU och fick en hastighetsförbättring.
Jag ser fram emot att svara på frågor i kommentarerna.
Källa: habr.com
