

Bakgrund
Det hände sig att servern blev attackerad av ett ransomware-virus, som av "lycklig slump" delvis lämnade .ibd-filer (filer med rådata från innodb-tabeller) orörda, men samtidigt helt krypterade .fpm-filer (strukturfiler). Därför kunde .idb delas in i:
- filer som kan återställas via standardmetoder och guider. För sådana fall finns det en utmärkt ;
- delvis krypterade tabeller. Det handlar huvudsakligen om stora tabeller, som (som jag förstod det) angriparna inte hade tillräckligt med RAM för att kryptera helt;
- och helt krypterade tabeller, som inte går att återställa.
Det gick att bestämma vilken av alternativen tabellerna tillhörde genom att enkelt öppna dem i vilken textredigerare som helst med rätt kodning (i mitt fall UTF8) och bara kolla filen för textfält, till exempel:
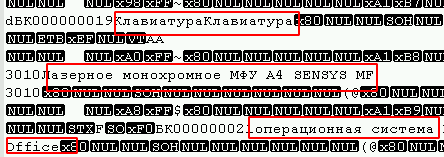
Dessutom kan man i början av filen se en stor mängd nollor, och virus som använder blockkrypteringsalgoritmer (de mest förekommande) brukar vanligtvis påverka dem också.

I mitt fall lämnade angriparna en rad av fyra bytes (1, 0, 0, 0) i slutet av varje krypterad fil, vilket gjorde uppgiften enklare. För att hitta de osmittade filerna räckte det med ett skript:
def opened(path):
    files = os.listdir(path)
    for f in files:
        if os.path.isfile(path + f):
            yield path + f

for full_path in opened("C:somepath"):
    file = open(full_path, "rb")
    last_string = ""
    for line in file:
        last_string = line
        file.close()
    if (last_string[len(last_string) -4:len(last_string)]) != (1, 0, 0, 0):
        print(full_path)
Således lyckades jag hitta filer som tillhörde den första typen. Den andra typen innebär långvarigt manuellt arbete, men den hittade mängden var redan tillräcklig. Allt skulle vara bra, men det är nödvändigt att veta den helt exakta strukturen och (naturligtvis) inträffade en sådan situation, att jag tvingades arbeta med en ofta förändrad tabell. Ingen kom ihåg om fältets typ hade ändrats eller om en ny kolumn lagts till.
Tyvärr kunde Debris City inte hjälpa med ett sådant fall, så denna artikel skrivs.
Till saken
Det finns en tabellstruktur från tre månader sedan som inte stämmer överens med nuvarande (kanske på ett fält, eller kanske fler). Tabellstrukturen är:
CREATE TABLE `table_1` (
    `id` INT (11),
    `date` DATETIME ,
    `description` TEXT ,
    `id_point` INT (11),
    `id_user` INT (11),
    `date_start` DATETIME ,
    `date_finish` DATETIME ,
    `photo` INT (1),
    `id_client` INT (11),
    `status` INT (1),
    `lead__time` TIME ,
    `sendstatus` TINYINT (4)
);
Samtidigt måste följande extraheras:
id_pointINT (11);id_userINT (11);date_startDATETIME ;date_finishDATETIME .
För återställning används byte-för-byte analys av .ibd-filen, följt av översättning av dessa till en mer läsbar form. Eftersom det för att söka det vi behöver räcker att analysera sådana datatyper som int och datetime kommer artikeln endast att beskriva dem, men ibland kommer jag att hänvisa till andra datatyper som kan vara till hjälp i liknande situationer.
Problem 1: i fälten med DATETIME och TEXT typer fanns det NULL-värden, och i filen hoppar de helt enkelt över, vilket gör att det inte gick att bestämma strukturen för återställning i mitt fall. I de nya kolumnerna var standardvärdet null, och en del av transaktionerna kan ha gått förlorade på grund av inställningen innodb_flush_log_at_trx_commit = 0, så för att bestämma strukturen skulle man ha behövt lägga mer tid.
Problem 2: det bör beaktas att rader som har tagits bort via DELETE fortfarande finns i ibd-filen, men vid ALTER TABLE kommer deras struktur inte att uppdateras. I slutändan kan databasstrukturen variera från början av filen till dess slut. Om du ofta använder OPTIMIZE TABLE kommer du sällan att stöta på denna typ av problem.
Observera, versionsnummer av databashanteraren påverkar hur data lagras, och detta exempel kanske inte fungerar för andra majorversioner. I mitt fall användes windows-versionen av mariadb 10.1.24. Dessutom, även om du arbetar med InnoDB-tabeller i mariadb, så är de faktiska , vilket utesluter tillämplighet av metoden med InnoDB mysql.
Analys av filen
I python representerar datatypen visar data i unicode istället för en vanlig uppsättning siffror. Även om filen kan ses på detta sätt, för bekvämlighetens skull kan man konvertera bytes till numerisk form genom att omvandla byte-arrayen till en vanlig array (list(example_byte_array)). I vilket fall som helst, för analys kommer båda metoder att vara till nytta.
Genom att granska flera ibd-filer kan man stöta på följande:
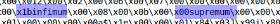
Och om man delar filen efter dessa nyckelord får man i huvudsak jämna block av data. Vi kommer att använda infimum som avdelare.
table = table.split("infimum".encode())Intressant observation, för tabeller med en liten mängd data finns det ett pekare mellan infimum och supremum som anger antalet rader i blocket.
 — testtabell med 1 rad
 — testtabell med 2 rader
Array of strings table[0] can be skipped. Upon reviewing it, I still couldn't find the raw data of the tables. Most likely, this block is used to store indexes and keys.
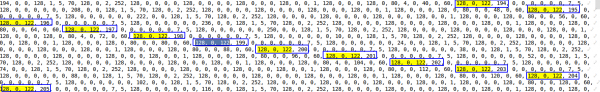
Starting from table[1] and converting it into a numeric array, certain patterns can already be observed, namely:
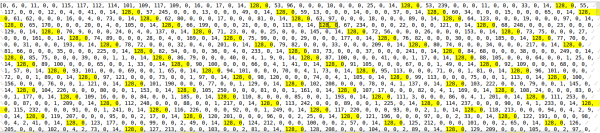
These are int values stored in a string. The first byte indicates whether the number is positive or negative. In my case, all numbers are positive. From the remaining 3 bytes, the number can be determined using the following function. Script:
def find_int(val: str):  # example '128, 1, 2, 3'
    val = [int(v) for v in  val.split(", ")]
    result_int = val[1]*256**2 + val[2]*256*1 + val[3]
    return result_int
Till exempel, 128, 0, 0, 1 = 1, eller 128, 0, 75, 108 = 19308.
The table had a primary key with auto-increment, and it can also be found here.
By matching data from the test tables, it was found that the DATETIME object consists of 5 bytes, starting with 153 (most likely indicating annual intervals). Since the DATETIME range is ‘1000-01-01’ to ‘9999-12-31’, I think the number of bytes may vary, but in my case, the data falls within the range from 2016 to 2019, so we will consider that 5 bytes are sufficient.
To determine the time without seconds, the following functions were written. Script:
day_ = lambda x: x % 64 // 2  # {x,x,X,x,x }

def hour_(x1, x2):  # {x,x,X1,X2,x}
    if x1 % 2 == 0:
        return x2 // 16
    elif x1 % 2 == 1:
        return x2 // 16 + 16
    else:
        raise ValueError

min_ = lambda x1, x2: (x1 % 16) * 4 + (x2 // 64)  # {x,x,x,X1,X2}
For the year and month, I couldn't write a functional working function, so I had to hardcode it. Script:
ym_list = {'2016, 1': '153, 152, 64', '2016, 2': '153, 152, 128',
           '2016, 3': '153, 152, 192', '2016, 4': '153, 153, 0',
           '2016, 5': '153, 153, 64', '2016, 6': '153, 153, 128',
           '2016, 7': '153, 153, 192', '2016, 8': '153, 154, 0',
           '2016, 9': '153, 154, 64', '2016, 10': '153, 154, 128',
           '2016, 11': '153, 154, 192', '2016, 12': '153, 155, 0',
           '2017, 1': '153, 155, 128', '2017, 2': '153, 155, 192',
           '2017, 3': '153, 156, 0', '2017, 4': '153, 156, 64',
           '2017, 5': '153, 156, 128', '2017, 6': '153, 156, 192',
           '2017, 7': '153, 157, 0', '2017, 8': '153, 157, 64',
           '2017, 9': '153, 157, 128', '2017, 10': '153, 157, 192',
           '2017, 11': '153, 158, 0', '2017, 12': '153, 158, 64',
           '2018, 1': '153, 158, 192', '2018, 2': '153, 159, 0',
           '2018, 3': '153, 159, 64', '2018, 4': '153, 159, 128',
           '2018, 5': '153, 159, 192', '2018, 6': '153, 160, 0',
           '2018, 7': '153, 160, 64', '2018, 8': '153, 160, 128',
           '2018, 9': '153, 160, 192', '2018, 10': '153, 161, 0',
           '2018, 11': '153, 161, 64', '2018, 12': '153, 161, 128',
           '2019, 1': '153, 162, 0', '2019, 2': '153, 162, 64',
           '2019, 3': '153, 162, 128', '2019, 4': '153, 162, 192',
           '2019, 5': '153, 163, 0', '2019, 6': '153, 163, 64',
           '2019, 7': '153, 163, 128', '2019, 8': '153, 163, 192',
           '2019, 9': '153, 164, 0', '2019, 10': '153, 164, 64',
           '2019, 11': '153, 164, 128', '2019, 12': '153, 164, 192',
           '2020, 1': '153, 165, 64', '2020, 2': '153, 165, 128',
           '2020, 3': '153, 165, 192','2020, 4': '153, 166, 0',
           '2020, 5': '153, 166, 64', '2020, 6': '153, 1, 128',
           '2020, 7': '153, 166, 192', '2020, 8': '153, 167, 0',
           '2020, 9': '153, 167, 64','2020, 10': '153, 167, 128',
           '2020, 11': '153, 167, 192', '2020, 12': '153, 168, 0'}

def year_month(x1, x2):  # {x,X,X,x,x }

    for key, value in ym_list.items():
        key = [int(k) for k in key.replace("'", "").split(", ")]
        value = [int(v) for v in value.split(", ")]
        if x1 == value[1] and x2 // 64 == value[2] // 64:
            return key
    return 0, 0
Jag är säker på att om man lägger ner n antal timmar kan detta missförstånd också åtgärdas.
Härnäst, en funktion som returnerar ett datetime-objekt från en sträng. Skript:
def find_data_time(val:str):
    val = [int(v) for v in val.split(", ")]
    day = day_(val[2])
    hour = hour_(val[2], val[3])
    minutes = min_(val[3], val[4])
    year, month = year_month(val[1], val[2])
    return datetime(year, month, day, hour, minutes)
Det har lyckats upptäcka ofta förekommande värden från int, int, datetime, datetime 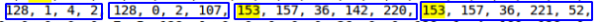 , verkar som detta är vad som behövs. Dessutom upprepas en sådan sekvens inte två gånger i strängen.
Genom att använda ett reguljärt uttryck letar vi efter de nödvändiga uppgifterna:
fined = re.findall(r'128, d*, d*, d*, 128, d*, d*, d*, 153, 1[6,5,4,3]d, d*, d*, d*, 153, 1[6,5,4,3]d, d*, d*, d*', int_array)Observera att vid sökning med detta uttryck går det inte att identifiera NULL-värden i de nödvändiga fälten, men i mitt fall är detta inte kritiskt. Efteråt itererar vi genom de funna resultaten. Skript:
result = []
for val in fined:
    pre_result = []
    bd_int  = re.findall(r"128, d*, d*, d*", val)
    bd_date= re.findall(r"(153, 1[6,5,4,3]d, d*, d*, d*)", val)
    for it in bd_int:
        pre_result.append(find_int(bd_int[it]))
    for bd in bd_date:
        pre_result.append(find_data_time(bd))
    result.append(pre_result)
Det är faktiskt allt, data från arrayen result är de nödvändiga uppgifterna för oss. ###PS.###
Jag förstår att denna metod inte passar alla, men huvudsyftet med artikeln är mer att inspirera till handling än att lösa alla era problem. Jag tror att det mest korrekta tillvägagångssättet skulle vara att börja studera källkoden själv , men på grund av begränsad tid verkade den aktuella metoden mest snabb.
I vissa fall, efter att ha analyserat filen, kan du avgöra den ungefärliga strukturen och återställa den med en av de standardmetoder som nämns ovan. Det kommer att vara mycket mer korrekt och orsaka färre problem.
Källa: habr.com
