

Inför kursstarten vi har förberett ytterligare en användbar översättning för dig.
Grafdatabaser är en viktig teknik för databasspecialister. Jag försöker hålla mig uppdaterad om innovationer och nya teknologier inom detta område, och efter att ha arbetat med relations- och NoSQL-databaser ser jag att rollen för grafdatabaser blir allt mer central. När det gäller komplexa hierarkiska data är traditionella databaser inte bara ineffektiva, utan även NoSQL. Ofta, med en ökning av antalet nivåer av relationer och databasens storlek, observeras en minskning av prestanda. Och med en ökning av sambandens komplexitet ökar också antalet JOIN.
Självklart finns det lösningar för att hantera hierarkier i den relationsbaserade modellen (till exempel med hjälp av rekursiva CTE), men det förblir iaf en kringgående väg. Samtidigt gör funktionaliteten i grafdatabaser i SQL Server det möjligt att enkelt hantera flera nivåer av hierarkier. Både datamodellen och frågorna förenklas, vilket gör dem mer effektiva. Mängden kod minskar avsevärt.
Grafdatabaser är ett uttrycksfullt språk för att representera komplexa system. Denna teknik används redan ganska brett inom IT-branschen i sådana områden som sociala nätverk, anti-bedrägerisystem, analys av IT-nätverk, sociala rekommendationer, produkt- och innehållsrekommendationer.
Funktionaliteten i grafdatabaser i SQL Server passar för scenarier där data är starkt sammankopplade och har tydligt definierade relationer.
Grafdatamodell
En graf är en mängd av noder (vertex, node) och kanter (edge, relationer). Noder representerar entiteter, och kanter representerar relationer, där attribut kan innehålla information.
Grafdatabasen modellerar entiteter i form av en graf som den definieras i grafteori. Datatyperna är noder och kanter. Attribut är egenskaper hos noder och kanter. Relation är en koppling mellan noder.
Till skillnad från andra datamodeller prioriterar grafdatabaser relationer mellan entiteter. Därför krävs det inte att beräkna relationer med hjälp av främmande nycklar eller på andra sätt. Man kan skapa komplexa datamodeller med endast abstraktioner av noder och kanter.
I den moderna världen kräver modellering av relationer allt mer komplexa metoder. För att modellera relationer erbjuder SQL Server 2017 funktioner för grafdatabaser. Noder och kanter i grafen representeras som nya tabelltyper: NODE och EDGE. För frågor till grafen används en ny T-SQL-funktion som kallas MATCH(). Eftersom denna funktionalitet är inbyggd i SQL Server 2017 kan den användas i dina befintliga databaser utan att det krävs någon konvertering.
Fördelarna med grafmodellen
För närvarande kräver företag och användare applikationer som hanterar allt större datamängder och förväntar sig hög prestanda och tillförlitlighet. Att presentera data som en graf erbjuder bekväma medel för att hantera komplexa relationer. Denna metod gör det möjligt att lösa många problem och hjälper till att få resultat inom en given kontext.
Det verkar som att många applikationer i framtiden kommer att dra nytta av att använda grafdatabaser.
Datamodellering: från relationsmodellen till grafmodellen
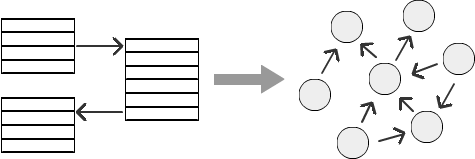
Exempel
Låt oss titta på ett exempel på en organisationsstruktur med en hierarki av anställda: en anställd rapporterar till en chef, chefen till en seniorchef och så vidare. Beroende på det specifika företaget kan det finnas ett vilket antal nivåer som helst i denna hierarki. Men med en ökning av nivåerna blir beräkning av relationer i en relationsdatabas allt svårare. Det är ganska utmanande att representera hierarkin av anställda, hierarkin inom marknadsföring eller relationer i sociala medier. Låt oss se hur SQL Graph kan lösa problemet med att hantera olika nivåer av hierarki.
För detta exempel skapar vi en enkel datamodell. Vi kommer att skapa en tabell för anställda EMP med identifieraren EMPNO och en kolumn MGR, som anger identifieraren för den anställdes chef (manager). All information om hierarkin lagras i denna tabell och kan begäras med hjälp av kolumnerna EMPNO och MGR.
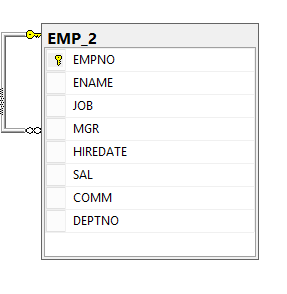
I nästa diagram visas samma modell av organisationsstrukturen med fyra nivåer av inbäddning i ett mer bekant format. Anställda är noder i grafen från tabellen EMP. Entiteten "anställd" är kopplad till sig själv genom relationen "rapporterar till" (ReportsTo). I termer av grafen är relationen en kant (EDGE) som kopplar ihop noder (NODE) av anställda.
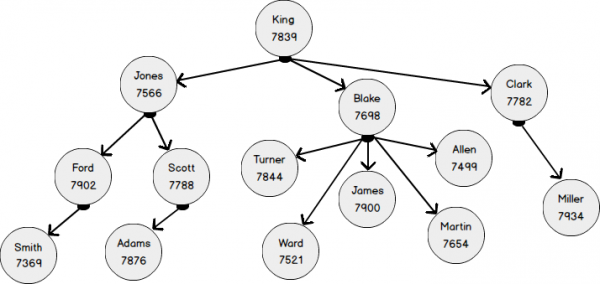
Låt oss skapa en vanlig tabell EMP och lägga till värden i enlighet med ovanstående diagram.
SKAPA TABELL EMP
(EMPNO INT NOT NULL,
ENAME VARCHAR(20),
JOB VARCHAR(10),
MGR INT,
JOINDATE DATETIME,
SALARY DECIMAL(7, 2),
COMMISIION DECIMAL(7, 2),
DNO INT)

INFOGA IN I EMP VÄRDEN
(7369, 'SMITH', 'CLERK', 7902, '02-MAR-1970', 8000, NULL, 2),
(7499, 'ALLEN', 'SALESMAN', 7698, '20-MAR-1971', 1600, 3000, 3),
(7521, 'WARD', 'SALESMAN', 7698, '07-FEB-1983', 1250, 5000, 3),
(7566, 'JONES', 'MANAGER', 7839, '02-JUN-1961', 2975, 50000, 2),
(7654, 'MARTIN', 'SALESMAN', 7698, '28-FEB-1971', 1250, 14000, 3),
(7698, 'BLAKE', 'MANAGER', 7839, '01-JAN-1988', 2850, 12000, 3),
(7782, 'CLARK', 'MANAGER', 7839, '09-APR-1971', 2450, 13000, 1),
(7788, 'SCOTT', 'ANALYST', 7566, '09-DEC-1982', 3000, 1200, 2),
(7839, 'KING', 'PRESIDENT', NULL, '17-JUL-1971', 5000, 1456, 1),
(7844, 'TURNER', 'SALESMAN', 7698, '08-AUG-1971', 1500, 0, 3),
(7876, 'ADAMS', 'CLERK', 7788, '12-MAR-1973', 1100, 0, 2),
(7900, 'JAMES', 'CLERK', 7698, '03-NOV-1971', 950, 0, 3),
(7902, 'FORD', 'ANALYST', 7566, '04-MAR-1961', 3000, 0, 2),
(7934, 'MILLER', 'CLERK', 7782, '21-JAN-1972', 1300, 0, 1)
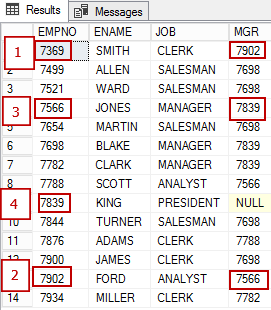
På bild nedan visas anställda:
- den anställde med EMPNO 7369 rapporterar till 7902;
- den anställde med EMPNO 7902 rapporterar till 7566
- den anställde med EMPNO 7566 rapporterar till 7839
Nu ska vi titta på representationen av samma data som en graf. Noden ANSTÄLLD har flera attribut och är kopplad till sig själv genom relationen 'rapporterar till' (EmplReportsTo). EmplReportsTo är namnet på relationen.
I kanttabellen (EDGE) kan det också finnas attribut.
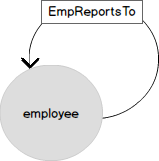
Låt oss skapa nodtabellen EmpNode
Syntaxen för att skapa en nod är ganska enkel: till uttrycket SKAPA TABELL läggs till "AS NODE".
SKAPA TABELL dbo.EmpNode(
ID Int Identity(1,1),
EMPNO NUMERIC(4) NOT NULL,
ENAME VARCHAR(10),
MGR NUMERIC(4),
DNO INT
) SOM NODE;
Nu omvandlar vi data från den vanliga tabellen till en graf. Nästa INSÄTT infogar data från den relationella tabellen EMP.
INFOGA IN I EmpNode(EMPNO,ENAME,MGR,DNO) VÄLJ empno,ename,MGR,dno FRÅN emp 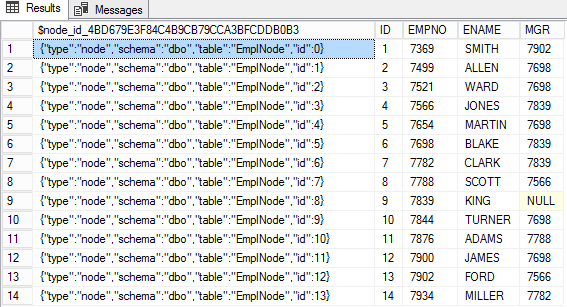
I nodtabellen finns i en särskild kolumn $node_id_* lagras nodens identifierare som JSON. I övriga kolumner i denna tabell finns nodens attribut.
Vi skapar kanter (EDGE)
Att skapa kanttabellen liknar att skapa nodtabellen, med undantag för att nyckelordet "AS EDGE".
SKAPA TABELL empReportsTo(Deptno int) SOM EDGE 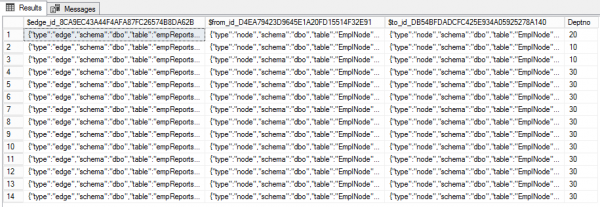
Nu definierar vi relationerna mellan anställda, med hjälp av kolumner EMPNO och MGR. På organisationsdiagrammet kan man tydligt se hur man skriver INSÄTT.
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 1),
   	(SELECT $node_id FROM EmpNode WHERE id = 13),20);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 2),
   	(SELECT $node_id FROM EmpNode WHERE id = 6),10);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 3),
   	(SELECT $node_id FROM EmpNode WHERE id = 6),10)
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 4),
   	(SELECT $node_id FROM EmpNode WHERE id = 9),30);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 5),
   	(SELECT $node_id FROM EmpNode WHERE id = 6),30);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 6),
   	(SELECT $node_id FROM EmpNode WHERE id = 9),30);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 7),
   	(SELECT $node_id FROM EmpNode WHERE id = 9),30);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 8),
   	(SELECT $node_id FROM EmpNode WHERE id = 4),30);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 9),
   	(SELECT $node_id FROM EmpNode WHERE id = 9),30);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 10),
   	(SELECT $node_id FROM EmpNode WHERE id = 6),30);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 11),
   	(SELECT $node_id FROM EmpNode WHERE id = 8),30);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 12),
   	(SELECT $node_id FROM EmpNode WHERE id = 6),30);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 13),
   	(SELECT $node_id FROM EmpNode WHERE id = 4),30);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 14),
   	(SELECT $node_id FROM EmpNode WHERE id = 7),30);
Standardskärmarna för kanterna består av tre kolumner. Den första, $edge_id — är identifieraren för kanten i JSON-format. De två andra ($from_id och $to_id) representerar samband mellan noder. Dessutom kan kanter ha ytterligare egenskaper. I vårt fall är det Deptno.
Systemvyer
I systemvyn sys.tables har två nya kolumner tillkommit:
- is_edge
- is_node
SELECT t.is_edge,t.is_node,*
FROM sys.tables t
WHERE name like 'emp%' 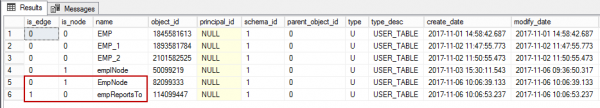
SSMS
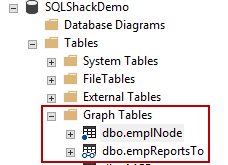
Objekt som rör grafer finns i mappen Graph Tables. Ikonen för nodtabeller är markerad med en punkt, medan kant-tabellerna — med två sammanlänkade cirklar (vilket påminner om glasögon).
MATCH-uttrycket
Uttrycket MATCH är hämtat från CQL (Cypher Query Language). Detta är ett effektivt sätt att fråga om grafens egenskaper. CQL börjar med uttrycket MATCH.
Syntax
MATCH (<graph_search_pattern>)

<graph_search_pattern>::=
    {<node_alias> {
                 	{ <-( <edge_alias> )- }
               	| { -( <edge_alias> )-> }
             	<node_alias>
             	}
 	}
 	[ { AND } { ( <graph_search_pattern> ) } ]
 	[ ,...n ]

<node_alias>::=
    node_table_name | node_alias

<edge_alias>::=
    edge_table_name | edge_alias
Exempel
Låt oss titta på några exempel.
Frågan nedan visar de anställda som rapporterar till Smith och hans chef.
SELECT
E.EMPNO,E.ENAME,E.MGR,E1.EMPNO,E1.ENAME,E1.MGR
FROM
    empnode e, empnode e1, empReportsTo m
WHERE
    MATCH(e-(m)->e1)
and e.ENAME='SMITH' 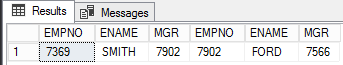
Denna fråga är avsedd för att söka efter anställda och mellanchefer på andra nivåer för Smith. Om vi tar bort meningen DÄR, så kommer alla anställda att visas i resultatet.
SELECT
E.EMPNO,E.ENAME,E.MGR,E1.EMPNO,E1.ENAME,E1.MGR,E2.EMPNO,e2.ENAME,E2.MGR
FROM
    empnode e, empnode e1, empReportsTo m ,empReportsTo m1, empnode e2
WHERE
    MATCH(e-(m)->e1-(m1)->e2)
and e.ENAME='SMITH' 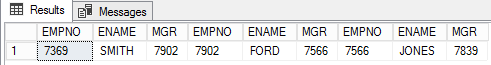
Och slutligen, frågan för anställda och mellanchefer på tredje nivå.
SELECT
E.EMPNO,E.ENAME,E.MGR,E1.EMPNO,E1.ENAME,E1.MGR,E2.EMPNO,e2.ENAME,E2.MGR,E3.EMPNO,e3.ENAME,E3.MGR
FROM
    empnode e, empnode e1, empReportsTo m ,empReportsTo m1, empnode e2, empReportsTo M2, empnode e3
WHERE
    MATCH(e-(m)->e1-(m1)->e2-(m2)->e3)
and e.ENAME='SMITH' 
Nu låt oss ändra riktning för att få Smiths chefer.
SELECT
E.EMPNO,E.ENAME,E.MGR,E1.EMPNO,E1.ENAME,E1.MGR,E2.EMPNO,e2.ENAME,E2.MGR,E3.EMPNO,e3.ENAME,E3.MGR
FROM
    empnode e, empnode e1, empReportsTo m ,empReportsTo m1, empnode e2, empReportsTo M2, empnode e3
WHERE
MATCH(e<-(m)-e1<-(m1)-e2<-(m2)-e3) 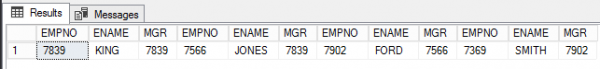
Slutsats
SQL Server 2017 har etablerat sig som en heltäckande företagslösning för olika IT-utmaningar inom företag. Den första versionen av SQL Graph är mycket lovande. Trots vissa begränsningar finns det redan nu tillräcklig funktionalitet för att utforska grafikens möjligheter.
Funktionen SQL Graph är helt integrerad i SQL-motorn. Men som redan nämnts har SQL Server 2017 följande begränsningar:
Ingen stöd för polymorfism.
- Endast ensidiga relationer stöds.
- Kanter kan inte uppdatera kolumnerna $from_id och $to_id via UPDATE.
- Transitiva stängningar (transitive closure) stöds inte, men de kan åstadkommas med hjälp av CTE.
- Begränsat stöd för In-Memory OLTP-objekt.
- System-versionerade temporära tabeller, temporära lokala och globala tabeller stöds inte.
- Tabelltyper och tabellvariabler kan inte deklareras som NODE eller EDGE.
- Frågor mellan databaser (cross-database queries) stöds inte.
- Det finns inget direkt sätt eller någon guide (wizard) för att konvertera vanliga tabeller till grafiska.
- Det finns ingen GUI för att visa grafiker, men Power BI kan användas.
Läs mer:
Källa: habr.com
