

Hej alla. Nedan följer en sammanfattning .
– ett övervakningssystem för olika system och tjänster, som gör det möjligt för systemadministratörer att samla in information om aktuella systemparametrar och ställa in aviseringar för att få meddelanden om avvikelser i systemens prestanda.
Föredraget kommer att innehålla en jämförelse och – projekt för långsiktig lagring av Prometheus-metrik.
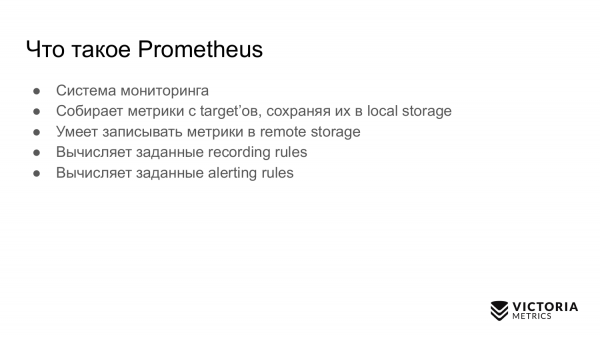
Först kommer jag att berätta om Prometheus. Det är ett övervakningssystem som samlar in metrik från angivna måltavlor och sparar dem i en lokal lagring. Prometheus kan skriva metrik till en fjärrlagring, generera aviseringar och inspelningsregler.
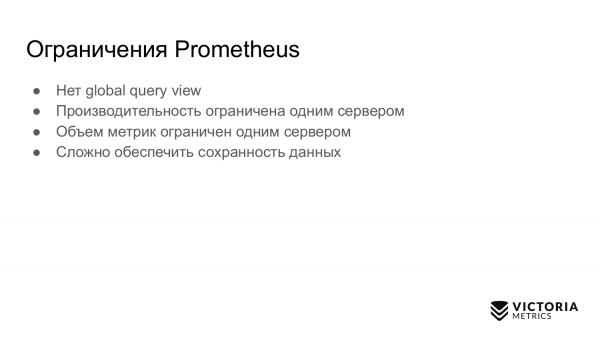
Begränsningar med Prometheus:
- Den har ingen global frågevy. Det är när ni har flera oberoende instanser av Prometheus. De samlar in metrik, och ni vill göra en fråga på alla dessa metrik från olika Prometheus-instanser. Det tillåter inte Prometheus.
- Prestandan hos Prometheus begränsas av en enda server. Prometheus kan inte automatiskt skalas över flera servrar. Ni kan bara manuellt dela upp era måltavlor mellan flera Prometheus-instanser.
- Mängden metrik i Prometheus begränsas också av en enda server av samma anledning som den inte kan skalas över flera servrar.
- Det är inte så enkelt att organisera datalagring i Prometheus.
Lösningar på dessa problem/uppgifter?
Lösningarna är:
Alla dessa lösningar handlar om fjärrlagring av data som samlats in av Prometheus. De löser problemet med fjärrlagring från föregående bild på olika sätt. I denna presentation kommer jag endast att tala om de första två lösningarna: och .
För första gången dök informationen om upp i . Där beskrivs arkitekturen och hur den fungerar.
Thanos tar data som Prometheus har sparat på lokal disk och kopierar dem till S3, eller annan objektlagring.
Således erbjuder Thanos en global frågevy. Ni kan fråga efter data som har sparats i objektlagring från flera instanser av Prometheus.
Thanos stöder PromQL och .
Thanos använder Prometheus kod för datalagring.
Thanos utvecklas av samma utvecklare som Prometheus.
Om . Här är , där vi först berättade om .
VictoriaMetrics får data från flera Prometheus via protokollet som stöds av Prometheus.
VictoriaMetrics erbjuder en global sökvy, eftersom flera Prometheus-instanser kan skriva data till en VictoriaMetrics. Därför kan ni göra förfrågningar på all denna data.

VictoriaMetrics stöder även, precis som Thanos - PromQL och Prometheus fråge-API.
Till skillnad från Thanos är källkoden till VictoriaMetrics skriven från grunden och optimerad för hastighet och resursanvändning.
VictoriaMetrics kan, till skillnad från Thanos, skalas både vertikalt och horisontellt. Det finns , som skalar vertikalt. Du kan börja med en processor och 1 GB minne och växa gradvis till hundra processorer och 1 TB minne. VictoriaMetrics kan använda alla dessa resurser. Dess prestanda kommer att öka med ungefär 100 gånger jämfört med ett system med en kärna.
Historien om Thanos började i november 2017, när den första offentliga committen släpptes. Innan dess utvecklades Thanos internt i företaget .
I juni 2019 släpptes en betydelsefull version 0.5.0, där Det togs bort från Thanos eftersom det inte presterade som förväntat. Ofta fungerade Thanos-klustret felaktigt, noder kopplades inte korrekt på grund av gossip-protokollet. Därför beslöt man att ta bort det. Jag anser att detta var ett rätt beslut.
I juni 2019 skickade de in ansökan nummer på .
Och efter ett par månader blev Thanos accepterad i , som inkluderar Prometheus, Kubernetes och andra populära projekt.
I januari 2018 påbörjades utvecklingen av VictoriaMetrics.
I september 2018 nämnde jag för första gången offentligt VictoriaMetrics.
I december 2018 publicerade vi Enkelnods-versionen.
I maj 2019 källkoden både för Enkelnod och klusterversionen.
I juni 2019, precis som Thanos, skickade vi in en ansökan till CNCF-fonden med nummer . Vi skickade in ansökan en dag tidigare än Thanos.
Men tyvärr har vi fortfarande inte blivit accepterade där. Det behövs stöd från communityn.
Låt oss titta på de viktigaste bilderna som visar arkitekturen för Thanos och VictoriaMetrics.
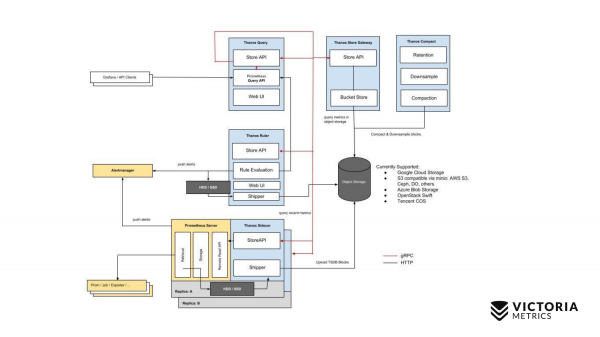
Vi börjar med Thanos. De gula komponenterna är Prometheus-komponenter. Allt annat är Thanos-komponenter. Vi börjar med den mest centrala komponenten. Thanos Sidecar är en komponent som installeras bredvid varje Prometheus. Den ansvarar för att ladda Prometheus-data från lokal lagring till S3 eller annan objektlagring.
Det finns också en komponent som Thanos Store Gateway, som kan läsa dessa data från Object Storage vid inkommande förfrågningar från Thanos Query. Thanos Query implementerar PromQL och Prometheus API. Det betyder att det externt ser ut som Prometheus. Det tar emot PromQL-förfrågningar, skickar dem till Thanos Store Gateway, som hämtar nödvändiga data från Object Storage och skickar dem tillbaka.
Men vi har data i Object Storage som saknar de senaste två timmarna på grund av hur Thanos Sidecar är implementerad, vilket inte kan ladda upp de senaste två timmarna till Object Storage S3, eftersom Prometheus ännu inte har skapat filer i det lokala lagret för dessa två timmar.
Hur löser man detta? Thanos Query skickar, utöver förfrågningar till Thanos Store Gateway, parallella förfrågningar även till varje Thanos Sidecar som ligger nära Prometheus.
Thanos Sidecar, å sin sida, proxyfierar förfrågningarna vidare till Prometheus och hämtar data för de senaste två timmarna.
Förutom dessa komponenter finns det också en valfri komponent som Thanos kommer att ha svårt utan. Det är Thanos Compact, som hanterar sammanslagningen av små filer i Object Storage till större filer som har laddats upp dit av Thanos Sidecars. Thanos Sidecar laddar upp filer med data för två timmar. Om dessa filer inte slås ihop till större filer kan deras antal öka avsevärt. Ju fler sådana filer, desto mer minne krävs för Thanos Store Gateway, desto fler resurser krävs för dataöverföring över nätverket, metadata. Thanos Store Gateways arbete blir ineffektivt. Därför måste Thanos Compact startas för att slå samman små filer till större, så att det finns färre sådana filer och för att minska overheaden på Thanos Store Gateway.
Det finns också en komponent som Thanos Ruler. Den utför Prometheus alerting rules och kan beräkna Prometheus recording rules för att skriva data tillbaka till Object Storage. Men denna komponent rekommenderas inte att använda, eftersom den .
Så här ser den enkla strukturen ut för Thanos.
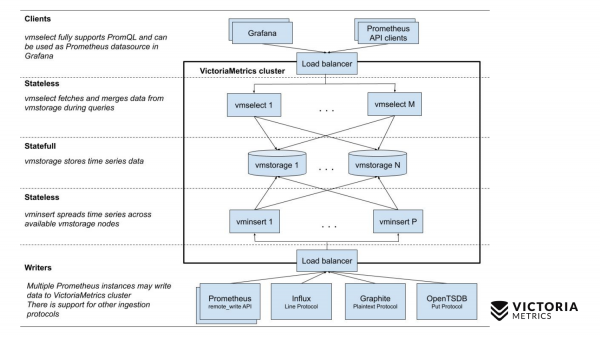
Nu jämför vi med strukturen för VictoriaMetrics.
VictoriaMetrics finns i två versioner: Single-node och kluster. Single-node fungerar på en dator. I Single-node finns dessa komponenter inte, bara en binär fil. Denna binära fil ser ut som den här kvadraten i presentationen. Allt som finns inom kvadraten är innehållet i den binära filen för Single-node-versionen. Du behöver inte känna till den. Du startar bara den binära filen - och allt fungerar.
Den klusterbaserade versionen är mer komplicerad. Inuti den finns tre olika komponenter: vmselect, vminsert och vmstorage. Deras namn bör ge en förståelse för vad varje komponent gör. Insert-komponenten tar emot data i olika format: från Prometheus remote write API, Influx line-protokollet, Graphite-protokollet och från OpenTSDB-protokollet. Insert-komponenten tar emot dem, parserar och distribuerar dem mellan de befintliga lagringskomponenterna, där datan sedan sparas. , samt Prometheus fråge-API, och den kan användas som en ersättning för Prometheus i Grafana eller andra Prometheus API-klienter. Select tar emot promql-frågor, parserar dem, läser nödvändig data för att utföra denna fråga från lagringsnoder, processar dessa data och returnerar ett svar.
Låt oss jämföra installationskomplexiteten för Thanos och VictoriaMetrics.
Vi börjar med Thanos. Innan du börjar arbeta med Thanos måste du skapa en bucket i Object Storage, som S3 eller GCS, så att Thanos Sidecar kan skriva data dit.
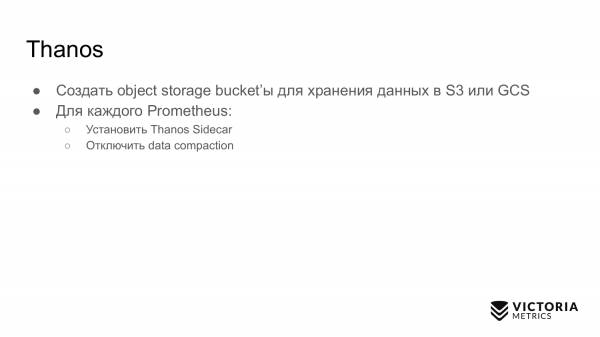
Sedan måste du installera Thanos Sidecar för varje Prometheus. Kom ihåg att stänga av datakomprimering (data compaction) i Prometheus innan du gör detta. Datakomprimering komprimerar periodiskt data i den lokala lagringen i Prometheus för att minska resursanvändningen.
När du installerar Thanos Sidecar till dina Prometheus:er måste du stänga av denna datakomprimering, eftersom Thanos Sidecar inte fungerar ordentligt med aktiverad datakomprimering. Det innebär att din Prometheus börjar spara data i block om två timmar och slutar slå samman dessa block i större. Därför, om du gör förfrågningar som överskrider varaktigheten för de senaste två timmarna, kommer de att vara mindre effektiva jämfört med hur de skulle kunna vara om datakomprimering var aktiverad.
Därför rekommenderar Thanos att minska datalagringstiden (data retention) i den lokala lagringen till 6-8 timmar för att minska överbelastningen från ett stort antal små block.
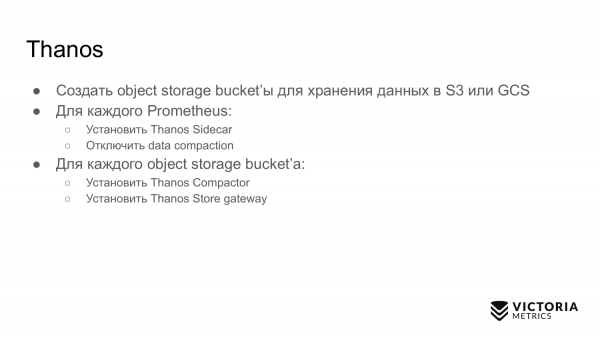
När du har installerat Thanos Sidecar måste du installera två komponenter för varje Object Storage Bucket. Det handlar om Thanos Compactor och Thanos Store Gateway.
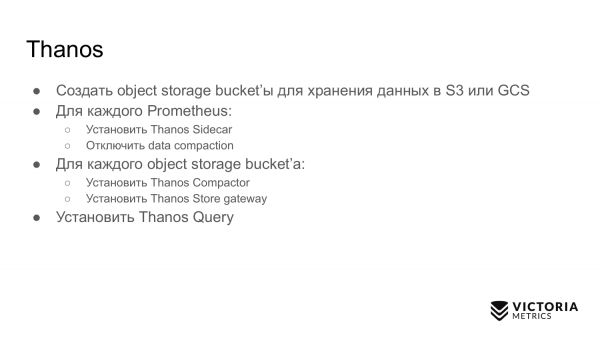
Därefter behöver du installera Thanos Query och konfigurera det så att det kan ansluta till alla Thanos Store Gateways du har, samt kunna ansluta till alla Thanos Sidecars.
Här kan det uppstå ett litet problem.
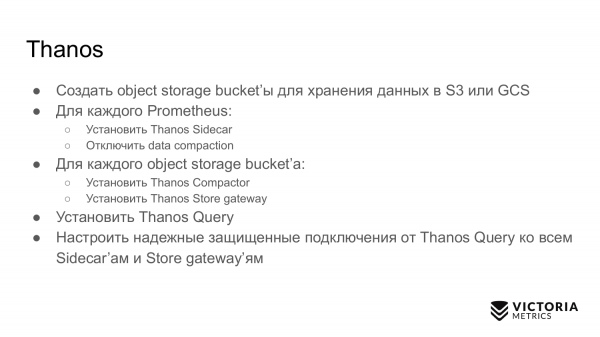
Du behöver konfigurera en pålitlig och säker anslutning från Thanos Query till dessa komponenter. Om dina Prometheus-instansor befinner sig i olika datacenter eller i olika VPC:er, så är externa anslutningar förbjudna. Men för att Thanos Query ska fungera måste du på något sätt konfigurera en anslutning dit, och du måste hitta en lösning.
Om du har många sådana datacenter minskar systemets tillförlitlighet. Eftersom Thanos Query ständigt måste hålla anslutningar till alla Thanos Sidecar som ligger i olika datacenter. Vid varje inkommande förfrågan kommer den att skicka förfrågningar till alla Thanos Sidecar. Om anslutningen bryts kommer du att få antingen en ofullständig uppsättning data eller svaret "klustret fungerar inte".
I VictoriaMetrics är allt lite enklare. För single-node-versionen räcker det med att köra en binärfil, så fungerar allt.
För den klusterbaserade versionen behöver du bara köra alla de tre ovan nämnda typerna av komponenter i valfritt antal, eller använda för att automatisera start av komponenter i Kubernetes. Vi planerar också att skapa en Kubernetes-operator. Helm-diagrammet täcker inte vissa användningsfall och kan leda till problem. Till exempel tillåter det att minska antalet storage-noder, vilket kan leda till dataförlust.
När du har startat en binärfil eller kluster-versionen räcker det med att lägga till i Prometheus-konfigurationen , så att den börjar skriva data parallellt till den lokala lagringen och till den externa lagringen. Som du har märkt bör denna konfiguration fungera mycket mer pålitligt jämfört med Thanos-konfigurationen. Vi behöver inte hålla anslutningen från VictoriaMetrics till alla Prometheus-instansor, eftersom Prometheus-instansorna själva ansluter till VictoriaMetrics och överför data.
Låt oss överväga hantering av Thanos och VictoriaMetrics.
Thanos måste övervaka Sidecar så att de inte slutar överföra data till Object Storage. De kan sluta denna dataöverföring på grund av uppladdningsfel, till exempel om din nätverksanslutning till Object Storage tillfälligt avbryts, eller om Object Storage tillfälligt blir otillgängligt. Thanos Sidecar kommer märka detta, rapportera ett fel, kan krascha och därefter sluta fungera. Om du inte övervakar det kommer dataöverföringen till Object Storage att upphöra. Om retention-tiden passerar (6-8 timmar rekommenderas), kommer du att förlora data som inte har nått Object Storage.
Thanos kompaktorer kan sluta fungera på grund av . Kompaktorer tar data från Object Storage och slår ihop dem till större datastycken. Eftersom kompaktorer inte är synkroniserade med Sidecar kan följande hända: Sidecar har inte hunnit skriva klart blocket, Kompaktorn beslutar att detta block är helt skrivet. Kompaktorn börjar läsa det. Den läser blocket inte i sin helhet och slutar fungera. Se detaljer. .
Store Gateway kan ge inkonsekventa data på grund av kapplöpningar mellan Kompaktorn och Sidecar. Det här är en liknande situation, eftersom Store Gateway inte är synkroniserad med Kompaktorer och Sidecar. Följaktligen kan det uppstå kapplöpningar där Store Gateway inte ser en del av datan, eller ser överskottsdata.
Query-komponenten i Thanos ger som standard ett delresultat om vissa Sidecar eller Store Gateway för närvarande inte är tillgängliga. Du kommer att få del av datan och du kommer inte ens att veta att du inte fick all data. Det fungerar så här som standard. I en liknande situation returnerar VictoriaMetrics märkta data som partiella.
Till skillnad från Thanos förlorar VictoriaMetrics sällan data. Även om anslutningen från Prometheus till VictoriaMetrics bryts är det inget problem, eftersom Prometheus fortsätter att skriva inkommande nya data i Write Ahead Log, vars storlek är 2 timmar. Om du återställer anslutningen till VictoriaMetrics inom två timmar så kommer datan inte att gå förlorad. Prometheus .
Till skillnad från Thanos, som skriver data till objektlagring först efter två timmar, replikeras data automatiskt av Prometheus via remote write-protokollet till remote-lagring, som VictoriaMetrics. Du behöver inte oroa dig för att förlora lokal lagring i Prometheus. Om den skulle förlora lokal lagring, förlorar du i värsta fall de senaste sekunderna av data som ännu inte har skrivits till remote-lagring.
Kubernetes hanterar automatiskt klustret till skillnad från Thanos. Alla komponenter i Thanos är svåra att få plats i ett enda Kubernetes-kluster, till skillnad från klusterkomponenterna i VictoriaMetrics.
Uppdatering till en ny version i VictoriaMetrics är mycket enkel. Du stoppar bara VictoriaMetrics, uppdaterar binärerna och startar den igen. När den stoppas med SIGINT-signal utför alla binärer av VictoriaMetrics en smidig avstängning. De sparar korrekt de nödvändiga uppgifterna och stänger rätt ned inkommande anslutningar för att inte förlora något. Därför förlorar du ingenting vid uppdatering.
Det är mycket enkelt att skala klustret med VictoriaMetrics. Du lägger bara till de nödvändiga komponenterna och fortsätter arbeta.
Om komplikationer med Thanos och VictoriaMetrics.
Thanos har följande komplikationer. Prometheus måste lagra data från de senaste två timmarna. Om de förloras, förlorar du dem helt, eftersom de inte har skrivits till objektlagring, som S3.
Store Gateway-komponenten och compactor-komponenten kan kräva mycket minne för att hantera stora objektlagringar, om det finns många små filer där. Ju fler filer och ju större filerna är, desto mer RAM krävs av Store Gateway och compactor för att lagra metadata. Thanos har många problem när det gäller att .
Thanos marknadsförs som att den kan skalas oändligt med antalet Prometheus. I själva verket är detta inte sant. Eftersom alla förfrågningar går genom Query-komponenten, som måste samtidigt fråga alla Store Gateway-komponenter och alla Sidecar-komponenter, hämta data därifrån och sedan förbearbeta dessa. Det är uppenbart att hastigheten på förfrågningarna begränsas av den långsammaste svaga länken, den långsammaste Store Gateway eller den långsammaste Sidecar.
Dessa komponenter kan vara ojämnt belastade. Till exempel, om du har Prometheus som samlar miljontals mätvärden per sekund. Och det finns en Prometheus som samlar tusentals mätvärden per sekund. Prometheus som samlar miljontals mätvärden per sekund belastar servern där den körs betydligt mer. Följaktligen kommer Sidecar att arbeta långsammare där. Överlag kommer allt att fungera långsammare där. Query-komponenten kommer att hämta data därifrån mycket långsamt. Därför kommer prestandan för hela din kluster att begränsas av den långsamma Sidecar.
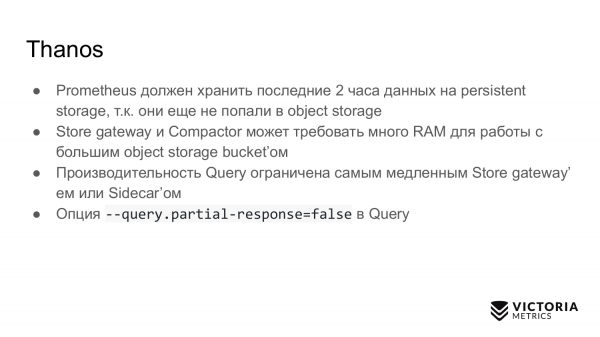
Som standard levererar Thanos partiella data om vissa Sidecar:er eller Store Gateway är otillgängliga. Om du har Sidecar:er utspridda över hela världen i olika datacenter ökar risken för avbrott i anslutningen och otillgänglighet för komponenterna kraftigt. Därför kommer du i de flesta fall att få partiella data utan att ens veta om det.
VictoriaMetrics har också sina fallgropar. Den första fallgropen är en inställning som begränsar mängden RAM-minne som används för cache i VictoriaMetrics. Som standard gäller det 60% av RAM-minnet på den maskin där VictoriaMetrics körs, eller 60% av podens RAM-minne för VictoriaMetrics i Kubernetes.
Om detta värde ändras felaktigt kan det förstöra prestandan för VictoriaMetrics. Till exempel, om du ställer in ett för lågt värde kan data sluta rymmas i cachen för VictoriaMetrics. Det kan leda till att den måste göra onödigt arbete och belasta CPU:n och disken. Om du gör denna inställning för hög ökar risken för att VictoriaMetrics kraschar med out of memory-fel och det kommer samtidigt att bli kvar mycket lite RAM-minne i operativsystemet för filcachen. VictoriaMetrics är beroende av filcachen för prestanda. Om det inte finns tillräckligt kan belastningen på disken öka avsevärt. Därför är rådet: ändra inte detta parameter utan yttersta nödvändighet.
Den andra inställningen är retentionPeriod – en period som som standard är inställd på 1 månad. Detta är den tid under vilken VictoriaMetrics lagrar data. Efter denna tid raderar VictoriaMetrics data.
Många kör VictoriaMetrics utan denna parameter och samlar data under en månad. Sedan undrar de: varför försvann data för den föregående månaden? För att retentionPeriod som standard är 1 månad. Därför behövs kunskap om och inställning av rätt retentionPeriod.
Låt oss gå igenom de unika funktionerna.
Thanos har en funktion som kallas downsampling: 5-minuters och timintervall, som ofta . Om du googlar och tittar på deras ärenden på GitHub, finns det många ärenden kopplade till denna downsampling, där den ibland fungerar felaktigt eller inte som användarna förväntar sig.
Thanos har deduplicering av data för Prometheus HA-par. När två Prometheus samlar in samma mätvärden från samma mål, och Thanos lägger dem i objektlagring. Thanos kan korrekt deduplicera dessa data, till skillnad från VictoriaMetrics.
Thanos har en alert-komponent, som syntes i Thanos-diagrammet. Men den .
Thanos har den fördelen att koden för Thanos och Prometheus är gemensam. Thanos och Prometheus har utvecklats av samma utvecklare. Vid förbättringar av Thanos eller Prometheus drar den andra sidan nytta.
VictoriaMetrics huvudfunktion är MetricsQL. Detta är en utvidgning av VictoriaMetrics för PromQL, som jag berättade om på den senaste stora övervakningskonferensen.
VictoriaMetrics stöder inmatning av data via många olika protokoll. VictoriaMetrics kan inte bara ta emot data från Prometheus, utan också via protokollen Influx, OpenTSDB och Graphite.
Data i VictoriaMetrics tar vanligtvis mycket mindre plats jämfört med Thanos och Prometheus.
Om verkliga data skrivs, rapporterar användarna en minskning av datastorleken på disken med 2-5 gånger jämfört med Prometheus och Thanos.
Ytterligare en fördel med VictoriaMetrics är att den är optimerad för hastighet.
Låt oss titta på kostnaden för infrastrukturen.
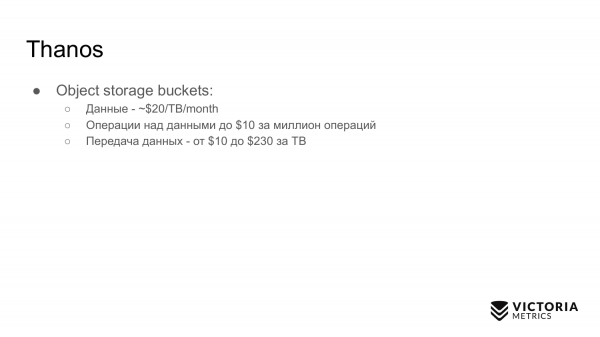
En av fördelarna med Thanos är att den sparar data i objektlagring, vilket är relativt billigt.
Vid lagring av data i objektlagring måste du betala för skriv- och läsoperationer ($10 per miljon operationer). När du skriver data i objektlagring betalar du för dina hostingkostnader för att överföra data till internet, om din kluster inte är i AWS – där är det gratis. När du läser data betalar du mellan $10 och $230 per 1 TB. Detta kan bli betydande om du ofta begär historiska data från Thanos-klustret.
För ett Thanos-kluster behöver servrar för Compact, Store Gateway och Query-komponenter betalas, som kräver mycket minne och CPU för stora datamängder.
För VictoriaMetrics ser kostnaderna ut så här. Om data lagras på GCE HDD-diskar så blir det $40 per 1TB. För VictoriaMetrics är vanliga HDD-diskar tillräckliga, inga SSD:er behövs, vilket kostar fem gånger så mycket. VictoriaMetrics är optimerad för HDD.
För VictoriaMetrics behövs servrar för komponenterna: antingen Single-node eller för klusterkomponenter, som i motsats till Thanos-komponenter kräver mycket mindre CPU och RAM, vilket gör det billigare.
Exempel på implementeringar.
Ett exempel på implementering av Thanos är GitLab. GitLab fungerar fullt ut med Thanos. Men allt är inte så enkelt. Om man tittar på deras , kan man se att de ständigt har vissa : det saknas minne för Store Gateway eller Query-komponenter. De tvingas hela tiden öka minneskapaciteten.
Därför ökar kostnaderna för att lösa dessa problem.
En andra implementering, som kan vara mer framgångsrik, är företaget Improbable, som började utvecklingen av Thanos. De publicerade källkoden för Thanos. Improbable är ett företag som arbetar med utveckling av spelmotorer.
Publicerade exempel på VictoriaMetrics-implementeringar inkluderar:
- wix.com webbplatsbyggare
- Adidas implementerar VictoriaMetrics och presenterade till och med ett föredrag på senaste PromCon 2019
- TrafficStars – annonstjänst
- Seznam.cz – en populär tjeckisk sökmotor.
Och vidare finns det namnlösa företag som jag inte kan nämna just nu. De gav ingen tillåtelse.
- En stor spelutvecklare. Större än de inom Improbable.
- En stor utvecklare av grafikprogramvara.
- En stor rysk bank.
- En europeisk tillverkare av vindkraftverk som framgångsrikt har testat VictoriaMetrics. Denna tillverkare implementerar VictoriaMetrics för att övervaka data från vindkraftverk med en hastighet av 50 samplingar per sekund för varje sensor. I varje vindkraftverk finns det flera hundra sensorer. De har flera hundra vindkraftverk.
- Ryska flygbolag som vill implementera VictoriaMetrics, men som fortfarande inte kan. Vi är i avtalsstadiet med dem.
 Slutsatser.
VictoriaMetrics och Thanos löser liknande problem, men på olika sätt:
- Global fråga vy
- horisontell skalning
- valfri retention
Tack.
Vi väntar på er på vår .
Endast registrerade användare kan delta i omröstningen. , tack.
Vad använder ni som långsiktig lagring för Prometheus?
35,3%Thanos6
0,0%Cortex0
0,0%M3DB0
41,2%VictoriaMetrics7
23,5%annat4
17 användare röstade. 16 användare avstod.
Källa: habr.com
