

Zabbix är ett övervakningssystem. Precis som alla andra system står det inför tre grundläggande problem som alla övervakningssystem möter: insamling och bearbetning av data, lagring av historik och dess rengöring.
Stegen för att erhålla, bearbeta och registrera data tar tid. Lite, men för ett större system kan det leda till betydande fördröjningar. Lagringsproblemet är en fråga om datatillgång. De används för rapportering, kontroller och triggers. Fördröjningar i datatillgång påverkar också prestandan. När databaser växer måste föråldrad data raderas. Radering är en resurskrävande operation som också påverkar resurstillgången.
Problemen med fördröjningar vid insamling och lagring i Zabbix löses med caching: flera typer av cache och caching i databasen. För att lösa det tredje problemet är caching inte tillräckligt, därför har Zabbix implementerat TimescaleDB. Mer om detta kommer att berättas av Andrej Gushchin — teknisk supportingenjör . Andrej har arbetat med Zabbix-support i över 6 år och har direkt erfarenhet av prestanda.
Hur fungerar TimescaleDB, vilken prestanda kan det ge jämfört med vanligt PostgreSQL? Vilken roll spelar Zabbix för TimescaleDB? Hur börjar man från noll och hur migrerar man från PostgreSQL och vilken konfiguration ger bäst prestanda? Allt detta kommer vi att diskutera.

Prestandautmaningar
Varje övervakningssystem ställs inför specifika prestandautmaningar. Jag kommer att berätta om tre av dem: insamling och bearbetning av data, lagring och rensning av historik.
Snabb insamling och bearbetning av data. Ett bra övervakningssystem måste snabbt samla in all data och bearbeta den enligt triggeruttryck — efter sina egna kriterier. Efter bearbetning måste systemet också snabbt spara dessa data i databasen för senare användning.
Lagring av historik. Ett bra övervakningssystem måste lagra historik i databasen och ge enkel åtkomst till mätdata. Historik är nödvändig för att användas i rapporter, diagram, triggers, tröskelvärden och beräknade datatyper för notifieringar.
Rensning av historik. Ibland kommer en dag då du inte behöver lagra metrik. Varför skulle du vilja ha data som samlades in för 5 år sedan, för en månad eller två: vissa noder har tagits bort, vissa värdar eller metrik är inte längre nödvändiga eftersom de har blivit föråldrade och inte samlas in längre. Ett bra övervakningssystem bör lagra historiska data och regelbundet ta bort dem för att förhindra att databasen växer sig för stor.
Rensning av föråldrad data är en akut fråga som påverkar databasens prestanda kraftigt.
Caching i Zabbix
I Zabbix hanteras första och andra anrop genom caching. För insamling och bearbetning av data används RAM. För lagring – historik i triggerar, diagram och beräknade datakoder. På databasens sida finns det viss caching för huvudfrågor, till exempel diagram.
Caching på själva Zabbix-servern är:
- ConfigurationCache;
- ValueCache;
- HistoryCache;
- TrendsCache.
Låt oss titta närmare på dem.
ConfigurationCache
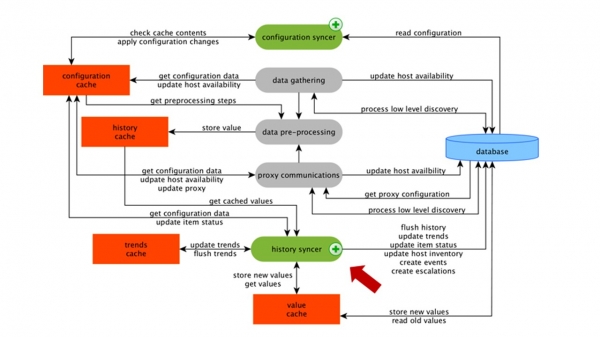
Detta är den huvudsakliga cachen där vi lagrar metrik, värdar, datakoder, triggerar – allt som behövs för PreProcessing och datainsamling.
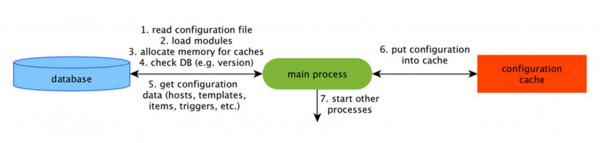
Allt detta lagras i ConfigurationCache för att undvika extra frågor till databasen. Efter serverstart uppdaterar vi denna cache och skapar och uppdaterar konfigurationer regelbundet.
Datainsamling
Schemat är ganska stort, men det viktigaste är insamlarna. Det är olika "pollers" – insamlingsprocesser. De ansvarar för olika typer av insamling: de hämtar data via SNMP, IPMI och överför allt detta till PreProcessing.
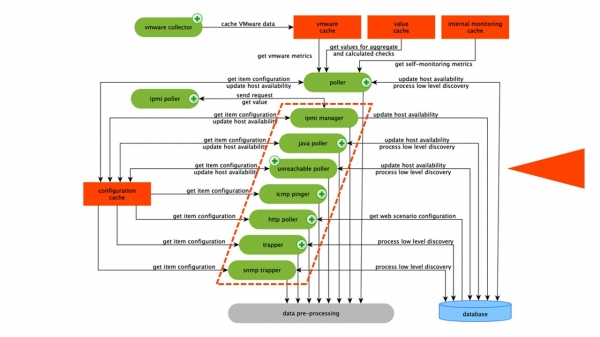 Insamlarna är markerade med en orange linje.
I Zabbix finns det beräknade aggregationsdatakoder som behövs för att aggregera kontrollerna. Om vi har dem hämtar vi data för dem direkt från ValueCache.
PreProcessing HistoryCache
Alla insamlare använder ConfigurationCache för att få uppgifter. Sedan överför de dem till PreProcessing.
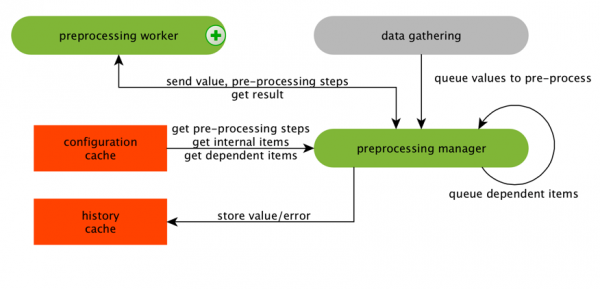
PreProcessing använder ConfigurationCache för att hämta stegen i PreProcessing. Den bearbetar dessa data på olika sätt.
Efter att ha bearbetat data med hjälp av PreProcessing sparar vi dem i HistoryCache för att bearbeta dem. Här slutar datainsamlingen och vi går vidare till huvudprocessen i Zabbix – history syncer, eftersom det är en monolitisk arkitektur.
Obs: PreProcessing är en ganska resurskrävande operation. Från version 4.2 har den flyttats till proxy. Om du har ett mycket stort Zabbix med många datakoder och hög insamlingsfrekvens underlättar detta kraftigt arbetsbördan.
ValueCache, historik och trender cache
Historiksynkroniseraren är den huvudsakliga processen som atomärt bearbetar varje dataval, det vill säga varje värde.
Historiksynkroniseraren tar värden från HistoryCache och kontrollerar i Configuration om det finns triggers för beräkningar. Om de finns - beräknar den.
Historiksynkroniseraren skapar en händelse, en eskalering, för att skapa meddelanden om det behövs enligt konfigurationen, och registrerar. Om det finns triggers för efterföljande bearbetning, sparar den detta värde i ValueCache för att inte behöva hänvisa till historiktabellen. Så fylls ValueCache med data som behövs för beräkning av triggers, beräknade element.
Historiksynkroniseraren registrerar all data i databasen, och den - på disken. Bearbetningsprocessen slutar här.
Caching i databasen
På databassidan finns det olika cachar när du vill titta på diagram eller rapporter om händelser:
Innodb_buffer_poolpå MySQL-sidan;shared_bufferspå PostgreSQL-sidan;effective_cache_sizepå Oracle-sidan;shared_poolpå DB2-sidan.
Det finns många andra cacher, men detta är de huvudsakliga för alla databaser. De gör det möjligt att hålla data i RAM som ofta behövs för förfrågningar. De har sina egna teknologier för detta.
Databasens prestanda är kritiskt viktig
Zabbix-servern samlar ständigt in data och registrerar dem. Vid omstart läser den också från historiken för att fylla ValueCache. Skripten och rapporterna använder Zabbix API, som bygger på webgränssnittet. Zabbix API gör förfrågningar mot databasen och får nödvändig data för diagram, rapporter, händelselistor och senaste problemen.
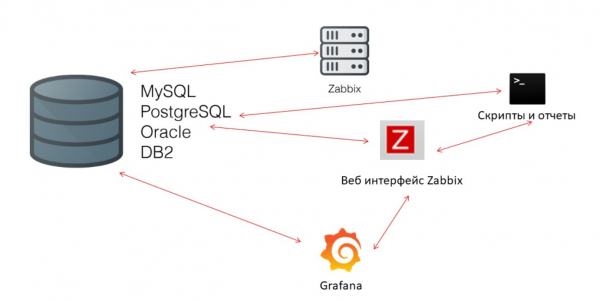
För visualisering - Grafana. Bland våra användare är det en populär lösning. Den kan skicka förfrågningar direkt genom Zabbix API både till databasen och skapar en viss konkurrens för att hämta data. Därför behövs en mer finjusterad och bra konfiguration av databasen för att motsvara snabb resultatåtergivning och testning.
Housekeeper
Det tredje prestandautmaningen i Zabbix är rensning av historik med Housekeeper. Den följer alla inställningar - i datatelemen anges hur länge dynamikförändringar (trender) ska bevaras i dagar.
TrendsCache beräknar vi i realtid. När data kommer in aggregerar vi dem under en timme och registrerar dem i tabeller för dynamikförändringar av trender.
Housekeeper startar och tar bort information från databasen med vanliga "selects". Detta är inte alltid effektivt, vilket kan förstås från prestandadiagram för interna processer.
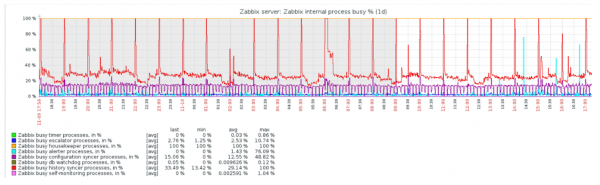
Det röda diagrammet visar att History syncer konstant är upptagen. Det orange diagrammet ovan är Housekeeper, som ständigt startar. Den väntar på att databasen ska ta bort alla rader som den har begärt.
När bör man stänga av Housekeeper? Till exempel, om det finns "Item ID" och man behöver ta bort de senaste 5 000 raderna under en viss tid. Självklart sker detta via index. Men vanligtvis är datasetet väldigt stort, och databasen läser fortfarande från disken och laddar upp i cachen. Detta är alltid en mycket kostsam operation för databasen och kan, beroende på storleken av databasen, leda till prestandaproblem.
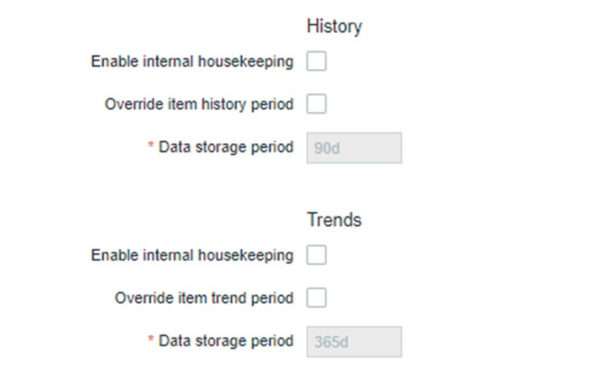
Housekeeper kan enkelt stängas av. I webbgränssnittet finns en inställning under "Administration general" för Housekeeper. Vi stänger av intern Housekeeping för intern trendhistorik, och den hanterar inte längre detta.
Housekeeper har stängts av, och diagrammen har jämnat ut sig. Vilka problem kan uppstå i detta fall, och vad kan hjälpa till att lösa den tredje prestandautmaningen?
Partitioning — partitionering eller sektionering
Oftast konfigureras partitionering på olika sätt i varje relationsdatabas, som jag har nämnt. Varje har sin egen teknik, men de är liknande i stort. Skapandet av en ny partition leder ofta till vissa problem.
Oftast anpassas partitioner beroende på "setup" — mängden data som skapas under en dag. Vanligtvis sätts Partitioning för en dag, detta är minimi. För trender sätts en ny partition för en månad.
Värden kan ändras i fall av ett mycket stort "setup". Om ett litet "setup" är upp till 5 000 nvps (nya värden per sekund), medel är mellan 5 000 och 25 000, medan stort är över 25 000 nvps. Detta är stora och mycket stora installationer som kräver noggrann databasjustering.
Vid mycket stora installationer kan ett intervall på en dag vara suboptimalt. Jag har sett MySQL-partitioner på 40 GB eller mer per dag. Detta är en mycket stor mängd data som kan leda till problem, och det bör minskas.
Vad ger Partitioning?
Sektionering av tabeller. Ofta är detta separata filer på disken. Frågeplanen väljer mer optimalt en partition. Vanligtvis används partitionering efter intervall - detta gäller även för Zabbix. Vi använder där "timestamp" - tiden sedan epoch. Hos oss är detta vanliga siffror. Du anger början och slutet av dagen - detta är en partition.
Snabb borttagning — TA BORT. En fil/subtabell väljs, inte en radval för borttagning.
Ger avsevärt snabbare dataval VÄLJ — använder en eller flera partitioner, inte hela tabellen. Om du begär data från två dagar sedan hämtas de snabbare från databasen, eftersom det bara behöver laddas i cachen och endast ett fil, inte en stor tabell, behöver fås fram.
Ofta påskyndar detta många databaser också INSÄTT — insättningar i barn-tabellen.
TimescaleDB
För v 4.2 har vi noterat TimescaleDB. Det är ett tillägg för PostgreSQL med ett inbyggt gränssnitt. Tillägget fungerar effektivt med tidsseriedata utan att förlora fördelarna med relationsdatabaser. TimescaleDB partitionerar också automatiskt.
I TimescaleDB finns det en begrepp hypertabell (hypertable) som du skapar. Den innehåller chunkar — partitioner. Chunkar är automatiskt hanterade delar av hypertabellen, som inte påverkar andra delar. För varje chunk finns en egen tidsintervall.
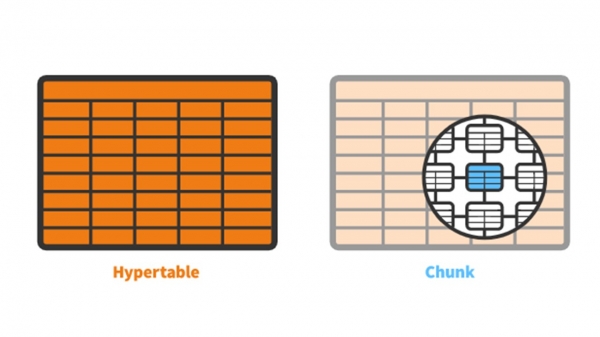
TimescaleDB vs PostgreSQL
TimescaleDB fungerar verkligen effektivt. Tillverkarna av tillägget hävdar att de använder en mer korrekt algoritm för att behandla förfrågningar, särskilt <code>insättningar</code>. När storleken på datasetinsättningarna växer, upprätthåller algoritmen konstant prestanda.
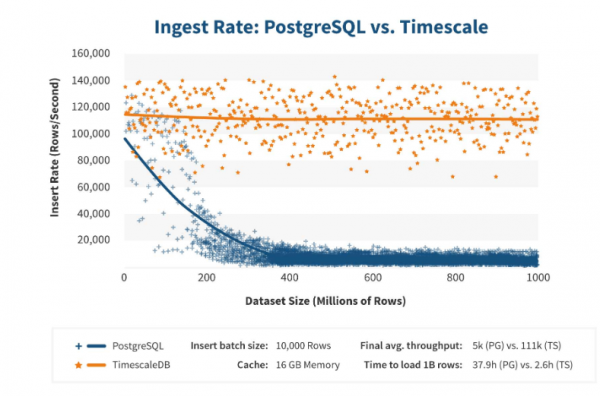
Efter 200 miljoner rader börjar PostgreSQL vanligtvis att tappa prestanda kraftigt och tappar sin effektivitet till 0. TimescaleDB möjliggör effektiv insättning av "insättningar" oavsett datavolym.
Installation
Att installera TimescaleDB är ganska enkelt för alla paket. I är allt utförligt beskrivet - det beror på de officiella PostgreSQL-paketen. TimescaleDB kan också byggas och kompileras manuellt.
För Zabbix-databaser aktiverar vi helt enkelt tillägget:
echo "CREATE EXTENSION IF NOT EXISTS timescaledb CASCADE;" | sudo -u postgres psql zabbix Du aktiverar tillägget och skapar det för Zabbix-databasen. Slutsteget är att skapa hypertabellen.
Migration av historiska tabeller till TimescaleDB
Det finns en speciell funktion för detta create_hypertable:
VÄLJ skapa_hypertable(‘history’, ‘clock’, chunk_time_interval => 86400, migrate_data => true);
VÄLJ skapa_hypertable(‘history_unit’, ‘clock’, chunk_time_interval => 86400, migrate_data => true);
VÄLJ skapa_hypertable(‘history_log’, ‘clock’, chunk_time_interval => 86400, migrate_data => true);
VÄLJ skapa_hypertable(‘history_text’, ‘clock’, chunk_time_interval => 86400, migrate_data => true);
VÄLJ skapa_hypertable(‘history_str’, ‘clock’, chunk_time_interval => 86400, migrate_data => true);
VÄLJ skapa_hypertable(‘trends’, ‘clock’, chunk_time_interval => 86400, migrate_data => true);
VÄLJ skapa_hypertable(‘trends_unit’, ‘clock’, chunk_time_interval => 86400, migrate_data => true);
UPPDATERA config SET db_extension=’timescaledb’, hk_history_global=1, hk_trends_global=1
Funktionen har tre parametrar. Den första är tabellen i databasen, för vilken en hypertabell ska skapas. Den andra är fältet, efter vilket man måste skapa chunk_time_interval — intervall för partitionernas chunk, som ska användas. I mitt fall är intervallet en dag — 86 400.
Den tredje parametern är migrera_data. Om man sätter true, flyttas alla nuvarande data till de förhands skapade chunkarna. Jag använde det. migrera_dataJag hade ungefär 1 TB, vilket tog över en timme. Även i vissa fall under testning raderade jag onödiga historiska data av typ sträng för att inte flytta dem.
Det sista steget är UPPDATERA: i db_extension sätter vi timescaledb, så att databasen förstår att detta tillägg finns. Zabbix aktiverar det och använder korrekt syntax och frågor mot databasen — de funktioner som behövs för TimescaleDB.
Hårdvarukonfiguration
Jag använde två servrar. Den första är VMware-maskin. Den är ganska liten: 20 processorer Intel® Xeon® CPU E5-2630 v 4 @ 2.20GHz, 16 GB RAM och en SSD-disk på 200 GB.
Jag installerade PostgreSQL 10.8 med Debian 10.8-1.pgdg90+1 och filsystemet xfs. Jag gjorde minimi-inställningar för att använda just denna databas, förutom att Zabbix kommer att använda den.
På denna maskin fanns Zabbix-servern, PostgreSQL och lastningsagenter. Jag hade 50 aktiva agenter som använde LoadableModule, för att mycket snabbt generera olika resultat: siffror, strängar. Jag fyllde databasen med stora mängder data.
Initialt innehöll konfigurationen 5 000 datanoder per värd. Nästan varje nod innehöll en trigger för att likna verkliga installationer. I vissa fall fanns det mer än en trigger. På en nod i nätverket fanns det 3 000-7 000 triggers.
Uppdateringsintervallet för datanoder är 4-7 sekunderJag justerade lasten genom att använda inte bara 50 agenter, utan jag lade också till fler. Dessutom justerade jag lasten dynamiskt med hjälp av dataelement och sänkte uppdateringsintervallet till 4 s.
PostgreSQL. 35 000 nvps
Mitt första körning på denna hårdvara var på ren PostgreSQL — 35 000 värden per sekund. Som man kan se, tar insättning av data bråkdelen av en sekund — allt fungerar bra och snabbt. Det enda är att SSD-disken på 200 GB snabbt fylls.
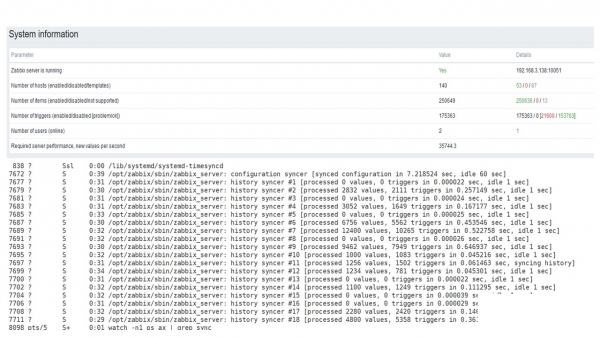
Detta är den standardiserade prestationsöversikten för Zabbix — servrar.
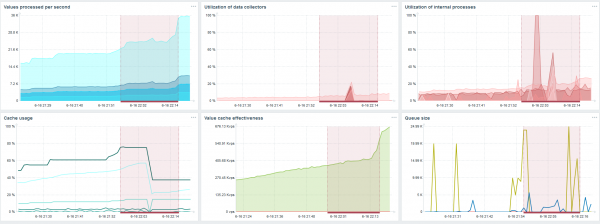
Den första blå grafen visar antalet värden per sekund. Den andra grafen till höger visar belastningen av byggprocesserna. Den tredje — belastningen av interna byggprocesser: history syncers och Housekeeper, som här kördes under en tillräcklig tid.
Den fjärde grafen visar användningen av HistoryCache. Detta är en typ av buffert före insättning i databasen. Den gröna femte grafen visar användningen av ValueCache, det vill säga hur många träffar ValueCache får för triggarna — detta är flera tusen värden per sekund.
PostgreSQL. 50 000 nvps
Därefter ökade jag lasten till 50 000 värden per sekund på samma hårdvara.
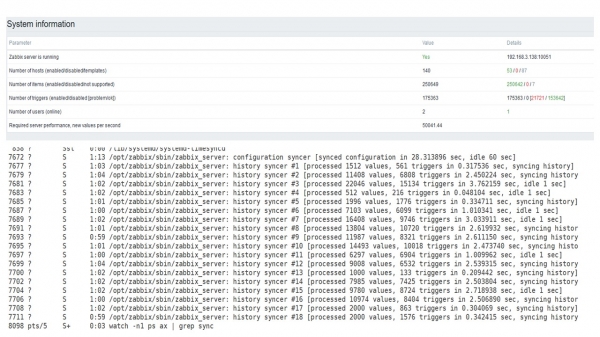
Vid belastning med Housekeeper registrerades 10 000 värden på 2-3 s.
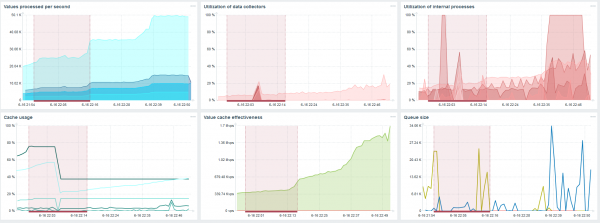
Housekeeper börjar redan påverka arbetet.
Från den tredje grafen kan man se att, övergripande, belastningen av trapper och history syncers fortfarande ligger på 60%. På den fjärde grafen börjar HistoryCache under Housekeepers arbete fyllas tillräckligt aktivt. Det har fyllts till 20% — det är omkring 0,5 GB.
PostgreSQL. 80 000 nvps
Därefter ökade jag lasten till 80 000 värden per sekund. Det är ungefär 400 000 dataelement och 280 000 triggar.
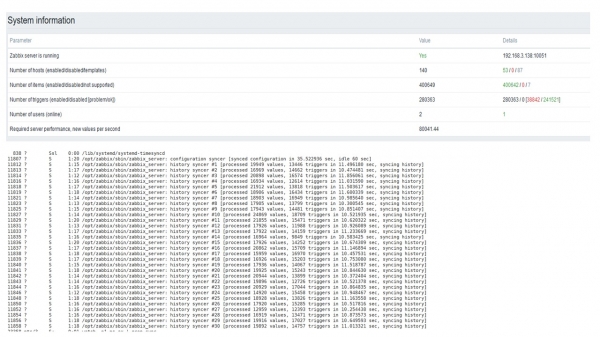
Insättningen med belastning från trettio history syncers är redan ganska hög.
Jag ökade också olika parametrar: history syncers, cache.
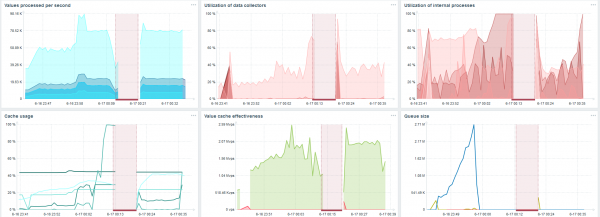
På min hårdvara ökade belastningen av history syncers till maximalt. HistoryCache fylldes snabbt med data — bufferten samlade data för bearbetning.
Hela tiden observerade jag hur processorn, RAM och andra systemparametrar användes, och jag upptäckte att diskanvändningen var maximal.
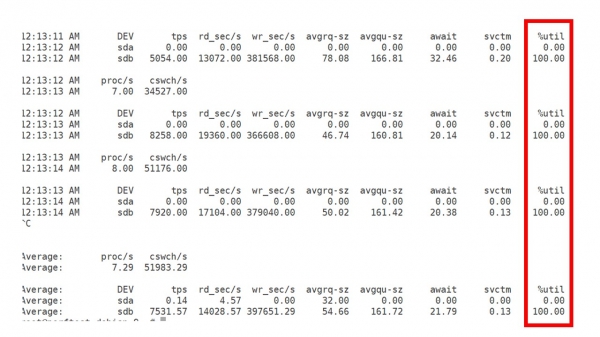
Jag uppnådde användningen av diskens maximala kapacitet på denna hårdvara och på denna virtuella maskin. Vid sådan intensitet började PostgreSQL snabbt släppa data, och disken kunde inte längre hålla jämna steg med skriv- och läsoperationer.
En andra server
Jag tog en annan server som redan hade 48 processorer och 128 GB RAM. Jag finjusterade den — installerade 60 history syncer och uppnådde acceptabel prestanda.
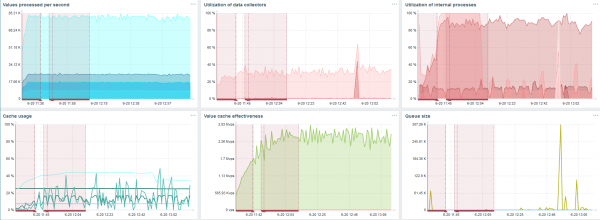
Faktiskt är detta redan prestationsgränsen där något måste göras.
TimescaleDB. 80 000 nvps
Mitt huvudsakliga mål är att testa TimescaleDB:s kapabiliteter under belastning från Zabbix. 80 000 värden per sekund är mycket, insamlingsfrekvensen för metric (utom Yandex, förstås) och en ganska stor "setup".
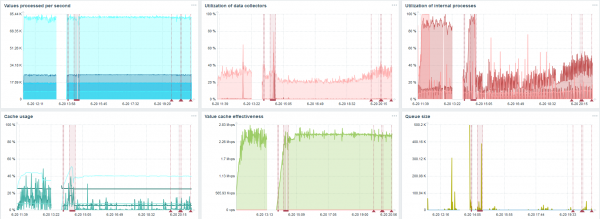
På varje graf finns en nedgång — det är just dataöverföringen. Efter nedgångarna i Zabbix-servern ändrades belastningsprofilen för history syncer dramatiskt — den föll med tre gånger.
TimescaleDB gör det möjligt att införa data nästan tre gånger snabbare och använda mindre HistoryCache.
Därmed kommer dina data att levereras i rätt tid.
TimescaleDB. 120 000 nvps
Därefter ökade jag antalet datapunkter till 500 000. Huvudmålet var att testa TimescaleDB:s kapabiliteter — jag fick ett beräknat värde på 125 000 värden per sekund.
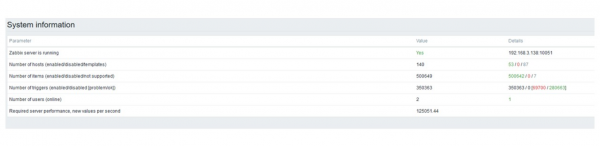
Detta är en fungerande "setup" som kan fungera länge. Men eftersom min disk bara var 1,5 TB, fyllde jag den på några dagar.
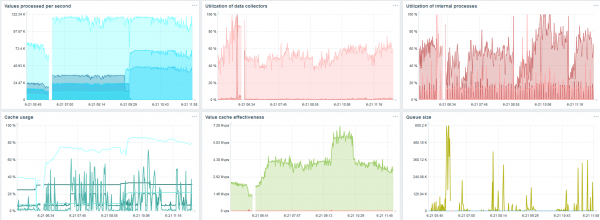
Det viktigaste är att nya partitioner i TimescaleDB också skapades under samma tid.
För prestandan är detta helt omärkbart. När partitioner skapas i MySQL, till exempel, är allt annorlunda. Vanligtvis sker detta på natten, eftersom det blockerar all inmatning, arbetar med tabeller och kan skapa service degradation. I fallet med TimescaleDB finns detta inte.
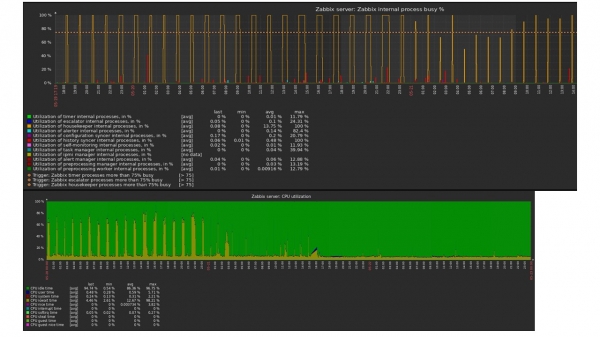
Som exempel visar jag en graf från många i community. I bilden är TimescaleDB aktiverat, vilket gör att belastningen på io.weight på processorn sjönk. Användningen av interna processer minskade också. Dessutom är detta en vanlig virtuell maskin på vanliga spinning disks, inte SSD.
Slutsatser
TimescaleDB är en bra lösning för små "setup", som stöter på diskprestanda. Det kommer att tillåta att fortsätta arbeta bra tills databasens migration till snabbare hårdvara.
TimescaleDB är lätt att konfigurera, ger en prestationsökning, fungerar bra med Zabbix och har fördelar jämfört med PostgreSQL.
Om du använder PostgreSQL och inte planerar att byta, rekommenderar jag att använda PostgreSQL med TimescaleDB-tillägget i samverkan med Zabbix. Denna lösning fungerar effektivt upp till medelstora "setup".
När vi säger "högpresterande" menar vi Det dröjer inte länge innan vi får bekanta oss med teknologier och metoder som gör det möjligt för tjänster att betjäna miljontals användare. Listan för den 7 och 8 november har vi redan sammanställt, men kan fortfarande föreslås.
Prenumerera på vår och , där vi avslöjar nyheter om den kommande konferensen och lär dig hur du får ut maximalt.
Källa: habr.com
