

Hej, jag arbetar med att skapa applikationer för databashanteringssystem. — det är en plattform utvecklad av Mail.ru Group som kombinerar en högpresterande databashanteringssystem med en applikationsserver skriven i Lua. Den höga hastigheten hos lösningar baserade på Tarantool uppnås bland annat genom stödet för in-memory-databashantering och möjligheten att köra affärslogik i samma adressutrymme som data. Samtidigt garanteras datapersistering med hjälp av ACID-transaktioner (WAL-loggning hålls på disk). Tarantool har inbyggt stöd för replikering och sharding. Från och med version 2.1 stöds SQL-frågor. Tarantool har öppen källkod och distribueras under en förenklad BSD-licens. Det finns också en kommersiell Enterprise-version.
Känn kraften! (…akkurat njut av prestandan)
Allt detta gör Tarantool till en attraktiv plattform för att skapa högbelastade applikationer som arbetar med databaser. I sådana applikationer uppstår ofta behovet av datoreplikering.
Som nämnts ovan har Tarantool inbyggd datoreplikering. Principen för dess arbete är att alla transaktioner som finns i masterlogg (WAL) utförs sekventiellt på replikerna. Vanligtvis kallas en sådan replikering för lågnivå) och används för att säkerställa applikationens motståndskraft och/eller för att fördela läsbelastningen mellan klusternoder.
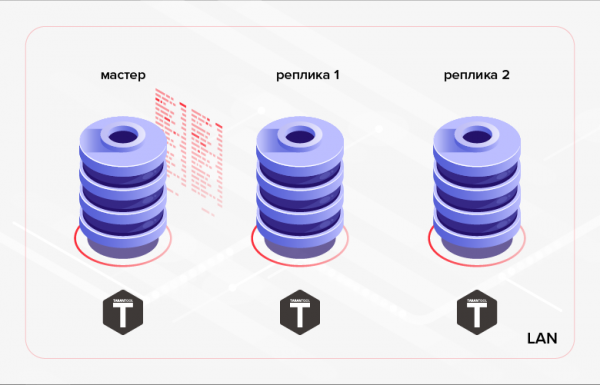
Fig. 1. Replikering inom klustret
Ett exempel på ett alternativt scenario kan vara överföring av data skapade i en databas till en annan databas för bearbetning/övervakning. I det senare fallet kan det vara mer praktiskt att använda högnivå replikering — datoreplikering på affärslogikens nivå i applikationen. Det vill säga, vi använder inte en färdig lösning inbyggd i databashanteringssystemet, utan implementerar replikering i den applikation vi utvecklar själva. Denna metod har både fördelar och nackdelar. Låt oss lista fördelarna.
1. Minska trafik:
- du kan överföra inte alla data, utan bara en del av dem (till exempel kan du överföra endast vissa tabeller, vissa av deras kolumner eller poster som uppfyller vissa kriterier);
- till skillnad från lågnivåreplikation som kontinuerligt körs i asynkront (implementerat i nuvarande version av Tarantool - 1.10) eller synkront (kommer att implementeras i kommande versioner av Tarantool) läge, kan högnivåreplikation utföras i sessioner (dvs. applikationen synkroniserar först data - en databyte-session, sedan följer ett uppehåll i replikationen, efter vilket nästa databyte-session äger rum, och så vidare);
- om posten har ändrats flera gånger kan endast den senaste versionen av den överföras (till skillnad från lågnivåreplikation där alla ändringar som gjorts på master kommer att spelas upp i ordning på replikerna).
2. Inga svårigheter med att implementera överföring via HTTP, vilket möjliggör synkronisering av fjärr-DB.
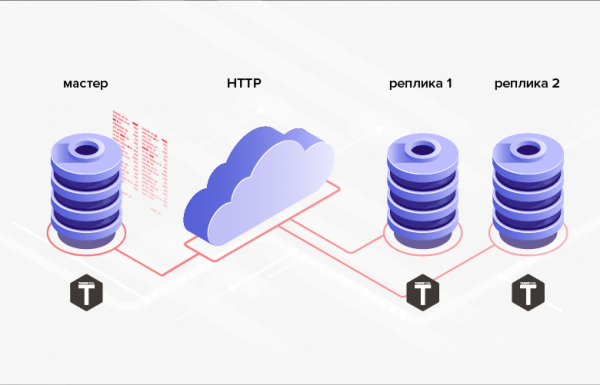
Fig. 2. Replikation via HTTP
3. Databastrukturerna mellan vilka data överförs behöver inte vara identiska (faktiskt är det i allmänhet möjligt att till och med använda olika DBS, programmeringsspråk, plattformar etc.).
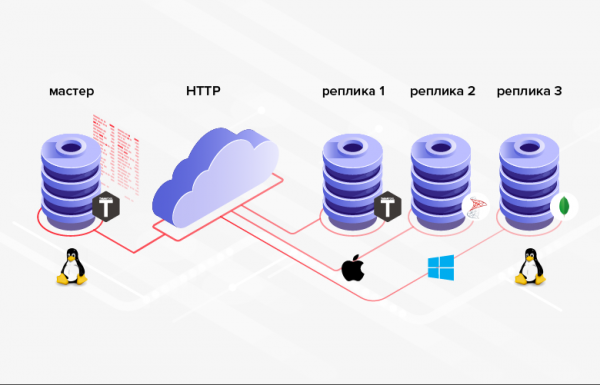
Fig. 3. Replikation i heterogena system
Nackdelen är att programmering i genomsnitt är svårare/kostsammare än konfiguration, och istället för att ställa in inbyggd funktionalitet måste man implementera sin egen.
Om fördelarna som anges i din situation är avgörande (eller är nödvändiga villkor), kan det vara värt att använda högnivåreplikation. Låt oss överväga flera sätt att implementera högnivåreplikation av data i Tarantool DB.
Minimering av trafik
Så ett av fördelarna med högnivåreplikation är att spara trafik. För att detta fördel ska kunna realiseras fullt ut måste mängden data som överförs vid varje databyte-session minimeras. Självklart är det viktigt att komma ihåg att vid slutet av sessionen måste datamottagaren vara synkroniserad med källan (åtminstone för den del av data som är involverad i replikationen).
Hur kan man minimera mängden data som överförs vid högnivåreplikation? En direkt lösning kan vara att välja data baserat på datum-tid. För detta kan ett befintligt databasfält med datum-tid användas (om det finns). Till exempel kan ett "order"-dokument ha ett fält för "önskad leveranstid" - leveranstid. Problemet med denna lösning är att värdena i detta fält inte nödvändigtvis behöver vara i den ordning de beställningar skapades. Således kan vi inte komma ihåg det maximala värdet för fältet leveranstid, som överfördes vid föregående utbytestillfälle, och vid nästa utbytestillfälle välja alla poster med ett högre värde för fältet leveranstid. Under tiden mellan utbytestillfällen kan poster med ett lägre värde ha lagts till leveranstid. Dessutom kan beställningen ha ändrats utan att påverka fältet leveranstid. I båda fallen kommer ändringarna inte att överföras från källan till mottagaren. För att lösa dessa problem behöver vi överföra data "överlappar". Det vill säga, vid varje utbytestillfälle kommer vi att överföra all data med ett värde för fältet leveranstid, som överstiger en viss punkt i det förflutna (till exempel N timmar från nu). Men det är uppenbart att denna metod är starkt överflödig för stora system och kan upphäva den trafikbesparing vi strävar efter. Dessutom kanske det inte finns något fält kopplat till datum och tid i den överförda tabellen.
En annan lösning, som är mer komplex ur implementeringssynpunkt, är att bekräfta mottagandet av data. I det här fallet överförs all data vid varje utbytestillfälle som inte har bekräftats av mottagaren. För att genomföra detta krävs det att vi lägger till en boolean-kolumn i källtabellen (till exempel, is_transferred). Om mottagaren bekräftar mottagandet av posten, kommer det aktuella fältet att anta värdet true, varefter posten inte längre deltar i utbyten. Denna implementeringsvariant har följande nackdelar. För det första, för varje överförd post måste ett bekräftelse skapas och skickas. Grovt sett kan detta jämställas med att dubba mängden överförda data och leda till en fördubbling av antalet rundresor. För det andra, det saknas möjlighet att skicka samma post till flera mottagare (den första mottagaren som fått posten bekräftar mottagandet för sig själv och för alla andra).
En metod utan de ovan nämnda bristerna består av att lägga till en kolumn i den överförda tabellen för att spåra ändringar i dess rader. Denna kolumn kan ha datetime-typ och bör sättas/uppdateras av applikationen till den aktuella tiden varje gång en post läggs till/ändras (atomärt med tillägg/ändring). Låt oss kalla kolumnen update_time. Genom att spara det maximala värdet av detta kolumnfält för de överförda posterna kan vi börja nästa utbytespass från detta värde (välj poster med värdet i fältet update_time, som överstiger det tidigare sparade värdet). Problemet med den senaste metoden är att datamodifikationer kan ske i paketform. Som ett resultat kan värdena i fältet i kolumnen update_time inte vara unika. Därför kan denna kolumn inte användas för partiell (sidan för sida) datautdelning. För sidvis utdelning av data måste ytterligare mekanismer uppfinnas, som troligen kommer att ha mycket låg effektivitet (till exempel att hämta alla poster från databasen med ett värde update_time över ett visst angivet och ge ett visst antal poster, med början från en viss förskjutning från början av urvalet).
Effektiviteten av dataöverföringen kan ökas något genom att förbättra den föregående metoden. För detta syfte kommer vi att använda heltalsformat (long integer) som värden i fältet för att spåra ändringar. Vi kallar kolumnen row_ver. Värdet i detta kolumnfält bör fortfarande anges/uppdateras varje gång en post skapas/ändras. Men i det här fallet kommer fältet att tilldelas ett värde av en räknare som ökas med ett. Som ett resultat kommer kolumnen row_ver att innehålla unika värden och kan användas inte bara för att ge "delta" data (data som lagts till/ändrats efter att det föregående utbytet avslutats), utan även för en enkel och effektiv uppdelning av dessa i sidor.
Den sista föreslagna metoden för att minimera mängden data som överförs inom högre nivå av replikering framstår som den mest optimala och allsidiga. Låt oss stanna vid den lite mer detaljerat.
Överföring av data med hjälp av en radversionsräknare
Implementering av server-/masterdel
I MS SQL Server finns det en speciell kolumntyp för att genomföra en liknande metod - rowversion. Varje databas har en räknare som ökar med ett varje gång en post läggs till/ändras i en tabell som har en kolumn av typen rowversion. Värdet av denna räknare tilldelas automatiskt fältet i den nyaddedda/ändrade posten. DBMS Tarantool har ingen liknande inbyggd mekanism. Emellertid kan det enkelt implementeras manuellt i Tarantool. Låt oss se hur det görs.
Först lite terminologi: tabeller i Tarantool kallas utrymmen (space), och poster kallas tupler (tuple). I Tarantool kan man skapa sekvenser (sequence). Sekvenser är inget annat än namngivna generatorer av ordnade heltalsvärden. Det vill säga, det är precis vad vi behöver för våra syften. Nedan kommer vi att skapa en sådan sekvens.
Innan någon operation med databasen i Tarantool kan utföras, måste följande kommando köras:
box.cfg{}Som ett resultat kommer Tarantool att börja spara databasens snapshots och transaktionslogg i den aktuella katalogen.
Låt oss skapa en sekvens row_version:
box.schema.sequence.create('row_version',
    { if_not_exists = true })
Alternativ if_not_exists möjliggör att skapa skriptet flera gånger: om objektet finns, kommer Tarantool inte att försöka skapa det igen. Detta alternativ kommer att användas i alla kommande DDL-kommandon.
Låt oss skapa ett utrymme som exempel.
box.schema.space.create('goods', {
    format = {
        {
            name = 'id',
            type = 'unsigned'

        },
        {
            name = 'name',
            type = 'string'

        },
        {
            name = 'code',
            type = 'unsigned'

        },
        {
            name = 'row_ver',
            type = 'unsigned'

        }
    },
    if_not_exists = true
})
Här har vi angett namnet på utrymmet (goods), fältnamn och deras typer.
Autoincrement-fält i Tarantool skapas också med hjälp av sekvenser. Låt oss skapa en autoincrement primärnyckel på fältet id:
box.schema.sequence.create('goods_id',
    { if_not_exists = true })
box.space.goods:create_index('primary', {
    parts = { 'id' },
    sequence = 'goods_id',
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
Tarantool stöder flera typer av index. Vanligast används index av typerna TREE och HASH, baserade på deras respektive struktur. TREE är den mest mångsidiga typen av index. Den gör det möjligt att hämta data i ordnad form. För att välja på lika värde passar däremot HASH bättre. Därför är det lämpligt att använda HASH för primärnyckeln (vilket vi har gjort).
För att använda en kolumn row_ver för att överföra ändrade data, måste värdena i sekvensen kopplas till fälten i denna kolumn row_ver. Men till skillnad från primärnyckeln måste värdet i kolumnens fält row_ver öka med ett enhet, inte bara vid tillägg av nya poster, utan också vid ändring av befintliga. För detta kan man använda triggers. I Tarantool finns det två typer av triggers för spaces: before_replace och on_replace. Triggers aktiveras vid varje databasändring i space (för varje tuple som berörs av ändringar aktiveras triggerfunktionen). Till skillnad från on_replace, before_replace-triggers tillåter att modifiera data i tuple som trigget utförs för. Därför passar den sista typen av triggers oss.
box.space.goods:before_replace(function(old, new)
    return box.tuple.new({new[1], new[2], new[3],
        box.sequence.row_version:next()})
end)
Den angivna triggern ersätter värdet i fältet row_ver i den bevarade tupeln med nästa värde från sekvensen row_version.
För att kunna hämta data från space goods baserat på kolumnen row_ver, skapar vi ett index:
box.space.goods:create_index('row_ver', {
    parts = { 'row_ver' },
    unique = true,
    type = 'TREE',
    if_not_exists = true
})
Typ av index är träd (TREE), eftersom vi behöver hämta data i stigande ordning av värden i kolumnen. row_ver.
Låt oss lägga till några data i space:
box.space.goods:insert{nil, 'pen', 123}
box.space.goods:insert{nil, 'pencil', 321}
box.space.goods:insert{nil, 'brush', 100}
box.space.goods:insert{nil, 'watercolour', 456}
box.space.goods:insert{nil, 'album', 101}
box.space.goods:insert{nil, 'notebook', 800}
box.space.goods:insert{nil, 'rubber', 531}
box.space.goods:insert{nil, 'ruler', 135}
Eftersom det första fältet är en autoinkrementerande räknare, skickar vi nil istället för det. Tarantool sätter automatiskt in nästa värde. På samma sätt kan man ange nil för kolumnens fält row_ver eller helt enkelt utelämna värdet, eftersom denna kolumn är den sista i space.
Låt oss kontrollera resultatet av insättningen:
tarantool> box.space.goods:select()
---
- - [1, 'pen', 123, 1]
  - [2, 'pencil', 321, 2]
  - [3, 'brush', 100, 3]
  - [4, 'watercolour', 456, 4]
  - [5, 'album', 101, 5]
  - [6, 'notebook', 800, 6]
  - [7, 'rubber', 531, 7]
  - [8, 'ruler', 135, 8]
...
Som vi ser, har det första och sista fältet fyllts i automatiskt. Nu blir det inte svårt att skriva en funktion för paginering av ändringar i rymden. goods:
local page_size = 5
local function get_goods(row_ver)
    local index = box.space.goods.index.row_ver
    local goods = {}
    local counter = 0
    for _, tuple in index:pairs(row_ver, {
        iterator = 'GT' }) do
        local obj = tuple:tomap({ names_only = true })
        table.insert(goods, obj)
        counter = counter + 1
        if counter >= page_size then
            break
        end
    end
    return goods
end
Funktionen tar ett parametervärde row_ver, vilket anger från vilket värde ändringarna ska hämtas, och returnerar en portion av de ändrade uppgifterna.
Dataval är i Tarantool baserat på index. Funktionen get_goods använder en iterator över indexet row_ver för att hämta de ändrade uppgifterna. Typen av iteratorn är GT (Större än). Detta innebär att iteratorn kommer att gå igenom indexvärdena startande från den angivna nyckeln (värdet av fältet row_ver).
Iteratorn returnerar tuples. För att kunna överföra data via HTTP senare, måste tupler konverteras till en struktur som är bekväm för efterföljande serialisering. I det här exemplet används standardfunktionen tomap. Istället för att använda tomap kan man skriva en egen funktion. Till exempel kan vi vilja döpa om fältet name, inte skicka fältet code och lägga till fältet comment:
local function unflatten_goods(tuple)
    local obj = {}
    obj.id = tuple.id
    obj.goods_name = tuple.name
    obj.comment = 'some kommentar'
    obj.row_ver = tuple.row_ver
    return obj
end
Storleken på sidan av de returnerade uppgifterna (antal poster per portion) definieras av variabeln page_size. I exemplet är värdet page_size Det är lika med 5. I ett riktigt program har sidstorleken vanligtvis större betydelse. Den beror på den genomsnittliga storleken av ett tuple-space. Den optimala sidstorleken kan bestämmas empiriskt genom att mäta dataöverföringstiden. Ju större sidstorlek, desto färre rundresor mellan avsändaren och mottagaren. Detta kan minska den totala tiden för att överföra ändringar. Men med en alltför stor sidstorlek kan vi ta för lång tid för servern att serialisera resultaten. Det kan leda till förseningar i bearbetningen av andra förfrågningar som skickas till servern. Parametern page_size kan laddas från konfigurationsfilen. För varje överfört space kan ett eget värde anges. För de flesta spaces kan dock standardvärdet (till exempel 100) passa.
Vi utför funktionen get_goods:
tarantool> get_goods(0)

---
- - row_ver: 1
    code: 123
    name: pen
    id: 1
  - row_ver: 2
    code: 321
    name: pencil
    id: 2
  - row_ver: 3
    code: 100
    name: brush
    id: 3
  - row_ver: 4
    code: 456
    name: watercolour
    id: 4
  - row_ver: 5
    code: 101
    name: album
    id: 5
...
Låt oss ta värdet av fältet row_ver från den sista raden och återskalla funktionen:
tarantool> get_goods(5)

---
- - row_ver: 6
    code: 800
    name: notebook
    id: 6
  - row_ver: 7
    code: 531
    name: rubber
    id: 7
  - row_ver: 8
    code: 135
    name: ruler
    id: 8
...
Och en gång till:
tarantool> get_goods(8)
---
- []
...
Som vi ser returnerar funktionen samtliga poster i space på detta sätt, goods. Efter den sista sidan följer en tom uppsättning.
Vi gör ändringar i space:
box.space.goods:update(4, {{'=', 6, 'copybook'}})
box.space.goods:insert{nil, 'clip', 234}
box.space.goods:insert{nil, 'folder', 432}
Vi har ändrat värdet av fältet name för en post och lagt till två nya poster.
Vi upprepar det senaste funktionsanropet:
tarantool> get_goods(8)
---


- - row_ver: 9
    code: 800
    name: copybook
    id: 6
  - row_ver: 10
    code: 234
    name: clip
    id: 9
  - row_ver: 11
    code: 432
    name: folder
    id: 10
...
Funktionen returnerade de ändrade och tillagda posterna. Således gör funktionen get_goods möjligt att hämta data som har ändrats sedan den senaste anropningen, vilket är grunden för den diskuterade replikeringsmetoden.
Vi lämnar HTTP-resultatets utdata i form av JSON utanför ramarna för denna artikel. Mer information kan läsas här:
Implementeringen av klient-/slave-delen
Låt oss se hur implementeringen av mottagarsidan ser ut. Vi skapar en space på mottagarsidan för att lagra de uppladdade data:
box.schema.space.create('goods', {
    format = {
        {
            name = 'id',
            type = 'unsigned'

        },
        {
            name = 'name',
            type = 'string'

        },
        {
            name = 'code',
            type = 'unsigned'

        }
    },
    if_not_exists = true
})

box.space.goods:create_index('primary', {
    parts = { 'id' },
    sequence = 'goods_id',
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
Strukturen av utrymmet liknar strukturen av utrymmet i källan. Men eftersom vi inte planerar att överföra de erhållna uppgifterna någon annanstans, finns inte kolumnen row_ver i mottagarens utrymme. I fältet id kommer identifierarna från källan att sparas. Därför behöver inte mottagarsidan göra den autoinkrementell.
Dessutom behöver vi ett utrymme för att spara värdena row_ver:
box.schema.space.create('row_ver', {
    format = {
        {
            name = 'space_name',
            type = 'string'

        },
        {
            name = 'value',
            type = 'string'

        }
    },
    if_not_exists = true
})

box.space.row_ver:create_index('primary', {
    parts = { 'space_name' },
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
För varje laddat utrymme (fältet space_name) kommer vi här att spara det senaste laddade värdet row_ver (fältet value). Den primära nyckeln är kolumnen space_name.
Vi kommer att skapa en funktion för att ladda data från utrymmet goods via HTTP. För detta behöver vi ett bibliotek som implementerar en HTTP-klient. Följande rad laddar biblioteket och skapar en instans av HTTP-klienten:
local http_client = require('http.client').new()Vi behöver också ett bibliotek för deserialisering av json:
local json = require('json')Det är tillräckligt för att skapa en funktion för att ladda data:
local function load_data(url, row_ver)
    local url = ('%s?rowVer=%s'):format(url,
        tostring(row_ver))
    local body = nil
    local data = http_client:request('GET', url, body, {
        keepalive_idle =  1,
        keepalive_interval = 1
    })
    return json.decode(data.body)
end
Funktionen utför en HTTP-begäran till den angivna url:en, skickar med row_ver som parameter och returnerar det deserialiserade resultatet av begäran.
Funktionen för att spara de mottagna uppgifterna ser ut så här:
local function save_goods(goods)
    local n = #goods
    box.atomic(function()
        for i = 1, n do
            local obj = goods[i]
            box.space.goods:put(
                obj.id, obj.name, obj.code)
        end
    end)
end
Loopen för att spara data i utrymmet goods placeras i en transaktion (detta görs med funktionen box.atomic) för att minska antalet operationer med disken.
Slutligen kan funktionen för att synkronisera det lokala utrymmet goods med källan implementeras så här:
local function sync_goods()
    local tuple = box.space.row_ver:get('goods')
    local row_ver = tuple and tuple.value or 0

    —— set your url here:
    local url = 'http://127.0.0.1:81/test/goods/list'

    while true do
        local goods = load_goods(url, row_ver)

        local count = #goods
        if count == 0 then
            return
        end

        save_goods(goods)

        row_ver = goods[count].rowVer
        box.space.row_ver:put({'goods', row_ver})
    end
end
Först läser vi det tidigare sparade värdet row_ver för utrymmet goods. Om den saknas (första utbytet), tar vi som row_ver noll. Nästa steg i cykeln är att utföra sidladdning av ändrade data från källan via angiven url. Vid varje iteration sparar vi de mottagna uppgifterna i motsvarande lokala utrymme och uppdaterar värdet row_ver (i utrymmet row_ver och i variabeln row_ver) - vi tar värdet row_ver från den sista raden av de laddade uppgifterna.
För att skydda mot oavsiktlig loopning (i händelse av ett programfel) kan cykeln while ersättas med for:
for _ = 1, max_req do ... Som ett resultat av att funktionen sync_goods utrymmet goods i mottagaren kommer att innehålla de senaste versionerna av alla poster från utrymmet goods i källan.
Uppenbarligen kan denna metod inte användas för att överföra borttagning av data. Om det finns ett sådant behov kan vi använda en borttagningsmarkering. Vi lägger till i utrymmet goods ett booleskt fält is_deleted och istället för fysisk borttagning av poster använder vi logisk borttagning - vi sätter värdet på fältet is_deleted till värdet true. Ibland kan det vara mer praktiskt att använda ett fält is_deleted , där datum och tid för den logiska borttagningen av posten lagras. Efter logisk borttagning kommer den markerade posten att överföras från källan till mottagaren (enligt den logik som diskuterades ovan). borttagenSekvensen
kan användas för att överföra data från andra utrymmen: det finns inget behov av att skapa en separat sekvens för varje överfört utrymme. row_ver Vi har sett en effektiv metod för hög nivå av datareplication i applikationer som använder databashanteringssystemet Tarantool.
Databashanteringssystemet Tarantool är en attraktiv och lovande produkt för att skapa högbelastade applikationer.
Slutsatser
- Hög nivå av datareplication har flera fördelar jämfört med låg nivå av datareplication.
- Metoden för hög nivå av datareplication som beskrivs i artikeln gör det möjligt att minimera mängden överförda data genom att bara överföra de poster som har ändrats efter den senaste utbytestillfället.
- Hej, jag utvecklar applikationer för databashanteringssystemet Tarantool - en plattform utvecklad av Mail.ru Group som kombinerar högpresterande.
Källa: habr.com
