

Jag vill att ni ska ta del av sammanfattningen av Georgy Rylovs rapport från början av 2020 "WAL-G: nya möjligheter och samhällsutveckling"
Under open-source underhållet uppstår många problem när man växer. Hur skriver man fler efterfrågade funktioner, fixar fler issues och hinner se fler pull requestar? Genom exemplet WAL-G (backup-verktyg för PostgreSQL) kommer jag att berätta hur vi löste dessa problem genom att starta en kurs i Open-source utveckling på universitetet, vad vi har uppnått och vart vi ska gå härnäst.
Hej alla igen! Jag är utvecklare på Yandex från Jekaterinburg. Och idag kommer jag att berätta om WAL-G.
I titeln på rapporten stod det inte att det handlade om backuper. Finns det någon som inte vet vad WAL-G är? Eller vet alla? Räck upp handen om ni inte vet. Wow, ni kom till föreläsningen utan att veta vad den handlar om.
Låt mig berätta vad som kommer hända idag. Det har blivit så att vårt team har arbetat med backuper ett tag nu. Och det här är ytterligare en föreläsning i serien där vi berättar om hur vi lagrar data säkert, pålitligt, bekvämt och effektivt.
I tidigare avsnitt har det varit många föreläsningar av Andrey Borodin, Vladimir Leskov. Vi har varit många. Och vi har alla pratat om WAL-G i många år.
clck.ru/F8ioz —
clck.ru/Ln8Qw —
Den här föreläsningen kommer att skilja sig lite från de andra, för här handlar det mer om den tekniska delen, och här kommer jag att berätta om hur vi stött på problem relaterade till tillväxten av samhället. Och hur vi kom på en liten idé som hjälper oss att hantera detta.
För några år sedan var WAL-G ett ganska litet projekt som vi fått från Citus Data. Och vi tog just över det. Det utvecklades av en person.
Och i WAL-G fanns det inte:
- Backup från replik.
- Det fanns inga inkrementella backuper.
- Det fanns inga WAL-Delta backuper.
- Och massor av saker saknades.
Under dessa år har WAL-G växt mycket.
Och vid 2020 hade allt detta nämnda redan dykt upp. Dessutom har vi nu:
- Över 1 000 stjärnor på GitHub.
- 150 forkningar.
- Cirka 15 öppna PR.
- Och mycket fler bidragsgivare.
- Och öppna issues hela tiden. Och detta trots att vi bokstavligen går in där varje dag för att göra något med det.
Och vi kom fram till att det här projektet kräver mer av vår uppmärksamhet, även när vi själva inte behöver implementera något för vår tjänst Managed Databases i Yandex.
Och någonstans hösten 2018 kom vi på en idé. Vanligtvis har teamet några sätt att utveckla funktioner eller åtgärda buggar om ni har ont om resurser. Till exempel kan man anställa en ytterligare utvecklare och betala denne. Eller man kan ta in en praktikant under en tid och betala denne en lön. Men det finns också en ganska stor grupp människor, en del av vilken faktiskt kan skriva kod. Problemet är bara att ni inte alltid vet vilken kvalitet den koden har.
Vi funderade och bestämde oss för att försöka involvera studenter. Men studenterna kommer inte att delta i allt. De kommer att göra endast en del av arbetet. De kommer till exempel att skriva tester, fixa buggar och implementera funktioner som inte berör den huvudsakliga funktionaliteten. Den huvudsakliga funktionaliteten är att skapa säkerhetskopior och återställa dessa. Om man tillåter en bugg i skapandet av en säkerhetskopia kommer vi att förlora data. Och ingen vill förstås det. Alla vill att allt ska vara mycket pålitligt. Därför vill vi självklart inte släppa in någon kod som vi har mindre förtroende för än vår egen. Det vill säga, all icke-kritisk kod är vad vi skulle vilja få från våra extra arbetskrafter.
Under vilka förhållanden accepteras studenternas PR?
- De är skyldiga att täcka sin kod med tester. Allt måste passerar i CI.
- Och vi genomgår också 2 granskningar. En av Andrej Borodin och en av mig.
- Och för att ytterligare kontrollera att detta inte bryter något i vår tjänst laddar jag upp en version med denna commit. Och vi kontrollerar i end-to-end tester att ingenting faller.
Specialkurs om Open Source
Lite om varför detta är viktigt och varför jag tror att det är en cool idé.
För oss är vinsten uppenbar:
- Vi får extra händer.
- Och vi söker kandidater till teamet bland duktiga studenter som skriver bra kod.
Vad är vinsten för studenterna?
De kan vara mindre uppenbara, eftersom studenterna åtminstone inte får pengar för den kod de skriver, utan får endast betyg i sin studieprotokoll.
Jag frågade dem om detta. Och enligt deras ord:
- Erfarenhet som bidragsgivare i Open Source.
- Få en rad i CV:t.
- Visa sig och gå igenom en intervju hos Yandex.
- Bli deltagare i GSoC.
- +1 specialkurs för dem som vill skriva kod.
Jag kommer inte att prata om hur kursen var strukturerad. Jag kan bara säga att WAL-G var det huvudsakliga projektet. Vi inkluderade också sådana projekt som Odyssey, PostgreSQL och ClickHouse i denna kurs.
Och vi gav uppgifter inte bara på denna kurs, utan delade också ut diplom och projektarbeten.
Och vad är vinsten för användarna?
Nu går vi vidare till den del som förmodligen intresserar er. Vad får ni ut av detta? Vinsten är att studenterna har åtgärdat många buggar. Och de har gjort funktionsförfrågningar som ni bad oss att genomföra.
Låt mig berätta om de saker som ni länge har velat ha och som nu har implementerats.
Stöd för tablespaces. Stöd för tablespaces i WAL-G har nog efterfrågats sedan WAL-G släpptes, eftersom WAL-G är efterträdaren till ett annat backupverktyg, WAL-E, där databackuper med tablespaces stödjades.
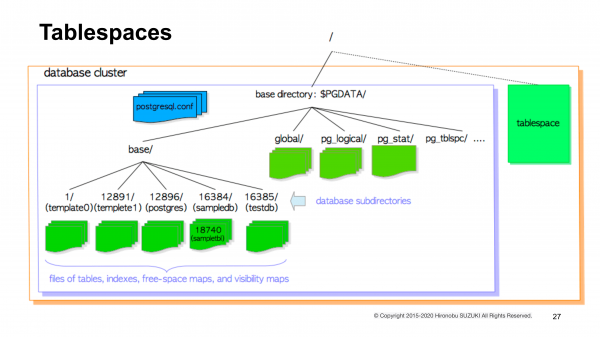
Jag påminner kort om vad det är och varför det behövs. Vanligtvis tar all Postgres-data upp en katalog i filsystemet som kallas basen. Och den här katalogen innehåller redan alla filer och underkataloger som Postgres behöver.
Tablespaces är kataloger där Postgres-data ligger, men de ligger inte utanför basen. På bilden kan man se att tablespaces ligger utanför basen.
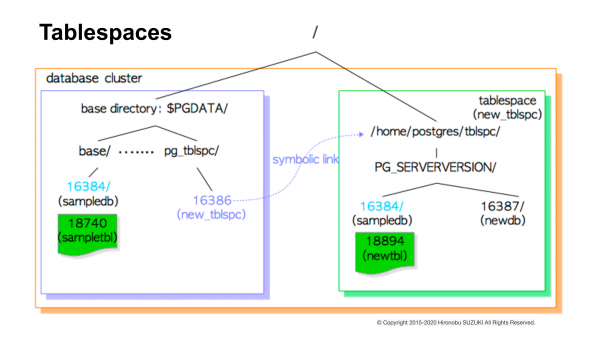
Hur ser detta ut för själva Postgres? I basen finns en separat underkatalog pg_tblspc. Och där ligger symlänkar till kataloger där Postgres-data faktiskt ligger utanför basen.
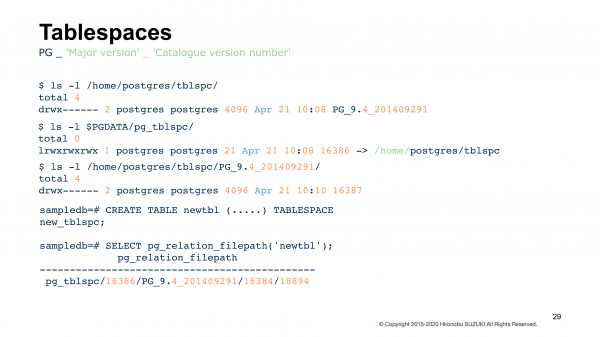
När ni använder allt detta kan dessa kommandon se ut som följande. Det vill säga, ni skapar en tabell i en specificerad tablespace och ser var den ligger nu. De två sista raderna, de sista kallelserna. Där kan man se att det finns någon väg. Men i själva verket – det är inte en riktig väg. Det är en väg med prefix från basen till tablespace. Och därifrån är den kopplad via en symlink som leder till era verkliga data.
Vi använder inte detta i vårt team, men det har använts av många andra användare av WAL-E som har berättat för oss att de ville migrera till WAL-G, men detta hindrade dem. Nu stöds det.
En annan funktion som vårt specialkurs har gett oss är catchup. De som har arbetat mer med Oracle än med Postgres känner till catchup.
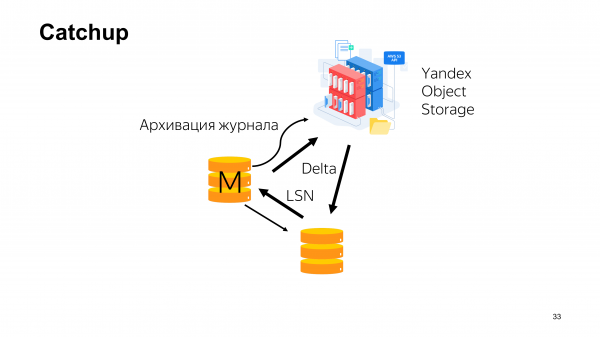
Kort om vad det handlar om. En sådan här kan vanligtvis se ut i topologin av vårt kluster. Vi har en master. Det finns en replika som strömmar från den en write-ahead log. Och replikan säger till mastern på vilken LSN den nu befinner sig. Och parallellt kan loggen arkiveras. Utöver arkiveringen skickas även säkerhetskopior till molnet. Delta-säkerhetskopior skickas också.
Vilket problem kan uppstå? När ni har en ganska stor databas kan det hända att replikan börjar halka efter mastern dramatiskt. Och den halkar efter så mycket att den aldrig kan ta ikapp. Detta problem behöver i regel lösas på något sätt.
Det enklaste sättet är att ta bort replikan och installera om den, eftersom den aldrig kommer att ta ikapp, och problemet måste åtgärdas. Men detta tar ganska lång tid, eftersom det är mycket, mycket tidskrävande att återställa en fullständig säkerhetskopia av en databas på 10 TB. Vi vill gärna göra detta så snabbt som möjligt om sådana problem uppstår. Det är just därför catchup är avsett.
Catchup möjliggör användning av delta-säkerhetskopior som lagras i molnet på detta sätt. Ni anger vilken LSN den efterhängande replikan befinner sig på och anger det i catchup-kommandot för att skapa en delta-säkerhetskopia mellan den LSN och LSN där ert kluster för närvarande befinner sig. Därefter återställer ni denna säkerhetskopia på den replika som hängde efter.
Andra databaser
Dessutom har våra studenter tagit med sig många funktioner. Eftersom vi på Yandex arbetar med mer än bara Postgres, har vi också MySQL, MongoDB, Redis och ClickHouse, så fick vi vid något tillfälle behovet av att kunna göra säkerhetskopior med point-in-time recovery för MySQL och att kunna ladda upp dem till molnet.
Och vi ville göra detta på ett sätt som liknar det som WAL-G gör. Vi bestämde oss för att experimentera och se hur allt skulle se ut.
I början separerade vi inte denna logik i en fork och skrev kod. Vi såg att vi hade en slags fungerande modell och att det kunde fungera. Sedan tänkte vi att vårt huvudcommunity är postgres-användare och de använder WAL-G. Därför måste vi på något sätt separera dessa delar. Det vill säga när vi justerar koden för Postgres får vi inte krossa MySQL, och när vi justerar MySQL får vi inte krossa Postgres.
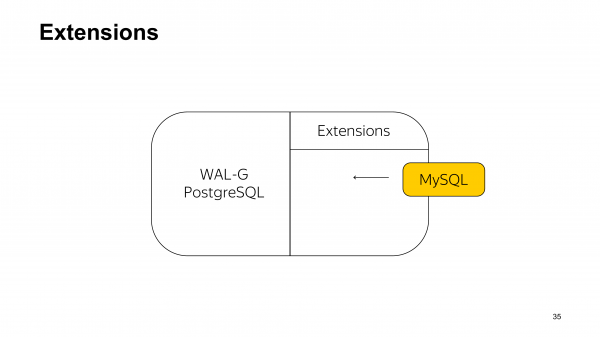
Den första idén om hur man skulle separera detta var att använda samma tillvägagångssätt som används i PostgreSQL-tillägg. Och i själva verket, för att göra en backup av MySQL måste du installera ett slags dynamiskt bibliotek.
Men här syns genast asymmetrin i detta tillvägagångssätt. När du säkerhetskopierar Postgres installerar du en vanlig backup-lösning för Postgres och allt fungerar utmärkt. Men för MySQL blir det så att du installerar en backup-lösning för Postgres och dessutom lägger till ett dynamiskt bibliotek för MySQL. Det låter lite konstigt. Vi tänkte också så och beslutade att detta inte var den lösningen som vi behövde.
Olika lösningar för Postgres, MySQL, MongoDB, Redis
Men det gjorde att vi, som vi känner, kom till den rätta lösningen – att utarbeta olika lösningar för olika databaser. Det tillät att isolera logiken knuten till säkerhetskopior av olika databaser, som skulle använda ett gemensamt API som implementeras av WAL-G.
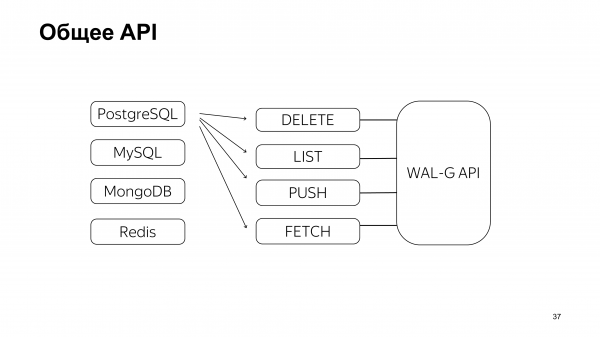
Detta är den delen som vi skrev själva – innan vi gav studenterna uppgifterna. Det betyder att detta är den del där de kunde göra något fel, så vi beslutade att det var bättre att göra något själva så att allt skulle bli bra.
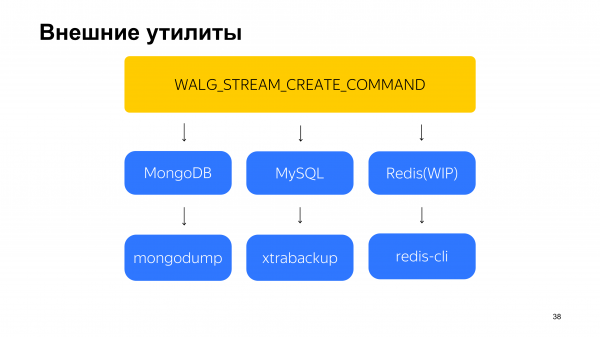
Efter detta gav vi ut uppgifterna. De togs omedelbart itu med. Studenterna krävdes att stödja tre databaser.
Det handlar om MySQL, som vi har säkerhetskopierat med hjälp av WAL-G på detta sätt i över ett år.
Och nu närmar sig MongoDB produktion, det finslipas där en del. I själva verket byggde vi grundstrukturen för allt detta. Sedan skrev studenterna några fungerande delar. Och vi förde dem till ett tillstånd där vi kan ta emot dem i vår produktion.
Dessa uppgifter såg inte ut som att studenterna behövde skriva kompletta backupverktyg för var och en av dessa databaser. Vi hade inte det problemet. Vår fråga var att vi ville ha point-in-time recovery och vi ville säkerhetskopiera till molnet. Vi bad studenterna att skriva någon kod som skulle lösa detta. Studenterna använde befintliga backupverktyg som på något sätt gör säkerhetskopior och sedan sammanfogade de allt detta med WAL-G, vilket överförde det hela till molnet. De lade också till point-in-time recovery.
Vad mer bidrog studenterna med? De tillförde stöd för kryptering med Libsodium till WAL-G.
Vi har också fått backupbevarande policys. Nu kan säkerhetskopior märkas som permanenta. Det är också mer praktiskt för din tjänst att automatisera processen för deras lagring.
Vad blev resultatet av detta experiment?
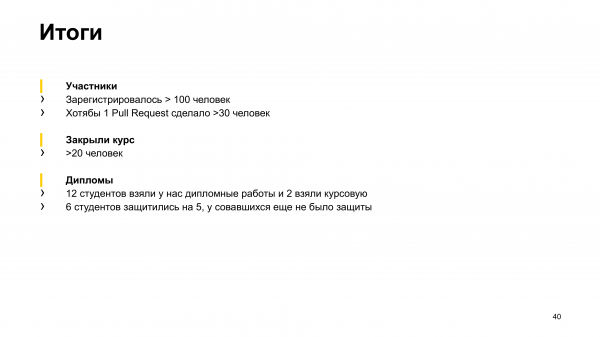
Ursprungligen registrerade sig över 100 personer på kursen. Jag nämnde inte från början att universitetet i Jekaterinburg är Ural Federal University. Där tillkännagav vi allt. 100 personer registrerade sig. Faktiskt började betydligt färre göra något, ungefär 30 personer.
Ännu färre personer avslutade kursen, eftersom det krävdes att skriva tester för de redan existerande koderna. Dessutom behövdes antingen fixa en bugg eller skapa en funktion. En del studenter avslutade ändå kursen.
Vid den här tidpunkten har studenterna reparerat cirka 14 frågor för denna kurs och skapat 10 funktioner av olika storlekar. Och enligt mig är detta en fullgod ersättning för en eller två utvecklare.
Förutom allt detta delade vi ut diplom och kursarbeten. 12 tog emot diplom. 6 av dem har redan gått igenom försvarsarbetet med betyget "5". De övriga har ännu inte haft sina försvar, men jag tror att de också kommer att klara sig bra.
Framtidsplaner
Vad har vi för planer för framtiden?
Åtminstone de funktionsförfrågningar som vi redan har hört från användare och vill genomföra. Det handlar om:
- Övervakning av korrektheten vid spårning av tidslinjen i arkivet för HA-klustrets säkerhetskopior. Med hjälp av WAL-G går det att göra detta. Och jag tror att vi hittar studenter som kan ta sig an detta.
- Vi har redan en ansvarig person för att överföra säkerhetskopior och WAL mellan moln.
- Och vi publicerade nyligen idén om att vi kan snabba upp WAL-G ännu mer genom att packa upp inkrementella säkerhetskopior utan att skriva över sidor och optimera arkiven som vi skickar dit.
Ni kan dela dem här
Vad var syftet med detta föredrag? Att just nu, förutom fyra av oss som stödjer detta projekt, har vi många extra händer. Särskilt om de kontaktar oss privat. Och om ni säkerhetskopierar era data och gör det med WAL-G eller skulle vilja övergå till WAL-G, så kan vi ganska lätt ta hänsyn till era önskemål.
Detta är QR-koden och länken. Ni kan gå dit och skriva alla era önskemål. Till exempel, om vi inte åtgärdar någon bugg. Eller en funktion som ni verkligen vill ha, men av någon anledning finns den ännu inte i någon säkerhetskopiering, inklusive vår. Var noga med att skriva om det.
Frågor
Hej! Tack för presentationen! Jag har en fråga om WAL-G, men inte om Postgres. WAL-G säkerhetskopierar MySQL och utför en extra backup. Om vi tar moderna installationer på CentOS, och om du gör en yum install MySQL, så kommer MariaDB att installeras. Från version 10.3 stöds ingen extra backup, utan MariaDB-backup stöds. Hur ser det ut med er?
Just nu har vi inte försökt säkerhetskopiera MariaDB. Vi har fått förfrågningar om stöd för FoundationDB, men generellt sett, om det finns en sådan förfrågan, kan vi hitta personer som kan göra det. Det tar inte så lång tid och är inte så svårt som jag tror.
God dag! Tack för presentationen! Frågan handlar om potentiellt nya funktioner. Är ni redo att få WAL-G att fungera med band, så att man kan göra backup till band?
Menar du backup till bandlagring, antar jag?
Ja.
Det finns Andrey Borodin där, som kan svara på den här frågan bättre än jag.
(Andrey) Ja, tack för frågan! Vi har fått en förfrågan om att flytta backup till band från molnlagring. Och för detta överföring mellan moln. Eftersom överföring mellan moln är en slags generell version av överföring till band. Dessutom har vi en skalbar arkitektur när det gäller lagringslösningar. Förresten, många av lagringarna skrevs av studenter. Om du skriver en lagring för band, så kommer den självklart att stödjas. Vi är redo att överväga pull requests. Man måste skriva en fil, läsa en fil. Om man gör dessa saker i Go, brukar det vanligtvis bli cirka 50 rader kod. Då kommer band att stödjas i WAL-G.
Tack för presentationen! En intressant utvecklingsprocess. Backup är en viktig del av funktionaliteten, som bör vara väl täckt av tester. När ni implementerade funktionalitet för nya databaser, var det också studenter som skrev testerna eller skrev ni testerna själva och lät studenterna göra implementationen senare?
Tester skrevs också av studenter. Men studenterna skrev mer för funktioner som nya databaser. De skrev integrationstester. Och de skrev enhetstester. Om integrationstesterna går igenom, dvs just nu – det är ett scenario som ni utför manuellt eller som görs av cron, till exempel. Dvs där är scenariot väldigt tydligt.
Studenterna har inte så mycket erfarenhet. Hur mycket tid går åt till granskning?
Ja, det går ganska mycket tid åt till recensionerna. Det vill säga, vanligtvis när flera committers kommer och säger att jag har gjort det och jag har gjort det, behöver man tänka och avsätta en halv dag för att förstå vad de har skrivit. För koden måste man läsa noggrant. De har ju inte genomgått en intervju. Vi känner dem inte så väl, därför tar det en betydande tid.
Tack för presentationen! Tidigare har Andrey Borodin sagt att archive_command i WAL-G bör anropas direkt. Men i fallet med en patronkluster behövs det ytterligare logik för att bestämma vilken nod som ska skicka loggar. Hur löser ni detta problem?
Vilket problem har ni här? Har ni en synkron replika från vilken ni tar backup? Eller vad?
(Andrey) Saken är att WAL-G verkligen är tänkt att användas utan inbäddning av shell-skript. Om något saknas, låt oss då skriva den logik som behöver finnas i WAL-G. När det gäller varifrån arkiveringen ska göras, så anser vi att arkiveringen bör ske från den nuvarande mastern i klustret. Arkivering från replica är en dålig idé. Där kan det uppstå olika scenarier med problem. Specifikt problem med arkivering av tidslinjer och all typ av tilläggsinformation. Tack för frågan!
(Förtydligande: Vi har gjort oss av med inbäddningen av shell-skript) )
God kväll! Tack för presentationen! Jag blev intresserad av funktionen catchup, som du nämnde. Har ni stött på situationer där replikan har fallit efter och som inte kunde ikapp?
Catchup dök upp bokstavligen i slutet av januari 2020. Med dokumentationen kan det vara bra att jobba lite mer. Vi skriver den själva och vi skriver inte så superbra. Och kanske bör vi kräva att studenterna skriver den.
Är den redan i release?
Pull request har redan blivit merge:ad, det vill säga jag har kontrollerat den. Jag testade detta på ett testkluster. Än så länge har vi inte haft en situation där vi kunde kontrollera detta på ett produktionsfall.
När ska vi förvänta oss det?
Jag vet inte. Vänta en månad, då har vi det säkert.
Källa: habr.com
