

Sedan 2019 har det funnits en lag i Ryssland om obligatorisk märkning. Lagen gäller inte alla varugrupper, och tidsramarna för införandet av obligatorisk märkning för olika varugrupper är olika. De första produkterna som omfattas av obligatorisk märkning är tobak, skor och läkemedel; senare kommer även andra produkter som parfymer, textilier och mjölk att läggas till. Denna lagstiftningsnyhet har lett till utvecklingen av nya IT-lösningar som gör det möjligt att spåra hela livscykeln för en produkt från produktion till köp av slutanvändaren, både för staten och alla organisationer som säljer produkter med obligatorisk märkning.
I X5 har systemet som ska spåra produkter med märkning och utbyta data med staten och leverantörer fått namnet “Markus”. Vi berättar i tur och ordning hur och av vem det har utvecklats, vilken teknologistack det har och varför vi har anledning att vara stolta.
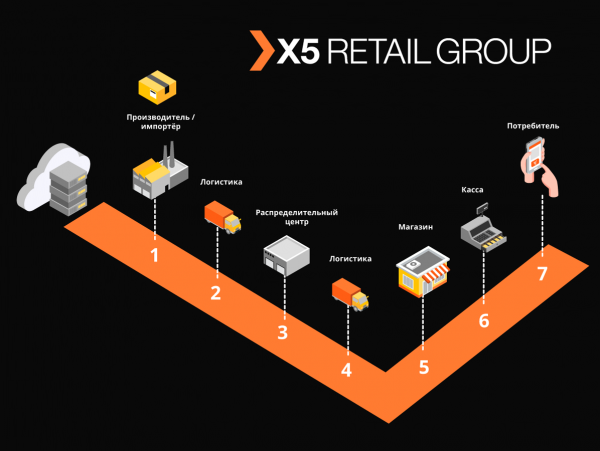
Verklig HighLoad
“Markus” löser många uppgifter, den viktigaste av dem är integrationsinteraktionen mellan informationssystemen hos X5 och statens informationssystem för märkta produkter (GIS MP) för att spåra rörelsen av märkta produkter. Plattformen lagrar också alla mottagna märkningkoder och hela historien om dessa koders rörelse mellan objekt, och hjälper till att eliminera förväxlingar med märkta produkter. Till exempel, med tobaksprodukter som ingår i de första grupperna av märkta varor, innehåller endast en bil med cigaretter cirka 600 000 paket, som vart och ett har sin egen unika kod. Vår uppgift är att spåra och verifiera lagligheten av flytten av varje sådant paket mellan lager och butiker, och i slutändan verifiera möjligheten att sälja dem till slutkonsumenten. Vi registrerar cirka 125 000 kassatransaktioner i timmen, och vi måste även registrera hur varje paket kom in i butiken. Med tanke på alla flyttningar mellan objekt förväntar vi oss tiotals miljarder poster per år.
Team M
Trots att "Markus" betraktas som ett projekt inom X5, genomförs det utifrån en produktansats. Teamet arbetar enligt Scrum. Projektet startade sommaren förra året, men de första resultaten kom först i oktober - teamet sattes samman, systemarkitekturen utvecklades och utrustning köptes in. Idag består teamet av 16 personer, varav sex arbetar med backend- och frontendutveckling, tre med systemanalys. Ytterligare sex personer ansvarar för manuell, belastning, automatiserad testning och produktunderhåll. Dessutom har vi en SRE-specialist.
I vårt team skriver inte bara utvecklare kod, nästan alla i gruppen kan programmera och skriver automatiserade tester, belastningsskript och automatiseringsskript. Vi lägger stor vikt vid detta, eftersom även produktunderhåll kräver en hög nivå av automatisering. Vi försöker alltid hjälpa kollegor som tidigare inte programmerat genom att ge dem små uppgifter.
Med anledning av coronaviruspandemin har vi övergått till distansarbete. Tillsammans med vår tillgång till alla verktyg för att hantera utvecklingen och den uppbyggda arbetsflödet i Jira och GitLab, lyckades vi enkelt klara denna fas. De månader som spenderades på distans visade att teamets produktivitet inte påverkades, för många ökade komforten i arbetet, det enda som saknas är det personliga mötet.
Teamets möte före distansarbetet
Möten under distansarbetet
Den tekniska stacken för lösningen
Den standardrepository och CI/CD-verktyget för X5 är GitLab. Vi använder det för att lagra koden, kontinuerlig testning, och distribution på test- och produktionsservrar. Vi tillämpar även en code review-praxis, där minst två kollegor måste godkänna de förändringar som utvecklaren gjort i koden. De statiska kodanalysatorerna SonarQube och JaCoCo hjälper oss att hålla koden ren och säkerställa att den nödvändiga nivån av enhetstestning upprätthålls. Alla kodändringar måste först genomgå dessa kontroller. Alla testscenarier som körs manuellt automatiseras senare.
För att framgångsrikt genomföra affärsprocesserna med "Markus" var vi tvungna att lösa ett antal tekniska utmaningar, en i taget.
Uppgift 1. Behov av horisontell skalbarhet i systemet
För att lösa denna uppgift valde vi en mikrotjänstarkitektur. Det var mycket viktigt att förstå ansvarsområdena för tjänsterna. Vi försökte dela upp dem utifrån affärsoperationer med hänsyn till processernas specifik. Till exempel, mottagningen på lagret är en ovanlig, men mycket omfattande operation, där man snabbt måste få information från myndigheterna om de mottagna varorna, där antalet i en leverans kan nå upp till 600000, kontrollera om det är tillåtet att ta emot dessa varor på lagret och ge all nödvändig information till lagrets automatiseringssystem. Å andra sidan har utfoutskick från lagren en mycket högre intensitet, men arbetar med mindre datavolymer.
Vi implementerar alla tjänster enligt stateless-principen och försöker även dela upp interna operationer i steg, genom att använda det vi kallar self-ämnen i Kafka. Detta innebär att mikrotjänsten skickar meddelanden till sig själv, vilket gör att belastningen på mer resurskrävande operationer kan fördelas och förenklar produktunderhåll, men mer om detta senare.
Vi beslutade att separera modulerna för interaktion med externa system i egna tjänster. Detta löste problemet med snabbt föränderliga API:er i externa system, nästan utan påverkan på tjänster med affärsfunktionalitet.
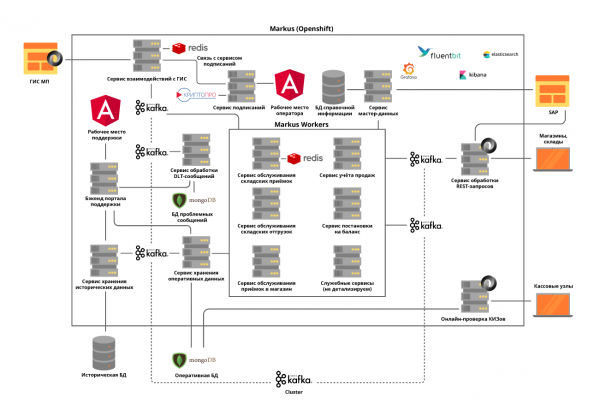
Alla mikrotjänster distribueras i en OpenShift-kluster, vilket både hanterar problem med skalning av varje mikrotjänst och gör att vi kan undvika att använda externa verktyg för Service Discovery.
Uppgift 2. Behov av att stödja hög belastning och mycket intensiv datakommunikation mellan plattformens tjänster: bara i projektets startfas genomförs cirka 600 operationer per sekund. Vi förväntar oss att detta värde ökar till 5000 op/s i takt med att handelsobjekten kopplas till vår plattform.
Denna uppgift löstes genom att implementera en Kafka-kluster och praktiskt taget helt överge synkron interaktion mellan plattformens mikrotjänster. Detta kräver en mycket noggrann analys av systemets krav, eftersom inte alla operationer kan vara asynkrona. Vi skickar inte bara händelser via en broker, utan överför också all nödvändig affärsinformation i meddelandet. Därför kan storleken på meddelandet uppgå till flera hundra kilobyte. Begränsningen av meddelandestorlek i Kafka kräver att vi exakt kan förutsäga meddelandestorlekar, och vid behov delar vi upp dem, men uppdelningen är logisk och relaterad till affärsoperationer.
Till exempel, för varor som anländer med bil delar vi upp dem i lådor. För synkrona operationer avsätts separata mikrotjänster, och noggranna prestandatester utförs. Användningen av Kafka ställde en annan utmaning för oss — att kontrollera hur vår tjänst fungerar med tanke på integrationen av Kafka gör alla våra enhetstester asynkrona. Denna uppgift löste vi genom att skriva egna tillgängliga metoder med Embedded Kafka Broker. Detta avskaffar inte behovet av att skriva enhetstester för separata metoder, men för komplexa fall föredrar vi att testa med Kafka.
Vi har lagt mycket fokus på loggtracing så att deras TraceId inte går förlorade vid undantag i tjänsternas drift eller vid hantering av Kafka-batchar. Om det första inte orsakade några särskilda frågor, var vi i det andra fallet tvungna att logga alla TraceId som batchen kom med och välja ett för att fortsätta spårningen. Då kan användaren enkelt hitta det ursprungliga TraceId och se vilket spårning som fortsatte.
Uppgift 3. Behovet av att lagra stora mängder data: mer än 1 miljard märkningar per år, bara för tobak, kommer in i X5. Dessa kräver ständig och snabb åtkomst. Totalt ska systemet hantera cirka 10 miljarder poster av datarörelser för märkta varor.
För att lösa den tredje uppgiften valdes NoSQL-databasen MongoDB. Vi har byggt ett sharded kluster med 5 noder, och i varje nod finns en Replica Set med 3 servrar. Detta möjliggör horisontell skalning av systemet genom att lägga till nya servrar i klustret och säkerställa dess fel-tolerans. Här stötte vi på ett annat problem - att säkerställa transaktionalitet i ett mongo-kluster med tanke på användningen av horisontellt skalbara mikrotjänster. Till exempel är en av våra systems uppgifter att upptäcka försök till återförsäljning av varor med samma märkning. Här uppstår problem med felaktiga skanningar eller felaktiga kasörer. Vi har upptäckt att sådana dubbletter kan uppkomma både inom en behandlad Kafka-batch och inom två parallellt behandlade batches. Därför gav kontrollen av dubbletter genom en databasfråga ingenting. För varje mikrotjänst hanterade vi problemet separat baserat på affärslogiken för den tjänsten. Till exempel har vi för kvitton lagt till en kontroll inom batchen och en separat hantering för att upptäcka dubbletter vid insättning.
För att användarnas arbete med transaktionshistorik inte skulle påverka det mest centrala - funktionen av våra affärsprocesser, har vi separerat all historisk data i en särskild tjänst med en särskild databas, som också får information genom Kafka. På så sätt arbetar användarna med en isolerad tjänst utan att påverka de tjänster som hanterar data om aktuella transaktioner.
Uppgift 4. Ombehandling av köer och övervakning:
I distribuerade system uppstår oundvikligen problem och fel med tillgång till databaser, köer och externa datakällor. I fallet med "Markus" är källan till sådana fel integrationen med externa system. Det var nödvändigt att hitta en lösning som skulle möjliggöra omförfrågningar vid felaktiga svar med en viss timeout, men utan att avbryta behandlingen av framgångsrika förfrågningar i den primära kön. För detta valdes den så kallade konceptet "topic based retry". För varje huvudtopic skapas en eller flera retry-topics dit felaktiga meddelanden dirigeras, vilket samtidigt utesluter fördröjning i behandlingen av meddelanden från huvudtoppen. Kommunikationsschemat -
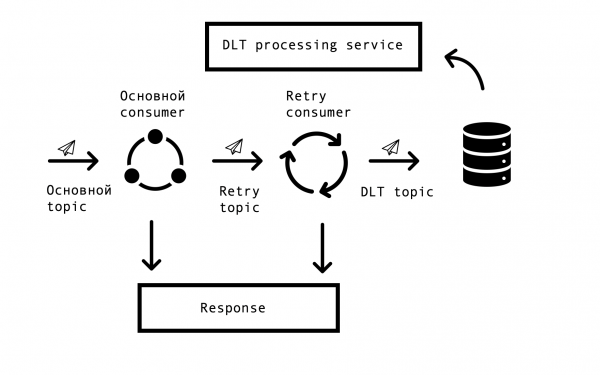
För att genomföra denna lösning behövde vi integrera den med Spring och undvika kodduplicering. Vi stötte på en liknande lösning online, baserad på Spring BeanPostProcessor, men den verkade onödigt tungrodd. Vårt team skapade en enklare lösning som gör det möjligt att integrera med Spring-cykeln för att skapa konsumenter och dessutom lägga till Retry-konsumenter. Prototypen av vår lösning presenterade vi för Spring-teamet, den kan ses . Antalet Retry-konsumenter och antalet försök för varje konsument kan konfigureras via parametrar, beroende på behov inom affärsprocessen, och för att allt ska fungera krävs bara den välkända annoteringen org.springframework.kafka.annotation.KafkaListener som alla Spring-utvecklare känner till.
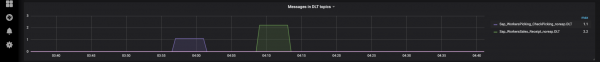
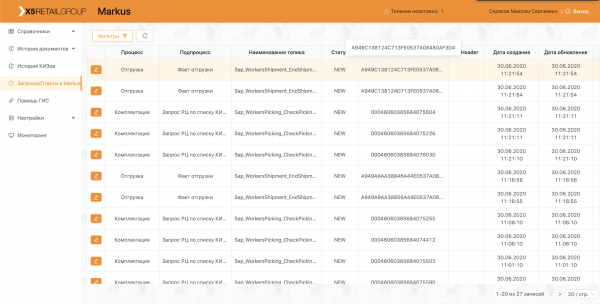
Om ett meddelande inte kunde bearbetas efter alla retry-försök går det till DLT (dead letter topic) med hjälp av Spring DeadLetterPublishingRecoverer. På begäran av supporten utvidgade vi denna funktion och skapade en separat tjänst som gör det möjligt att se meddelanden som hamnat i DLT, stackTrace, traceId och annan nyttig information om dem. Dessutom har övervakning och larm på alla DLT-topiker lagts till, och i dagsläget är ett meddelande i DLT-topiken i stort sett en anledning till att göra en felanmälan. Detta är mycket praktiskt - genom topikens namn förstår vi direkt vilket steg i processen problemet uppstod, vilket avsevärt påskyndar sökandet efter dess rotorsak.
Nyligen implementerade vi ett gränssnitt som gör det möjligt att återigen skicka meddelanden med hjälp av vår support, efter att orsaken till problemen åtgärdats (till exempel återställande av den externa systemets funktionalitet) och givetvis gör en motsvarande felanmälan för analys. Här kom våra self-topiker till nytta, för att inte behöva starta om hela kedjan av bearbetning kan den startas om från det önskade steget.
Drift av plattformen
Plattformen är redan i produktiv drift, varje dag genomför vi leveranser och frakt, samt kopplar nya distributionscentra och butiker. Inom ramen för piloten fungerar systemet med produktgrupperna "Tobak" och "Skor".
Hela vårt team deltar i piloterna, analyserar de problem som uppstår och kommer med förslag på förbättringar av vår produkt, från att förbättra loggar till förändringar i processerna.
För att undvika att upprepa sina misstag återspeglas alla fall som upptäckts under piloten i automatiserade tester. Närvaron av ett stort antal automatiserade tester och enhetstester möjliggör regressionsprovning och att tillämpa en hotfix bokstavligt talat inom några timmar.
Just nu fortsätter vi att utveckla och förbättra vår plattform och stöter ständigt på nya utmaningar. Om du är intresserad kan vi berätta om våra lösningar i kommande artiklar.
Källa: habr.com
