

Loggar är en viktig del av systemet, vilket gör det möjligt att förstå om det fungerar (eller inte fungerar) som förväntat. I en mikroservice-arkitektur blir hanteringen av loggar en separat disciplin av specialolympiaden. Vi måste lösa en mängd frågor:
- hur man skriver loggar från applikationen;
- vart loggar ska skrivas;
- hur man levererar loggar för lagring och behandling;
- hur man hanterar och lagrar loggar.
Användningen av populära containrar idag lägger till ett extra lager av komplexitet på lösa problem.
Just detta handlar föreläsningen av Yuriy Bushmelev "Kartan över hinder i insamling och leverans av loggar"
Den som är intresserad, vänligen läs vidare.
Jag heter Yuriy Bushmelev. Jag arbetar på Lazada. Idag ska jag berätta hur vi har gjort våra loggar, hur vi har samlat dem och vad vi skriver i dem.
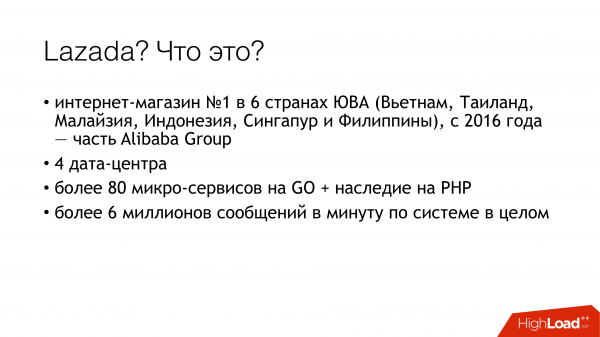
Vart kommer vi ifrån? Vem är vi? Lazada är den största onlinebutiken i sex länder i Sydöstra Asien. Dessa länder är spridda över våra datacenter. Totalt har vi nu 4 datacenter. Varför är det viktigt? För vissa lösningar berodde på att det finns mycket svaga länkar mellan datacentren. Vi har en mikroservice-arkitektur. Jag blev förvånad över att upptäcka att vi redan har 80 mikroservicer. När jag började med loggfrågan fanns det bara 20. Dessutom har vi en ganska stor mängd PHP-leverans som vi också måste leva med. Allt detta genererar för närvarande mer än 6 miljoner meddelanden per minut i systemet totalt. Nästa kommer jag att visa hur vi hanterar detta och varför det är så.
Med dessa 6 miljoner meddelanden måste vi på något sätt hantera dem. Vad ska vi göra med dem? 6 miljoner meddelanden som måste:
- skickas från applikationen
- mottas för leverans
- levereras för analys och lagring.
- analysera
- på något sätt lagra.
När det fanns tre miljoner meddelanden hade jag ungefär en sådan här uppsyn. Eftersom vi började med små summor. Det är klart att apploggar skrivs dit. Till exempel kunde inte ansluta till databasen, kunde ansluta till databasen men kunde inte läsa något. Men förutom detta skriver varje mikrotjänst också en access-logg. Varje förfrågan som kommer till mikrotjänsten hamnar i loggen. Varför gör vi detta? Utvecklarna vill ha möjlighet att spåra. I varje access-logg finns ett fält som heter traceid, vilket gör att ett speciellt gränssnitt kan bryta ner hela kedjan och vackert visa spåret. Spåret visar hur förfrågan har passerat, och det hjälper våra utvecklare att snabbt hantera alla okända problem.
Hur lever man med detta? Nu ska jag kort gå igenom alternativen — hur detta problem i allmänhet löses. Hur man löser uppgiften med insamling, överföring och lagring av loggar.
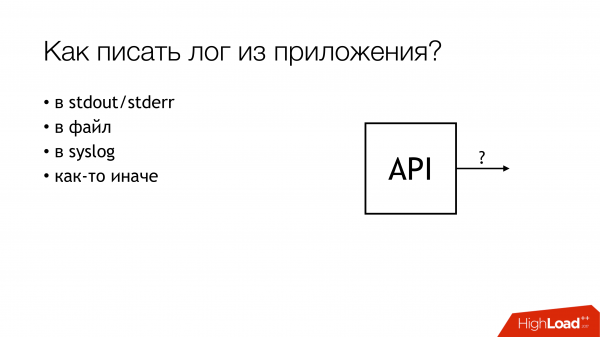
Hur skriver man från applikationen? Det är klart att det finns olika sätt. I synnerhet finns det bästa praxis, som de trendiga personerna berättar för oss. Det finns old school i två versioner, som farbröderna berättade. Det finns andra metoder.
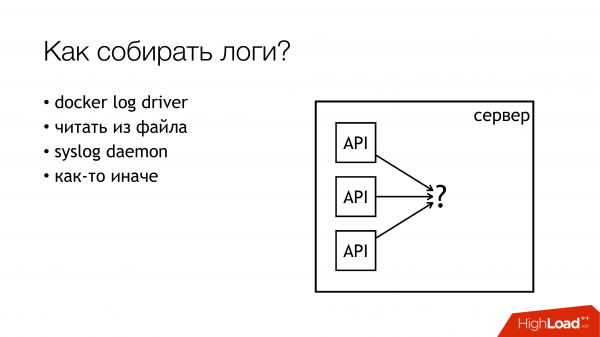
Samma sak gäller insamling av loggar. Alternativen för att lösa just denna del är inte så många. Det finns lite fler än tidigare, men fortfarande inte så många.
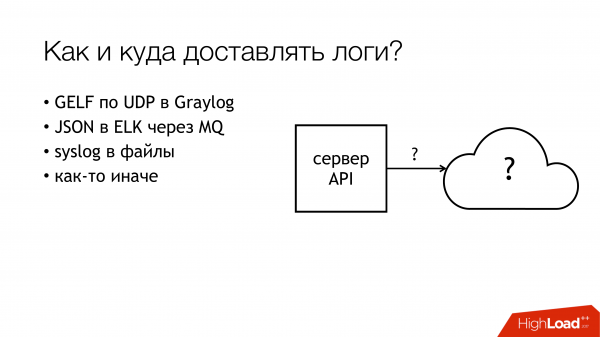
Men när det kommer till leverans och efterföljande analys — antalet variationer börjar skjuta i höjden. Jag kommer inte att beskriva varje alternativ just nu. Jag tror att de viktigaste alternativen är kända för alla som har intresserat sig för ämnet.
Jag ska visa hur vi gjorde detta på Lazada och hur allt faktiskt började.
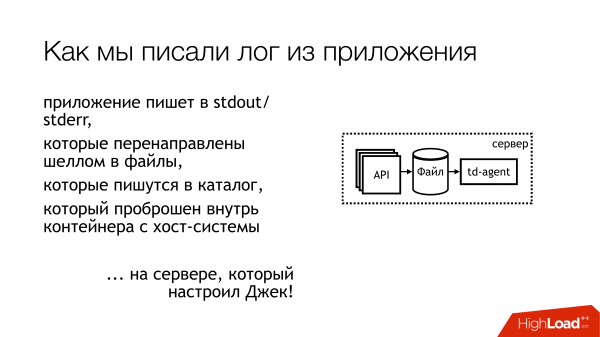
För ett år sedan kom jag till Lazada, och jag blev skickad till ett projekt om loggar. Det var ungefär så här. Loggen från applikationen skrevs till stdout och stderr. Alla gjorde det på det trendiga sättet. Men senare sköts det ut från standardströmmarna, och sedan skulle infrastruktursspecialisterna lösa det. Mellan infrastruktursspecialister och utvecklare finns det också release-specialister som sa: "eh... okej, låt oss bara slå in dem i en fil med shell, och så är det klart". Och eftersom allt detta är i en container, så blev det inkapslat direkt i själva containern, mappades in i katalogen och lades dit. Jag tror att det är ganska uppenbart för alla vad som blev resultatet av detta.
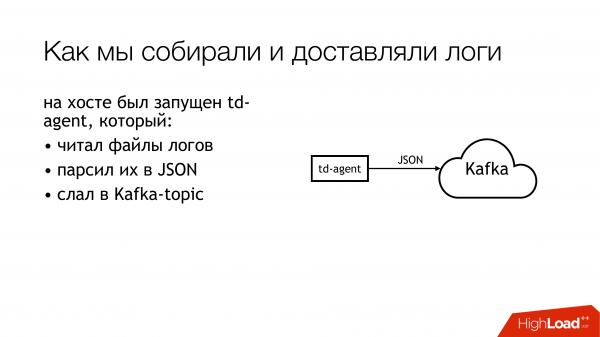
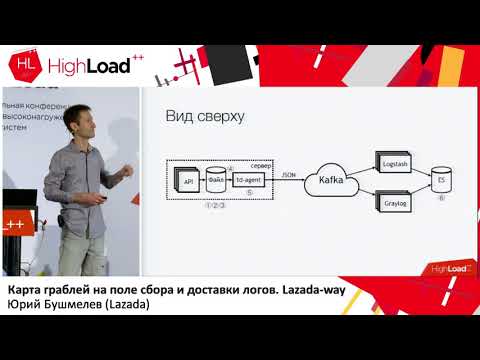
Låt oss titta lite längre fram. Hur vi levererade dessa loggar. Någon valde td-agent, som egentligen är fluentd, men inte riktigt fluentd. Jag förstod aldrig relationen mellan dessa två projekt, men de verkar handla om samma sak. Och denna fluentd, skriven i Ruby, läste loggfiler, parserade dem till JSON med någon slags regex. Sedan skickade den dem till Kafka. Faktum är att vi hade 4 separata ämnen i Kafka för varje API. Varför 4? För att det finns live, det finns staging, och eftersom det finns stdout och stderr. Utvecklarna skapar dem, och infrastructure-teamen måste skapa dem i Kafka. Dessutom kontrollerades Kafka av en annan avdelning. Därför behövde vi skapa en ticket för att de skulle skapa 4 ämnen för varje API. Alla glömde detta. Det var verkligen kaos.
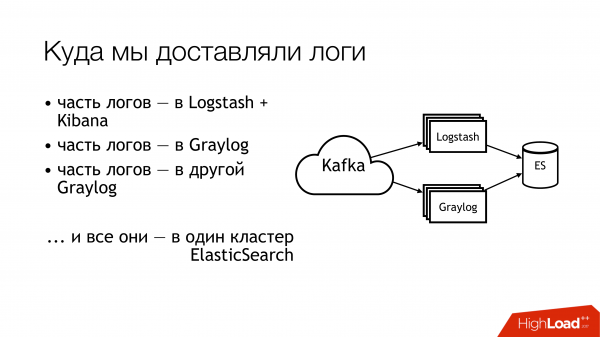
Vad gjorde vi sedan med detta? Vi skickade det till Kafka. Sedan flög hälften av loggarna till Logstash. Den andra hälften av loggarna delades. En del flög till en Graylog, en del till en annan Graylog. Så i slutändan flög allt detta till en Elasticsearch-kluster. Så hela detta kaos hamnade slutligen där. Man ska inte göra så!
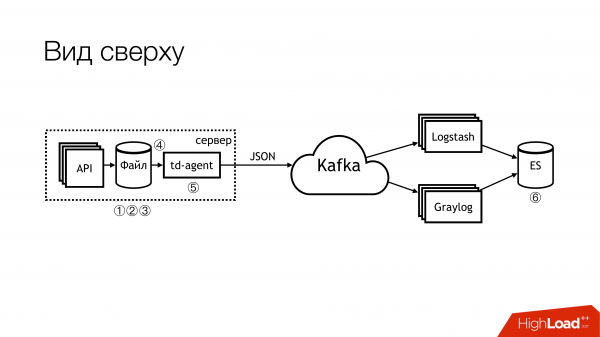
Så här ser det ut om man ser på det från ovan. Man ska inte göra så! Här är problemen direkt markerade med siffror. Det finns faktiskt fler, men 6 — det är verkligen problematiska, med vilka man måste göra något. Jag kommer att berätta mer om dem separat.
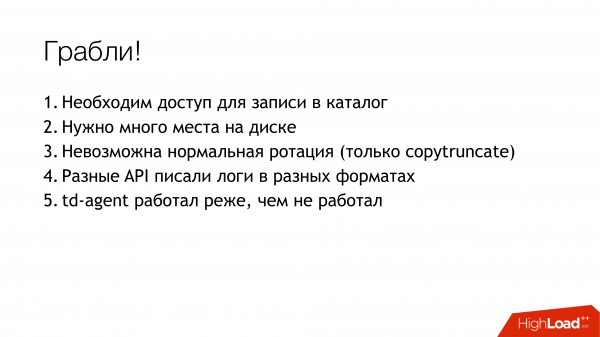
Här (1,2,3) skriver vi filer och, därmed, finns det tre fallgropar direkt.
Första (1) — vi måste skriva dem någonstans. Man skulle inte alltid vilja ge API:et möjligheten att skriva direkt i filen. Det är önskvärt att API:et är isolerat i en container, och ännu bättre – att den är read-only. Jag är systemadministratör, så jag har en lite alternativ syn på dessa saker.
Den andra punkten (2,3) - vi tar emot många förfrågningar i API:et. API:et skriver mycket data till fil. Filerna växer. Vi måste rotera dem. För annars kommer vi inte att ha tillräckligt med diskutrymme. Att rotera dem är dåligt, eftersom de görs med en omdirigering via shell till en katalog. Vi kan inte rotera det. Vi kan inte säga till applikationen att den ska öppna omdeskriptorerna. För utvecklarna skulle se på dig som om du var idiot: "Vilka deskriptorer? Vi skriver överhuvudtaget till stdout." Infrastrukturteknikerna gjorde copytruncate i logrotate, som helt enkelt gör en kopia av filen och trunkerar den ursprungliga. Därför brukar det bli brist på diskutrymme mellan dessa kopieringsprocesser.
(4) Vi hade olika format i olika API:er. De skiljde sig lite åt, men vi behövde skriva olika regexp. Eftersom allt kontrollerades av Puppet, fanns det en stor bunt klasser med sina egna problem. Dessutom kunde td-agent äta mycket minne ibland, hänga sig, och han kunde helt enkelt låtsas som om han arbetade, utan att göra något. Utifrån var det omöjligt att förstå att han inte gjorde något. I bästa fall skulle han krascha, och någon skulle senare starta om honom. Mer exakt, ett larm skulle dyka upp, och någon skulle gå och starta om det manuellt.
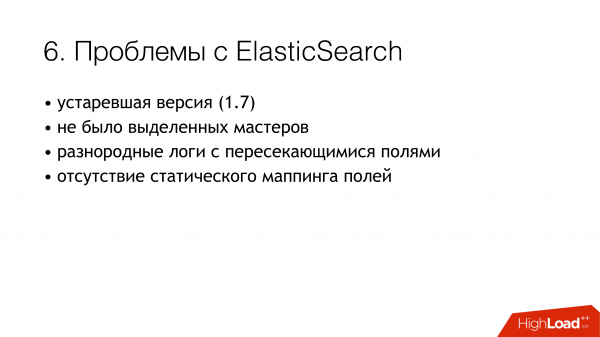
(6) Och den mest kaotiska delen var elasticsearch. För det var en gammal version. För vi hade inte dedikerade masters vid den tiden. Vi hade heterogena loggar, vars fält kunde överlappa. Olika loggar från olika applikationer kunde skrivas med samma fältnamn, men innehållet kunde vara olika. Det vill säga, en logg kommer med ett Integer i fältet, till exempel, level. En annan logg kommer med en String i fältet level. I avsaknad av statisk mapping får vi något fantastiskt. Om ett meddelande som är en sträng kommer först efter indexrotationen i elasticsearch, då fungerar allt normalt. Men om det först kommer med ett Integer, så kommer alla efterföljande meddelanden som kommer med en String helt enkelt att avvisas. För att fälttypen stämmer inte överens.
Vi började ställa oss dessa frågor. Vi bestämde oss för att inte leta efter skulden.
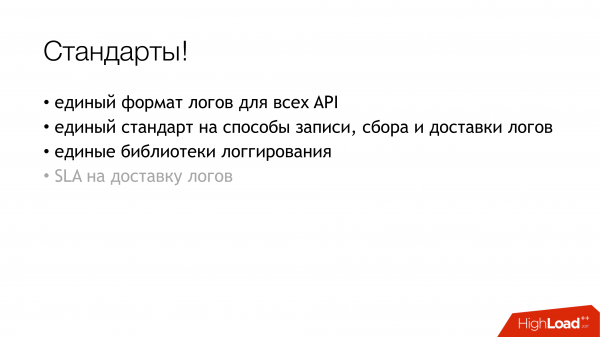
Men vi måste göra något! En uppenbar sak är att vi behöver upprätta standarder. Vi hade redan vissa standarder. Vissa införde vi lite senare. Lyckligtvis hade vi redan godkänt ett gemensamt loggformat för alla API:er vid det tillfället. Det är specificerat direkt i standarderna för tjänsternas interaktion. Därför, de som vill ta emot loggar måste skriva dem i detta format. Om någon inte skriver loggar i detta format, kan vi inte ge några garantier.
Vidare skulle vi vilja införa en enhetlig standard för sätt att skriva, leverera och samla loggar. Det handlar om vart man ska skriva dem och hur man ska leverera dem. Den idealiska situationen är när samma bibliotek används i projekten. Här finns ett separat loggningsbibliotek för Go, ett annat för PHP. Alla vi har — de måste använda dem. För närvarande skulle jag säga att vi når cirka 80 % av detta. Men vissa fortsätter att äta kaktusar.
Och just där (på bilden) börjar 'SLA för leverans av loggar' knappt att framträda. Det finns ännu inte, men vi jobbar på det. För det är mycket praktiskt när infrastrukturen säger att om ni skriver i ett visst format på en viss plats och inte mer än N meddelanden per sekund, så kommer vi med viss sannolikhet att leverera det dit. Det tar bort mycket huvudvärk. Om SLA finns, är det helt fantastiskt!
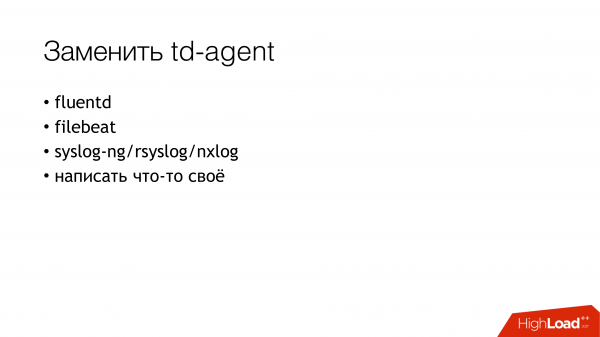
Hur började vi lösa problemet? Den största fallgropen var med td-agent. Det var oklart vart våra loggar försvann. Levereras de? Samlas de? Var är de ens? Därför beslutades det i första hand att byta ut td-agent. Jag har sammanställt några alternativ till vad vi kan byta ut det mot.
Fluentd. För det första, jag har stött på det på mitt tidigare jobb, och det föll också periodiskt där. För det andra, det är samma sak, men bättre anpassat.
Filebeat. Vad gjorde det bekvämt för oss? Eftersom det är gjort i Go, och vi har stor expertis i Go. Således, om det behövs, kunde vi anpassa det till våra behov. Därför valde vi inte det. För att det inte ens skulle finnas frestelse att börja skriva om det.
Ett uppenbart beslut för systemadministratören är olika systemloggar i sådan mängd (syslog-ng/rsyslog/nxlog).
Eller skriva något eget, men det avfärdade vi, liksom filebeat. Om man ska skriva något, är det bättre att skriva något användbart för verksamheten. För att leverera loggar är det bättre att välja något färdigt.
Så valet kom i praktiken att stå mellan syslog-ng och rsyslog. Jag lutade mig mot rsyslog helt enkelt för att vi redan hade klasser för rsyslog i Puppet, och jag hittade ingen uppenbar skillnad mellan dem. Det är syslog här också. Ja, någon har sämre dokumentation, någon annan har bättre. Den ena kan så, den andra på ett annat sätt.
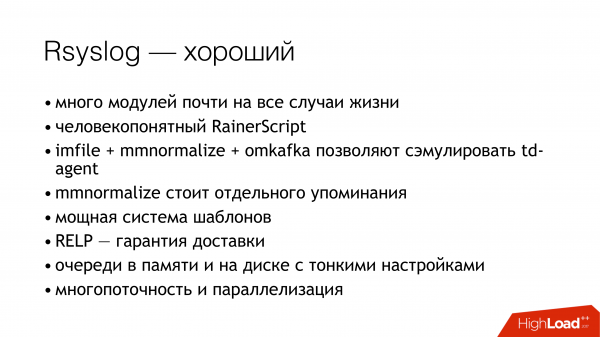
Lite om rsyslog. För det första är det superbra eftersom den har många moduler. Den har ett människovänligt RainerScript (ett modernt konfigurationsspråk). En fantastisk bonus är att vi kunde simulera beteendet hos td-agent med inbyggda medel, och inget förändrades för applikationerna. Det vill säga att vi byter ut td-agent mot rsyslog, utan att röra resten. Och får omedelbart fungerande leverans. Dessutom, mmnormalize — det är en fantastisk grej i rsyslog. Den tillåter att parsa loggar, men inte med Grok och regexp. Den gör en abstrakt syntaxträd. Den parserar loggar ungefär som en kompilator parserar källkoden. Detta gör att det går väldigt snabbt, använder lite CPU, och är helt enkelt en riktigt cool grej. Det finns massor av andra fördelar. Jag kommer inte att stanna vid dem.
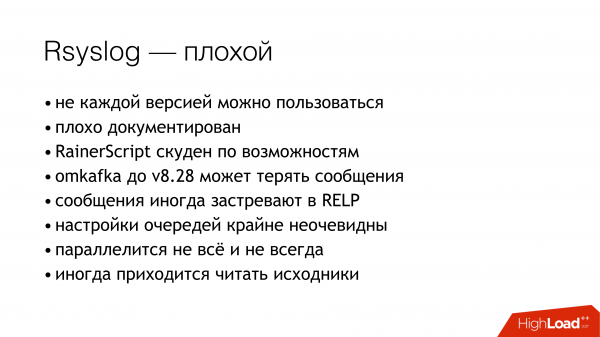
Rsyslog har också en massa nackdelar. De är ungefär desamma som fördelarna. De största problemen är att man måste veta hur man konfigurerar det, och man måste välja version.
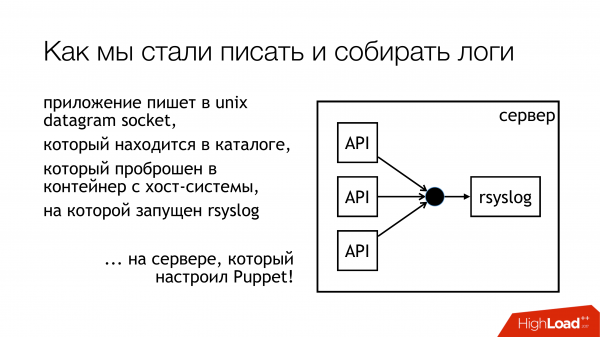
Vi bestämde oss för att skriva loggar i en unix-socket. Och inte i /dev/log, för där har vi en röra av systemloggar, där journald är med i denna pipeline. Så låt oss skriva till en anpassad socket. Vi kopplar den till ett separat ruleset. Vi ska inte blanda ihop något. Allt blir transparent och tydligt. Så gjorde vi. Katalogen med dessa sockets är standardiserad och passeras till alla containrar. Containrarna kan se den socket de behöver, öppna och skriva till den.
Varför inte en fil? För att alla har läst , som försökte passera en fil till docker, och upptäckte att efter en omstart av rsyslog förändras filbeskrivaren, och docker förlorar den filen. Den håller något annat öppet, men inte den socket dit vi skriver. Vi bestämde oss för att vi skulle lösa detta problem, och samtidigt åka runt blockeringen.
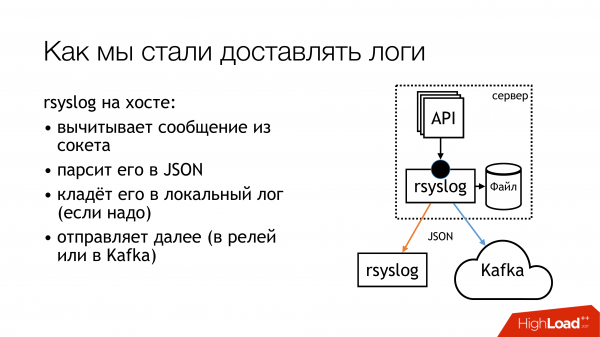
Rsyslog utför åtgärderna som anges på sliden och skickar loggarna antingen till relay eller till Kafka. Kafka motsvarar det gamla sättet. Relay — jag försökte använda ren rsyslog för loggleverans. Utan meddelandekö, med vanliga medel från rsyslog. I princip fungerar det.
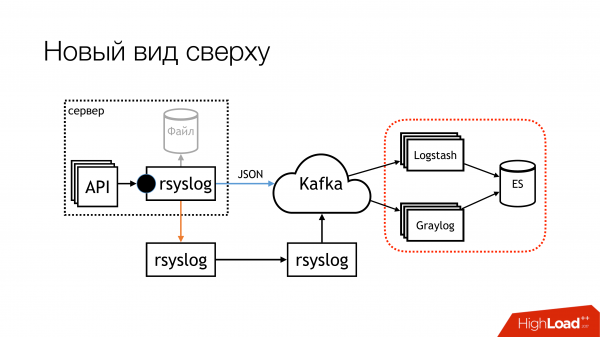
Men det finns nyanser med hur man sedan stoppar dem i denna del (Logstash/Graylog/ES). Denna del (rsyslog-rsyslog) används mellan datacenter. Här är en komprimerad tcp-länk som sparar bandbredd och ökar sannolikheten att vi får loggar från ett annat datacenter under förhållanden när kanalen är överbelastad. För vi har Indonesien, där allt är dåligt. Där är detta ett ständigt problem.
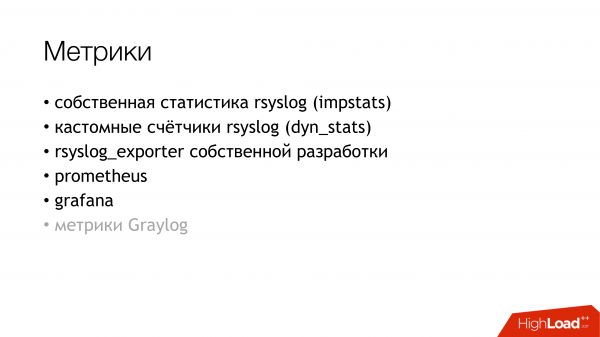
Vi funderade på hur vi faktiskt kan övervaka med vilken sannolikhet loggarna vi skrivit från applikationen når fram till slutet. Vi beslöt oss för att införa metrik. Rsyslog har sin egen statistikinsamlingsmodul som har olika räknare. Till exempel kan den visa storleken på kön, eller hur många meddelanden som kommit in vid en viss åtgärd. Av dessa kan man få fram något. Dessutom har den anpassade räknare som kan konfigureras, och den kommer att visa exempelvis antalet meddelanden som ett visst API skrivit. Vidare skrev jag rsyslog_exporter i Python, och vi skickade allt detta till Prometheus och byggde grafer. Vi hade gärna velat ha Graylog-metrik, men vi har inte hunnit konfigurera dem ännu.
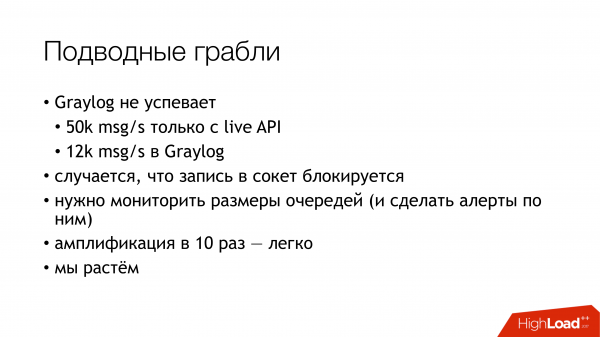
Vilka problem uppstod? Problem uppstod då vi oväntat upptäckte att våra Live API skickade 50 000 meddelanden per sekund. Det är bara Live API utan staging. Och Graylog visar oss bara 12 000 meddelanden per sekund. Och då uppstod den rimliga frågan, var är resten? Från detta drog vi slutsatsen att Graylog helt enkelt inte klarade av det. Vi kollade, och faktiskt, Graylog med Elasticsearch hanterade inte denna belastning.
Vidare, andra insikter som vi gjorde under processen.
Inlägg i socket blockeras. Hur hände detta? När jag använde rsyslog för leverans, så brast kanalen mellan datacentren vid ett tillfälle. Leveransen stannade på ett ställe, leveransen stannade på ett annat ställe. Allt detta nådde maskinen med API:erna, som skriver i rsyslog-socket. Där fylldes kön. Sedan fylldes kön för skrivning till unix socket, som som standard har 128 paket. Och nästa write() i applikationen blockeras. När vi tittade i biblioteket som vi använder i våra Go-applikationer stod det att skrivning till socket sker i icke-blockerande läge. Vi var övertygade om att ingenting blockeras. Eftersom vi läste. , som skrev om detta. Men det finns en punkt. Rundt detta anrop var det också en oändlig slinga där vi ständigt försökte trycka meddelandet i socketen. Det märkte vi inte. Vi fick skriva om biblioteket. Sedan dess har det förändrats flera gånger, men nu har vi blivit av med låsningar i alla delsystem. Därför kan vi stoppa rsyslog utan att något kommer att falla.
Vi måste övervaka storleken på köerna, vilket hjälper oss att undvika dessa problem. För det första kan vi övervaka när vi börjar förlora meddelanden. För det andra kan vi övervaka att vi har problem med leveransen i allmänhet.
Och ytterligare ett obehagligt problem – förstärkning med 10 gånger i mikrotjänarkitekturen – det är extremt enkelt. Vi har inte så många inkommande förfrågningar, men på grund av grafen som dessa meddelanden senare löper på, på grund av access-loggar, ökar vi verkligen belastningen på loggarna med ungefär tio gånger. Jag har tyvärr inte haft tid att räkna ut de exakta siffrorna, men mikrotjänster är så. Det är något man måste ha i åtanke. Just nu är loggsamlingssystemet det mest belastade i Lazada.
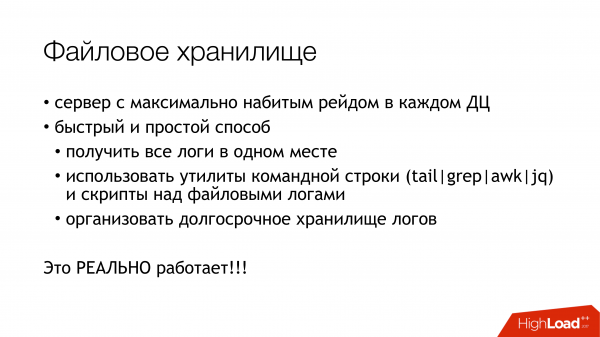
Hur löser man problemet med elasticsearch? Om man snabbt behöver få loggar på ett ställe, så att man inte behöver springa runt på alla maskiner och samla dem där, använd en filbaserad lagring. Det fungerar garanterat. Det görs från vilken server som helst. Man behöver bara stoppa dit diskar och sätta upp syslog. Efter det har ni garanterat alla loggar på ett ställe. Sedan kan man i lugn och ro konfigurera elasticsearch, graylog eller något annat. Men ni kommer redan att ha alla loggar, och dessutom kan ni lagra dem så länge lagringskapaciteten räcker.
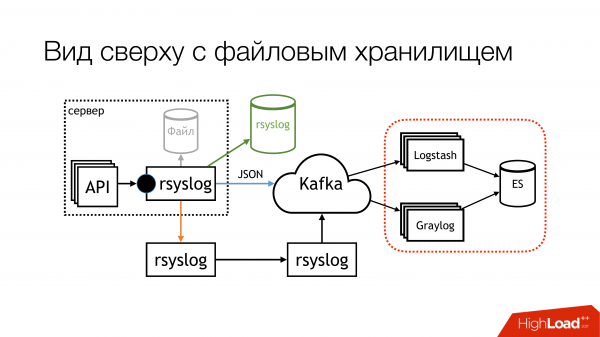
Vid tiden för min presentation såg schemat ut så här. Vi har praktiskt taget slutat skriva till fil. Nu kommer vi förmodligen att stänga av de sista resterna. På de lokala maskiner där API:erna körs kommer vi att sluta skriva till filer. För det första finns det en filbaserad lagringslösning som fungerar mycket bra. För det andra tar det slut på utrymme på dessa maskiner ständigt, och vi behöver övervaka det hela tiden.
Den här delen med Logstash och Graylog är verkligen besvärlig. Därför måste vi bli av med den. Vi måste välja något av det.
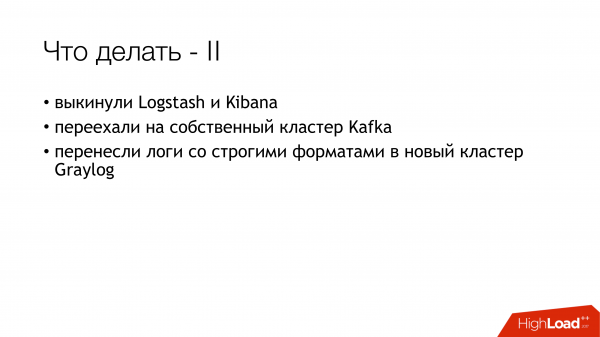
Vi har bestämt oss för att avveckla Logstash och Kibana. För vi har en säkerhetsavdelning. Vad har det med saken att göra? Sambandet är att Kibana utan X-Pack och utan Shield inte tillåter åtkomstkontroll för loggar. Därför valde vi Graylog. Det är inte min favorit, men det fungerar. Vi köpte ny hårdvara, installerade en ny version av Graylog och flyttade alla loggar med strikta format till en separat Graylog. Vi har löst problemet med olika typer av identiska fält organisatoriskt.
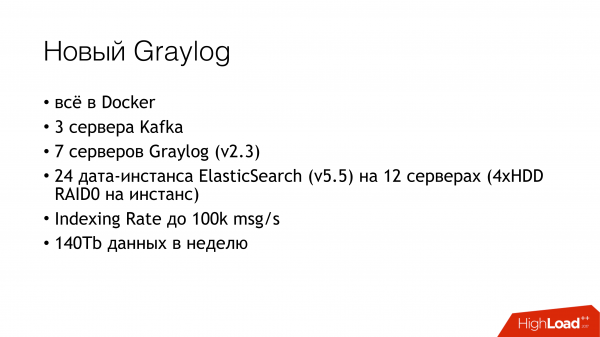
Vad ingår egentligen i den nya Graylog? Vi skrev helt enkelt allt i Docker. Vi tog en massa servrar, distribuerade tre instanser av Kafka, 7 servrar av Graylog version 2.3 (eftersom vi ville ha Elasticsearch version 5). Allt detta kördes på RAID med HDD. Vi såg en indexeringshastighet på upp till 100 000 meddelanden per sekund. Vi såg siffran att 140 terabyte data per vecka.
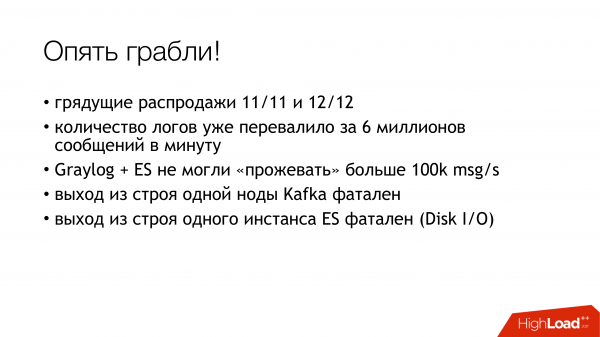
Och så kom motgångarna igen! Vi har två utförsäljningar på gång. Vi har flyttat över 6 miljoner meddelanden. Vår Graylog hinner inte med. Vi måste på något sätt överleva igen.
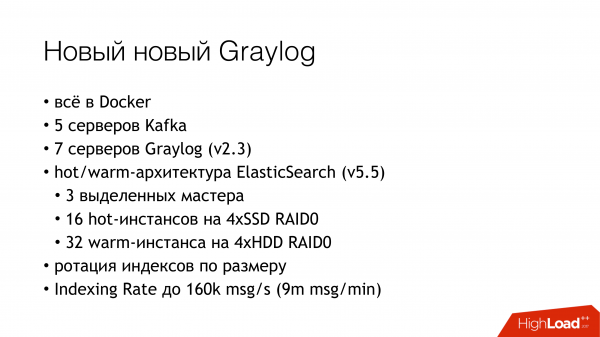
Vi överlevde på följande sätt. Vi lade till några fler servrar och SSD. För tillfället lever vi på det här sättet. Nu bearbetar vi redan 160 000 meddelanden per sekund. Vi har inte nått gränsen än, så det är oklart hur mycket vi verkligen kan dra från detta.
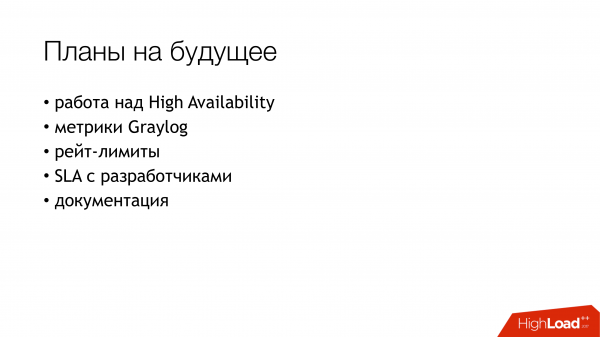
Så här ser våra framtidsplaner ut. Av dem är det sannolikt mest viktiga, hög tillgänglighet. Vi har inte det ännu. Några maskiner är konfigurerade lika, men allt går fortfarande via en maskin. Vi måste ta oss tid att ställa in failover mellan dem.
Samla in metrik från Graylog.
Sätta upp en rate limit så att en överbelastad API inte dödar vår bandbredd och allt annat.
Och slutligen, skriva ett SLA med utvecklarna som anger hur mycket vi kan hantera. Om ni skriver mer, så beklagar jag.
Och skriva dokumentation.
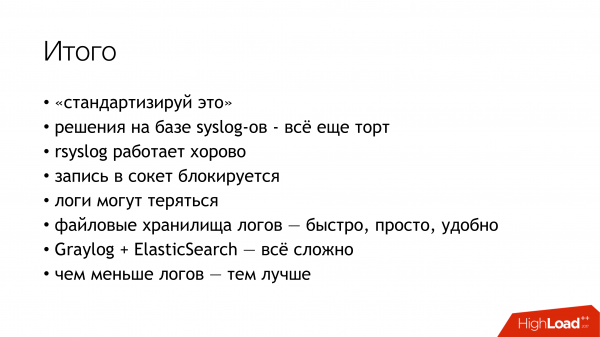
Sammanfattningsvis, resultaten av allt vi har gått igenom. För det första, standarder. För det andra, syslog - en tårta. För det tredje, rsyslog fungerar precis så här som det står på sliden. Låt oss gå vidare till frågorna.
Frågor.
Fråga: Varför beslutade ni att inte använda… (filebeat?)
Svar: Vi måste skriva till en fil. Det ville jag verkligen undvika. När du har en API som skriver tusentals meddelanden per sekund, även om du roterar varje timme, är det fortfarande inte en lösning. Du kan skriva till en pipe. På vilket utvecklarna frågade: "Vad händer om processen vi skriver till kraschar"? Jag kunde helt enkelt inte hitta ett svar och sa: "Okej, låt oss inte göra så."
Fråga: Varför skriver ni inte loggar direkt i HDFS?
Svar: Det är nästa steg. Vi tänkte på det i början, men eftersom vi för närvarande inte har resurser att arbeta med det så ligger det som en långsiktig lösning.
Fråga: Kolumnformatet skulle vara mer lämpligt.
Svar: Jag förstår allt. Vi är helt för det.
Fråga: Ni skriver i rsyslog. Där kan man använda både TCP och UDP. Men om ni använder UDP, hur garanterar ni då leveransen?
Svar: Det finns två aspekter. För det första, jag säger alltid till alla att vi inte garanterar loggar levereras. För när utvecklarna kommer och säger: 'Låt oss börja skriva finansiella data dit, och ni kommer att lagra dem någonstans i fall något händer', svarar vi: 'Utmärkt! Låt oss blockera skrivningen till socket och göra detta i transaktioner så att ni garanterat skriver till vår socket och ser till att vi får det från er sida.' Just i det ögonblicket blir det plötsligt mindre intressant för dem. Och eftersom det inte är intressant, varför skulle vi då ha några frågor? Om ni inte vill garantera skrivning i socket, varför ska vi garantera leverans? Vi gör vårt bästa. Vi försöker verkligen leverera så mycket som möjligt och så bra som möjligt, men vi ger inte 100% garanti. Så för detta, skriv inte finansiella data där. För det finns databaser med transaktioner.
Fråga: När API:t genererar ett meddelande i loggen och överlämnar kontrollen till mikrotjänsterna, har ni då stött på problem med att meddelanden från olika mikrotjänster kommer i fel ordning? Detta kan leda till förvirring.
Svar: Det är normalt att de kommer i olika ordningar. Man måste vara beredd på det. Eftersom vilken nätverksleverans som helst garanterar inte ordningen, eller så måste man avsätta speciella resurser för det. Om vi tar filsystem, så sparar varje API loggar i sin egen fil. Rättare sagt, rsyslog sorterar dem i mappar. Varje API har sina egna loggar, som man kan gå till och se, och sedan kan man matcha dem efter tidsstämpel i den loggen. Om de tittar i Graylog, så sorteras det där efter tidsstämpel. Allt kommer att se bra ut där.
Fråga: Tidsstämpeln kan skilja sig med millisekunder.
Svar: Tidsstämpeln genereras av API:t självt. Det är egentligen hela grejen. Vi har NTP. API:t genererar tidsstämpeln redan i meddelandet. Det är inte rsyslog som lägger till den.
Fråga: Det är inte helt klart hur interaktionen mellan datacentren fungerar. Inom datacentret är det klart hur loggarna samlades och bearbetades. Hur går interaktionen mellan datacentren till? Eller lever varje datacenter sitt eget liv?
Svar: Nästan. Vi har varje land i ett specifikt datacenter. Just nu har vi inget utspritt system, så ett land är inte placerat i olika datacenter. Så det behöver inte kombineras. Inom varje center finns det en Log Relay. Det är en Rsyslog-server. Faktiskt finns det två hanteringsmaskiner. De är konfigurerade på samma sätt. Men just nu går bara trafiken genom en av dem. Den aggregaterar alla loggar. Den har en disk-kö för säkerhets skull. Den komprimerar loggarna och skickar dem till det centrala datacentret (i Singapore), där de sedan skickas till Graylog. Och i varje datacenter finns sin egen fil-lagring. Om vi förlorar kontakten har vi alla loggar där. De stannar där. De kommer att sparas.
Fråga: Får du loggar därifrån vid onormala situationer?
Svar: Man kan gå dit (till fil-lagringen) och kolla.
Fråga: Hur övervakar ni att ni inte förlorar loggar?
Svar: Vi förlorar dem faktiskt, och vi övervakar det. Övervakningen startade för en månad sedan. I biblioteket som används av Go API finns det mätvärden. Den kan räkna hur många gånger den inte kunde skriva till socketen. Just nu finns det en smart heuristik. Det finns en buffert. Den försöker skriva meddelandet från den till socketen. Om bufferten blir full börjar den droppa dem. Och räknar hur många den har droppat. Om räknarna börjar bli fulla får vi veta det. De åker nu också till Prometheus, och i Grafana kan man se grafer. Man kan ställa in aviseringar. Men än så länge är det oklart vem man ska skicka dem till.
Fråga: I Elasticsearch lagrar ni loggar med replikering. Hur många repliker har ni?
Svar: En replik.
Fråga: Det är endast en replik?
Svar: Det är en master och en replik. Data lagras i två exemplar.
Fråga: Har ni justerat storleken på rsyslog-bufferten på något sätt?
Svar: Vi skriver datagram till en anpassad unix socket. Detta begränsar oss till 128 kilobyte. Vi kan inte skriva mer än så. Vi har specificerat detta i standarden. Den som vill lagra data skriver 128 kilobyte. Biblioteken klipper faktiskt och sätter en flagga för att ange att meddelandet har klippts. I vår standard för meddelandet finns det ett speciellt fält som visar om det har klippts vid skrivning eller inte. Så vi har möjlighet att spåra den aspekten också.
Fråga: Skriver du trasig JSON?
Svar: Trasig JSON kommer att kasseras antingen under relay, eftersom paketet är för stort. Eller så kommer Graylog att kassera det eftersom den inte kan parsa JSON. Men det finns nyanser som behöver åtgärdas, och de är mestadels kopplade till rsyslog. Jag har redan fyllt i några problem där som fortfarande behöver arbete.
Fråga: Varför Kafka? Har du provat RabbitMQ? Fungerar inte Graylog under sådana belastningar?
Svar: Vi får inte det att fungera med Graylog. Men Graylog fungerar för oss. Det är verkligen problematiskt. Det är en speciell typ av sak. Och i själva verket behövs den inte. Jag skulle föredra att skriva direkt från rsyslog till elasticsearch och sedan titta på Kibana. Men vi behöver klara upp frågan med säkerhetsansvariga. Det är ett möjligt utvecklingsalternativ för oss, när vi kastar bort Graylog och börjar använda Kibana. Det finns ingen mening med att använda Logstash. För jag kan göra allt detsamma med rsyslog. Och den har en modul för att skriva till elasticsearch. Med Graylog försöker vi på något sätt klara oss. Vi har till och med optimerat den lite. Men det finns fortfarande utrymme för förbättringar där.
Om Kafka. Det har historiskt sett blivit så. När jag kom, fanns den redan, och loggar skrevs redan till den. Vi installerade bara vår kluster och flyttade loggarna dit. Vi hanterar den, vi vet hur den mår. När det gäller RabbitMQ… det fungerar inte riktigt för oss. Men RabbitMQ fungerar för oss. Vi har det i produktion och hade problem med det. Nu skulle vi ha fixat det innan försäljningen, och det började fungera ordentligt. Men innan det var jag inte redo att lansera det i produktion. Det finns ytterligare en punkt. Graylog kan läsa version AMQP 0.9, medan rsyslog kan skriva version AMQP 1.0. Det finns inget lösning som kan både och. Antingen det ena eller det andra. Så just nu är det bara Kafka. Men där finns också sina nuanser. För omkafka av den versionen av rsyslog som vi använder kan förlora hela meddelandebufferten som den har fått från rsyslog. För tillfället får vi leva med det.
Fråga: Använder ni Kafka för att den redan fanns hos er? Används den inte till några andra syften?
Svar: Kafka som fanns, används av Data Science-teamet. Det är ett helt eget projekt som jag tyvärr inte kan säga något om. Jag är inte insatt. Den var under Data Science-teamets ansvar. När loggarna startades så beslutades det att använda den för att inte behöva installera en egen. Nu har vi uppdaterat Graylog, och vi har förlorat kompatibiliteten eftersom det är en gammal version av Kafka. Vi var tvungna att skapa vår egen. Samtidigt blev vi av med de fyra ämnena för varje API. Vi gjorde ett brett ämne för alla live, ett brett ämne för alla staging och skickade allt dit. Graylog extraherar allt detta parallellt.
Fråga: Varför behövs detta trixande med sockets? Har ni försökt använda syslog-loggdrivrutinen för containrar?
Svar: Vid den tidpunkten när vi ställde oss frågan var vår relation till Docker ansträngd. Det var Docker 1.0 eller 0.9. Docker var i sig själv märkligt. För det andra, om man dessutom skulle få in loggar... Jag har en obekräftad misstanke om att den släpper igenom alla loggar via Docker-demonen. Om ett API får problem stötter de andra API:erna på att de inte kan skicka stdout och stderr. Jag vet inte vart detta leder. Jag har en känslomässig misstanke om att vi inte borde använda Docker-syslog-drivrutinen just här. Vår avdelning för funktionell testning har sin egna lille Graylog-kluster med loggar. De använder Docker-loggdrivrutiner och de verkar ha det ganska bra. Men de skriver direkt till Graylog i GELF-format. Vid den tidpunkten när vi startade allt detta behövde vi att det helt enkelt skulle fungera. Kanske senare, när någon kommer och säger att det har fungerat bra i hundra år, kommer vi att prova.
Fråga: Gör ni leverans mellan datacentren med rsyslog? Varför inte med Kafka?
Svar: Vi gör faktiskt både och. Av två skäl. Om kanalen är helt förstörd går inte ens alla loggar i komprimerad form igenom den. Och Kafka tillåter oss att förlora dem under processen. På så sätt slipper vi fastna i dessa loggar. I det här fallet använder vi Kafka direkt. Om vi har en bra kanal och vill frigöra den använder vi rsyslog. Men man kan faktiskt konfigurera det så att det själv släpper det som inte går igenom. För tillfället använder vi på vissa ställen leverans med rsyslog direkt och på andra ställen Kafka.
Källa: habr.com
