

Pavel Selivanov, lösningsarkitekt på Southbridge och lärare på Slyrm, höll en presentation på DevOpsConf 2019. Denna presentation är en del av en av temi fördjupad kurs om Kubernetes "Slyrm Mega".
ä skriven i Moskva 18-20 november.
— Moskva, 22-24 november.
finns alltid tillgänglig.
Under läsningen finns transkriptionen av presentationen.
God dag, kollegor och stödjande åhörare. Idag kommer jag att prata om säkerhet.
Jag ser att det finns många säkerhetsproffs här idag. Jag ber om ursäkt i förväg om jag använder termer från säkerhetsvärlden på ett sätt som inte är helt standard för er.
För ungefär ett halvår sedan fick jag tillgång till ett offentligt Kubernetes-kluster. Offentligt betyder att det finns ett visst antal namnrymder där användare är isolerade i sina egna namnrymder. Alla dessa användare tillhör olika företag. Tanken var att detta kluster skulle användas som CDN. Det vill säga, ni får klustret, får en användare in i ert namnrum, och ni kommer för att distribuera era frontend.
Mitt tidigare företag försökte sälja en sådan tjänst. Jag blev ombedd att undersöka klustret för att se om denna lösning var lämplig eller inte.
Jag gick in i detta kluster. Jag fick begränsade rättigheter, begränsad namnrymd. Där förstod killarna vad säkerhet innebar. De hade läst om Rollbaserad åtkomstkontroll (RBAC) i Kubernetes — och de hade konfigurerat det så att jag inte kunde köra pods separat från deployeringar. Jag minns inte uppgiften som jag försökte lösa genom att köra en pod utan en deployering, men jag ville verkligen bara köra en pod. Jag beslöt mig för att kolla vilka rättigheter jag hade i klustret, vad jag kunde och inte kunde göra, och vad de hade ställt till med. Jag kommer också att berätta att deras RBAC var felkonfigurerat.
Det hände sig att efter två minuter hade jag blivit administratör för deras kluster, jag tittade i alla angränsande namnrymder och såg aktiva produktionsfronter från företag som redan köpt tjänsten och hade distribuerat sina system. Jag fick svårt att inte gå in på någon av sidorna och placera något olämpligt ord på förstasidan.
Jag kommer att berätta med exempel hur jag gjorde detta och hur man skyddar sig mot det.
Men jag ska först presentera mig. Jag heter Pavel Selivanov. Jag är arkitekt på Southbridge. Jag har kunskaper inom Kubernetes, DevOps och diverse moderna grejer. Tillsammans med ingenjörerna på Southbridge bygger vi detta, och jag ger rådgivning.
Förutom vår huvudverksamhet har vi nyligen lanserat projekt som kallas Slërmy. Vi försöker sprida vår förmåga att arbeta med Kubernetes och lära andra att också arbeta med K8s.
Vad jag kommer att prata om idag. Temat för presentationen är helt klart — säkerheten i Kubernetes-kluster. Men jag vill genast säga att detta ämne är mycket stort — och därför vill jag direkt klargöra vad jag definitivt inte kommer att diskutera. Jag kommer inte att prata om klichéer som redan har diskuterats hundratals gånger på internet. Sådana saker som RBAC och certifikat.
Jag kommer att berätta om de saker som mig och mina kollegor bekymrar inom säkerheten i Kubernetes-kluster. Vi ser dessa problem hos både leverantörer som tillhandahåller Kubernetes-kluster och hos kunder som kommer till oss. Och till och med hos kunder som kommer till oss från andra konsultadministrationsföretag. Det vill säga, tragedins omfattning är faktiskt mycket stor.
Jag kommer idag att diskutera tre punkter:
- Användarrättigheter vs pod-rättigheter. Användarrättigheter och pod-rättigheter är inte samma sak.
- Informationsinsamling om klustret. Jag kommer att visa vad som kan samlas in från klustret, som kan behövas utan särskilda rättigheter i detta kluster.
- DoS-attack mot klustret. Om vi inte kan samla in information kan vi ändå slå ut klustret. Jag kommer att berätta om DoS-attacker mot klusterhanteringskomponenterna.
En annan allmän sak som jag kommer att nämna — vad jag testade detta på, vad jag definitivt kan säga fungerar.
Vi baserar oss på installationen av Kubernetes-klustret med Kubespray. Om någon inte vet, så är detta i princip ett set av roller för Ansible. Vi använder det konstant i vårt arbete. Det är bra eftersom det kan användas överallt — både på fysiska serverar och i molnet. En installationsmetod passar i princip för allt.
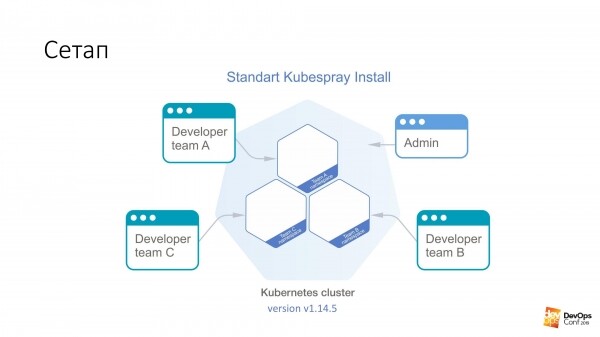
I detta kluster kommer jag att ha Kubernetes v1.14.5. Hela klustret av Kubernetes, som vi ska titta på, är uppdelat i namnområden, där varje namnområde tillhör ett separat team och endast medlemmarna i det teamet har tillgång till sitt eget namnområde. De kan inte gå in i andra namnområden. Men det finns ett administratörskonto som har rättigheter för hela klustret.
Jag lovade att det första vi ska göra är att få administrativa rättigheter till klustret. Vi behöver en speciellt förberedd pod som kommer att bryta klustret Kubernetes. Det enda vi behöver göra är att tillämpa den i klustret Kubernetes.
kubectl apply -f pod.yamlDenna pod kommer att landa på en av masternoderna i klustret Kubernetes. Klustret kommer glatt att returnera en fil som heter admin.conf. I denna fil lagras alla certifikat för administratören, och dessutom är API:et för klustret konfigurerat. Så enkelt kan man få administrativ åtkomst, jag tror till 98% av Kubernetes-kluster.
Jag upprepar, denna pod skapades av en utvecklare i ert kluster, som har tillgång att distribuera sina förslag i ett litet namnområde, där allt är begränsat av RBAC. Han hade inga rättigheter. Men ändå kom certifikatet tillbaka.
Nu, om den specialförberedda podden. Låt oss köra den på valfri bild. Som exempel tar vi debian:jessie.
Vi har något sådant här:
tolerations:
-   effect: NoSchedule
    operator: Exists
nodeSelector:
    node-role.kubernetes.io/master: ""
Vad är tolerans? Masternoderna i Kubernetes-klustret är vanligtvis markerade med något som kallas taint ("smitta" på engelska). Poängen med denna "smitta" är att poddar inte får tilldelas till masternoder. Men ingen hindrar en pod från att ange att den är tolerant mot "smittan". Sektionen Toleration säger just att om det finns NoSchedule på en nod, så är vår pod tolerant mot denna smitta — och inga problem uppstår.
Vidare säger vi att vår pod inte bara är tolerant, utan också vill hamna speciellt på mastern. För på mastern finns det det mest attraktiva som vi behöver — alla certifikat. Så vi specificerar nodeSelector — och vi har en standardetikett på mastern som gör att vi kan välja just de noder i klustret som är masters.
Med dessa två sektioner kommer podden garanterat att hamna på mastern. Och den kommer att få bo där.
Men det är inte tillräckligt att bara komma till mastern. Det kommer inte att ge oss något. Så här följer två saker:
hostNetwork: true
hostPID: true
Vi anger att vår podd, som vi kör, kommer att leva i kärnans namnutrymme, i nätverksnamnutrymmet och i PID-namnutrymmet. Så snart podden startar på mastern, kommer den att kunna se alla riktiga, levande gränssnitt på denna nod, lyssna på all trafik och se PID för alla processer.
Därefter är det enkelt. Ta etcd och läs vad du vill.
Det mest intressanta är denna funktion i Kubernetes, som är där som standard.
volumeMounts:
- mountPath: /host
  name: host
volumes:
- hostPath:
    path: /
    type: Directory
  name: host
Och poängen är att vi kan i podden, som vi kör, även utan rättigheter i denna kluster, säga att vi vill skapa ett volume av typen hostPath. Det betyder att vi tar vägen från värden vi kommer att docka — och tar det som ett volume. Vi kallar det sedan name: host. Hela denna hostPath monteras inuti podden. I detta exempel i katalogen /host.
Jag upprepar. Vi har sagt till podden att åka till mastern, få hostNetwork och hostPID — och montera hela root på mastern inuti denna pod.
Du förstår att vi har bash igång i Debian, och denna bash körs under root. Så vi har just fått root på mastern, utan att ha några rättigheter i Kubernetes-klustret.
Därefter är hela uppgiften att gå in i podden i katalogen /host /etc/kubernetes/pki, om jag inte minns fel, ta alla mastercertifikat från klustret och därmed bli administratör av klustret.
Om man ser det så här, är dessa en av de mest farliga rättigheterna i poddar — oavsett vilka rättigheter användaren har:
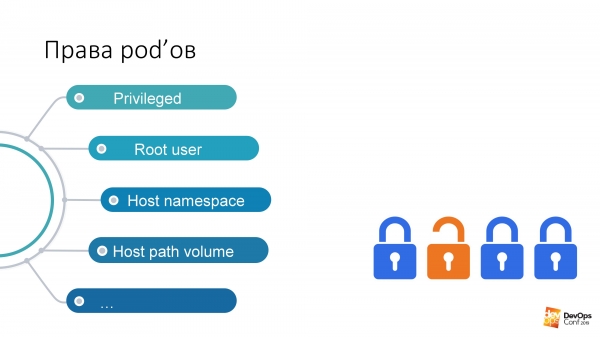
Om jag har rätt att köra en podd i något namnutrymme i klustret, så har denna podd dessa rättigheter som standard. Jag kan köra privilegierade poddar, och det betyder i princip alla rättigheter, nästan root på noden.
Min favorit — Root-användare. Och Kubernetes har en sådan alternativ Run As Non-Root. Detta är en sorts skydd mot hackare. Vet du vad en "moldavisk virus" är? Om du plötsligt är en hackare och har kommit in i mitt Kubernetes-kluster, så ber vi, de stackars administratörerna: "Ange snälla i dina poddar, med vilka du planerar att hacka mitt kluster, run as non-root. Annars kan det hända att du kör en process i din podd som root, och det blir väldigt enkelt för dig att hacka mig. Skydda dig själv, snälla."
Host path volume — enligt min åsikt, det snabbaste sättet att få det önskade resultatet från Kubernetes-klustret.
Men vad ska man göra med allt detta?
Tankar som varje normal administratör som stöter på Kubernetes bör ha: "Aha, jag sa ju att Kubernetes inte fungerar. Den har hål. Och hela Kubernetes är skräp." I verkligheten finns det något som heter dokumentation, och om man tittar dit så finns det ett avsnitt. .
Detta är ett yaml-objekt - vi kan skapa det i Kubernetes-klustret - som kontrollerar säkerhetsaspekter specifikt i beskrivningen av poddar. Det innebär att den faktiskt kontrollerar rättigheter för användning av olika hostNetwork, hostPID, vissa typer av volymer som finns i poddar vid start. Med hjälp av Pod Security Policy kan allt detta beskrivas.
Det mest intressanta med Pod Security Policy är att i Kubernetes-klustret är alla PSP-installationer egentligen inte beskrivna på något sätt, de är helt enkelt avstängda som standard. Pod Security Policy aktiveras med hjälp av en admission plugin.
Okej, vi ska deploya Pod Security Policy i klustret och säga att vi har vissa tjänstepoddar i ett namespace som bara administratörer har åtkomst till. Låt oss säga att i alla andra poddar har man begränsade rättigheter. Eftersom det troligen inte är nödvändigt för utvecklarna att köra privilegierade poddar i ert kluster.
Och vi har tydligen allt i ordning. Och vårt Kubernetes-kluster kan inte hackas på två minuter.
Det finns ett problem. Troligen om ni har ett Kubernetes-kluster, så har ni också övervakning installerad. Jag vågar till och med förutspå att om det finns övervakning i ert kluster så kallas den Prometheus.
Det jag nu ska berätta gäller både Prometheus-operatören och Prometheus installerad i sin rena form. Frågan är att om jag inte kan få en administratör så snabbt i klustret, betyder det att jag måste leta mer. Och jag kan leta med hjälp av er övervakning.
Förmodligen har alla läst samma artiklar på Habré, och övervakningen finns i namespace monitoring. Helm-diagrammet heter ungefär detsamma för alla. Jag antar att om ni gör helm install stable/prometheus, så får ni ungefär samma namn. Och det är till och med troligt att DNS-namnet i ert kluster inte behöver gissas. Eftersom det är standard.
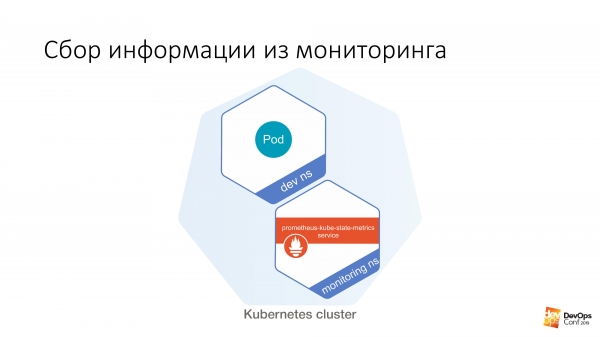
Sedan har vi ett visst dev-namespac, i vilket man kan starta en viss pod. Och därifrån är det mycket lätt att göra så här:
$ curl http://prometheus-kube-state-metrics.monitoring prometheus-kube-state-metrics är en av Prometheus-exportörerna som samlar in mätdata från Kubernetes API:et. Det finns en mängd information om vad som körs i din kluster, hur det ser ut och vilka problem du har med det.
Som ett enkelt exempel:
kube_pod_container_info{namespace="kube-system",pod="kube-apiserver-k8s-1",container="kube-apiserver",image=
"gcr.io/google-containers/kube-apiserver:v1.14.5"
,image_id="docker-pullable://gcr.io/google-containers/kube-apiserver@sha256:e29561119a52adad9edc72bfe0e7fcab308501313b09bf99df4a9638ee634989",container_id="docker://7cbe7b1fea33f811fdd8f7e0e079191110268f2853397d7daf08e72c22d3cf8b"} 1
Genom att göra en enkel curl-förfrågan från en icke-privilegerad pod kan du få sådan information. Om du inte vet vilken version av Kubernetes du kör så kan den enkelt berätta det för dig.
Och det mest intressanta är att förutom att du kontaktar kube-state-metrics kan du lika gärna nå själva Prometheus direkt. Du kan samla in mätdata därifrån. Du kan till och med bygga mätdata därifrån. Teoretiskt sett kan du konstruera en sådan förfrågan från klustret till Prometheus som helt enkelt slår av det. Och din övervakning kommer helt att sluta fungera.
Och här uppstår frågan, övervakar någon extern övervakning din övervakning? Jag fick just möjligheten att agera i Kubernetes-klustret helt utan konsekvenser för mig själv. Du kommer inte ens att veta att jag är där eftersom övervakningen redan är borttagen.
Precis som med PSP finns känslan av att problemet är att alla dessa trendiga teknologier — Kubernetes, Prometheus — helt enkelt inte fungerar och är fyllda med hål. Det är faktiskt inte så.
Det finns något som kallas — .
Om du är en vanlig admin vet du sannolikt att Network Policy är ännu en yaml, av vilka det redan finns gott om i klustret. Och vissa Network Policies är verkligen inte nödvändiga. Även om du har läst vad en Network Policy är, att den är en yaml-brandvägg för Kubernetes, som gör det möjligt att begränsa åtkomsträttigheter mellan namespaces, mellan pods, så har du säkert kommit fram till att en brandvägg i yaml-format i Kubernetes är ytterligare en abstraktion… Nej, det behövs verkligen inte.
Även om era säkerhetsspecialister inte har berättat att ni kan bygga en mycket enkel och granulär brandvägg med hjälp av er Kubernetes, behöver ni i alla fall Network Policy för att stänga åtkomst till vissa känsliga platser som kan nås från er kluster utan någon autentisering.
Som i exemplet jag nämnde kan man nå kube state metrics från vilket namnrum som helst i Kubernetes-klustret utan att ha några rättigheter. Network policies stängde åtkomst från alla andra namnrum till övervakningsnamnrymden, och så är det: ingen åtkomst, inga problem. I alla diagram som finns, både i standard Prometheus och det Prometheus som finns i operatören, finns det helt enkelt ett alternativ att aktivera nätverkspolicys för dem i values-filen i Helm. Det är bara att aktivera, så fungerar de.
Det finns dock ett problem med detta. Som en erfaren administratör har ni förmodligen kommit fram till att nätverkspolicys inte är nödvändiga. Och efter att ha läst olika artiklar på resurser som Habr, har ni beslutat att flannel, särskilt i host-gateway-läget, är det bästa alternativet ni kan välja.
Vad göra?
Ni kan försöka omdeplaera den nätverkslösning som ni har i ert Kubernetes-kluster och byta ut den mot något mer funktionellt. Kanske Calico, till exempel. Men jag vill genast påpeka att det är en ganska komplicerad uppgift att byta nätverkslösning i ett aktivt Kubernetes-kluster. Jag har löst det två gånger (båda gångerna, faktiskt, teoretiskt), men vi visade till och med på Slurm hur man gör. För våra studenter visade vi hur man byter nätverkslösning i ett Kubernetes-kluster. Ni kan i princip försöka göra det så att det inte blir någon driftstopp i produktionsklustret. Men det är troligt att ni misslyckas.
Och problemet går faktiskt att lösa ganska enkelt. I klustret finns det certifikat, och ni vet att certifikaten kommer att gå ut om ett år. Det normala tillvägagångssättet med certifikat i klustret är att vi sätter upp ett nytt kluster bredvid, låter det gamla gå ut, och allt deployas om. Visserligen kommer det gamla klustret att ligga stilla i en hel dag när det går ut, men då har vi åtminstone det nya klustret.
När ni sätter upp det nya klustret, se till att inkludera Calico istället för flannel.
Vad ska man göra om dina certifikat är utfärdade på hundra år och du inte tänker omdeploya klustret? Det finns något som heter Kube-RBAC-Proxy. Det är en riktigt fantastisk lösning som låter dig integrera den som en sidecar-container i valfri podd i Kubernetes-klustret. Den tillför i praktiken autentisering via RBAC i själva Kubernetes.
Det finns ett problem. Tidigare var Kube-RBAC-Proxy integrerat i Prometheus-operatorn. Men det finns inte längre. Nu kör moderna versioner på att du har en nätverkspolicy som stänger av åtkomst med hjälp av dem. Därför måste du ändra diagrammet lite grann. Om du går in i , hittar du exempel på hur man använder det som sidecars, och diagrammen måste ändras minimalt.
Det finns även ett litet problem till. Inte bara Prometheus levererar sina mätvärden till vem som helst. Alla komponenter i Kubernetes-klustret kan också leverera sina egna mätvärden.
Men som jag redan har nämnt, om du inte kan få åtkomst till klustret och samla information, kan du åtminstone skada det.
Så jag ska snabbt visa två sätt att förstöra hälsan på ett Kubernetes-kluster.
Du kommer att skratta när jag berättar detta, det är två fall från verkliga livet.
Metod ett. Resursutarmning.
Vi startar en särskild podd. Den kommer att ha en sektion som ser ut så här.
resources:
    requests:
        cpu: 4
        memory: 4Gi
Som du vet är requests den mängd CPU och minne som reserveras på värden för specifika poddar med requests. Om vi har en fyrkärnig värd i Kubernetes-klustret, och det finns en podd med fyra CPU i requests, betyder det att ingen annan podd med requests kan åka dit.
Om jag startar en sådan podd och sedan kör kommandot:
$ kubectl scale special-pod --replicas=...Då kan ingen annan deploya i Kubernetes-klustret. Eftersom alla noder får slut på requests. På så sätt kan jag stoppa ditt Kubernetes-kluster. Om jag gör detta på kvällen kan jag stoppa deployerna ganska länge.
Om vi tittar igenom Kubernetes-dokumentationen så ser vi något som kallas Limit Range. Det sätter resursgränser för klusterobjekt. Du kan skriva ett Limit Range-objekt i yaml, tillämpa det på specifika namespaces — och sedan kan du ange att du har standard-, maximal- och minimalresurser för pods i det namnet.
Med den här funktionen kan vi begränsa användare i specifika produktnamn för team när det gäller att ange oönskade resurser för sina pods. Men tyvärr, även om du informerar användaren att de inte får starta pods med begärningar som överstiger en CPU, finns det en fantastisk skala-kommando, eller via dashboarden kan de utföra skalan.
Och härifrån kommer sätt nummer två. Vi startar 11 111 111 111 111 pods. Det är elva miljarder. Detta är inte för att jag hittade på det numret, utan för att jag själv har sett det.
En sann historia. Sent på kvällen var jag redo att lämna kontoret. Jag såg en grupp utvecklare sitta i ett hörn och göra något hektiskt med sina laptops. Jag gick fram till killarna och frågade: "Vad har hänt?"
Lite tidigare, vid nio på kvällen, var en av utvecklarna på väg hem. Han bestämde sig: "Jag ska skala min applikation till en." Han tryckte på enan, men internet blev lite segt. Han tryckte en gång till på enan, han tryckte på enan, klickade på Enter. Han tryckte på allt han kunde. Då blev internet snabbt igen — och allt började skala till det numret.
Men detta hände inte på Kubernetes, då var det Nomad. Detta slutade med att efter en timmes försök att stoppa Nomad från att insistera på att skala, svarade Nomad att den inte skulle sluta skala och inte skulle göra något annat. "Jag är trött, jag går". Och låg ner.
Självklart försökte jag göra detsamma på Kubernetes. Elva miljarder pods gjorde Kubernetes besviken, den sa: "Jag kan inte. Överskrider interna gränser." Men 1 000 000 000 pods gick att skapa.
Som svar på en miljard Pods har Kubernetes inte stängt av sig själv. Det började verkligen skala. Ju längre processen fortskred, desto mer tid krävdes för att skapa nya Pods. Men processen fortsatte ändå. Det enda problemet är att om jag kan starta Pods utan begränsningar i mitt namnrymd, så kan jag, även utan requests och begränsningar, starta så många Pods med olika uppgifter att noderna börjar lagra minne och CPU-resurser. När jag startar så många Pods, måste informationen från dem lagras, det vill säga i etcd. Och när för mycket information når lagringen, börjar den att ge ut data för långsamt — och Kubernetes får problem.
Och en ytterligare problem… Som ni vet, är Kubernetes kontrollkomponenter inte en enskild central enhet, utan flera komponenter. Där finns bland annat controller manager, scheduler och så vidare. Alla dessa komponenter kommer att börja utföra onödigt arbete samtidigt, vilket med tiden kommer att ta mer och mer tid. Controller manager kommer att skapa nya Pods. Scheduler kommer att försöka hitta nya noder åt dem. Nya noder i din kluster kommer sannolikt att ta slut snart. Kubernetes-klustret kommer att börja arbeta långsammare och långsammare.
Men jag bestämde mig för att gå ännu längre. Som ni vet finns det något i Kubernetes som kallas en tjänst. Och som standard fungerar tjänsten i era kluster, sannolikt, med hjälp av IP-tables.
Om man startar en miljard Pods, till exempel, och sedan med hjälp av ett skript får Kubernetes att skapa nya tjänster:
for i in {1..1111111}; do
    kubectl expose deployment test --port 80
        --overrides="{"apiVersion": "v1",
           "metadata": {"name": "nginx$i"}}";
done
På alla noder i klustret kommer nya IP-tables regler att genereras nästan samtidigt. Dessutom kommer en miljard IP-tables regler att genereras för varje tjänst.
Jag har testat detta med några tusen, upp till ett tiotal. Problemet är att det redan på denna nivå är ganska problematiskt att göra en SSH-anslutning till en nod. Eftersom paketen, som passerar genom så många kedjor, inte mår så bra.
Och detta löses också med hjälp av Kubernetes. Det finns ett objekt som heter Resource quota. Det fastställer antalet tillgängliga resurser och objekt för namnområdet i klustret. Vi kan skapa en yaml-objekt i varje namnområde i Kubernetes-klustret. Med hjälp av detta objekt kan vi säga att vi har fått ett visst antal förfrågningar och begränsningar för detta namnområde, och vidare kan vi säga att det är möjligt att skapa 10 tjänster och 10 pods i detta namnområde. Och utvecklaren kan ge sig själv kvot för att experimentera på kvällarna. Kubernetes kommer att säga: "Det går inte att skala upp dina pods till den mängden, eftersom det överskrider resurskvoten." Problemet är löst. .
Ett problematiskt moment uppstår i samband med detta. Du känner hur svårt det blir att skapa ett namnområde i Kubernetes. För att skapa det behöver vi ta hänsyn till en massa olika faktorer.
Resource quota + Limit Range + RBAC
• Skapa namnområde
• Skapa en limit range inuti
• Skapa en resource quota inuti
• Skapa ett service account för CI
• Skapa role binding för CI och användare
• Eventuellt starta nödvändiga service pods
Så jag vill gärna passa på att dela med mig av mina projekt. Det finns en sak som kallas operator SDK. Det är ett sätt att skriva operatörer för Kubernetes-klustret. Du kan skriva operatörer med hjälp av Ansible.
Först hade vi skrivit det i Ansible, och sen såg jag att det finns en operator SDK och skrev om Ansible-rollen till en operator. Denna operator gör det möjligt att skapa ett objekt i Kubernetes-klustret som kallas kommando. Inuti kommandot kan den beskriva miljön för detta kommando i yaml. Och inom kommando-miljön kan den beskriva hur mycket resurser vi tilldelar.
Liten .
Och slutligen. Vad ska man göra med allt detta?
Första. Pod Security Policy - det är bra. Trots att ingen av Kubernetes-installatörerna använder dem till denna dag, bör de ändå användas i era kluster.
Network Policy - det är ingen annan onödig funktion. Det är något som verkligen behövs i klustret.
LimitRange/ResourceQuota - det är dags att använda. Vi har använt detta länge, och jag var länge övertygad om att alla gjorde det. Det visade sig vara ganska sällsynt.
Förutom det jag nämnde under presentationen finns det odeklarerade funktioner som gör det möjligt att attackera klustret. Nyligen kom ut .
Vissa saker är så sorgliga och upprörande. Som till exempel, under vissa förhållanden kan kubeletar i Kubernetes-klustret ge obehöriga användare åtkomst till innehållet i warlocks-katalogen.
finns instruktioner om hur man återskapar allt jag pratat om. Det finns filer med produktions exempel, som visar hur ResourceQuota och Pod Security Policy ser ut. Och allt detta kan man ta på.
Tack alla.
Källa: habr.com
