

Jag delar med mig av mina personliga erfarenheter om vad som varit användbart, när och var. En sammanfattande och punktlista som tydligt visar vad och var man kan fördjupa sig — men detta är endast baserat på min subjektiva upplevelse, och din erfarenhet kan vara helt annorlunda.
Varför är det viktigt att känna till och kunna hantera frågespråk? I Data Science finns det flera avgörande faser i arbetet, och den första och viktigaste (utan den fungerar ingenting!) är att skaffa eller hämta data. Ofta sitter data någonstans i sin form och måste 'fiskas upp' därifrån.
Frågespråk gör just det möjligt att extrahera dessa data! Idag kommer jag att berätta om de frågespråk som varit användbara för mig och visa var och hur de används — varför det är viktigt att lära sig dessa.
Vi kommer att gå igenom tre huvudsakliga block av datatyper av frågor som vi ska diskutera i denna artikel:
- Här är de 'standardiserade' frågespråken — de språk som vanligtvis avses när man pratar om frågespråk, som till exempel relationell algebra eller SQL.
- Skriptfrågespråk: till exempel Python-grejer som pandas, numpy eller shell scripting.
- Frågespråk för kunskapsgrafer och grafdatabaser.
Allt som skrivits här är helt enkelt personliga erfarenheter, vad som varit användbart, med beskrivningar av situationer och 'varför de behövdes' — varje person kan reflektera över i vilken utsträckning liknande situationer kan uppstå för dem och försöka förbereda sig i förväg genom att sätta sig in i dessa språk innan de måste tillämpa dem (i brådskande fall) på ett projekt eller ens hamna i ett projekt där de behövs.
'Standardiserade' frågespråk
'Standardiserade' frågespråk i den meningen att det är vanligtvis dem vi tänker på när vi pratar om frågor.
Relationell algebra
Varför behövs relationell algebra idag? För att ha en god förståelse för varför frågespråk är utformade på ett visst sätt och medvetet använda dem måste vi förstå kärnan som ligger till grund.
Vad är relationell algebra?
Den formella definitionen är: relationell algebra — ett slutet system av operationer på relationer i den relationella datamodellen. Mer begripligt är det ett system av operationer på tabeller, sådant att resultatet alltid också är en tabell.
Se alla relationella operationer i artikeln från Habr - här beskriver vi varför det är viktigt att veta och var det används.
Varför?
Du börjar förstå hur frågespråk egentligen är uppbyggda och vilka operationer som ligger bakom uttrycken i specifika frågespråk - det ger ofta en djupare förståelse för vad som händer och hur det fungerar i frågespråken.
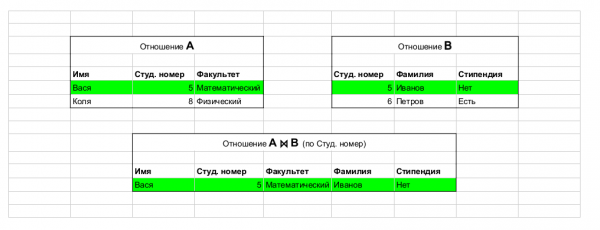
Taget från artiklar. Exempel på en operation: join, som förenar tabeller.
Material för studier:
. Generellt finns det mycket material om relationell algebra och teori - Coursera, Udacity. Det finns också en stor mängd material online, inklusive bra . Mitt personliga råd: du måste förstå relationell algebra mycket väl - det är grunden till allt.
SQL
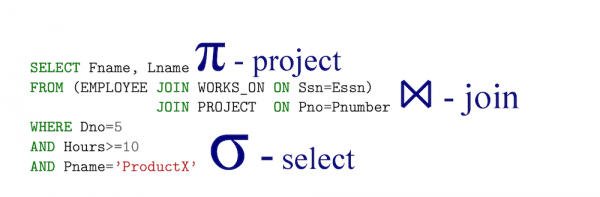
Taget från artiklar.
SQL är i grunden en implementering av relationell algebra - med den viktiga anmärkningen att SQL är deklarativt! Det vill säga när du skriver en fråga på relationell algebra talar du faktiskt om hur det ska beräknas - men med SQL beskriver du vad du vill hämta, och därefter genererar DBMS redan (effektiva) uttryck på relationell algebra (deras ekvivalens är känd som ).
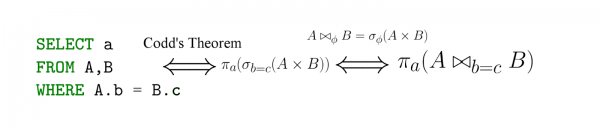
Taget från artiklar.
Varför?
Relationella DBMS: Oracle, Postgres, SQL Server osv - finns fortfarande överallt och chanserna är stora att du kommer att behöva interagera med dem, vilket betyder att du antingen måste läsa SQL (vilket är mycket troligt) eller skriva i det (inte heller osannolikt).
Vad man ska läsa och studera
Via samma länkar ovan (om relationell algebra) finns det otroligt mycket material, till exempel .
Förresten, vad är NoSQL?
"Det är värt att understryka igen att termen 'NoSQL' har ett helt spontant ursprung och saknar en allmänt erkänd definition eller något vetenskapligt institut bakom sig." Relaterat på Habr.
I själva verket insåg folk att den fullständiga relationella modellen inte är nödvändig för att lösa många problem, särskilt där till exempel prestanda är avgörande och vissa enkla frågeställningar med aggregering dominerar - det är kritiskt att snabbt räkna metrik och skriva dem till databasen, och de flesta funktioner av relationella var inte bara onödiga, utan också skadliga - varför normalisera något om det påverkar det mest viktiga för oss (för en viss specifik uppgift) - prestanda?
Det behövs ofta flexibla scheman istället för fasta matematiska scheman från den klassiska relationella modellen - och det förenklar verkligen utvecklingen av applikationer, när det är kritiskt att snabbt distribuera systemet och börja arbeta, hantera resultaten - eller så är schemat och typerna av lagrade data inte så viktiga.
Till exempel, när vi skapar ett expertssystem och vill lagra information om ett visst domän tillsammans med viss metadata - kan vi faktiskt inte veta alla fält och enkelt lagra JSON för varje post - det ger oss en mycket flexibel miljö för att utöka datamodellen och snabbt iterera - därför blir NoSQL i detta fall till och med att föredra och läsbarare. Ett exempel på en post (från ett av mina projekt där NoSQL verkligen var där det behövdes).
{"en_wikipedia_url":"https://en.wikipedia.org/wiki/Johnny_Cash",
"ru_wikipedia_url":"https://ru.wikipedia.org/wiki/?curid=301643",
"ru_wiki_pagecount":149616,
"entity":[42775,"Джонни Кэш","ru"],
"en_wiki_pagecount":2338861}
Du kan läsa mer om NoSQL.
Vad ska man studera?
Det handlar mer om att noggrant analysera din uppgift, vilka egenskaper den har och vilka NoSQL-system som passar under denna beskrivning - och sedan börja studera det specifika systemet.
Scriptbaserade frågespråk
Först verkar det som om Python hamnar långt från frågorna - det är ett programmeringsspråk, och handlar inte alls om frågningar.
- Pandas är verkligen en schweizisk armékniv inom Data Science, en enorm mängd datatransformationer, aggregeringar och så vidare sker där.
- Numpy - vektorberäkningar, matriser och linjär algebra finns där.
- Scipy - mycket matematik i detta paket, särskilt statistik.
- Jupyter lab - passar bra för mycket exploratory data analysis i anteckningsböcker - det är bra att kunna.
- Requests - nätverksarbete.
- Pyspark - mycket populär bland datatekniker, du kommer sannolikt att behöva interagera med denna eller Spark, bara på grund av deras popularitet.
- *Selenium - mycket användbar för insamling av data från webbsidor och resurser, ibland får man helt enkelt inte tag på data på något annat sätt.
Mitt viktigaste råd: lär dig Python!
Pandas
Låt oss ta följande kod som exempel:
import pandas as pd
df = pd.read_csv("data/dataset.csv")
# Beräkna och döp om aggregeringar
all_together = (df[df[‘trip_type’] == "return"]
    .groupby(['start_station_name','end_station_name'])
    .agg({'trip_duration_seconds': [np.size, np.mean, np.min, np.max]})
    .rename(columns={'size': 'num_trips',
           'mean': 'avg_duration_seconds',
           'amin': 'min_duration_seconds',
           ‘amax': 'max_duration_seconds'}))
I grund och botten ser vi att koden passar in i det klassiska SQL-mönstret.
SELECT start_station_name, end_station_name, count(trip_duration_seconds) as size, …..
FROM dataset
WHERE trip_type = 'return'
GROUP BY start_station_name, end_station_name
Men en viktig del är att denna kod är en del av ett skript och en pipeline, vi integrerar faktiskt förfrågningar i en Python-pipeline. I detta fall kommer språkförfrågningarna till oss från bibliotek som Pandas eller pySpark.
I allmänhet ser vi i pySpark en liknande typ av datatransformation genom språkförfrågningar i stil med:
df.filter(df.trip_type = "return")
  .groupby("day")
  .agg({duration: 'mean'})
  .sort()
Var och vad att läsa
Om själva Python att hitta material för att studera. Det finns en mängd tutorials på nätet om , och kurser i (liksom om själva ). Generellt sett är materialet utmärkt sökbart och om jag skulle behöva välja ett paket som man bör fokusera på — skulle det vara pandas, såklart. Det finns också .
Shell som språk för förfrågningar
Många projekt för bearbetning och analys av data, som jag har arbetat med — är i grund och botten shell-skript som anropar kod i Python, i Java och faktiskt själva shell-kommandona. Därför kan man i allmänhet betrakta pipelines i bash/zsh/etc. som en sorts hög nivåförfrågan (man kan naturligtvis stoppa in loopar där, men det är atypiskt för DS-kod i shell-språk), här är ett enkelt exempel — jag behövde göra en mappning av QID från Wikidata och den fullständiga länken till den ryska och engelska Wikipedia, för detta skrev jag en enkel förfrågan av kommandon i bash och för utskriften skrev jag ett enkelt skript i Python, som jag satte ihop så här:
pv "data/latest-all.json.gz" |
unpigz -c |
jq --stream $JQ_QUERY |
python3 scripts/post_process.py "output.csv"
w
JQ_QUERY = 'select((.[0][1] == "sitelinks" and (.[0][2]=="enwiki" or .[0][2] =="ruwiki") and .[0][3] =="title") or .[0][1] == "id")' Detta var i grund och botten hela pipelinen som skapade den nödvändiga mappningen, som vi ser fungerade allt i realtid:
- pv filepath — ger en progressbar baserat på filstorlek och skickar dess innehåll vidare
- unpigz -c läste en del av arkivet och skickade det till jq
- jq med nyckeln — stream gav omedelbart resultat och skickade det till efterbehandlaren (liksom i det första exemplet) i Python
- inuti efterbehandlaren — är en enkel maskin för tillstånd som formaterade utdata
Totalt är det en komplex pipeline som fungerar i strömmodus på stora data (0,5 TB), utan betydande resurser och skapad av en enkel pipeline och ett par verktyg.
Ett annat viktigt tips: lär dig att arbeta bra och effektivt i terminalen och skriva i bash/zsh/etc.
Var är detta användbart? Nästan överallt – det finns MYCKET material för studier på nätet. Specifikt, här är min tidigare artikel.
R scripting
Återigen kan läsaren utropa – men det är ju ett helt programmeringsspråk! Och självklart har de rätt. Men jag har oftast stött på R i sådana sammanhang att det i praktiken liknar ett frågespråk.
R är en miljö för statistiska beräkningar och ett språk för statistiska beräkningar och visualisering (enligt ).
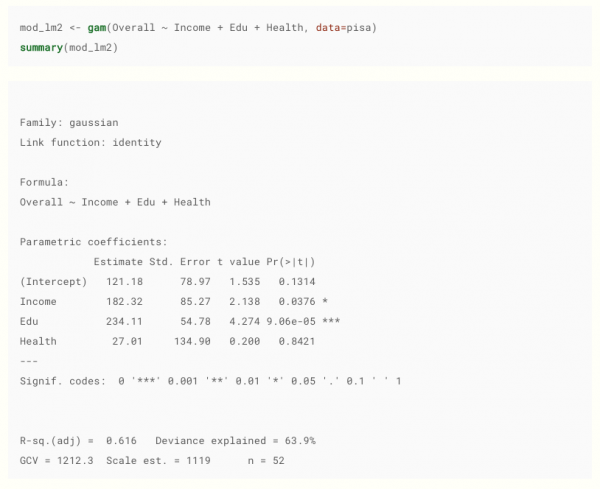
Taget . Förresten rekommenderar jag, bra material.
Varför behöver en data scientist veta R? Åtminstone för att det finns en stor grupp människor utanför IT som sysslar med dataanalys i R. Jag har stött på det på följande ställen:
- Det farmaceutiska sektorn.
- Biologer.
- Finanssektorn.
- Människor med ren matematisk utbildning som sysslar med statistik.
- Specialiserade statistiska modeller och maskininlärningsmodeller (som ofta endast kan hittas i författarversioner i form av R-paket).
Varför är detta faktiskt ett frågespråk? I den form det ofta förekommer – det är i grunden en förfrågan om att skapa en modell, inklusive att läsa data och fastställa parametrar för förfrågan (modellen), samt visualisering av data i paket som ggplot2 – detta är också en form av att skriva förfrågningar.
Exempel på förfrågningar för visualisering
ggplot(data = beav,
       aes(x = id, y = temp,
           group = activ, color = activ)) +
  geom_line() +
  geom_point() +
  scale_color_manual(values = c("red", "blue"))
Generellt har många idéer från R övergått till Python-paket som pandas, numpy eller scipy, som dataframes och vektorisering av data – därför kommer många saker i R att verka bekanta och användbara för dig.
Det finns många källor för att lära sig, till exempel, .
Kunskapsgrafer (Knowledge graph)
Här har jag lite ovanlig erfarenhet, eftersom jag ofta får arbeta med kunskapsgrafer och frågespråk för grafer. Så låt oss bara snabbt gå igenom grunderna, eftersom denna del är något mer exotisk.
I klassiska relationella databaser har vi ett fast schema – här är schemat flexibelt, varje predikat är faktiskt en "kolumn" och ännu mer.
Tänk dig att du skulle modellera en människa och ville beskriva nyckeldetaljer, vi tar en specifik person, Douglas Adams, som utgångspunkt och använder denna beskrivning.
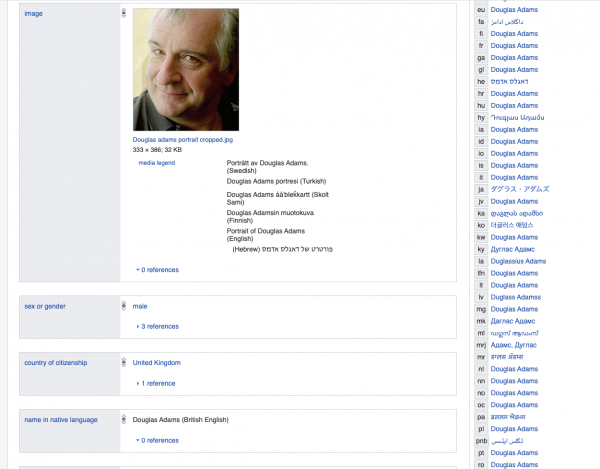
Om vi hade använt en relationell databas skulle vi ha behövt skapa en enorm tabell eller flera tabeller med ett stort antal kolumner, där en stor del av dem nog skulle vara NULL eller fyllda med något standard False-värde, till exempel är det osannolikt att många av oss har en post i det nationella koreanska biblioteket – självklart skulle vi kunna flytta dem till separata tabeller, men det skulle i slutändan vara ett försök att modellera ett flexibelt logiskt schema med predikat med hjälp av en fast relationell databas.
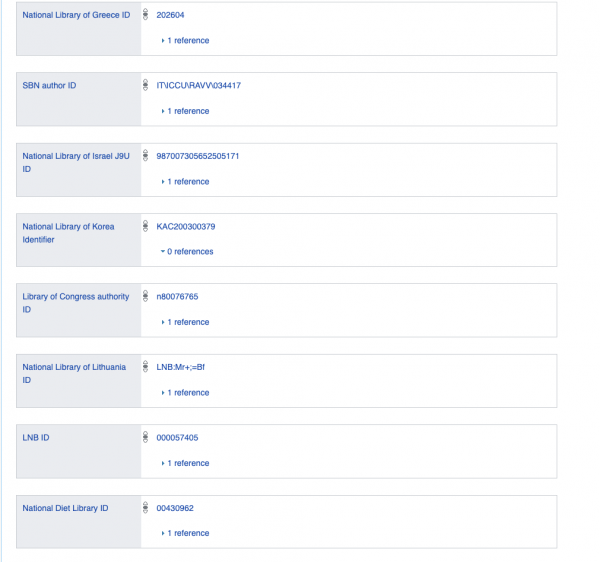
Så föreställ dig att all data lagras i form av en graf eller som binära och unära logiska uttryck.
Var kan du överhuvudtaget stöta på det här? Först och främst när man arbetar med , ja, och med alla grafdatabaser eller relaterade data.
Nedan följer de huvudsakliga frågespråken som jag har varit tvungen att använda och arbeta med.
SPARQL
Wiki:
SPARQL ( från SPARQL Protocol and RDF Query Language) — , presenterat enligt modellen , samt för att överföra dessa förfrågningar och svar på dem. SPARQL är en rekommendation från och en av teknologierna .
I själva verket är det ett frågespråk för logiska unära och binära predikat. Det specificeras helt enkelt vad som är fast i det logiska uttrycket och vad som inte är (mycket förenklat).
Själva RDF-databasen (Resource Description Framework), där SPARQL-förfrågningar utförs, är en triplet objekt, predikat, subjekt – och frågan väljer de relevanta tripletterna enligt angivna begränsningar i stil med: hitta sådan X att p_55(X, q_33) är sant – där p_55 självklart är en relation med ID 55, och q_33 är objektet med ID 33 (och det är hela berättelsen, igen utan att gå in på alla möjliga detaljer).
Exempel på datavisualisering:
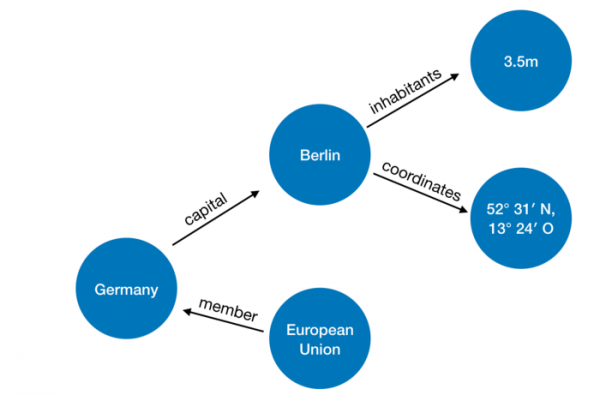
Bilder och exempel med länder är här .
Exempel på en grundläggande förfrågan
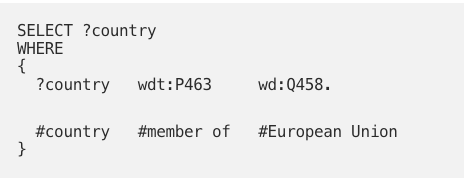
I själva verket vill vi hitta värdet av variabeln ?country, sådant att för predikatet
member_of, är det sant att member_of(?country,q458), där q458 är ID för Europeiska unionen.
Ett exempel på en verklig SPARQL-förfrågan inom python-motorn:
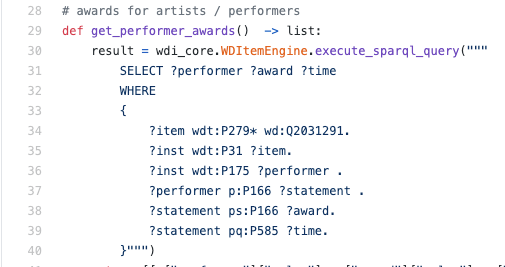
Som regel har jag fått läsa SPARQL snarare än att skriva den — i en sådan situation är det förmodligen en nyttig färdighet att förstå språket åtminstone på en grundläggande nivå för att förstå hur data faktiskt hämtas.
Det finns mycket material online för att studera: till exempel här är och . Jag brukar vanligtvis googla specifika konstruktioner och exempel och det räcker hittills.
Logiska förfrågningsspråk
Mer om ämnet kan läsas i min artikel . Här går vi dock bara kort igenom varför logiska språk är bra för att skriva förfrågningar. I grund och botten är RDF bara en uppsättning logiska påståenden av typen p(X) och h(X,Y), och en logisk förfrågan har följande form:
output(X) :- country(X), member_of(X, "EU").
Här pratar vi om att skapa en ny predikat output/1 (/1 betyder unär), under förutsättning att det för X gäller att country(X) — det vill säga, X är ett land och även member_of(X, "EU").
Det innebär att både data och regler i detta fall representeras på exakt samma sätt, vilket gör det mycket enkelt och bra att modellera uppgifter.
Där de förekommit i branschen: ett stort projekt med ett företag som skriver förfrågningar på ett sådant språk, samt i det nuvarande projektet i systemets kärna — det verkar vara en ganska exotisk sak, men ibland förekommer det.
Ett exempel på en kodsnutt i ett logiskt språk som bearbetar wikidata:
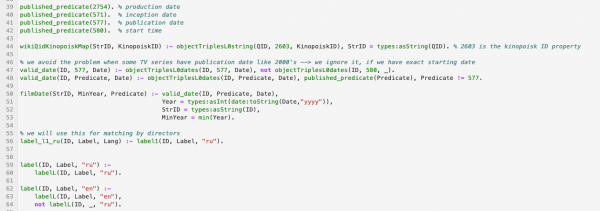
Material: jag ger här några länkar till det moderna logiska programmeringsspråket Answer Set Programming — jag rekommenderar att studera just det:
Källa: habr.com
