

Kära läsare, god dag. Idag ska vi prata lite om Apache Spark och dess utvecklingsutsikter.
I dagens Big Data-värld är Apache Spark de facto-standarden för utveckling av uppgifter för batchbehandling av data. Utöver detta används det också för att skapa streamingapplikationer, som arbetar i konceptet micro batch och bearbetar och levererar data i små portioner (Spark Structured Streaming). Traditionellt har det också varit en del av den allmänna Hadoop-stacken och använt YARN som resurshanterare (eller, i vissa fall, Apache Mesos). Fram till 2020 står dess användning i traditionell form för de flesta företag under stort frågetecken på grund av bristen på anständiga Hadoop-distributioner – utvecklingen av HDP och CDH har stoppats, CDH är otillräckligt utvecklat och har hög kostnad, och andra Hadoop-leverantörer har antingen upphört att existera eller har en osäker framtid. Därför väcker lanseringen av Apache Spark via Kubernetes allt större intresse hos samhället och stora företag – med att bli standard inom containerorkestrering och resursförvaltning i privata och offentliga moln löser det problemet med besvärlig resursplanering för Spark-uppgifter på YARN och erbjuder en stabilt utvecklande plattform med många kommersiella och öppna distributioner för företag av alla storlekar och branscher. Dessutom har i takt med populariteten de flesta redan skaffat sig ett par installationer och ökat sin expertis i användningen, vilket förenklar flytten.
Från och med version 2.3.0 har Apache Spark officiellt stöd för att köra uppgifter i Kubernetes-kluster, och idag ska vi prata om den aktuella mognaden av detta tillvägagångssätt, olika användningsalternativ och fallgropar som kan uppstå vid implementering.
Först och främst ska vi titta på processen för utveckling av uppgifter och applikationer baserade på Apache Spark och identifiera typiska fall där det är nödvändigt att köra en uppgift i ett Kubernetes-kluster. Förberedelse av detta inlägg använder OpenShift som distribution, och kommandon som är aktuella för dess kommandoradsverktyg (oc) kommer att anges. För andra Kubernetes-distributioner kan motsvarande kommandon i det standardiserade kommandoradsverktyget Kubernetes (kubectl) eller deras motsvarigheter (som till exempel för oc adm policy) användas.
Det första användningsområdet är spark-submit
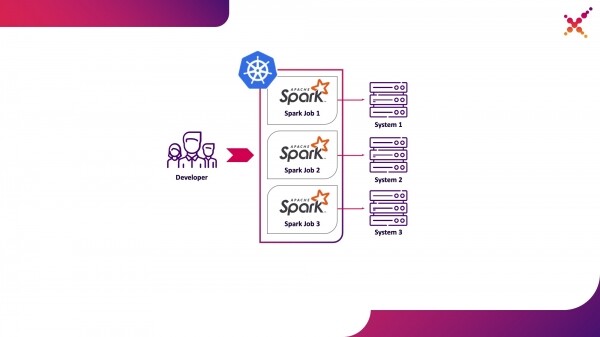
Under utvecklingen av uppgifter och applikationer behöver utvecklaren köra uppgifter för att felsöka datatransformationer. Teoretiskt kan stubbar användas för dessa ändamål, men utveckling med verkliga (även om de är test) instanser av slutsystem har visat sig vara snabbare och mer effektiv i denna typ av uppgifter. När vi felsöker på verkliga instanser av slutsystemen, är det två möjliga arbetsscenarier:
- utvecklaren kör Spark-jobbet lokalt i standalone-läge;

- utvecklaren kör Spark-jobbet på en Kubernetes-kluster i testmiljö.
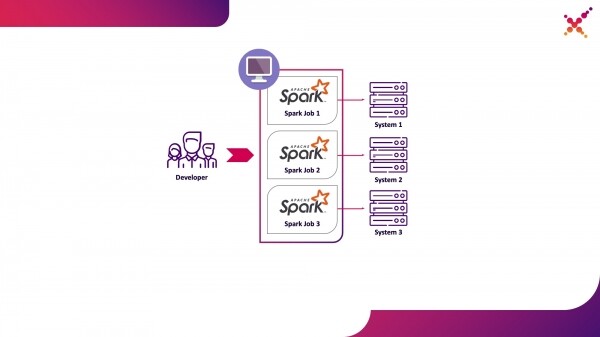
Det första alternativet är giltigt, men medför ett antal nackdelar:
- varje utvecklare behöver säkerställa åtkomst från sin arbetsstation till alla nödvändiga instanser av slutsystemen;
- den arbetsmaskin måste ha tillräckligt med resurser för att köra det utvecklade jobbet.
Det andra alternativet saknar dessa nackdelar, eftersom användningen av Kubernetes-klustret tillåter att allokera nödvändiga resurser för att köra uppgifterna och säkra nödvändig åtkomst till instanser av slutsystemen, vilket flexibelt ger tillgång till dem genom Kubernetes rollmodell för alla medlemmar i utvecklingsteamet. Låt oss lyfta fram det som det första användningsområdet — körning av Spark-jobb från utvecklarens lokala maskin på en Kubernetes-kluster i testmiljö.
Låt oss berätta mer om processen att konfigurera Spark för lokal körning. För att börja använda Spark behöver det installeras:
mkdir /opt/spark
cd /opt/spark
wget http://mirror.linux-ia64.org/apache/spark/spark-2.4.5/spark-2.4.5.tgz
tar zxvf spark-2.4.5.tgz
rm -f spark-2.4.5.tgz
Vi samlar de nödvändiga paketen för att arbeta med Kubernetes:
cd spark-2.4.5/
./build/mvn -Pkubernetes -DskipTests clean package
Den kompletta bygget tar mycket tid, och för att skapa Docker-bilder och köra dem på Kubernetes-klustret behövs egentligen bara jar-filer från katalogen "assembly/", därför kan bara detta delprojekt byggas:
./build/mvn -f ./assembly/pom.xml -Pkubernetes -DskipTests clean package
För att köra Spark-jobb i Kubernetes måste en Docker-bild skapas som ska användas som bas. Här finns två tillvägagångssätt:
- Den skapade Docker-bilden innehåller den körbara koden för Spark-uppgiften;
- Den skapade bilden innehåller endast Spark och nödvändiga beroenden, den exekverbara koden placeras på en fjärrserver (t.ex. i HDFS).
För att börja, ska vi bygga en Docker-bild som innehåller ett testexempel på en Spark-uppgift. För att skapa Docker-bilder har Spark ett verktyg som heter „docker-image-tool”. Låt oss kolla hjälpmenyn för det:
./bin/docker-image-tool.sh --help
Med det kan man skapa Docker-bilder och ladda upp dem till fjärrregister, men som standard har den flera nackdelar:
- den skapar alltid 3 Docker-bilder — för Spark, PySpark och R;
- den tillåter inte att ange bildens namn.
Därför kommer vi att använda en modifierad version av detta verktyg, som visas nedan:
vi bin/docker-image-tool-upd.sh
#!/usr/bin/env bash

function error {
  echo "$@" 1>&2
  exit 1
}

if [ -z "${SPARK_HOME}" ]; then
  SPARK_HOME="$(cd "`dirname "$0"`"/..; pwd)"
fi
. "${SPARK_HOME}/bin/load-spark-env.sh"

function image_ref {
  local image="$1"
  local add_repo="${2:-1}"
  if [ $add_repo = 1 ] && [ -n "$REPO" ]; then
    image="$REPO/$image"
  fi
  if [ -n "$TAG" ]; then
    image="$image:$TAG"
  fi
  echo "$image"
}

function build {
  local BUILD_ARGS
  local IMG_PATH

  if [ ! -f "$SPARK_HOME/RELEASE" ]; then
    IMG_PATH=$BASEDOCKERFILE
    BUILD_ARGS=(
      ${BUILD_PARAMS}
      --build-arg
      img_path=$IMG_PATH
      --build-arg
      datagram_jars=datagram/runtimelibs
      --build-arg
      spark_jars=assembly/target/scala-$SPARK_SCALA_VERSION/jars
    )
  else
    IMG_PATH="kubernetes/dockerfiles"
    BUILD_ARGS=(${BUILD_PARAMS})
  fi

  if [ -z "$IMG_PATH" ]; then
    error "Cannot find docker image. This script must be run from a runnable distribution of Apache Spark."
  fi

  if [ -z "$IMAGE_REF" ]; then
    error "Cannot find docker image reference. Please add -i arg."
  fi

  local BINDING_BUILD_ARGS=(
    ${BUILD_PARAMS}
    --build-arg
    base_img=$(image_ref $IMAGE_REF)
  )
  local BASEDOCKERFILE=${BASEDOCKERFILE:-"$IMG_PATH/spark/docker/Dockerfile"}

  docker build $NOCACHEARG "${BUILD_ARGS[@]}"
    -t $(image_ref $IMAGE_REF)
    -f "$BASEDOCKERFILE" .
}

function push {
  docker push "$(image_ref $IMAGE_REF)"
}

function usage {
  cat <<EOF
Usage: $0 [options] [command]
Builds or pushes the built-in Spark Docker image.

Commands:
  build       Build image. Requires a repository address to be provided if the image will be
              pushed to a different registry.
  push        Push a pre-built image to a registry. Requires a repository address to be provided.

Options:
  -f file               Dockerfile to build for JVM based Jobs. By default builds the Dockerfile shipped with Spark.
  -p file               Dockerfile to build for PySpark Jobs. Builds Python dependencies and ships with Spark.
  -R file               Dockerfile to build for SparkR Jobs. Builds R dependencies and ships with Spark.
  -r repo               Repository address.
  -i name               Image name to apply to the built image, or to identify the image to be pushed.
  -t tag                Tag to apply to the built image, or to identify the image to be pushed.
  -m                    Use minikube's Docker daemon.
  -n                    Build docker image with --no-cache
  -b arg      Build arg to build or push the image. For multiple build args, this option needs to
              be used separately for each build arg.

Using minikube when building images will do so directly into minikube's Docker daemon.
There is no need to push the images into minikube in that case, they'll be automatically
available when running applications inside the minikube cluster.

Check the following documentation for more information on using the minikube Docker daemon:

  https://kubernetes.io/docs/getting-started-guides/minikube/#reusing-the-docker-daemon

Examples:
  - Build image in minikube with tag "testing"
    $0 -m -t testing build

  - Build and push image with tag "v2.3.0" to docker.io/myrepo
    $0 -r docker.io/myrepo -t v2.3.0 build
    $0 -r docker.io/myrepo -t v2.3.0 push
EOF
}

if [[ "$@" = *--help ]] || [[ "$@" = *-h ]]; then
  usage
  exit 0
fi

REPO=
TAG=
BASEDOCKERFILE=
NOCACHEARG=
BUILD_PARAMS=
IMAGE_REF=
while getopts f:mr:t:nb:i: option
do
 case "${option}"
 in
 f) BASEDOCKERFILE=${OPTARG};;
 r) REPO=${OPTARG};;
 t) TAG=${OPTARG};;
 n) NOCACHEARG="--no-cache";;
 i) IMAGE_REF=${OPTARG};;
 b) BUILD_PARAMS=${BUILD_PARAMS}" --build-arg "${OPTARG};;
 esac
done

case "${@: -1}" in
  build)
    build
    ;;
  push)
    if [ -z "$REPO" ]; then
      usage
      exit 1
    fi
    push
    ;;
  *)
    usage
    exit 1
    ;;
esac
Med det samlar vi en grundläggande Spark-bild som innehåller ett testprojekt för att beräkna värdet av Pi med hjälp av Spark (här {docker-registry-url} — URL till ditt Docker-register, {repo} — namnet på förrådet inom registret, som matchar projektet i OpenShift, {image-name} — namnet på bilden (om det används en tre-nivåindelning av bilder, till exempel i det integrerade registret Red Hat OpenShift), {tag} — taggen för denna bildversion):
./bin/docker-image-tool-upd.sh -f resource-managers/kubernetes/docker/src/main/dockerfiles/spark/Dockerfile -r {docker-registry-url}/{repo} -i {image-name} -t {tag} build
Logga in i OKD-klustret med hjälp av kommandoradsverktyget (här {OKD-API-URL} — URL till OKD-klustrets API):
oc login {OKD-API-URL}
Vi får token för den aktuella användaren för att autentisera mot Docker Registry:
oc whoami -t
Logga in på det interna Docker-registret för OKD-klustret (använd token som lösenord, som erhölls via föregående kommando):
docker login {docker-registry-url}
Ladda upp den skapade Docker-bilden till OKD Docker Registry:
./bin/docker-image-tool-upd.sh -r {docker-registry-url}/{repo} -i {image-name} -t {tag} push
Kontrollera att den skapade bilden är tillgänglig i OKD. För att göra detta, öppna URL:en i webbläsaren med en lista över bilder för det aktuella projektet (här {project} — namnet på projektet inom OpenShift-klustret, {OKD-WEBUI-URL} — URL till OpenShift-webbgränssnittet) — https://{OKD-WEBUI-URL}/console/project/{project}/browse/images/{image-name}.
För att köra uppgift måste ett tjänstekonto med rättigheter att starta poddar som root skapas (mer om detta kommer vi att diskutera senare):
oc create sa spark -n {project}
oc adm policy add-scc-to-user anyuid -z spark -n {project}
Kör kommandot spark-submit för att publicera Spark-uppgiften i OKD-klustret, ange det skapade tjänstekontot och Docker-bilden:
/opt/spark/bin/spark-submit --name spark-test --class org.apache.spark.examples.SparkPi --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} local:///opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar
Här:
--name — uppgiftens namn som kommer att delta i formandet av podnamnen i Kubernetes;
—class — klass av körbar fil som anropas vid uppstart av uppgiften;
—conf — konfigurationsparametrar för Spark;
spark.executor.instances — antal Spark-executorer som ska köras;
spark.kubernetes.authenticate.driver.serviceAccountName — namnet på Kubernetes tjänstekonto som används vid uppstart av pods (för att definiera säkerhetskontext och behörigheter vid interaktion med Kubernetes API);
spark.kubernetes.namespace — Kubernetes-namnrymden där drivrutins- och executor-pods kommer att köras;
spark.submit.deployMode — sättet att köra Spark (för standard spark-submit används "cluster", för Spark Operator och senare versioner av Spark "client");
spark.kubernetes.container.image — Docker-image som används för att köra pods;
spark.master — URL för Kubernetes API (anges externt så att åtkomst sker från den lokala maskinen);
local:// — sökväg till Spark-körbar fil inuti Docker-imagen.
Vi går till den aktuella OKD-projektet och undersöker de skapade pods — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods.
För att förenkla utvecklingsprocessen kan en annan variant användas där en gemensam grundläggande Spark-image skapas och används av alla uppgifter för körning, och snapshots av körbara filer publiceras till extern lagring (t.ex. Hadoop) och anges vid anrop av spark-submit som en länk. På så sätt kan olika versioner av Spark-uppgifter startas utan att behöva bygga om Docker-images, genom att exempelvis använda WebHDFS för publicering. Vi skickar en begäran om att skapa en fil (här {host} — värden för WebHDFS-tjänsten, {port} — porten för WebHDFS-tjänsten, {path-to-file-on-hdfs} — den önskade sökvägen till filen på HDFS):
curl -i -X PUT "http://{host}:{port}/webhdfs/v1/{path-to-file-on-hdfs}?op=CREATE
Detta ger ett svar av följande slags (här {location} — URL:en som ska användas för att ladda upp filen):
HTTP/1.1 307 TEMPORARY_REDIRECT
Location: {location}
Content-Length: 0
Vi laddar upp den körbara Spark-filen till HDFS (här {path-to-local-file} — sökvägen till den körbara Spark-filen på den aktuella värden):
curl -i -X PUT -T {path-to-local-file} "{location}"
Efter detta kan vi köra spark-submit med den Spark-fil som laddats upp på HDFS (här {class-name} — namnet på klassen som ska köras för att utföra uppgiften):
/opt/spark/bin/spark-submit --name spark-test --class {class-name} --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} hdfs://{host}:{port}/{path-to-file-on-hdfs}
Det bör noteras att för att få åtkomst till HDFS och säkerställa att uppgiften fungerar kan det vara nödvändigt att ändra Dockerfile och skriptet entrypoint.sh — lägga till en direktiv i Dockerfile för att kopiera beroende bibliotek till mappen /opt/spark/jars och inkludera HDFS konfigurationsfilen i SPARK_CLASSPATH i entrypoint.sh.
Det andra användningsalternativet – Apache Livy
Vidare, när uppgiften har utvecklats och resultatet behöver testas, uppstår frågan om hur den kan köras inom CI/CD-processen och hur statusen för dess utförande kan spåras. Självklart kan den köras med hjälp av en lokal åkallning av spark-submit, men det komplicerar CI/CD-infrastrukturen eftersom det kräver installation och konfiguration av Spark på CI-serverns agenter/runners och inställningar för åtkomst till Kubernetes API. För detta fall valdes Apache Livy som en REST API-lösning för att köra Spark-jobb, placerad inom Kubernetes-klustret. Med hjälp av den kan man köra Spark-jobb i Kubernetes-klustret med vanliga cURL-förfrågningar, vilket är lätt att implementera i valfri CI-lösning, och dess placering inom Kubernetes-klustret löser problem med autentisering vid interaktion med Kubernetes API.
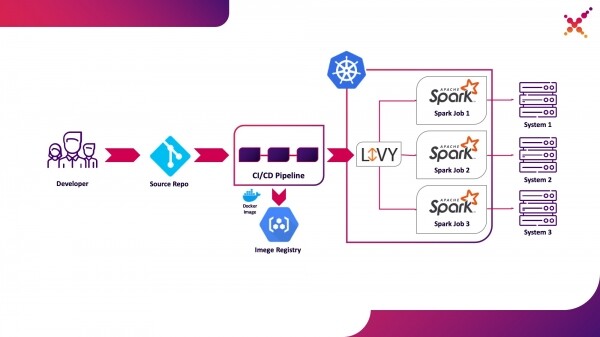
Låt oss förstärka det som det andra användningsalternativet – körning av Spark-jobb inom CI/CD-processen på Kubernetes-klustret i testmiljön.
Lite om Apache Livy – det fungerar som en HTTP-server som tillhandahåller ett webbgränssnitt och ett RESTful API som möjliggör fjärrkörning av spark-submit genom att överföra nödvändiga parametrar. Traditionellt levererades det som en del av HDP-distributionen, men kan även distribueras i OKD eller vilken annan Kubernetes-installation som helst med hjälp av motsvarande manifest och en uppsättning Docker-bilder, till exempel den här – . För vårt fall skapades en liknande Docker-bild som innehåller Spark version 2.4.5 från följande Dockerfile:
FROM java:8-alpine

ENV SPARK_HOME=/opt/spark
ENV LIVY_HOME=/opt/livy
ENV HADOOP_CONF_DIR=/etc/hadoop/conf
ENV SPARK_USER=spark

WORKDIR /opt

RUN apk add --update openssl wget bash &&
    wget -P /opt https://downloads.apache.org/spark/spark-2.4.5/spark-2.4.5-bin-hadoop2.7.tgz &&
    tar xvzf spark-2.4.5-bin-hadoop2.7.tgz &&
    rm spark-2.4.5-bin-hadoop2.7.tgz &&
    ln -s /opt/spark-2.4.5-bin-hadoop2.7 /opt/spark

RUN wget http://mirror.its.dal.ca/apache/incubator/livy/0.7.0-incubating/apache-livy-0.7.0-incubating-bin.zip &&
    unzip apache-livy-0.7.0-incubating-bin.zip &&
    rm apache-livy-0.7.0-incubating-bin.zip &&
    ln -s /opt/apache-livy-0.7.0-incubating-bin /opt/livy &&
    mkdir /var/log/livy &&
    ln -s /var/log/livy /opt/livy/logs &&
    cp /opt/livy/conf/log4j.properties.template /opt/livy/conf/log4j.properties

ADD livy.conf /opt/livy/conf
ADD spark-defaults.conf /opt/spark/conf/spark-defaults.conf
ADD entrypoint.sh /entrypoint.sh

ENV PATH="/opt/livy/bin:${PATH}"

EXPOSE 8998

ENTRYPOINT ["/entrypoint.sh"]
CMD ["livy-server"]
Den skapade bilden kan byggas och laddas upp till det Docker-repository du har, till exempel den interna OKD-repositoryn. För att implementera den används följande manifest ({registry-url} — URL till Docker-bildernas register, {image-name} — namnet på Docker-bilden, {tag} — taggen för Docker-bilden, {livy-url} — önskad URL där Livy-servern kommer att vara tillgänglig; manifestet "Route" används om Red Hat OpenShift används som Kubernetes-distribution, annars används motsvarande manifest för Ingress eller tjänst av typen NodePort):
---
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    component: livy
  name: livy
spec:
  progressDeadlineSeconds: 600
  replicas: 1
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      component: livy
  strategy:
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 25%
    type: RollingUpdate
  template:
    metadata:
      creationTimestamp: null
      labels:
        component: livy
    spec:
      containers:
        - command:
            - livy-server
          env:
            - name: K8S_API_HOST
              value: localhost
            - name: SPARK_KUBERNETES_IMAGE
              value: 'gnut3ll4/spark:v1.0.14'
          image: '{registry-url}/{image-name}:{tag}'
          imagePullPolicy: Always
          name: livy
          ports:
            - containerPort: 8998
              name: livy-rest
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
          volumeMounts:
            - mountPath: /var/log/livy
              name: livy-log
            - mountPath: /opt/.livy-sessions/
              name: livy-sessions
            - mountPath: /opt/livy/conf/livy.conf
              name: livy-config
              subPath: livy.conf
            - mountPath: /opt/spark/conf/spark-defaults.conf
              name: spark-config
              subPath: spark-defaults.conf
        - command:
            - /usr/local/bin/kubectl
            - proxy
            - '--port'
            - '8443'
          image: 'gnut3ll4/kubectl-sidecar:latest'
          imagePullPolicy: Always
          name: kubectl
          ports:
            - containerPort: 8443
              name: k8s-api
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
      dnsPolicy: ClusterFirst
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext: {}
      serviceAccount: spark
      serviceAccountName: spark
      terminationGracePeriodSeconds: 30
      volumes:
        - emptyDir: {}
          name: livy-log
        - emptyDir: {}
          name: livy-sessions
        - configMap:
            defaultMode: 420
            items:
              - key: livy.conf
                path: livy.conf
            name: livy-config
          name: livy-config
        - configMap:
            defaultMode: 420
            items:
              - key: spark-defaults.conf
                path: spark-defaults.conf
            name: livy-config
          name: spark-config
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: livy-config
data:
  livy.conf: |-
    livy.spark.deploy-mode=cluster
    livy.file.local-dir-whitelist=/opt/.livy-sessions/
    livy.spark.master=k8s://http://localhost:8443
    livy.server.session.state-retain.sec = 8h
  spark-defaults.conf: 'spark.kubernetes.container.image        "gnut3ll4/spark:v1.0.14"'
---
apiVersion: v1
kind: Service
metadata:
  labels:
    app: livy
  name: livy
spec:
  ports:
    - name: livy-rest
      port: 8998
      protocol: TCP
      targetPort: 8998
  selector:
    component: livy
  sessionAffinity: None
  type: ClusterIP
---
apiVersion: route.openshift.io/v1
kind: Route
metadata:
  labels:
    app: livy
  name: livy
spec:
  host: {livy-url}
  port:
    targetPort: livy-rest
  to:
    kind: Service
    name: livy
    weight: 100
  wildcardPolicy: None
Efter att ha tillämpat det och framgångsrikt startat podden är Livys grafiska gränssnitt tillgängligt via länken: http://{livy-url}/ui. Med hjälp av Livy kan vi publicera vår Spark-uppgift med ett REST-anrop, till exempel från Postman. Exempel på en samling med anrop presenteras nedan (i arrayen "args" kan konfigurationsargument med variabler som behövs för att köra den startade uppgiften skickas):
{
    "info": {
        "_postman_id": "be135198-d2ff-47b6-a33e-0d27b9dba4c8",
        "name": "Spark Livy",
        "schema": "https://schema.getpostman.com/json/collection/v2.1.0/collection.json"
    },
    "item": [
        {
            "name": "1 Skicka jobb med jar",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt\"file\": \"local://opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar\", nt\"className\": \"org.apache.spark.examples.SparkPi\",nt\"numExecutors\":1,nt\"name\": \"spark-test-1\",nt\"conf\": {ntt\"spark.jars.ivy\": \"/tmp/.ivy\",ntt\"spark.kubernetes.authenticate.driver.serviceAccountName\": \"spark\",ntt\"spark.kubernetes.namespace\": \"{project}\",ntt\"spark.kubernetes.container.image\": \"{docker-registry-url}/{repo}/{image-name}:{tag}\"nt}n}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        },
        {
            "name": "2 Skicka jobb utan jar",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt\"file\": \"hdfs://{host}:{port}/{path-to-file-on-hdfs}\", nt\"className\": \"{class-name}\",nt\"numExecutors\":1,nt\"name\": \"spark-test-2\",nt\"proxyUser\": \"0\",nt\"conf\": {ntt\"spark.jars.ivy\": \"/tmp/.ivy\",ntt\"spark.kubernetes.authenticate.driver.serviceAccountName\": \"spark\",ntt\"spark.kubernetes.namespace\": \"{project}\",ntt\"spark.kubernetes.container.image\": \"{docker-registry-url}/{repo}/{image-name}:{tag}\"nt},nt\"args\": [ntt\"HADOOP_CONF_DIR=/opt/spark/hadoop-conf\",ntt\"MASTER=k8s://https://kubernetes.default.svc:8443\"nt]n}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        }
    ],
    "event": [
        {
            "listen": "prerequest",
            "script": {
                "id": "41bea1d0-278c-40c9-ad42-bf2e6268897d",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        },
        {
            "listen": "test",
            "script": {
                "id": "3cdd7736-a885-4a2d-9668-bd75798f4560",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        }
    ],
    "protocolProfileBehavior": {}
}
Vi utför den första förfrågan från samlingen, går till OKD-gränssnittet och kontrollerar att uppgiften har startats framgångsrikt — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods. I Livy-gränssnittet (http://{livy-url}/ui) kommer en session att dyka upp, inom vilken vi kan övervaka framstegen för uppgiften och studera sessionens loggar antingen via Livy API eller det grafiska gränssnittet.
Nu ska vi visa hur Livy fungerar. För detta kommer vi att studera loggarna från Livy-behållaren inuti podden med Livy-servern — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods/{livy-pod-name}?tab=logs. Från dessa loggar kan vi se att när REST API:et för Livy anropas, körs spark-submit i behållaren med namnet "livy", vilket liknar det vi använde ovan (här är {livy-pod-name} namnet på den skapade podden med Livy-servern). I samlingen finns också en andra förfrågan som möjliggör att köra uppgifter med extern placering av Spark-körfilen via Livy-servern.
Tredje användningsalternativet — Spark Operator
Nu när uppgiften har testats, uppstår frågan om dess regelbundna körning. Den inbyggda metoden för att köra uppgifter regelbundet i en Kubernetes-kluster är CronJob-entiteten och vi kan använda den, men för tillfället är det mer populärt att använda operatörer för att hantera applikationer i Kubernetes, och för Spark finns det en tillräckligt mogen operator, som även används i företagslösningar (till exempel Lightbend FastData Platform). Vi rekommenderar att använda den — den nuvarande stabila versionen av Spark (2.4.5) har rätt begränsade alternativ för att konfigurera körning av Spark-uppgifter i Kubernetes, medan nästa huvudversion (3.0.0) lovar fullt stöd för Kubernetes, men utgångsdatumet för denna version är fortfarande okänt. Spark Operator kompenserar för denna brist genom att lägga till viktiga konfigurationsparametrar (till exempel montering av ConfigMap med konfiguration av åtkomst till Hadoop i Spark-poddar) och möjligheten att köra uppgifter efter schema.
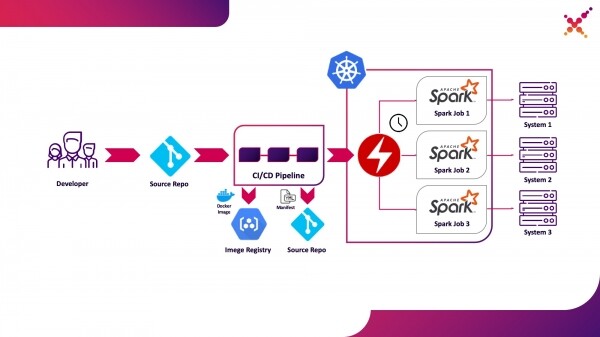
Vi framhäver detta som det tredje användningsalternativet — regelbunden körning av Spark-uppgifter på Kubernetes-klustret i produktionsmiljö.
Spark Operator är öppen källkod och utvecklas inom ramen för Google Cloud Platform — . Det kan installeras på tre sätt:
- Inom installationen av Lightbend FastData Platform/Cloudflow;
- Genom Helm:
helm repo add incubator http://storage.googleapis.com/kubernetes-charts-incubator helm install incubator/sparkoperator --namespace spark-operator - Genom att använda manifest från det officiella arkivet (https://github.com/GoogleCloudPlatform/spark-on-k8s-operator/tree/master/manifest). Det är viktigt att notera följande — Cloudflow inkluderar en operator med API-version v1beta1. Om denna installationsmetod används, bör beskrivningarna av Spark-applikationernas manifest baseras på exempel från taggar i Git med motsvarande API-version, till exempel "v1beta1-0.9.0-2.4.0". Versionen av operatorn kan ses i beskrivningen av CRD som ingår i operatorn i ordboken "versions":
oc get crd sparkapplications.sparkoperator.k8s.io -o yaml
Om operatorn har installerats korrekt, kommer en aktiv pod med Spark-operatorn att dyka upp i den relevanta projektet (till exempel cloudflow-fdp-sparkoperator i Cloudflow-namnområdet för Cloudflow-installationen) och en motsvarande typ av Kubernetes-resurs med namnet "sparkapplications" kommer att finnas. Du kan studera de befintliga Spark-applikationerna med följande kommando:
oc get sparkapplications -n {project}
För att köra uppgifter med hjälp av Spark-operatorn behöver man göra tre saker:
- skapa en Docker-bild som inkluderar alla nödvändiga bibliotek, samt konfigurations- och körbara filer. I det målbilden handlar det om en bild som skapats under CI/CD-steget och testats på en testkluster;
- publicera Docker-bilden i ett register som är tillgängligt från Kubernetes-klustret;
- skapa ett manifest av typen "SparkApplication" och en beskrivning av den uppgift som ska köras. Exempel på manifester finns i det officiella arkivet (till exempel, ). Det är viktigt att notera viktiga punkter angående manifestet:
- i ordboken "apiVersion" bör den API-version som motsvarar operatorns version anges;
- i ordboken "metadata.namespace" bör det anges vilket namnområde som applikationen ska köras i;
- i ordboken "spec.image" ska adressen till den skapade Docker-bilden i det tillgängliga registret anges;
- i ordboken "spec.mainClass" ska namnet på den Spark-klass som ska köras vid starten av processen anges;
- i ordboken "spec.mainApplicationFile" ska sökvägen till den körbara jar-filen anges;
- i ordboken "spec.sparkVersion" bör den använda versionen av Spark anges;
- i ordboken "spec.driver.serviceAccount" bör den tjänstekonto som används för att köra applikationen inom det relevanta namnområdet Kubernetes anges;
- i ordboken "spec.executor" bör antalet resurser som tilldelas applikationen anges;
- I ordboken «spec.volumeMounts» måste anges en lokal katalog där de lokala filerna för Spark-uppgiften kommer att skapas.
Exempel på hur man skapar en manifest (här är {spark-service-account} servicekontot inom Kubernetes-klustret för att köra Spark-uppgifter):
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:///opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "/tmp"
        type: Directory
  driver:
    cores: 0.1
    coreLimit: "200m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: {spark-service-account}
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
I det här manifestet anges ett servicekonto för vilket det krävs att nödvändiga rollbindningar skapas innan manifestet publiceras, som ger de nödvändiga rättigheterna för att interagera med Kubernetes API (om det behövs). I vårt fall behöver applikationen rättigheter för att skapa Pods. Låt oss skapa den nödvändiga rollbindningen:
oc adm policy add-role-to-user edit system:serviceaccount:{project}:{spark-service-account} -n {project}
Det bör också noteras att parameter «hadoopConfigMap» kan anges i specifikationen för detta manifest, vilket tillåter att ange en ConfigMap med Hadoop-konfiguration utan att behöva lägga den motsvarande filen i Docker-avbilden i förväg. Den passar också för att köra uppgifter regelbundet — med hjälp av parametern «schedule» kan körschema för denna uppgift anges.
Efter detta sparar vi vårt manifest i filen spark-pi.yaml och tillämpar det på vårt Kubernetes-kluster:
oc apply -f spark-pi.yaml
Då skapas ett objekt av typen «sparkapplications»:
oc get sparkapplications -n {project}
> NAME       AGE
> spark-pi   22h
Då skapas en pod med applikationen, vars status kommer att visas i den skapade «sparkapplications». Det kan ses med följande kommando:
oc get sparkapplications spark-pi -o yaml -n {project}
När uppgiften är klar kommer POD att ändra status till «Completed», vilket också kommer att uppdateras i «sparkapplications». Loggar från applikationen kan ses i webbläsaren eller med följande kommando (här är {sparkapplications-pod-name} namnet på podden för den körda uppgiften):
oc logs {sparkapplications-pod-name} -n {project}
Förvaltning av Spark-uppgifter kan också göras med hjälp av det specialiserade verktyget sparkctl. För att installera det klonar vi repot med dess källkod, installerar Go och bygger detta verktyg:
git clone https://github.com/GoogleCloudPlatform/spark-on-k8s-operator.git
cd spark-on-k8s-operator/
wget https://dl.google.com/go/go1.13.3.linux-amd64.tar.gz
tar -xzf go1.13.3.linux-amd64.tar.gz
sudo mv go /usr/local
mkdir $HOME/Projects
export GOROOT=/usr/local/go
export GOPATH=$HOME/Projects
export PATH=$GOPATH/bin:$GOROOT/bin:$PATH
go -version
cd sparkctl
go build -o sparkctl
sudo mv sparkctl /usr/local/bin
Låt oss granska listan över aktiva Spark-uppgifter:
sparkctl list -n {project}
Skapa en beskrivning för Spark-uppgiften:
vi spark-app.yaml
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:///opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "/tmp"
        type: Directory
  driver:
    cores: 1
    coreLimit: "1000m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: spark
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
Låt oss köra den beskrivna uppgiften med hjälp av sparkctl:
sparkctl create spark-app.yaml -n {project}
Låt oss granska listan över aktiva Spark-uppgifter:
sparkctl list -n {project}
Låt oss granska listan över händelser för den aktiva Spark-uppgiften:
sparkctl event spark-pi -n {project} -f
Låt oss granska statusen för den aktiva Spark-uppgiften:
sparkctl status spark-pi -n {project}
Avslutningsvis vill vi diskutera de nackdelar som identifierats vid användningen av den nuvarande stabila versionen av Spark (2.4.5) i Kubernetes:
- Den första och kanske största nackdelen är bristen på data-lokalitet. Trots alla nackdelar med YARN fanns det också fördelar med dess användning, till exempel principen att leverera kod till data (snarare än data till kod). Tack vare detta utfördes Spark-uppgifter på noder där datan som var involverad i beräkningarna fanns, vilket tydligt minskade tiden för dataleverans över nätverket. När vi använder Kubernetes möter vi behovet av att flytta data över nätverket som är involverat i uppgiften. Om de är tillräckligt stora kan tiden för att slutföra uppgiften öka avsevärt, och det kan också krävas en betydande mängd lagringsutrymme av de Spark-instans som tilldelats för temporär lagring. Denna nackdel kan minskas genom användning av specialiserade programvaror som säkerställer datalokalitet i Kubernetes (till exempel Alluxio), men detta innebär faktiskt att en fullständig kopia av datan behöver lagras på noderna i Kubernetes-klustret.
- Den andra viktiga nackdelen är säkerheten. Som standard är funktionerna relaterade till säkerhet vid körning av Spark-uppgifter inaktiverade; användningen av Kerberos nämns inte i den officiella dokumentationen (även om motsvarande parametrar introducerades i version 3.0.0, vilket kräver ytterligare utredning), och i dokumentationen för säkerhet vid användning av Spark (https://spark.apache.org/docs/2.4.5/security.html) nämns endast YARN, Mesos och Standalone Cluster som nyckel-lagringssysten. Dessutom kan användaren som kör Spark-uppgifterna inte anges direkt – vi anger endast ett tjänstekonto under vilket podden kommer att köras, och användaren väljs utifrån de angivna säkerhetspolicyn. Detta innebär antingen att användaren root används, vilket inte är säkert i en produktionsmiljö, eller att en användare med en slumpmässig UID används, vilket är besvärligt vid distribution av tillgångsbehörigheter till data (detta kan lösas genom att skapa PodSecurityPolicies och koppla dem till motsvarande tjänstekonton). För närvarande löses detta antingen genom att placera alla nödvändiga filer direkt i Docker-bilden eller genom att modifiera Spark-startskriptet för att använda den mekanism för lagring och hämtning av hemligheter som accepteras i din organisation.
- Att köra Spark-jobb med Kubernetes är fortfarande officiellt i experimentellt läge och i framtiden kan det bli betydande förändringar i de använda artefakterna (konfigurationsfiler, grundläggande Docker-bilder och start-skript). Under förberedelserna testades versionerna 2.3.0 och 2.4.5, och beteendet skilde sig avsevärt.
Vi ser fram emot uppdateringar — nyligen släpptes en ny version av Spark (3.0.0), som medförde märkbara förändringar i hur Spark fungerar på Kubernetes, men som fortfarande har ett experimentellt stöd för denna resursförvaltare. Kanske kommer de kommande uppdateringarna verkligen att möjliggöra att man på fullt allvar kan avstå från YARN och köra Spark-jobb på Kubernetes utan att oroa sig för säkerheten i ditt system och utan behov av att göra egna modifieringar av funktionella komponenter.
Fin.
Källa: habr.com
