

I mitt arbete stöter jag ofta på nya tekniska lösningar/programprodukter, och informationen om dem på svenskspråkiga internet är ganska knapp. I den här artikeln försöker jag fylla en sådan lucka med ett exempel från min senaste praktik, där jag behövde konfigurera utskick av CDC-händelser från två populära databashanterare (PostgreSQL och MongoDB) till ett Kafka-kluster med hjälp av Debezium. Jag hoppas att denna översiktsartikel, som kommit till efter genomförd verksamhet, kommer att vara till nytta även för andra.
Vad är Debezium och vad är CDC?
är en representant för kategorin CDC-programvara (), och mer exakt, det är en uppsättning anslutare för olika databashanterare som är kompatibla med ramverket Apache Kafka Connect.
Detta som använder licensen Apache License v2.0 och sponsras av företaget Red Hat. Utvecklingen påbörjades 2016 och i nuläget erbjuds officiellt stöd för följande databashanterare: MySQL, PostgreSQL, MongoDB, SQL Server. Det finns också anslutare för Cassandra och Oracle, men dessa är för närvarande i statusen "early access", och nya versioner garanterar inte bakåtkompatibilitet.
Jämfört med den traditionella metoden (där applikationen läser data direkt från databashanteraren) är dess främsta fördelar en realisering av strömmande datändringar på radnivå med låg latens, hög tillförlitlighet och tillgänglighet. De två sista punkterna uppnås genom att använda ett Kafka-kluster som lagringslösning för CDC-händelser.
En annan fördel är att en enhetlig modell används för lagring av händelser, vilket innebär att den slutgiltiga applikationen inte behöver oroa sig för nyanserna av olika databashanterare.
Slutligen öppnar användningen av en meddelandebroker möjligheter för horisontell skalning av applikationer som spårar datändringar. Samtidigt minimeras påverkan på datakällan, eftersom datainhämtning sker inte direkt från databashanteraren, utan från Kafka-klustret.
Om Debeziums arkitektur
Användningen av Debezium kan sammanfattas i ett så enkelt schema:
Databashanterare (som datakälla) → anslutare i Kafka Connect → Apache Kafka → konsument
Som illustration ger jag schemat från projektets webbplats:
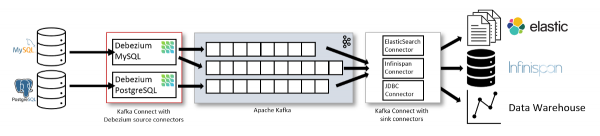
Men detta schema tilltalar mig inte särskilt mycket, eftersom det ger intryck av att endast sink-connectorn är möjlig att använda.
I själva verket är situationen en annan: fyllningen av din Data Lake (den sista länken i schemat ovan) — det är inte det enda sättet att använda Debezium. Händelser som skickas till Apache Kafka kan användas av dina applikationer för att lösa olika situationer. Till exempel:
- borttagning av irrelevanta data från cachen;
- skickande av meddelanden;
- uppdateringar av sökindex;
- någon form av revisionsloggar;
- …
Om du har en Java-applikation och inte har behov/kan använda ett Kafka-kluster, finns det även möjlighet att arbeta genom . Den uppenbara fördelen är att du kan avstå från ytterligare infrastruktur (i form av connector och Kafka). Men denna lösning har deklarerats som föråldrad (deprecated) sedan version 1.1 och rekommenderas inte längre för användning (i framtida releaser kan stödet tas bort).
Denna artikel kommer att ta upp den rekommenderade arkitekturen från utvecklarna, som erbjuder redundans och skalbarhet.
Connector-konfiguration
För att börja övervaka förändringar av den mest värdefulla tillgången — datan — behöver vi:
- en datakälla, som kan vara MySQL från version 5.7, PostgreSQL 9.6+, MongoDB 3.2+ ();
- Apache Kafka-kluster;
- Kafka Connect-instans (versioner 1.x, 2.x);
- konfigurerad Debezium-connector.
Arbetet med de första två punkterna, d.v.s. installationsprocessen av DBMS och Apache Kafka, ligger utanför ramarna för artikeln. Men för dem som vill ställa upp allt i en sandbox finns det en färdig .
Vi kommer istället att gå djupare in på de två sista punkterna.
0. Kafka Connect
Här och längre fram i artikeln behandlas alla konfigurations exempel i kontexten av Docker-image, som distribueras av Debezium-utvecklarna. Den innehåller alla nödvändiga plugin-filer (connectors) och möjliggör konfiguration av Kafka Connect med hjälp av miljövariabler.
Om det antas att Kafka Connect från Confluent ska användas, krävs det att du själv lägger till de nödvändiga connectorns plugins i katalogen som anges i plugin.path eller som anges via miljövariabeln CLASSPATHInställningar för Kafka Connect-arbetare och anslutningar definieras genom konfigurationsfiler som skickas som argument till kommandot för att starta arbetaren. Läs mer i .
Hela processen för att konfigurera Debezium med en anslutning utförs i två steg. Låt oss titta på varje steg:
1. Konfigurera Kafka Connect-ramverket
För att strömma data till Apache Kafka-klustret i Kafka Connect-ramverket anges specifika parametrar, såsom:
- anslutningsparametrar till klustret,
- namn på de ämnen där själva konfigurationen av anslutningen kommer att lagras,
- namnet på gruppen där anslutningen körs (i fallet med distribuerat läge).
Den officiella Docker-bilden för projektet stöder konfiguration via miljövariabler — och det är vad vi kommer att använda. Så, ladda ner bilden:
docker pull debezium/connectMinimala uppsättningar av miljövariabler som krävs för att starta anslutningen ser ut som följer:
-
BOOTSTRAP_SERVERS=kafka-1:9092,kafka-2:9092,kafka-3:9092— den initiala listan över Kafka-klusterservrar för att få den fullständiga listan över klustermedlemmar; -
OFFSET_STORAGE_TOPIC=connector-offsets— ämnet för att lagra positionerna för var anslutningen för närvarande är; -
CONNECT_STATUS_STORAGE_TOPIC=connector-status— ämnet för att lagra statusen för anslutningen och dess uppgifter; -
CONFIG_STORAGE_TOPIC=connector-config— ämnet för att lagra data om konfigurationen för anslutningen och dess uppgifter; -
GROUP_ID=1— identifierare för gruppen arbetare där uppgiften för anslutningen kan köras; nödvändig vid användning av distribuerat (distributed) läge.
Starta containern med dessa variabler:
docker run
  -e BOOTSTRAP_SERVERS='kafka-1:9092,kafka-2:9092,kafka-3:9092'
  -e GROUP_ID=1
  -e CONFIG_STORAGE_TOPIC=my_connect_configs
  -e OFFSET_STORAGE_TOPIC=my_connect_offsets
  -e STATUS_STORAGE_TOPIC=my_connect_statuses  debezium/connect:1.2
Obs för Avro
Som standard skriver Debezium data i JSON-format, vilket är acceptabelt för sandbox-miljöer och små datamängder, men kan bli ett problem i högbelastade databaser. Ett alternativ till JSON-konvertern är serialisering av meddelanden med hjälp av i binärt format, vilket minskar belastningen på I/O-systemet i Apache Kafka.
För att använda Avro krävs det att en separat (för att lagra scheman). Variablerna för konvertern kommer att se ut som följer:
name: CONNECT_VALUE_CONVERTER_SCHEMA_REGISTRY_URL
value: http://kafka-registry-01:8081/
name: CONNECT_KEY_CONVERTER_SCHEMA_REGISTRY_URL
value: http://kafka-registry-01:8081/
name: VALUE_CONVERTER
value: io.confluent.connect.avro.AvroConverter
Detaljer om användning av Avro och konfiguration av registry ligger utanför artikelns ämne — för tydlighetens skull kommer vi att använda JSON som exempel.
2. Konfigurera själva connectorn
Nu kan vi gå vidare till konfigurationen av själva connectorn som kommer att läsa data från källan.
Vi kommer att titta på exempel på connectors för två databashanteringssystem: PostgreSQL och MongoDB, för vilka jag har erfarenhet och där det finns skillnader (även om de är små, så kan de i vissa fall vara betydelsefulla!).
Konfigurationen beskrivs i JSON-notation och laddas upp till Kafka Connect via en POST-förfrågan.
2.1. PostgreSQL
Exempel på konfiguration för connectorn för PostgreSQL:
{
  "name": "pg-connector",
  "config": {
    "connector.class": "io.debezium.connector.postgresql.PostgresConnector",
    "plugin.name": "pgoutput",
    "database.hostname": "127.0.0.1",
    "database.port": "5432",
    "database.user": "debezium",
    "database.password": "definitelynotpassword",
    "database.dbname" : "dbname",
    "database.server.name": "pg-dev",
    "table.include.list": "public.(.*)",
    "heartbeat.interval.ms": "5000",
    "slot.name": "dbname_debezium",
    "publication.name": "dbname_publication",
    "transforms": "AddPrefix",
    "transforms.AddPrefix.type": "org.apache.kafka.connect.transforms.RegexRouter",
    "transforms.AddPrefix.regex": "pg-dev.public.(.*)",
    "transforms.AddPrefix.replacement": "data.cdc.dbname"
  }
}
Principen för hur connectorn fungerar efter denna konfiguration är ganska enkel:
- Vid första starten ansluter den till databasen som anges i konfigurationen och startar i läget initial snapshot, och skickar en initial uppsättning data till Kafka, hämtade med hjälp av en
SELECT * FROM table_name. - När initieringen är klar går connectorn över till att läsa ändringar från WAL-filerna i PostgreSQL.
Om de använda alternativen:
-
name— namnet på connectorn som konfigurationen gäller för; detta namn används senare för att arbeta med connectorn (dvs. se status/omstart/uppdatera konfigurationen) via Kafka Connects REST API; -
connector.class— klassen för databashanteringssystemet (DBMS) connectorn ska använda; -
plugin.name— namnet på pluginet för logisk avkodning av data från WAL-filer. Tillgängliga alternativ inkluderarwal2json,decoderbuffsochpgoutput. De två första kräver installation av motsvarande tillägg i DBMS, medanpgoutputför PostgreSQL version 10 och senare inte kräver några ytterligare åtgärder; -
database.*— alternativ för att ansluta till databasen, därdatabase.server.name— namnet på PostgreSQL-instansen som används för att bilda namnet på ämnet i Kafka-klustret; -
table.include.list— lista över tabeller där vi vill spåra ändringar; anges i formatetschema.table_name; kan inte användas tillsammans medtable.exclude.list; -
heartbeat.interval.ms— intervallet (i millisekunder) med vilket adaptern skickar heartbeat-meddelanden till ett speciellt ämne; -
heartbeat.action.query— frågan som kommer att utföras vid varje skickat heartbeat-meddelande (alternativet introducerades med version 1.1); -
slot.name— namnet på replikeringsslotet som ska användas av adaptern; publication.name— namnet i PostgreSQL som adaptern använder. Om det inte finns kommer Debezium att försöka skapa det. Om användaren, som adapteranslutningen görs med, inte har tillräckligt med rättigheter för detta kommer adaptern att avsluta med ett fel;-
transformsdefinierar hur målets ämnesnamn ska ändras:-
transforms.AddPrefix.typeanger att vi kommer att använda reguljära uttryck; -
transforms.AddPrefix.regex— masken vars namn på målets ämne kommer att åsidosättas; -
transforms.AddPrefix.replacement— det som vi faktiskt åsidosätter.
-
Mer om heartbeat och transforms
Som standard skickar adaptern data till Kafka för varje begången transaktion, och dess LSN (Log Sequence Number) skrivs till en tjänstämne offset. Men vad kommer att hända om adaptern är inställd på att läsa inte hela databasen utan bara delar av dess tabeller (där datauppdateringar inte sker så ofta)?
- Adaptern kommer att läsa WAL-filer och inte upptäcka några begångna transaktioner i de tabeller som den övervakar.
- Därför kommer den inte att uppdatera sin nuvarande position varken i ämnet eller i replikeringsslotet.
- Detta kommer i sin tur att leda till "hållande" av WAL-filer på disken och potentiellt utnyttjande av allt diskutrymme.
Och här kommer alternativen till hjälp. heartbeat.interval.ms och heartbeat.action.query. Genom att använda dessa alternativ tillsammans gör det möjligt att vid varje sändning av ett heartbeat-meddelande köra en fråga för att ändra data i en separat tabell. På så sätt hålls LSN, där adaptern just nu befinner sig (i replikeringsslotet), ständigt aktuellt. Detta gör att databashanteraren kan ta bort WAL-filer som inte längre behövs. Mer information om hur alternativen fungerar kan fås i .
Ett annat alternativ som är värt mer uppmärksamhet är transforms. Även om det snarare handlar om bekvämlighet och estetik...
Som standard skapar Debezium ämnen baserat på följande namngivningspolicy: serverName.schemaName.tableName. Detta kanske inte alltid är praktiskt. Alternativen transforms kan använda reguljära uttryck för att definiera en lista med tabeller vars händelser behöver routas till ett ämne med ett specifikt namn.
I vår konfiguration tack vare Avslutningsvis i beskrivningen av anslutningskonfigurationen för PostgreSQL är det värt att nämna följande funktioner/begränsningar: Så, låt oss ladda vår konfiguration till anslutningen: Vi kontrollerar att laddningen lyckades och att anslutningen startade: Utmärkt: den är inställd och klar för arbete. Nu spelar vi konsument och kopplar upp oss mot Kafka, varefter vi lägger till och ändrar en post i tabellen: I vårt ämne kommer detta att visas på följande sätt: Mycket lång JSON med våra ändringar I båda fallen består posterna av nyckeln (PK) till posten som har ändrats och själva essensen av ändringarna: hur posten såg ut före och hur den ser ut efter. Den här kopplingen använder standardreplikationsmekanismen för MongoDB och läser information från primärnodens oplog. På samma sätt som den tidigare beskrivna kopplingen för PgSQL, tas en primär snapshot av data vid första körningen, varefter kopplingen växlar till läsläge för oplogen. Exempelkonfiguration: Som man kan märka, finns det inga nya alternativ jämfört med det tidigare exemplet, men antalet alternativ som ansvarar för databaskopplingar och deras prefix har minskat. Inställningar Frågan om redundans och hög tillgänglighet är viktigare än någonsin — speciellt när vi pratar om data och transaktioner, och spårning av dataförändringar står inte i sidlinjen. Låt oss överväga vad som i princip kan gå fel och vad som kommer att hända med Debezium i varje fall. Det finns tre typer av fel: Det finns dock undantag. Om anslutningen har varit avstängd under en längre tid (eller inte har kunnat nå MongoDB-instansen), och oplog har roterat under den tiden, kommer anslutningen vid återställande av anslutningen lugnt att fortsätta läsa data från den första tillgängliga positionen, vilket gör att en del data i Kafka inte kommer att inkluderas. Debezium — min första erfarenhet av CDC-system och överlag mycket positiv. Projektet imponerade med stöd för de främsta databashanterarna, enkel konfigurering, support för kluster och ett aktivt samhälle. För dem som är intresserade av praktiken rekommenderar jag att ta del av guiderna för och . Jämfört med JDBC-anslutningen för Kafka Connect är den främsta fördelen med Debezium att förändringar läses från databashanterarens loggar, vilket möjliggör datainsamling med minimal fördröjning. JDBC Connector (från Kafka Connect-leveransen) gör begärningar till den övervakade tabellen med fasta intervall och (av samma anledning) genererar inte meddelanden vid borttagning av data (hur kan man begära data som inte finns?). För att lösa liknande uppgifter kan man överväga följande lösningar (förutom Debezium): Läs även i vår blogg: Källa: habr.comtransforms sker följande: alla CDC-händelser från den övervakade databasen kommer att hamna i ett ämne med namnet data.cdc.dbname. Annars (utan dessa inställningar) skulle Debezium som standard skapa ett ämne för varje tabell liknande: pg-dev.public..
Begränsningar för anslutningen
Tillämpning av konfigurationen
curl -i -X POST -H "Accept:application/json"
-H "Content-Type:application/json" http://localhost:8083/connectors/
-d @pg-con.json$ curl -i http://localhost:8083/connectors/pg-connector/status
HTTP/1.1 200 OK
Date: Thu, 17 Sep 2020 20:19:40 GMT
Content-Type: application/json
Content-Length: 175
Server: Jetty(9.4.20.v20190813)
{"name":"pg-connector","connector":{"state":"RUNNING","worker_id":"172.24.0.5:8083"},"tasks":[{"id":0,"state":"RUNNING","worker_id":"172.24.0.5:8083"}],"type":"source"}$ kafka/bin/kafka-console-consumer.sh
--bootstrap-server kafka:9092
--from-beginning
--property print.key=true
--topic data.cdc.dbname
postgres=# insert into customers (id, first_name, last_name, email) values (1005, 'foo', 'bar', 'foo@bar.com');
INSERT 0 1
postgres=# update customers set first_name = 'egg' where id = 1005;
UPDATE 1{
"schema":{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
}
],
"optional":false,
"name":"data.cdc.dbname.Key"
},
"payload":{
"id":1005
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"before"
},
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"after"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"version"
},
{
"type":"string",
"optional":false,
"field":"connector"
},
{
"type":"string",
"optional":false,
"field":"name"
},
{
"type":"int64",
"optional":false,
"field":"ts_ms"
},
{
"type":"string",
"optional":true,
"name":"io.debezium.data.Enum",
"version":1,
"parameters":{
"allowed":"true,last,false"
},
"default":"false",
"field":"snapshot"
},
{
"type":"string",
"optional":false,
"field":"db"
},
{
"type":"string",
"optional":false,
"field":"schema"
},
{
"type":"string",
"optional":false,
"field":"table"
},
{
"type":"int64",
"optional":true,
"field":"txId"
},
{
"type":"int64",
"optional":true,
"field":"lsn"
},
{
"type":"int64",
"optional":true,
"field":"xmin"
}
],
"optional":false,
"name":"io.debezium.connector.postgresql.Source",
"field":"source"
},
{
"type":"string",
"optional":false,
"field":"op"
},
{
"type":"int64",
"optional":true,
"field":"ts_ms"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"id"
},
{
"type":"int64",
"optional":false,
"field":"total_order"
},
{
"type":"int64",
"optional":false,
"field":"data_collection_order"
}
],
"optional":true,
"field":"transaction"
}
],
"optional":false,
"name":"data.cdc.dbname.Envelope"
},
"payload":{
"before":null,
"after":{
"id":1005,
"first_name":"foo",
"last_name":"bar",
"email":"foo@bar.com"
},
"source":{
"version":"1.2.3.Final",
"connector":"postgresql",
"name":"dbserver1",
"ts_ms":1600374991648,
"snapshot":"false",
"db":"postgres",
"schema":"public",
"table":"customers",
"txId":602,
"lsn":34088472,
"xmin":null
},
"op":"c",
"ts_ms":1600374991762,
"transaction":null
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
}
],
"optional":false,
"name":"data.cdc.dbname.Key"
},
"payload":{
"id":1005
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"before"
},
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"after"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"version"
},
{
"type":"string",
"optional":false,
"field":"connector"
},
{
"type":"string",
"optional":false,
"field":"name"
},
{
"type":"int64",
"optional":false,
"field":"ts_ms"
},
{
"type":"string",
"optional":true,
"name":"io.debezium.data.Enum",
"version":1,
"parameters":{
"allowed":"true,last,false"
},
"default":"false",
"field":"snapshot"
},
{
"type":"string",
"optional":false,
"field":"db"
},
{
"type":"string",
"optional":false,
"field":"schema"
},
{
"type":"string",
"optional":false,
"field":"table"
},
{
"type":"int64",
"optional":true,
"field":"txId"
},
{
"type":"int64",
"optional":true,
"field":"lsn"
},
{
"type":"int64",
"optional":true,
"field":"xmin"
}
],
"optional":false,
"name":"io.debezium.connector.postgresql.Source",
"field":"source"
},
{
"type":"string",
"optional":false,
"field":"op"
},
{
"type":"int64",
"optional":true,
"field":"ts_ms"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"id"
},
{
"type":"int64",
"optional":false,
"field":"total_order"
},
{
"type":"int64",
"optional":false,
"field":"data_collection_order"
}
],
"optional":true,
"field":"transaction"
}
],
"optional":false,
"name":"data.cdc.dbname.Envelope"
},
"payload":{
"before":{
"id":1005,
"first_name":"foo",
"last_name":"bar",
"email":"foo@bar.com"
},
"after":{
"id":1005,
"first_name":"egg",
"last_name":"bar",
"email":"foo@bar.com"
},
"source":{
"version":"1.2.3.Final",
"connector":"postgresql",
"name":"dbserver1",
"ts_ms":1600375609365,
"snapshot":"false",
"db":"postgres",
"schema":"public",
"table":"customers",
"txId":603,
"lsn":34089688,
"xmin":null
},
"op":"u",
"ts_ms":1600375609778,
"transaction":null
}
}
INSÄTT: värdet före (before) är lika med null, och efteråt — en sträng som har lagts till. UPPDATERA: i payload.before visar det tidigare tillståndet för raden, och i payload.after — det nya med essensen av ändringarna.2.2 MongoDB
{
"name": "mp-k8s-mongo-connector",
"config": {
"connector.class": "io.debezium.connector.mongodb.MongoDbConnector",
"tasks.max": "1",
"mongodb.hosts": "MainRepSet/mongo:27017",
"mongodb.name": "mongo",
"mongodb.user": "debezium",
"mongodb.password": "dbname",
"database.whitelist": "db_1,db_2",
"transforms": "AddPrefix",
"transforms.AddPrefix.type": "org.apache.kafka.connect.transforms.RegexRouter",
"transforms.AddPrefix.regex": "mongo.([a-zA-Z_0-9]*).([a-zA-Z_0-9]*)",
"transforms.AddPrefix.replacement": "data.cdc.mongo_$1"
}
}transforms denna gång gör följande: omvandlar namnet på den måltopic från mönstret .. på data.cdc.mongo_.Fel-tolerans
Slutsats
P.S.
