

Alla operationer med stora datamängder kräver stora beräkningsresurser. Vanlig överföring av data från en databas till Hadoop kan ta veckor eller kosta som en flygplansvinge. Vill du inte vänta och spendera? Balansera lasten över olika plattformar. Ett sätt är pushdown-optimering.
Jag bad den ledande tränaren i Ryssland för utveckling och administration av Informatica-produkter, Alexey Ananyev, att berätta om pushdown-optimeringsfunktionen i Informatica Big Data Management (BDM). Lärde ni er en gång att arbeta med Informatica-produkter? Det var förmodligen Alexey som lärde er grunderna i PowerCenter och förklarade hur man bygger mappningar.
Alexey Ananyev, chef för utbildningsavdelningen på DIS Group
Vad är pushdown?
Många av er är redan bekanta med Informatica Big Data Management (BDM). Produkten kan integrera stora data från olika källor, flytta dem mellan olika system, ge enkel åtkomst till dem, göra profiler och mycket mer.
I skickliga händer kan BDM åstadkomma underverk: uppgifter kommer att slutföras snabbt och med minimala beräkningsresurser.
Vill du också detta? Lär dig använda pushdown-funktionen i BDM för att fördela den beräkningsmässiga belastningen mellan olika plattformar. Pushdown-teknik gör det möjligt att omvandla en mappning till ett skript och välja den miljö där detta skript ska köras. Denna valmöjlighet gör att man kan kombinera styrkorna hos olika plattformar och uppnå deras maximala prestanda.
För att konfigurera exekveringsmiljön för skriptet måste du välja typ av pushdown. Skriptet kan köras helt på Hadoop eller delvis distribueras mellan källan och mottagaren. Det finns 4 möjliga typer av pushdown. Mappningen kan utföras utan att omvandlas till ett skript (native). Mappningen kan också utföras maximalt på källan (source) eller helt på källan (full). Dessutom kan mappningen omvandlas till ett Hadoop-skript (none).
Pushdown-optimering
Dessa 4 typer kan kombineras på olika sätt - optimera pushdown för specifika systembehov. Till exempel är det ofta mer fördelaktigt att extrahera data från databasen, genom att använda dess egna funktioner. Att transformera data görs bättre med Hadoop, för att undvika att överbelasta databasen.
Låt oss överväga ett fall där både källan och mottagaren finns i databasen, och plattformen för att utföra transformationerna kan väljas: beroende på inställningarna kommer det att vara Informatica, databasserver eller Hadoop. Ett sådant exempel gör det möjligt att bäst förstå den tekniska sidan av detta mekanismens arbete. Självklart uppstår en sådan situation sällan i verkliga livet, men för att demonstrera funktionaliteten passar det bäst.
Låt oss ta en mappning för att läsa två tabeller i en gemensam Oracle-databas. Resultaten av läsningen ska sparas i en tabell i samma databas. Mappningsschemat kommer att se ut så här:
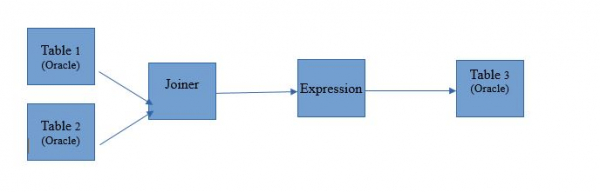
I form av mappning i Informatica BDM 10.2.1 ser det ut så här:
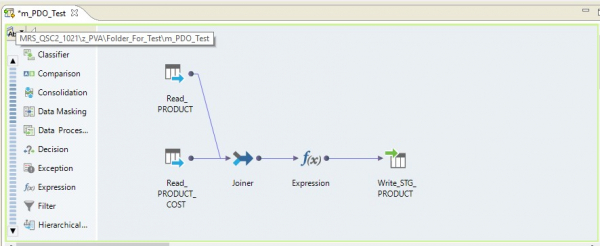
Typ pushdown – native
Om vi väljer typ pushdown native, kommer mappningen att utföras på servern Informatica. Data kommer att läsas från Oracle-servern, överföras till Informatica-servern, transformeras där och skickas till Hadoop. Med andra ord kommer vi att få en vanlig ETL-process.
Typ pushdown – source
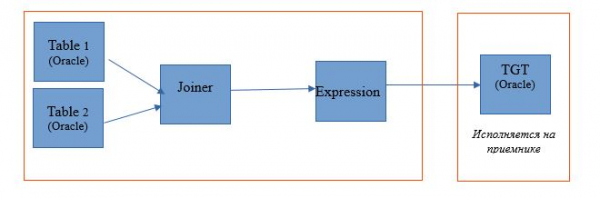
Vid val av typ source får vi möjlighet att fördela vår process mellan servern databaser (DB) och Hadoop. När processen utförs med denna inställning kommer förfrågningar att skickas till databasen för att hämta data från tabellerna. Övrigt kommer att utföras i form av steg på Hadoop.
Mappningens körschema kommer att se ut så här:
Nedan är ett exempel på inställning av exekveringsmiljön.
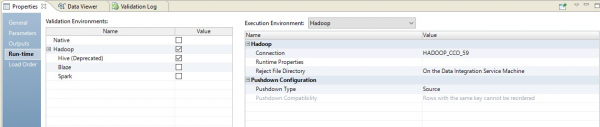
I detta fall kommer mappningen att utföras i två steg. I dess inställningar kommer vi att se att den har omvandlats till ett skript, som ska skickas till källan. Dessutom kommer sammanfogning av tabeller och datatransformation att utföras i form av en omdefinierad fråga på källan.
I bilden nedan ser vi en optimerad mappning på BDM, och på källan – en omdefinierad fråga.
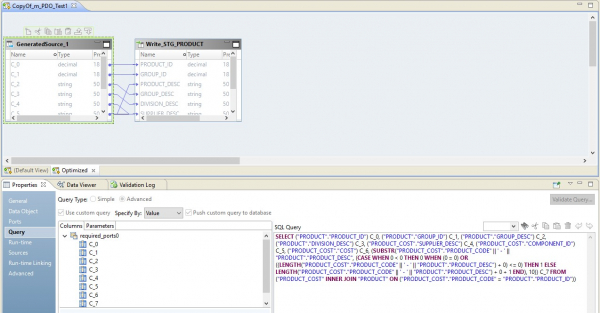
Hadoop:s roll i denna konfiguration kommer att vara att hantera datastreamen – dirigera dem. Resultatet av förfrågan kommer att skickas till Hadoop. Efter att läsningen är klar kommer filen från Hadoop att skrivas till mottagaren.
Typ pushdown – full
Vid valet av typ full kommer mappningen att omvandlas helt till en fråga på databasen. Resultatet av förfrågan kommer att skickas till Hadoop. Schemat för en sådan process presenteras nedan.
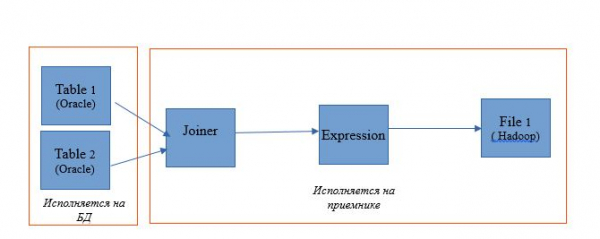
Exemplet på inställning presenteras nedan.
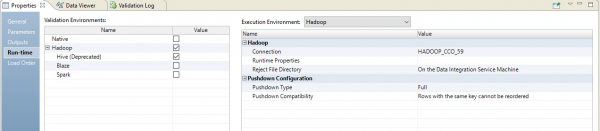
Som ett resultat kommer vi att få en optimerad mappning liknande den föregående. Skillnaden är bara att hela logiken överförs till mottagaren i form av en omdefiniering av dess insättning. Exemplet på den optimerade mappningen presenteras nedan.
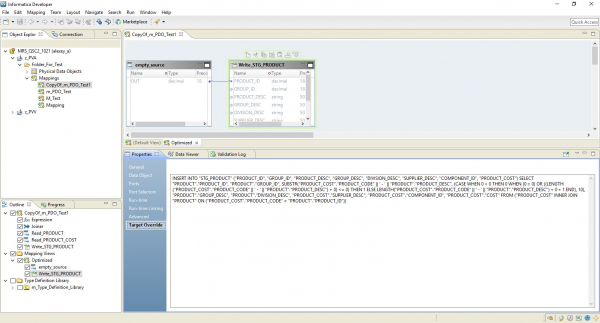
Här, precis som tidigare, fungerar Hadoop som dirigent. Men här läses källan i sin helhet, och sedan utförs logiken för databehandling på mottagarnivå.
Pushdown-typ – null
Och den sista varianten – pushdown-typ, där vår mappning omvandlas till ett skript på Hadoop.
Den optimerade mappningen kommer nu att se ut så här:
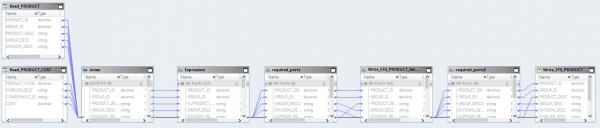
Här kommer data från källfiler först att läsas in på Hadoop. Sedan kommer dessa två filer att kombineras med hjälp av dess egna verktyg. Efter detta kommer data att omvandlas och exporteras till databasen.
Genom att förstå principerna för pushdown-optimering kan många processer för arbete med stora datamängder organiseras mycket effektivt. Så sent som nyligen lyckades ett stort företag på bara några veckor exportera stora datamängder från sitt lagringsutrymme till Hadoop, vilket de hade samlat in under flera år.
Källa: habr.com
