

Hej, Habr! Jag presenterar översättningen av artikeln
.
När det kommer till relationsdatabaser kan jag inte låta bli att tänka att det saknas något. De används överallt. Det finns många olika databaser, från den lilla och användbara SQLite till den kraftfulla Teradata. Men det finns bara några artiklar som förklarar hur en databas fungerar. Du kan själv söka på "howdoesarelationaldatabasework" för att se hur få resultat det finns. Dessutom är dessa artiklar korta. Om du letar efter de senaste trendteknologierna (BigData, NoSQL eller JavaScript) kommer du att hitta fler djupgående artiklar som förklarar hur de fungerar.
Är relationsdatabaser för gamla och tråkiga för att förklara utanför universitetskurser, forskningsartiklar och böcker?
Som utvecklare avskyr jag att använda något jag inte förstår. Och om databaser har använts i mer än 40 år måste det finnas en anledning. Under dessa år har jag spenderat hundratals timmar på att verkligen förstå dessa märkliga svarta lådor som jag använder varje dag. Relationsdatabaser är mycket intressanta, för de är baserade på användbara och återanvändbara koncept.Om du är intresserad av att förstå databaser, men aldrig haft tid eller lust att gräva ner dig i detta omfattande ämne, kommer du att gilla den här artikeln.
Även om titeln på denna artikel är tydlig, är syftet med denna artikel inte att förstå hur man använder en databas.Därför borde du redan veta hur man skriver en enkel join-fråga och grundläggande frågor; CRUDannars kanske du inte förstår den här artikeln. Det är det enda du behöver veta, jag kommer att förklara allt annat.
Jag börjar med några grundläggande datavetenskaper, såsom tidskomplexitet av algoritmer (BigO). Jag vet att vissa av er avskyr detta koncept, men utan det kan du inte förstå nyanserna i databasen. Eftersom det är ett omfattande ämne, kommer jag att fokusera på det som jag anser är viktigt.: hur databasen hanterar SQL frågan.Jag kommer bara att presentera grundläggande koncept inom databaser,så att du i slutet av artikeln har en uppfattning om vad som händer under huven.
Eftersom detta är en lång och teknisk artikel som innehåller många algoritmer och datastrukturer, ta dig tid att läsa den. Vissa begrepp kan vara svåra att förstå; du kan hoppa över dem och ändå få en allmän uppfattning.
För er som är mer insatta är denna artikel uppdelad i 3 delar:
- Översikt av lågnivå- och högnivåkomponenter i databaser
- Översikt av queryoptimeringsprocessen
- Översikt av transaktionshantering och buffertpool
Tillbaka till grunderna
För många år sedan (i en avlägsen, avlägsen galax…) var utvecklare tvungna att exakt känna till antalet operationer de kodade. De kunde sina algoritmer och datastrukturer utan och innan, eftersom de inte hade råd att slösa CPU och minne på sina långsamma datorer.
I denna del kommer jag att påminna dig om några av dessa begrepp, eftersom de är nödvändiga för att förstå databaser. Jag kommer också att introducera begreppet databasindex.
O(1) vs O(n2)
Idag bryr sig många utvecklare inte om tidskomplexiteten för algoritmer … och de har rätt!
Men när du hanterar stora mängder data (jag pratar inte om tusentals) eller om du kämpar för millisekunder, blir det kritiskt viktigt att förstå detta begrepp. Som du förstår måste databaser hantera båda situationerna! Jag kommer inte att låta dig spendera mer tid än nödvändigt för att fånga essensen. Detta kommer att hjälpa oss senare att förstå begreppet kostnadsbaserad (cost based optimization).
Konceptet
Tidskomplexiteten för en algoritm används för att se hur lång tid det tar att köra algoritmen för en viss mängd data. För att beskriva denna komplexitet används matematiska beteckningar av stor O. Denna notation används med en funktion som beskriver hur många operationer algoritmen behöver för en given mängd indatan.
Till exempel, när jag säger "denna algoritm har komplexitet O (some_function() )", betyder det att för att bearbeta en viss mängd data kräver algoritmen some_function(a_certain_amount_of_data) operationer.
Följaktligen Det är viktigt inte mängden data**, utan hur ** antalet operationer ökar med ökande datamängd. Tidskomplexiteten ger inte ett exakt antal operationer, men det är ett bra sätt att uppskatta körtiden.
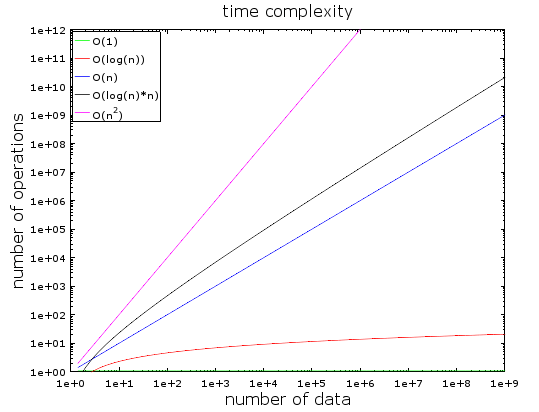
I den här grafen kan du se förhållandet mellan antalet operationer och mängden indata för olika typer av tidskomplexitet. Jag använde en logaritmisk skala för att visa dem. Med andra ord ökar mängden data snabbt från 1 till 1 miljard. Vi kan se att:
- O(1) eller konstant komplexitet förblir konstant (annars skulle det inte kallas konstant komplexitet).
- O(log(n)) förblir låg även med miljarder data.
- Den värsta komplexiteten är - O(n2), där antalet operationer växer snabbt.
- De två andra komplexiteterna ökar också snabbt.
Exempel
Vid små datamängder är skillnaden mellan O(1) och O(n2) obetydlig. Anta till exempel att du har ett algoritm som behöver bearbeta 2000 element.
- Algoritm O(1) kostar dig 1 operation
- Algoritm O(log(n)) kostar dig 7 operationer
- Algoritm O(n) kostar dig 2 000 operationer
- Algoritm O(n * log(n)) kostar dig 14 000 operationer
- Algoritm O(n2) kostar dig 4 000 000 operationer
Skillnaden mellan O(1) och O(n2) verkar stor (4 miljoner operationer) men du kommer att förlora högst 2 ms, bara tiden för att blinka. Faktiskt kan moderna processorer bearbeta . Det är därför prestanda och optimering inte är ett problem i många IT-projekt.
Som jag redan nämnt är det fortfarande viktigt att förstå detta koncept när man arbetar med stora mängder data. Om algoritmen den här gången måste bearbeta 1 000 000 element (vilket inte är så mycket för en databas):
- Algoritm O(1) kostar dig 1 operation
- Algoritm O(log(n)) kostar dig 14 operationer
- Algoritm O(n) kostar dig 1 000 000 operationer
- Algoritm O(n * log(n)) kostar dig 14 000 000 operationer
- Algoritm O(n2) kostar dig 1 000 000 000 000 operationer
Jag har inte gjort några beräkningar, men jag skulle säga att med algoritm O(n2) har du tid att ta en kaffe (till och med två!). Om du lägger till ytterligare 0 till datamängden har du tid att ta en tupplur.
Låt oss gå djupare
För referens:
- Sökning i en bra hash-tabell hittar elementet på O(1).
- Sökning i ett välbalanserat träd ger resultat på O(log(n)).
- Sökning i en array ger resultat på O(n).
- De bästa sorteringsalgoritmerna har komplexiteten O(n * log(n)).
- En dålig sorteringsalgoritm har komplexiteten O(n2).
Obs: i kommande delar kommer vi att se dessa algoritmer och datatyper.
Det finns flera typer av tidskomplexitet för algoritmer:
- medelklassens scenario
- bästa möjliga utfall
- och värsta scenariot
Tidskomplexiteten är ofta worst-case scenariot.
Jag har bara pratat om tidskomplexiteten för algoritmen, men komplexitet gäller även för:
- minnesförbrukningen för algoritmen
- disk I/O som algoritmen använder
Självklart finns det komplexiteter som är värre än n², exempelvis:
- n⁴: det är fruktansvärt! Några av de nämnda algoritmerna har en sådan komplexitet.
- 3n: det är ännu värre! En av algoritmerna som vi kommer att se mitt i den här artikeln har denna komplexitet (och den används faktiskt i många databaser).
- fakultet n: du kommer aldrig att få dina resultat ens med en liten mängd data.
- nˢ: om du stöter på denna komplexitet, bör du fråga dig själv om detta verkligen är ditt område ...
Obs: jag gav dig inte en verklig definition av beteckningen 'stor O', utan bara en idé. Du kan läsa den här artikeln för den verkliga (asymptotiska) definitionen.
MergeSort (Sammanslagningssortering)
Vad gör du när du behöver sortera en samling? Vad? Du anropar funktionen sort() ... Okej, bra svar ... Men för databaser måste du förstå hur den här funktionen sort() fungerar.
Det finns flera bra sorteringsalgoritmer, så jag kommer att fokusera på den viktigaste: sammanslagningssorteringen. Du kanske inte förstår varför datorsortering är användbart just nu, men du kommer att förstå det efter delen som handlar om optimering av frågor. Dessutom kommer förståelsen av sammanslagningssortering att hjälpa oss senare att förstå den allmänna operationen join i databaser, som kallas merge join (sammanslagningsjoin).
Merge (slå ihop)
Som många användbara algoritmer bygger sammanslagningssortering på en finess: att slå samman 2 sorterade arrayer med storleken N / 2 till en sorterad array med N element kostar bara N operationer. Denna operation kallas sammanslagning.
Låt oss titta på vad det här betyder genom ett enkelt exempel:
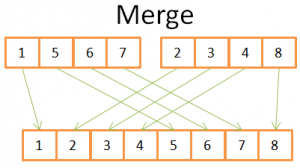
I denna bild ser du att för att bygga den slutliga sorterade arrayen med 8 element behöver du bara utföra en iteration över 2 st 4-elementarrayer. Eftersom båda 4-elementarrayerna redan är sorterande:
- 1) du jämför de aktuella elementen i de två arrayerna (i början är den aktuella = första)
- 2) ta sedan tar du den minsta för att placera den i en array med 8 element
- 3) och går vidare till nästa element i arrayen där du tog den minsta elementet
- och upprepa 1, 2, 3, tills du kommer till det sista elementet i en av arrayerna.
- Sedan tar du de återstående elementen från den andra arrayen för att placera dem i en array med 8 element.
Detta fungerar eftersom båda 4-element arrayerna är sorterade, och därför behöver du inte 'gå tillbaka' i dessa arrayer.
Nu när vi förstått detta trick, här är min pseudokod för merge:
array mergeSort(array a)
   if(length(a)==1)
      return a[0];
   end if

   //rekursiva anrop
   [left_array right_array] := split_into_2_equally_sized_arrays(a);
   array new_left_array := mergeSort(left_array);
   array new_right_array := mergeSort(right_array);

   //sammanfogar de 2 små sorterade arrayerna till en stor
   array result := merge(new_left_array,new_right_array);
   return result;
Merge sort delar upp problemet i mindre problem, och hittar sedan resultaten av de mindre problemen för att få resultatet av det ursprungliga problemet (notera: denna typ av algoritmer kallas dela och härska). Om du inte förstår denna algoritm, oroa dig inte; jag förstod det inte första gången jag såg det. Om det kan hjälpa dig, ser jag denna algoritm som en tvåfas algoritm:
- Delningsfas, där arrayen delas upp i mindre arrayer
- Sorteringsfas, där små arrayer sammanfogas (använder merge) för att bilda en större array.
Delningsfas (Division phase)
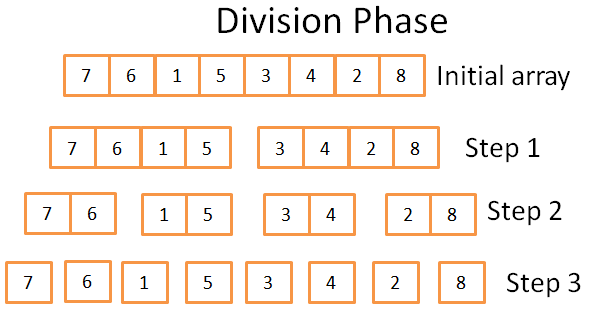
I delningsfasen delas arrayen upp i enhetsarrayer i 3 steg. Det formella antalet steg är log(N) (eftersom N=8, log(N) = 3).
Hur vet jag detta?
Jag är ett geni! Kort sagt — matematik. Idén är att varje steg minskar storleken på den ursprungliga arrayen med hälften. Antalet steg är det antal gånger du kan dela den ursprungliga arrayen i två. Detta är den exakta definitionen av logaritmen (med bas 2).
Sorteringsfas (Sorting phase)
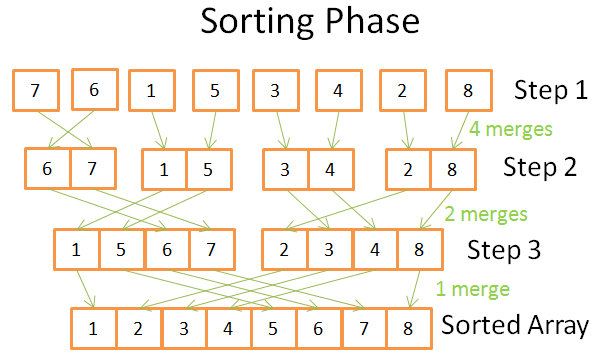
I sorteringsfasen börjar du med enhetsarrayer (enskilda element). Under varje steg tillämpar du ett antal sammanslagningsoperationer, och den totala kostnaden är N = 8 operationer:
- I det första steget har du 4 sammanslagningar som kostar 2 operationer vardera
- I det andra steget har du 2 sammanslagningar som kostar 4 operationer vardera
- I det tredje steget har du 1 sammanslagning som kostar 8 operationer
Eftersom det finns log(N) steg, den totala kostnaden N * log(N) operationer.
Fördelar med merge sort
Varför är denna algoritm så kraftfull?
För att:
- Du kan ändra den för att minska minnesanvändningen, så att du inte skapar nya arrayer, utan direkt ändrar den inmatade arrayen.
Observera: denna typ av algoritmer kallas (sortering utan extra minne).
- Du kan ändra den för att använda diskutrymme och ett litet minnesutrymme utan stora kostnader för disk in / ut. Idén är att ladda i minnet endast de delar som för närvarande bearbetas. Detta är viktigt när du behöver sortera en tabell som är flera gigabyte stor med en minnesbuffer på bara 100 megabyte.
Observera: denna typ av algoritmer kallas .
- Du kan ändra den för att köras på flera processer / trådar / servrar.
Till exempel är distribuerad sammanslagning av sortering en av nyckelkomponenterna (som är en struktur inom stora data).
- Denna algoritm kan förvandla bly till guld (verkligen!).
Denna sorteringsalgoritm används i de flesta (om inte alla) databaser, men den är inte den enda. Om du vill veta mer kan du läsa detta , som diskuterar för- och nackdelar med de vanligaste sorteringsalgoritmerna i databaser.
Array, Träd och Hash-Tabell
Nu när vi förstår idén om tidskomplexitet och sortering, måste jag berätta om 3 datatyper. Detta är viktigt eftersom de är grunden för moderna databaser. Jag kommer också att introducera begreppet databasindex.
Array
En tvådimensionell array är den enklaste datatypen. En tabell kan ses som en array. Till exempel:
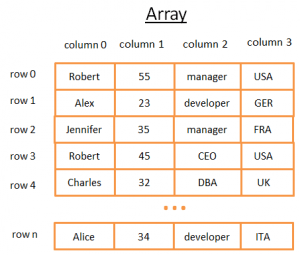
Denna 2D-array representerar en tabell med rader och kolumner:
- Varje rad representerar en enhet
- Kolumnerna lagrar egenskaper som beskriver enheten.
- Varje kolumn lagrar data av en viss typ (heltal, sträng, datum ...).
Det är så bekvämt att lagra och visualisera data, men när du behöver hitta ett visst värde fungerar det inte.
Till exempel, om du vill hitta alla killar som arbetar i Storbritannien måste du gå igenom varje rad för att avgöra om den raden tillhör Storbritannien. Det kommer att kosta dig N operationer, där N — antal rader, vilket är bra, men kan det finnas en snabbare väg? Nu är det dags att bekanta oss med träd.
Observera: de flesta moderna databaser erbjuder utökade matriser för effektiv lagring av tabeller: heap-organized tables och index-organized tables. Men det löser inte problemet med snabb sökning av ett specifikt villkor i en grupp av kolumner.
Databasträd och index
Ett binärt sökträd är ett binärt träd med en speciell egenskap, nyckeln i varje nod måste vara:
- större än alla nycklar som lagras i den vänstra underträdet
- mindre än alla nycklar som lagras i den högra underträdet
Låt oss se vad detta betyder visuellt
Tanken
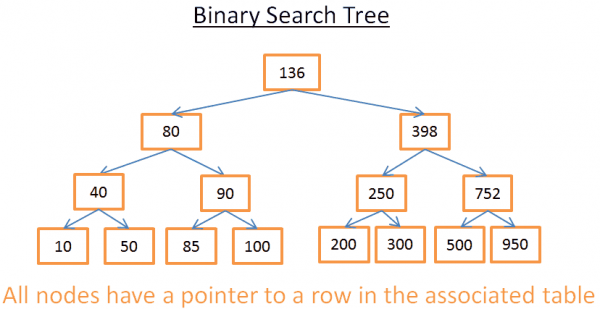
Detta träd har N = 15 element. Anta att jag letar efter 208:
- Jag börjar med roten, vars nyckel är 136. Eftersom 136<208, tittar jag på den högra underträdet av noden 136.
- 398>208, därför tittar jag på den vänstra underträdet av noden 398
- 250>208, därför tittar jag på den vänstra underträdet av noden 250
- 200<208, därför tittar jag på den högra underträdet av noden 200. Men 200 har inget högra underträd, värdet existerar inte (eftersom om det fanns, skulle det vara i det högra underträdet av 200).
Nu, låt oss säga att jag letar efter 40
- Jag börjar med roten, vars nyckel är 136. Eftersom 136 > 40, tittar jag på den vänstra underträdet av noden 136.
- 80 > 40, därför tittar jag på den vänstra underträdet av noden 80
- 40= 40, noden existerar. Jag hämtar radens identifierare inom noden (detta finns inte på bilden) och tittar i tabellen för den angivna radidentifieraren.
- Genom att känna till radens identifierare kan jag veta exakt var data finns i tabellen, och därför kan jag få åtkomst till dem omedelbart.
I slutändan kommer båda sökningarna att kosta mig antal nivåer inom trädet. Om du noggrant läser delen om merge sort, bör du se att det finns log (N) nivåer här. Det visar sig att sökkostnaden är log(N), inte dåligt!
Återkommer till vårt problem
Men detta är mycket abstrakt, så låt oss återgå till vårt problem. Istället för en enkel integer, tänk er en sträng som representerar någon landsnamn i den tidigare tabellen. Anta att du har ett träd som innehåller fältet "country" (kolumn 3) i tabellen:
- Om du vill veta vem som arbetar i Storbritannien
- tittar du på trädet för att få noden som representerar Storbritannien
- inuti "UKnode" hittar du platsen för arbetstagarnas poster i Storbritannien.
Denna sökning kommer att kosta log(N) operationer istället för N operationer om du använder en array direkt. Det du just har presenterat var databasindex.
Du kan bygga ett indexträd för vilken grupp av fält som helst (sträng, tal, 2 strängar, tal och sträng, datum…) så länge du har en funktion för att jämföra nycklar (dvs. grupper av fält) så att du kan ställa in ordningen bland nycklarna (vilket gäller för alla grundläggande typer i databasen).
B+TreeIndex
Även om detta träd fungerar bra för att få ett specifikt värde, finns det ett STORT problem när du behöver hämta flera element mellan två värden. Det kommer att kosta O(N) eftersom du måste titta på varje nod i trädet och kontrollera om den ligger mellan dessa två värden (t.ex. med en ordnad genomgång av trädet). Dessutom är denna operation inte praktisk för disk I/O eftersom du måste läsa hela trädet. Vi behöver hitta ett sätt att effektivt utföra intervalförfrågan. För att lösa detta problem använder moderna databaser en modifierad version av det tidigare trädet som kallas B+Tree. I B+Tree trädet:
- endast de lägsta noderna (blad) lagrar information (platsen för rader i den relaterade tabellen)
- de andra noderna finns här för att dirigera till rätt nod under sökningen.
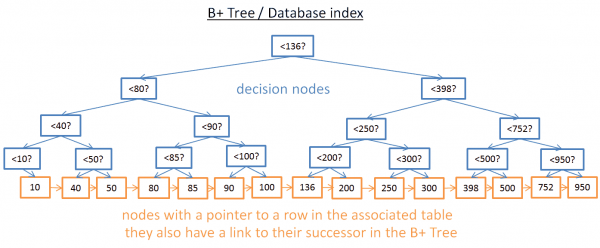
Som du kan se finns det fler noder här (dubbelt så många). Faktiskt har du ytterligare noder, "beslutsnoder", som hjälper dig att hitta rätt nod (som lagrar platsen för raderna i den relaterade tabellen). Men sökningens komplexitet är fortfarande O(log(N)) (det finns bara en nivå till). Den stora skillnaden är att noderna på den lägre nivån är kopplade till sina efterträdare.
Med detta B+Tree, om du söker efter värden mellan 40 och 100:
- Du behöver bara söka efter 40 (eller det närmaste värdet efter 40, om 40 inte finns), precis som du gjorde med det tidigare trädet.
- Samla sedan in efterträdarna till 40 genom att använda direkta länkar till efterträdarna tills du når 100.
Antag att du hittade M efterträdare, och trädet har N noder. Att söka efter en specifik nod kostar log(N) precis som det tidigare trädet. Men efter att ha fått denna nod får du M efterträdare i M operationer med länkar till deras efterträdare. Denna sökning kostar bara M+log(N) operationer jämfört med N operationer med det tidigare trädet. Dessutom behöver du inte läsa hela trädet (bara M + log (N) noder), vilket innebär mindre diskanvändning. Om M är litet (till exempel 200 rader) och N stort (1 000 000 rader) kommer detta att göra en STOR skillnad.
Men här finns nya problem (igen!). Om du lägger till eller tar bort en rad i databasen (och därmed i den relaterade B+Tree-indexet):
- du måste upprätthålla ordningen mellan noderna inom B+Tree, annars kan du inte hitta noder inom ett osorterat träd.
- du måste behålla det minimi möjliga antalet nivåer i B+Tree, annars kommer tidskomplexiteten i O(log(N)) att bli O(N).
Med andra ord måste B+Tree vara självordnande och balanserad. Lyckligtvis är detta möjligt med smarta borttagnings- och insättningsoperationer. Men detta kostar mycket: insättning och borttagning i B+ trädet kostar i O(log(N)). Det är därför vissa av er har hört att använda för många index inte är en bra idé.Verkligen, du saktar ner snabb insättning/uppdatering/borttagning av en rad i tabellen, eftersom databasen måste uppdatera tabellens index med den dyra operationen O(log(N)) för varje index. Dessutom innebär tillägg av index en större belastning för transaktionshanteraren (kommer att beskrivas i slutet av artikeln).
För mer information kan du se artikeln på Wikipedia om . Om du vill ha ett exempel på implementering av B+Tree i databasen, kolla och från huvudutvecklaren av MySQL. De är båda inriktade på hur InnoDB (MySQL-motorn) hanterar index.
Obs: läsaren sa mig att på grund av lågnivåoptimeringar måste B+ trädet vara helt balanserat.
Hash-tabell
Vår sista viktiga datastruktur är hash-tabellen. Den är mycket användbar när du vill snabbt söka efter värden. Dessutom hjälper förståelsen av hash-tabellen oss senare att förstå en allmän databasinoperation som kallas hash-join ( hash join). Denna datastruktur används också av databasen för att lagra vissa interna saker (till exempel, låsnings-tabell eller bufferpool, vi kommer att se båda dessa begrepp senare).
En hash-tabell är en databasstruktur som snabbt hittar ett element utifrån dess nyckel. För att skapa en hash-tabell måste du definiera:
- nyckel för dina element
- hash-funktion för nycklarna. Beräknade hashes av nycklarna ger platsen för elementen (kallade segment) ).
- en funktion för att jämföra nycklar.När du har hittat rätt segment måste du hitta elementet du söker inuti segmentet med hjälp av denna jämförelse.
Ett enkelt exempel
Låt oss ta ett illustrativt exempel:
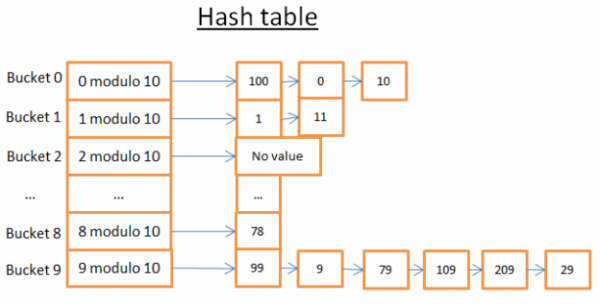
Denna hash-tabell har 10 segment. Eftersom jag är lat, har jag ritat endast 5 segment, men jag vet att ni är smarta, så jag låter er föreställa er de andra 5 själva. Jag använde en hash-funktion med mod 10 på nyckeln. Med andra ord, jag behåller endast sista siffran av elementets nyckel för att hitta dess segment:
- om den sista siffran är 0, går elementet till segment 0,
- om den sista siffran är 1, går elementet till segment 1,
- om den sista siffran är 2, går elementet till segment 2,
- …
Jämförelsefunktionen jag använde är helt enkelt jämlikhet mellan två heltal.
Anta att du vill hämta elementet 78:
- Hash-tabellen beräknar hash-koden för 78, vilket är 8.
- Hash-tabellen letar i segment 8, och det första elementet den hittar är 78.
- Den returnerar elementet 78 till dig.
- Sökningen kostade bara 2 operationer (en för att beräkna värdet av hash-funktionen och en annan för att hitta elementet inuti segmentet).
Nu, låt oss säga att du vill hämta elementet 59:
- Hash-tabellen beräknar hash-koden för 59, vilket är 9.
- Hash-tabellen letar i segment 9, det första hittade elementet är 99. Eftersom 99!=59 är elementet 99 inte det rätta elementet.
- Med samma logik tas det andra elementet (9), det tredje (79), …, och så vidare tills det sista (29).
- Elementet hittades inte.
- Sökningen kostade 7 operationer..
En bra hash-funktion
Som ni ser, beroende på det värde ni söker, är kostnaden inte densamma!
Om jag nu ändrar hash-funktionen till modul 1 000 000 av nyckeln (det vill säga, tar de senaste 6 siffrorna), kommer den andra sökningen bara kosta 1 operation, eftersom det i segment 000059 inte finns några element. Den verkliga uppgiften är att hitta en bra hash-funktion som skapar segment som innehåller ett mycket litet antal element..
I mitt exempel är det lätt att hitta en bra hash-funktion. Men det är ett enkelt exempel, att hitta en bra hash-funktion är svårare när nyckeln är:
- en sträng (till exempel - efternamn)
- 2 strängar (till exempel - efternamn och förnamn)
- 2 strängar och ett datum (till exempel - efternamn, förnamn och födelsedatum)
- …
Med en bra hash-funktion kostar uppslagning i hash-tabellen O(1).
Array vs hash-tabell
Varför inte använda en array?
Hmm, bra fråga.
- Hash-tabellen kan vara delvis inläst i minnet, medan andra segment kan kvarstå på disken.
- Med en array måste du använda ett sammanhängande utrymme i minnet. Om du laddar en stor tabell är det mycket svårt att hitta tillräckligt sammanhängande utrymme.
- För en hash-tabell kan du välja nyckel (till exempel, landet och personens efternamn).
För ytterligare information kan du läsa artikeln om , som är en effektiv implementation av hash-tabellen; du behöver inte förstå Java för att förstå de koncept som beskrivs i den här artikeln.
Källa: habr.com
