

Hej, Habr!
Efter nyårshelgerna har vi startat om det katastrofsäkra molnet baserat på två platser. Idag berättar vi hur det är uppbyggt och visar vad som händer med kundernas virtuella maskiner vid fel på enskilda klusterelement och ett helt områdes nedgång (spoiler – de fungerar fortfarande bra).
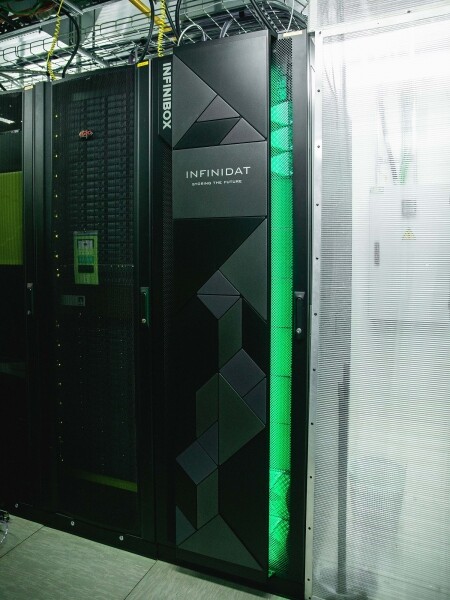
Lagringssystemet för det katastrofsäkra molnet på OST-platsen.
Vad finns inuti
Under huven på klustret finns servrar från Cisco UCS med hypervisor VMware ESXi, två INFINIDAT InfiniBox F2240-lagringssystem, nätverksutrustning från Cisco Nexus samt SAN-kontroller från Brocade. Klustret är distribuerat över två platser – OST och NORD, vilket innebär att varje datacenter har en identisk uppsättning av utrustning. Det är det som gör det katastrofsäkert.
Inom en plats är också huvudkomponenterna duplicerade (värdmaskiner, SAN-switchar, nätverksutrustning).
De två platserna är kopplade med dedikerade fiberoptiska linjer, som också är reservkopplade.
Några ord om lagringssystemet. Den första versionen av det katastrofsäkra molnet byggde vi på NetApp. Här valde vi INFINIDAT, och här är varför:
- Active-Active replikering. Den möjliggör att en virtuell maskin förblir verksam även vid fullständig nedgång av ett av lagringssystemen. Jag kommer att berätta mer om replikeringen senare.
- Tre diskontrollerare för att öka systemets felresistens. Vanligtvis finns det två.
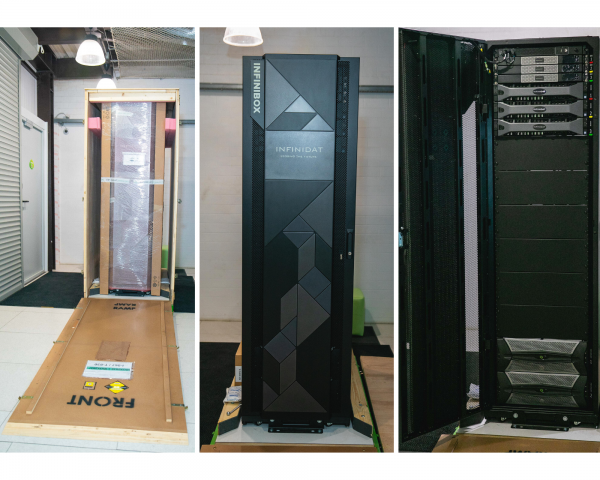
- Färdigt lösning. En redan monterad rack kom till oss, som bara behöver kopplas till nätverket och konfigureras.
- Uppmärksam teknisk support. INFINIDAT:s ingenjörer analyserar ständigt loggar och händelser från lagringssystemet, installerar nya versioner av firmware och hjälper till med konfiguration.
Här är några bilder från unpacking:
Hur det fungerar
Molnet är redan internt katastrofsäkert. Det skyddar kunden mot enskilda hårdvaru- och programvarufel. Det katastrofsäkra molnet hjälper till att skydda mot massfel i en enda plats: till exempel fel på lagringssystemet (eller SDS-kluster, vilket ofta förekommer 🙂), massor av fel i lagringsnätverket och så vidare. Och det viktigaste: ett sådant moln räddar när en hel plats blir otillgänglig på grund av brand, strömavbrott, raiderövergrepp eller invasionsförsök av utomjordingar.
I alla dessa fall fortsätter kundernas virtuella maskiner att arbeta, och här är varför.
Klustrets schema är uppbyggd så att varje ESXi-värd med klientvirtualiseringar kan nå antingen av de två lagringssystemen. Om lagringssystemet på OST-platsen skulle krascha fortsätter de virtuella maskinerna att fungera: värdarna, där de körs, kommer att hämta data från lagringssystemet på NORD.
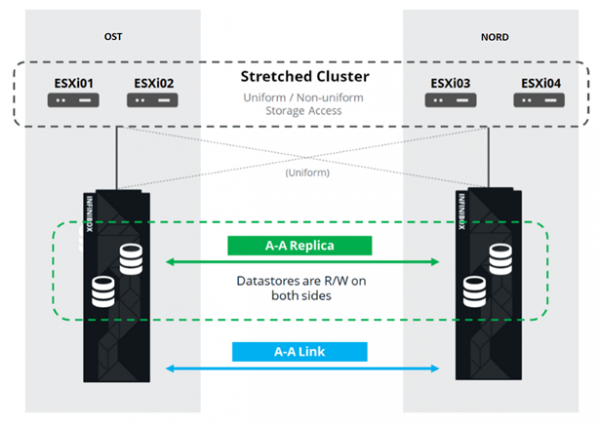
Så här ser anslutningsschemat i klustret ut.
Detta är möjligt tack vare att det mellan SAN-fabrikerna på de två platserna är inställt Uplink mellan switcharna: SAN-switch Fabric A OST är ansluten till SAN-switch Fabric A NORD, likadant för SAN-switcharna Fabric B.
För att alla dessa komplicerade nätverk av SAN-fabriker ska ha mening är en Active-Active-replikering inställd mellan de två lagringssystemen: information spelas in nästan samtidigt på det lokala och det avlägsna lagringssystemet, RPO=0. Detta innebär att det på ett lagringssystem finns en originaldata medan det på det andra finns en replik. Data replikeras på volymnivå av lagringssystemet, och på dessa lagras data från VM (dess diskar, konfigurationsfil, swap-fil osv.).
ESXi-värden ser den primära volymen och dess replik som en enda lagringsenhet (Storage Device). Från ESXi-värden går det 24 vägar till varje lagringsenhet:
12 vägar kopplar den till det lokala lagringssystemet (optimala vägar), och de övriga 12 till det avlägsna (inte optimala vägar). Under normala förhållanden hämtar ESXi data från det lokala lagringssystemet med hjälp av de "optimala" vägarna. Om detta lagringssystem skulle krascha förlorar ESXi de optimala vägarna och byter till de "inte optimala". Så här ser det ut i schemat.
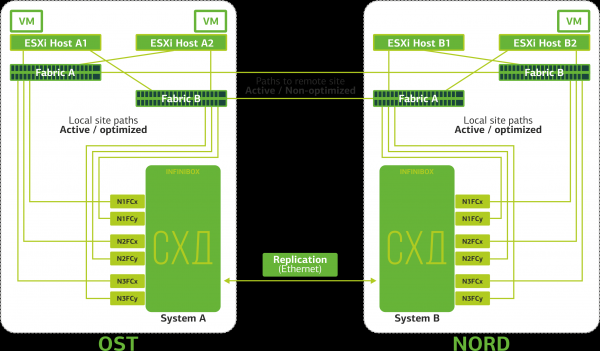
Schema för katastrofsäker kluster.
Alla klientnätverk är anslutna till båda platserna via en gemensam nätverksfabrik. På varje plats finns en Provider Edge (PE), där klienternas nätverk termineras. PE:erna är sammanlänkade i ett gemensamt kluster. Vid fel på PE på en plats omdirigeras all trafik till den andra platsen. Tack vare detta förblir de virtuella maskinerna på den plats som inte har PE tillgängliga via nätverket för kunden.
Låt oss nu titta på vad som händer med kundens virtuella maskiner vid olika fel. Vi börjar med de lättaste alternativen och slutar med den mest allvarliga – ett fel på hela platsen. I exemplen kommer den primära platsen att vara OST, och den reservplats med datareplicationer kommer att vara NORD.
Vad händer med kundens virtuella maskin om…
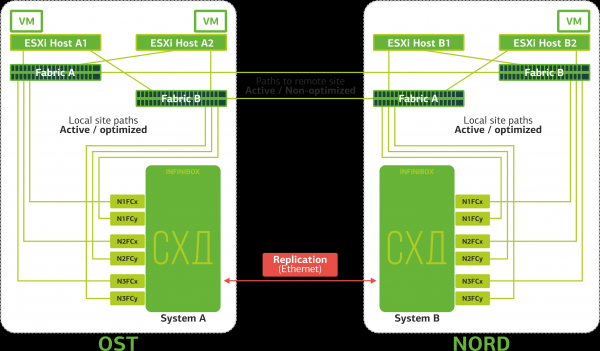
Replicationslänken faller. Replikationen mellan lagringssystemen på de två platserna upphör.
ESXi kommer bara att fungera med lokala lagringsenheter (enligt optimala vägar).
De virtuella maskinerna fortsätter att fungera.
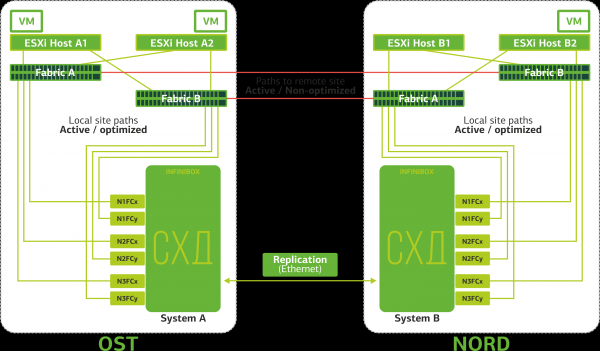
Det sker ett avbrott i ISL (Inter-Switch Link). Detta är osannolikt. Om en galen grävmaskin skulle gräva upp flera optiska spår som löper oberoende rutter och är anslutna till plattformarna via olika ingångar. Men i så fall. I detta fall förlorar ESXi-värdar hälften av vägarna och kan bara nå sina lokala SAN. Replikerna samlas, men värdarna kommer inte att kunna nå dem.
De virtuella maskinerna fungerar som vanligt.
SAN-switchen på en av plattformarna har slutat fungera. ESXi-värdar tappar en del av vägarna till SAN. I detta fall kommer värdarna på plattformen där switchen har slutat fungera att arbeta endast genom sin egen HBA.
De virtuella maskinerna fortsätter att fungera som vanligt.
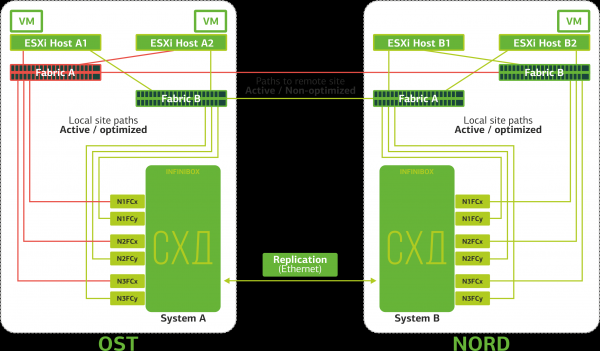
Alla SAN-switchar på en av plattformarna har slutat fungera. Antag att en sådan katastrof inträffade på plattformen OST. I så fall kommer ESXi-värdarna på denna plattform att förlora alla vägar till sina lagringsenheter. Den standardmekanism som VMware vSphere HA har startas: den kommer att omstarta alla virtuella maskiner på plattformen OST i NORD senast inom 140 sekunder.
De virtuella maskinerna som körs på värdarna på plattformen NORD fungerar som vanligt.
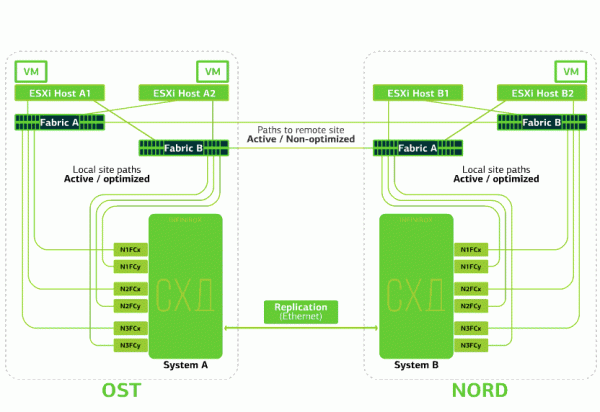
En ESXi-värd på en plattform har slutat fungera. Här arbetar mekanismen vSphere HA igen: de virtuella maskinerna från den kraschade värden omstartas på andra värdar – på samma eller en avlägsen plattform. Starttiden för den virtuella maskinen – upp till 1 minut.
Om alla ESXi-värdar på plattformen OST slutar fungera, finns det inget val: VM:erna omstartas på en annan. Starttiden är densamma.
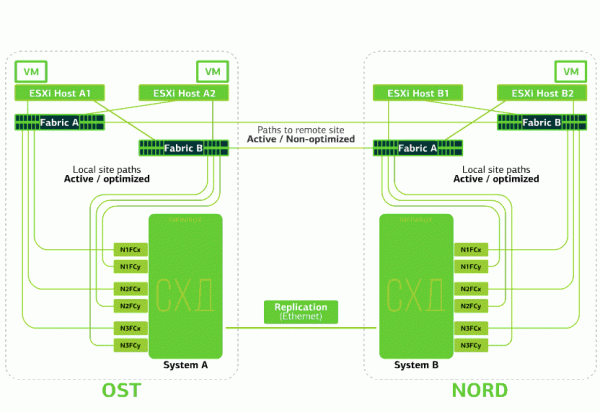
SAN har slutat fungera på en plattform. Antag att SAN har slutat fungera på plattformen OST. Då växlar ESXi-värdarna på plattformen OST till att arbeta med repliker av SAN i NORD. Efter att den kraschade SAN har återställts kommer en tvingad replikering att ske, och ESXi-värdarna OST kommer att börja nå den lokala SAN igen.
De virtuella maskinerna fungerar hela tiden som vanligt.
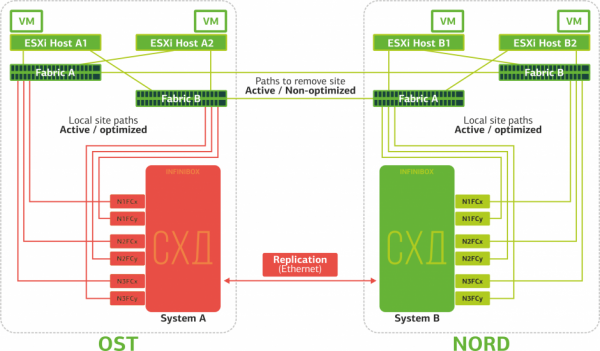
En av plattformarna har slutat fungera. I detta fall kommer alla virtuella maskiner att omstartas på en reservplattform via mekanismen vSphere HA. Starttiden för VM är 140 sekunder. Under tiden kommer alla nätverksinställningar för den virtuella maskinen att bevaras, och den förblir tillgänglig för kunden via nätverket.
För att omstarten av maskinerna på den reservplatsen ska gå smidigt, är varje plats endast halvfull. Den andra halvan är en reserv ifall alla virtuella maskiner behöver flyttas från den andra, drabbade platsen.
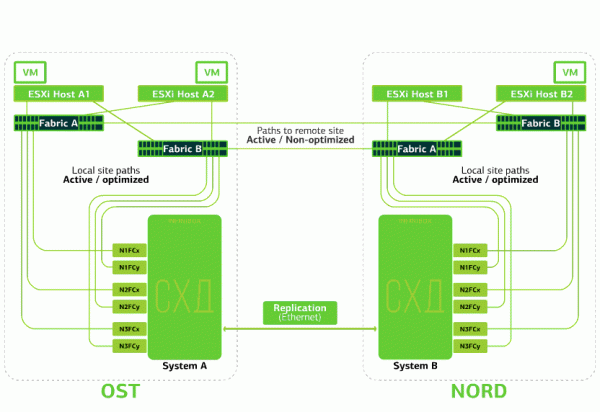
Det är detta som det katastrofresistenta molnet baserat på två datacenter skyddar mot.
Detta nöje är inte billigt, eftersom man, utöver de grundläggande resurserna, behöver en reserv på den andra platsen. Därför placeras affärskritiska tjänster i ett sådant moln, vars långa driftstopp orsakar stora ekonomiska och reputationsförluster, eller om det finns krav på katastrofresistens från reglerande myndigheter eller interna regler inom företaget.
Källor:
Källa: habr.com
