

Data Science för nybörjare
1. Sentimentanalys (Analys av känslor genom text)
Se den kompletta implementationen av Data Science-projektet med hjälp av källkoden — .
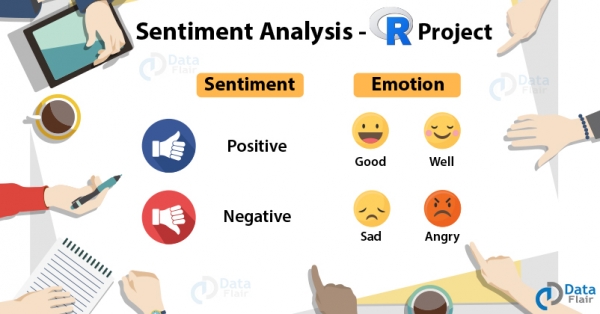
Sentimentanalys — är analys av ord för att bestämma känslor och åsikter som kan vara positiva eller negativa. Detta är en typ av klassificering där klasserna kan vara binära (positiva och negativa) eller flera (glada, arga, ledsna, avskyvärda ...). Vi kommer att implementera detta Data Science-projekt på språket R och använda ett dataset i paketet "janeaustenR". Vi kommer att använda allmänna ordböcker som AFINN, bing och loughran, utföra inre anslutningar, och i slutet kommer vi att skapa ett ordmoln för att visualisera resultatet.
Språk: R
Dataset/Paket: janeaustenR
Artikeln är översatt med stöd av företaget EDISON Software, som , samt .
2. Upptäckta falska nyheter (Fake News Detection)
Ta dina färdigheter till nästa nivå genom att arbeta på Data Science-projekt för nybörjare — .
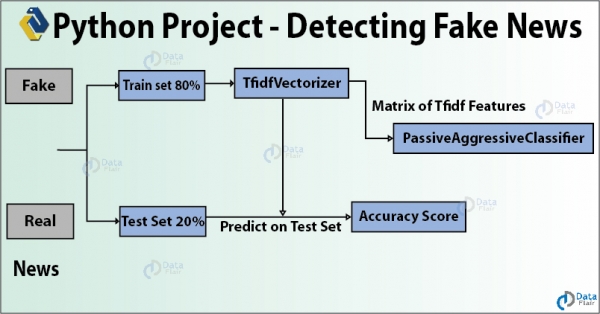
Falska nyheter är falsk information som sprids genom sociala medier och andra nätverksmedia för att uppnå politiska mål. I denna projektidé inom Data Science kommer vi att använda Python för att bygga en modell som kan exakt avgöra om en nyhet är äkta eller falsk. Vi kommer att skapa en TfidfVectorizer och använda PassiveAggressiveClassifier för att klassificera nyheter som "äkta" eller "falska". Vi kommer att använda datasetet i formatet 7796 × 4 och genomföra allt i Jupyter Lab.
Språk: Python
Dataset/Paket: news.csv
3. Upptäckte Parkinsons sjukdom (Detecting Parkinson’s Disease)
Gå vidare genom att arbeta på projektidéen Data Science Project Idea — .
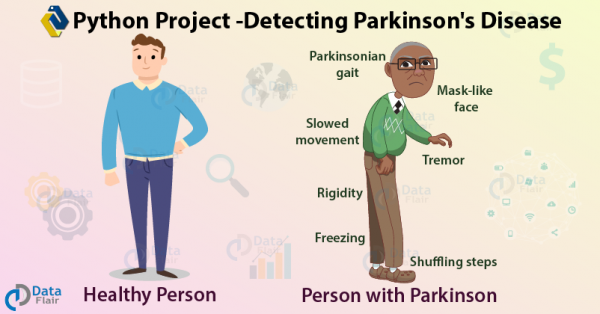
Vi började använda Data Science för att förbättra hälsovården och tjänster — om vi kan förutsäga sjukdomar i ett tidigt skede, får vi många fördelar. Så i denna projektidé för Data Science kommer vi att lära oss att upptäcka Parkinsons sjukdom med Python. Det är en neurodegenerativ, progressiv sjukdom i centrala nervsystemet som påverkar rörelsen och orsakar skakningar och stelhet. Det påverkar dopaminproducerande neuroner i hjärnan, och varje år påverkar det mer än 1 miljon människor i Indien.
Språk: Python
Dataset/Paket: UCI ML Parkinsons dataset
Data Science-projekt av medelsvår svårighetsgrad
4. Talemotionsigenkänning (Speech Emotion Recognition)
Bekanta dig med den fullständiga implementeringen av Data Science-projektet — .
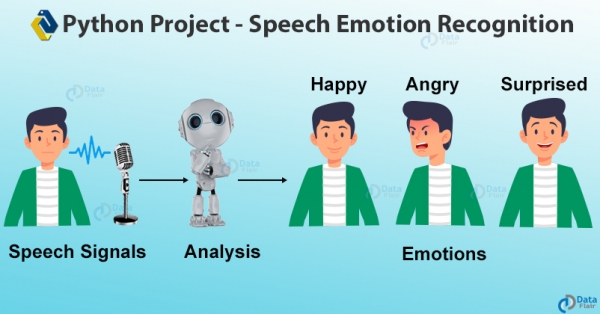
Låt oss nu lära oss att använda olika bibliotek. Detta Data Science-projekt använder librosa för röstigenkänning. SER är processen för att identifiera mänskliga känslor och affektiva tillstånd genom tal. Eftersom vi använder ton och tonhöjd för att uttrycka känslor med rösten är SER relevant. Men eftersom känslor är subjektiva är ljudannotering en komplex uppgift. Vi kommer att använda funktionerna mfcc, chroma och mel och använda RAVDESS-datasetet för känsligenkänning. Vi kommer att skapa en MLPC-klassificerare för denna modell.
Språk: Python
Dataset/Paket: RAVDESS-datasetet
5. Köns- och åldersdetektering
Imponera på arbetsgivare med det senaste Data Science-projektet — .
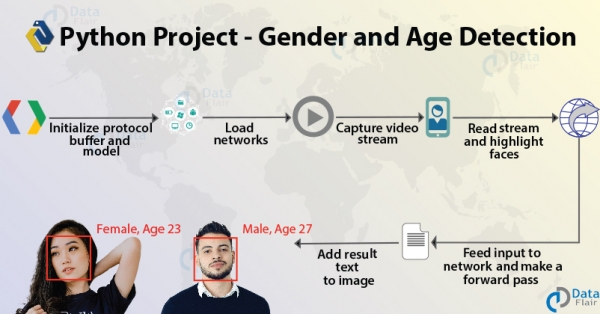
Detta är ett intressant Data Science-projekt med Python. Genom att använda bara en bild kommer du att lära dig att förutsäga en persons kön och ålder. I detta projekt introducerar vi dig till datorseende och dess principer. Vi kommer att bygga en och använda modellerna som tränats av Tal Hassner och Gil Levi för Adience-datasetet. På vägen kommer vi att använda några filer .pb, .pbtxt, .prototxt och .caffemodel.
Språk: Python
Dataset/Paket: Adience
6. Uber-dataanalys
Se den fullständiga implementeringen av Data Science-projektet med källkod — .
Detta är ett datavisualiseringsprojekt med ggplot2 där vi kommer att använda R och dess bibliotek för att analysera olika parametrar. Vi kommer att använda datasetet Uber Pickups i New York och skapa visualiseringar för olika tidsramar under året. Detta visar hur tid påverkar kundresor.
Språk: R
Dataset/Paket: Uber Pickups i New York City-datasetet
7. Detektering av förares sömnighet
Utveckla dina färdigheter genom att arbeta med Top Data Science Project — .
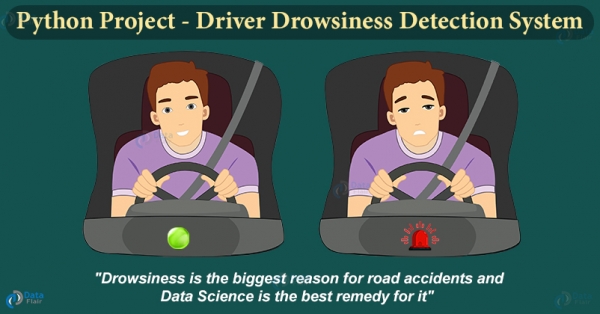
Sömnigt körande är extremt farligt, och varje år inträffar cirka tusen olyckor på grund av att förare somnar under körningen. I detta Python-projekt kommer vi att skapa ett system som kan upptäcka trötta förare och varna dem med ett ljudsignaler.
Detta projekt är genomfört med hjälp av Keras och OpenCV. Vi kommer att använda OpenCV för att upptäcka ansikten och ögon, och med Keras kommer vi att klassificera ögats tillstånd (Öppet eller Stängt) med hjälp av metoder för djupa neurala nätverk.
8. Chattbot
Skapa en chattbot med Python och ta ett steg framåt i din karriär — .
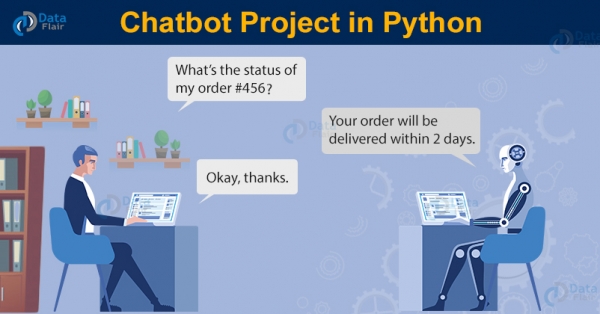
Chattbottar är en integrerad del av företag. Många företag behöver erbjuda tjänster till sina kunder, och för att kunna göra detta krävs mycket arbetskraft, tid och ansträngning. Chattbottar kan automatisera en stor del av kundinteraktionen genom att svara på vanliga frågor som kunder ställer. Det finns i huvudsak två typer av chattbottar: Domänspecifika och Öppna domäner. Domänspecifika chattbottar används ofta för att lösa specifika problem. Därför behöver du anpassa dem för att fungera effektivt inom ditt område. Öppna domänchattbottar kan ställas vilka frågor som helst, därför krävs en stor mängd data för deras träning.
Datasett: Intents json-fil
Språk: Python
Avancerade Data Science-projekt
9. Bildbeskrivningsgenerator
Kontrollera den fullständiga implementeringen av projektet med källkod — .
Att beskriva vad som finns på en bild är en lätt uppgift för människor, men för datorer är en bild bara en uppsättning siffror som representerar färgvärdet för varje pixel. Det är en svår uppgift för datorer. Att förstå vad som finns i en bild och sedan skapa en beskrivning på naturligt språk (t.ex. på engelska) är en annan svår utmaning. Detta projekt använder metoder för djupinlärning där vi implementerar ett konvolutionellt neuralt nätverk (CNN) tillsammans med ett återkommande neuralt nätverk (LSTM) för att skapa en bildbeskrivningsgenerator.
Datasett: Flickr 8K
Språk: Python
Ramverk: Keras
10. Upptäckte av kreditkortsmissbruk
Gör ditt bästa när du arbetar med en Data Science-projektidé — .
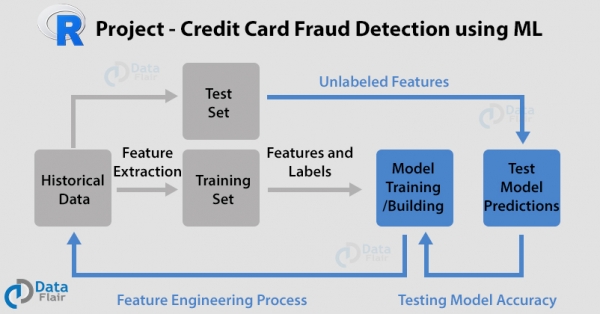
Vid det här laget har du börjat förstå metoder och koncept. Låt oss gå vidare till några avancerade projekt inom datavetenskap. I detta projekt kommer vi att använda programmeringsspråket R med algoritmer som , logistikregression, artificiella neurala nätverk och gradientboostingklassificerare. Vi kommer att använda en dataset för korttransaktioner för att klassificera kreditkortstransaktioner som bedrägliga eller äkta. Vi kommer att matcha dem med olika modeller och bygga prestandakurvor.
Språk: R
Dataset/Paket: Datasets för korttransaktioner
11. Filmtjänst rekommendationssystem
Upptäck implementeringen av det bästa Data Science-projektet med källkod —
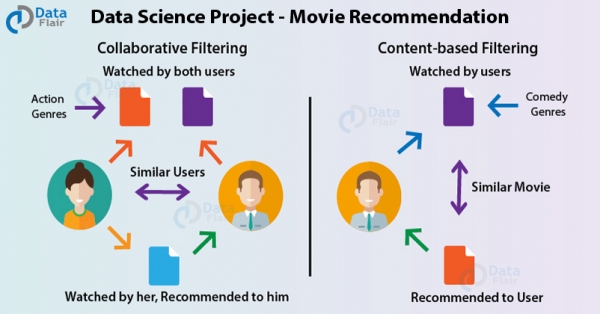
I detta Data Science-projekt kommer vi att använda R för att göra filmrekommendationer genom maskininlärning. Rekommendationssystemet skickar förslag till användare genom en filtreringsprocess baserat på andra användares preferenser och visningshistorik. Om både A och B gillar Home Alone, och B älskar Mean Girls, kan A föreslås också, eftersom de också kan gilla det. Detta gör att kunder kan interagera med plattformen.
Språk: R
Dataset/Paket: MovieLens dataset
12. Kundsegmentering
Imponera på arbetsgivare med ett Data Science-projekt (inkluderar källkod) — .
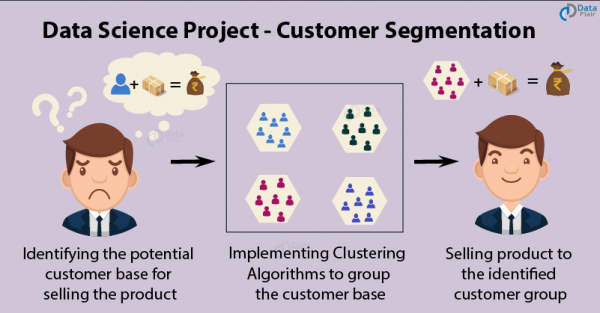
Kundsegmentering är en populär applikation . Genom att använda klustring identifierar företag kundsegment för att arbeta med potentiella användarbaser. De delar in kunder i grupper baserat på gemensamma egenskaper som kön, ålder, intressen och utgiftsvanor, så att de effektivt kan sälja sina produkter till varje grupp. Vi kommer att använda , samt visualisera fördelningen baserat på kön och ålder. Sedan kommer vi att analysera deras årliga inkomster och utgiftsnivåer.
Språk: R
Dataset/Paket: Mall_Customers dataset
13. Klassificering av bröstcancer
Se den fullständiga implementeringen av Data Science-projektet i Python — .
Återvänder till den medicinska aspekten av datavetenskap, låt oss lära oss att upptäcka bröstcancer med Python. Vi kommer att använda datasetet IDC_regular för att identifiera invasiv duktal cancer, den vanligaste formen av bröstcancer. Det utvecklas i mjölkgångarna och infiltrerar den fibrösa eller fettvävnaden utanför gången. I detta datainsamlingsprojekt kommer vi att använda och Keras-biblioteket för klassificering.
Språk: Python
Dataset/Paket: IDC_regular
14. Trafikskyltarigenkänning
Att uppnå precision i självkörande bilteknik genom ett Data Science-projekt om med öppen källkod.
Trafikskyltar och trafikregler är mycket viktiga för varje förare för att undvika olyckor. För att följa reglerna måste man först förstå hur en trafikskylt ser ut. En person måste lära sig alla trafikskyltar innan han eller hon får körkort för något fordon. Men nu ökar antalet självkörande fordon, och i en nära framtid kommer människor inte längre att köra bilar själva. I projektet "Trafikskyltarigenkänning" kommer du att lära dig hur programvaran kan känna igen typen av trafikskyltar genom att ta en bild som ingångssignal. Datasetet för trafikskyltar i Tyskland (GTSRB) används för att bygga ett djupt neuronnät för att identifiera vilken klass trafikskylten tillhör. Vi skapar också ett enkelt grafiskt gränssnitt för att interagera med applikationen.
Språk: Python
Datasett: GTSRB (German Traffic Sign Recognition Benchmark)
Läs mer
Källa: habr.com
